论文精读笔记:MIRETR
1. 核心判断
多实例配准与普通 pairwise registration 的差别,不只是“输出多组 pose”。scene feature 若使用全局 self-attention,一个严重遮挡实例的少量点会被完整邻居和背景主导;即使提取到对应,后续 multi-model fitting 也需要从海量 hypotheses 中把 correspondence 分簇。
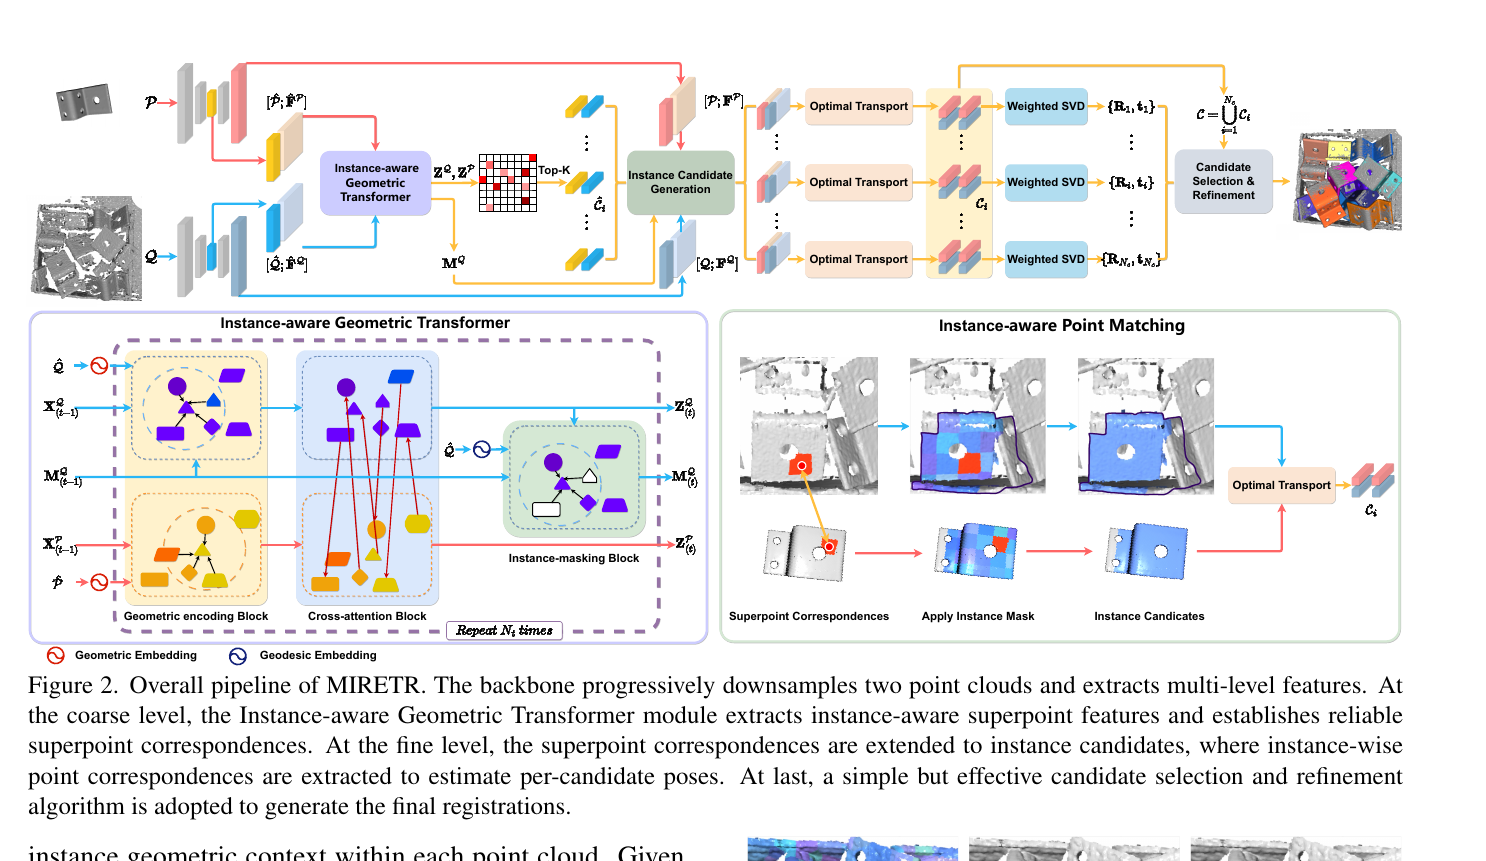
MIRETR 把实例分离提前到 correspondence learning:每个 scene superpoint 预测以自己为 anchor 的 instance mask,只聚合同实例邻域;粗匹配之后又用该 mask 直接形成 instance candidate。这样 feature、matching 和 pose grouping 使用同一个 instance-aware signal。
ROBI 的 global-attention 变体 MF 只有 10.96,完整模型 39.80,是这篇论文最有说服力的因果证据。
2. 问题定义
模型点云:
P = { p i ∈ R 3 } i = 1 N , P=\{p_i\in\mathbb R^3\}_{i=1}^{N}, P = { p i ∈ R 3 } i = 1 N , 场景点云:
Q = Q 0 ∪ Q 1 ∪ ⋯ ∪ Q K , Q=Q_0\cup Q_1\cup\cdots\cup Q_K, Q = Q 0 ∪ Q 1 ∪ ⋯ ∪ Q K , 其中 Q 0 Q_0 Q 0 Q 1 , … , Q K Q_1,\ldots,Q_K Q 1 , … , Q K K K K K K K
T k = ( R k , t k ) = arg min R , t ∑ ( p i , q i ) ∈ C k ∥ R p i + t − q i ∥ 2 2 . T_k=(R_k,t_k)
=\arg\min_{R,t}
\sum_{(p_i,q_i)\in C_k}
\|Rp_i+t-q_i\|_2^2. T k = ( R k , t k ) = arg R , t min ( p i , q i ) ∈ C k ∑ ∥ R p i + t − q i ∥ 2 2 . 难点有两个:
correspondences 要覆盖尽可能多的实例,不能只集中在最完整对象;
correspondences 必须正确分到各实例,否则一个刚体变换会混合多个对象。
MIRETR 的“open-set”指几何模型可来自训练外对象 / 类别,不是无 model 的 open-vocabulary detection。
3. 从全局上下文到 instance-aware context
原论文 Figure 2。上方是 model-to-scene coarse-to-fine 主流程;左下迭代 transformer 在 mask 内编码几何,右下把 coarse correspondence 扩展为 candidate-specific dense matching。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
KPFCNN 将点云下采样为 P ^ , Q ^ \hat P,\hat Q P ^ , Q ^
geometric encoding :对 anchor 的 KNN 邻域编码距离和角度结构,但用上一轮 mask 排除其他实例;cross-attention :model 与 scene superpoints 交换信息,学习跨点云几何一致性;instance masking :利用更新 feature 重新预测 anchor 所属实例的邻域 mask。
初始 mask 不准确,但 local neighborhood 仍提供弱先验;feature 改善后 mask 更准,下一轮 context 又更纯。这是一个可学习的 EM-like 迭代。
监督由三项构成:
L = L c i r c l e + L n l l + L m a s k , \mathcal L
=\mathcal L_{\mathrm{circle}}
+\mathcal L_{\mathrm{nll}}
+\mathcal L_{\mathrm{mask}}, L = L circle + L nll + L mask , 分别约束 superpoint feature、dense point matching 和 instance mask。
4. 从 superpoint match 到实例 pose
传统 pipeline 把所有 correspondences 交给 T-Linkage、RansaCov、ECC 或 PointCLM。MIRETR 对每个 superpoint correspondence:
取 model patch;
用预测 mask 收集 scene anchor 同实例的多个 neighbor patches;
在局部对应矩阵上做 optimal transport;
形成 candidate-specific dense correspondences;
weighted SVD 求该 candidate 的 T i T_i T i
候选得分使用 inlier ratio。重复候选按两组 pose 的 ADD similarity 合并:
s i j = 1 − ADD ( T i , T j ) r , s_{ij}=1-\frac{\operatorname{ADD}(T_i,T_j)}{r}, s ij = 1 − r ADD ( T i , T j ) , r r r
5. Scan2CAD
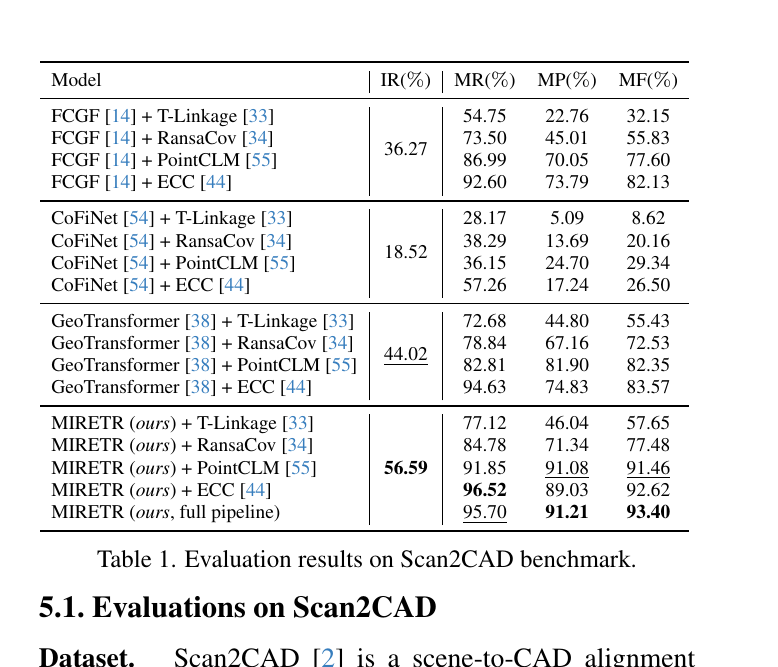
原论文 Table 1。MIRETR correspondence 的 IR 为 56.59;完整 pipeline 的 MR / MP / MF 为 95.70 / 91.21 / 93.40。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
Scan2CAD 子集有 2,184 model-scene pairs,70% / 10% / 20% 划分。关键比较:
方法 IR MR MP MF GeoTransformer + PointCLM 44.02 82.81 81.90 82.35 GeoTransformer + ECC 44.02 94.63 74.83 83.57 MIRETR + PointCLM 56.59 91.85 91.08 91.46 MIRETR + ECC 56.59 96.52 89.03 92.62 MIRETR full — 95.70 91.21 93.40
ECC 的 recall 高但 precision 低,说明它倾向输出更多假阳性;完整 MIRETR 在 recall 几乎不损失的情况下把 precision 提到 91.21。
6. ROBI:真正困难的 clutter
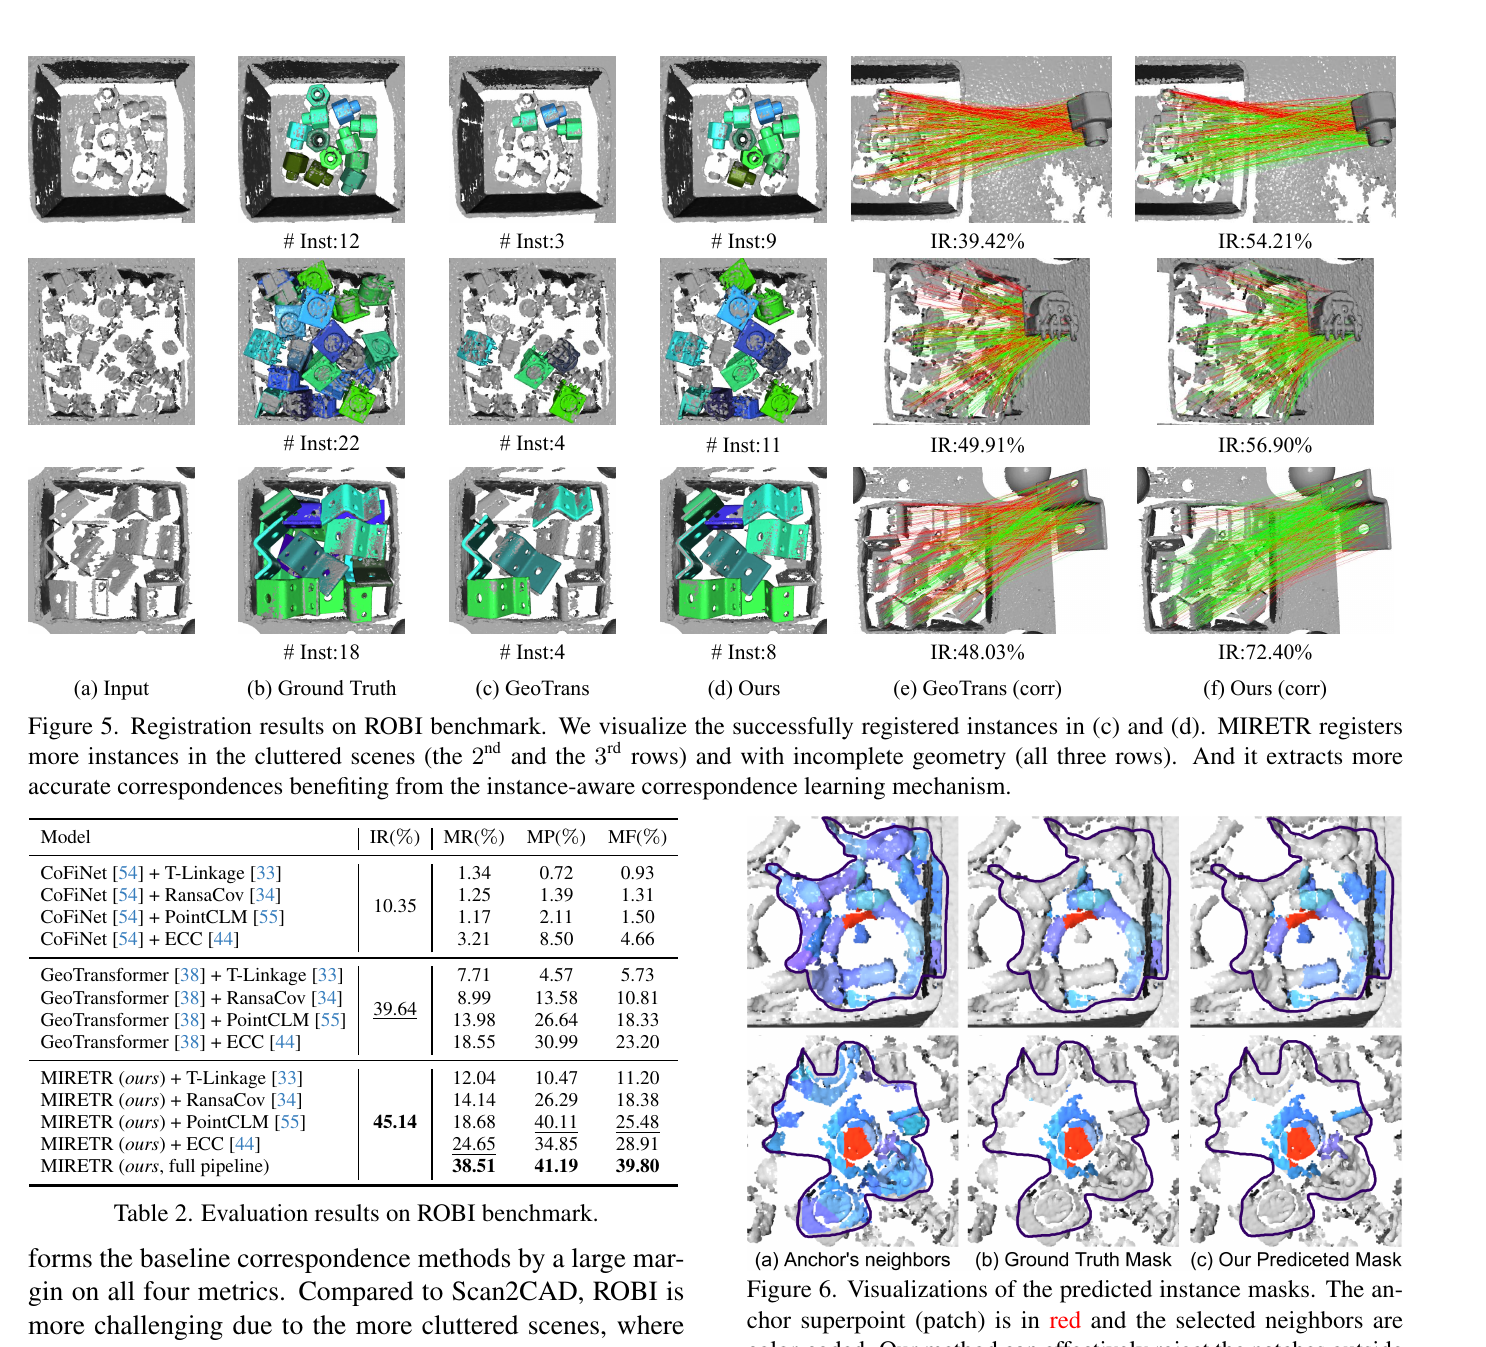
原论文 Figure 5–6 与 Table 2。彩色 CAD 叠加显示成功注册实例,右侧对应线与 instance masks 展示模型如何排除其他对象和背景。来源:CVPR 2024 正式论文 ;图片与表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
ROBI 包含 7 个反光金属零件、63 个 bin-picking scenes、4,880 pairs,按场景 6:1:2 划分。结果:
方法 IR MR MP MF GeoTransformer + ECC 39.64 18.55 30.99 23.20 MIRETR + PointCLM 45.14 18.68 40.11 25.48 MIRETR + ECC 45.14 24.65 34.85 28.91 MIRETR full — 38.51 41.19 39.80
完整 pipeline 相比 GeoTransformer + ECC 的 MF 提升 16.6 points。绝对 MF 仍只有 39.80,说明 ROBI 中深度缺失、反光和极端遮挡仍非常困难。
实例 mask mIoU 为 69.26,而无 masking 设计为 38.13。平均成功实例数 13.7,相比 MIRETR + PointCLM 的 6.2;提升主要来自找回 hard / low-overlap instances,而不是只把 easy cases 做得更准。
7. 未见类别泛化与消融
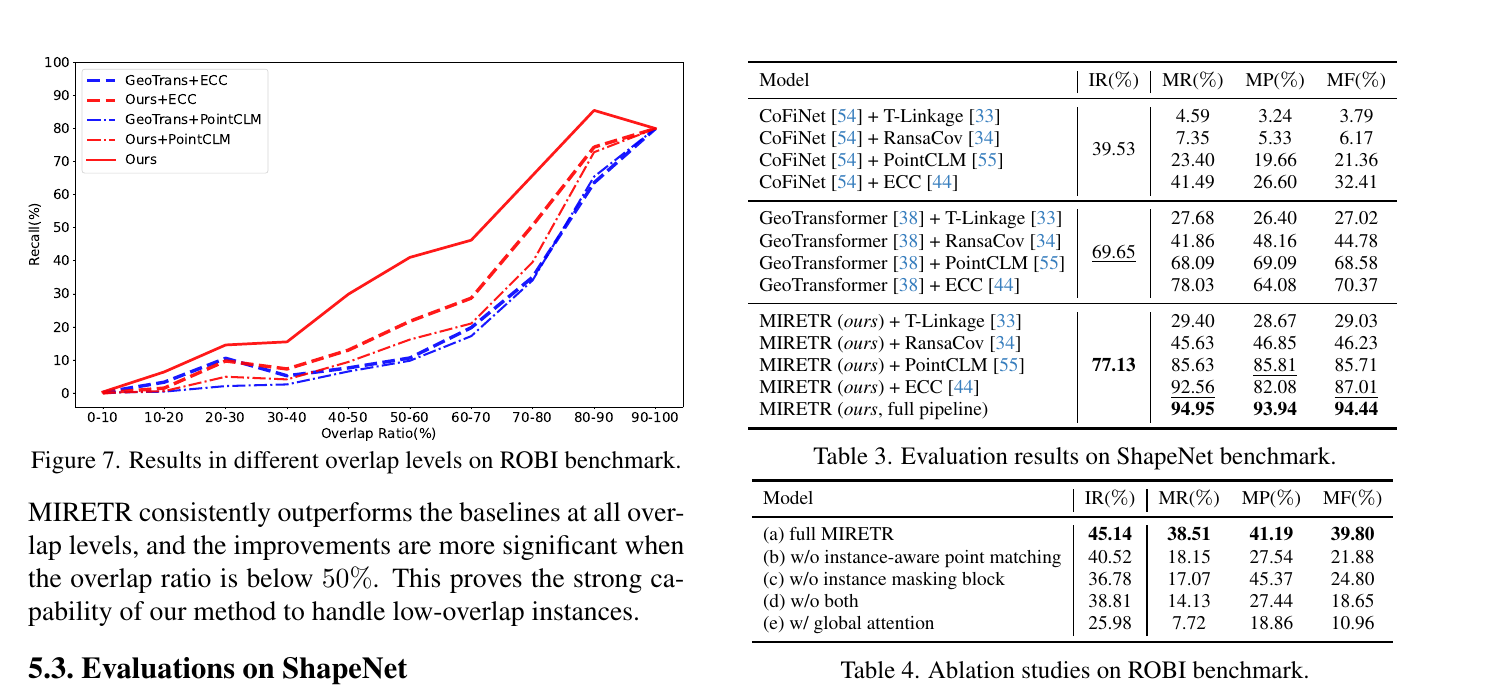
原论文 Figure 7、Table 3–4:左侧按 overlap 分桶,低于 50% 时优势最大;右侧给出 ShapeNet 未见类别和 ROBI 结构消融。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
ShapeNet 用前 30 类训练、后 25 类测试;每个 scene 放置 4–16 个随机变换实例。完整模型:
I R / M R / M P / M F = 77.13 / 94.95 / 93.94 / 94.44. \mathrm{IR/MR/MP/MF}
=77.13/94.95/93.94/94.44. IR/MR/MP/MF = 77.13/94.95/93.94/94.44. GeoTransformer + ECC 的 MF 为 70.37,MIRETR full 高 24.07 points。这里点云是合成 CAD,噪声与遮挡比 ROBI 容易,所以 94.44 不能代表真实 bin-picking 的绝对性能,但能说明几何 feature 不依赖固定语义类别。
ROBI 消融:
配置 IR MR MP MF 完整 45.14 38.51 41.19 39.80 无 instance-aware point matching 40.52 18.15 27.54 21.88 无 instance masking block 36.78 17.07 45.37 24.80 两者都无 38.81 14.13 27.44 18.65 global attention 25.98 7.72 18.86 10.96
无 masking 时 precision 反而最高,但 recall 崩溃:模型只保留少数容易实例。global attention 最差,直接验证“跨实例上下文污染”是核心问题。
8. 工程意义
MIRETR 适合已知目标零件的 bin picking:
不要求预先知道堆叠数量;
同一前向过程输出多组 pose;
对低 overlap 和实例接触比全局 matching 更稳;
可复用 weighted SVD 与 point-cloud registration 工具链;
纯几何方案可跨对象类别。
但完整机器人系统仍需:
从 CAD 库选择要搜索的 model;
获得质量足够的 depth;
处理对称 pose 等价性;
为每个候选做碰撞 / 可抓取性验证;
在工业节拍下测量端到端速度和显存。
主文没有给 runtime,对比 multi-model fitting 的“更高效”更多来自算法结构,部署前仍需基准测试。
9. 局限与复现检查
Scan2CAD 被替换为 aligned CAD 场景,不是原始 noisy scan 的完整难度。
ShapeNet scene 由同一 CAD 的随机变换复制构造,domain gap 较大。
ROBI 只含每场景同一种零件;混合不同 CAD 的多类别 clutter 尚未验证。
输入 model point cloud 已知,检索错误不会被评测。
Instance mask 是 anchor-relative,而非全局一致 segmentation;候选 merge 仍依赖阈值。
对高对称工业零件,ADD-based candidate similarity 可能需要 symmetry-aware 改造。
主文未报告 FPS、参数量、候选数量敏感性和 depth noise calibration。
10. 最终评价
MIRETR 的设计逻辑非常完整:将“实例边界”从后处理提前到 feature learning,再沿 coarse match、dense correspondence、pose candidate 一路传递。ROBI 的低 overlap 曲线、mask mIoU 和结构消融共同支撑核心假设,不是只靠最终 leaderboard 数字。
它仍是 model-to-scene registration,而非通用对象发现;真实 ROBI MF 也只有 39.80。最自然的后续方向是多 CAD 混合场景、symmetry-aware candidate merge,以及和 RGB / foundation feature 融合来补偿反光零件的深度缺失。