Reading Notes
粗读 / 精读
已生成 src/paper-notes/mixri-iccv2025/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:MixRI: Mixing Features of Reference Images for Novel Object Pose Estimation
1. 基本信息
- 年份 / 会议:2025 / ICCV;阅读模式:粗读。
- 任务:CAD-based novel-object 6D pose,面向 RGB 与多张渲染 reference images。
- 原文:ICCV Open Access;项目页:MixRI。
2. 一句话定位
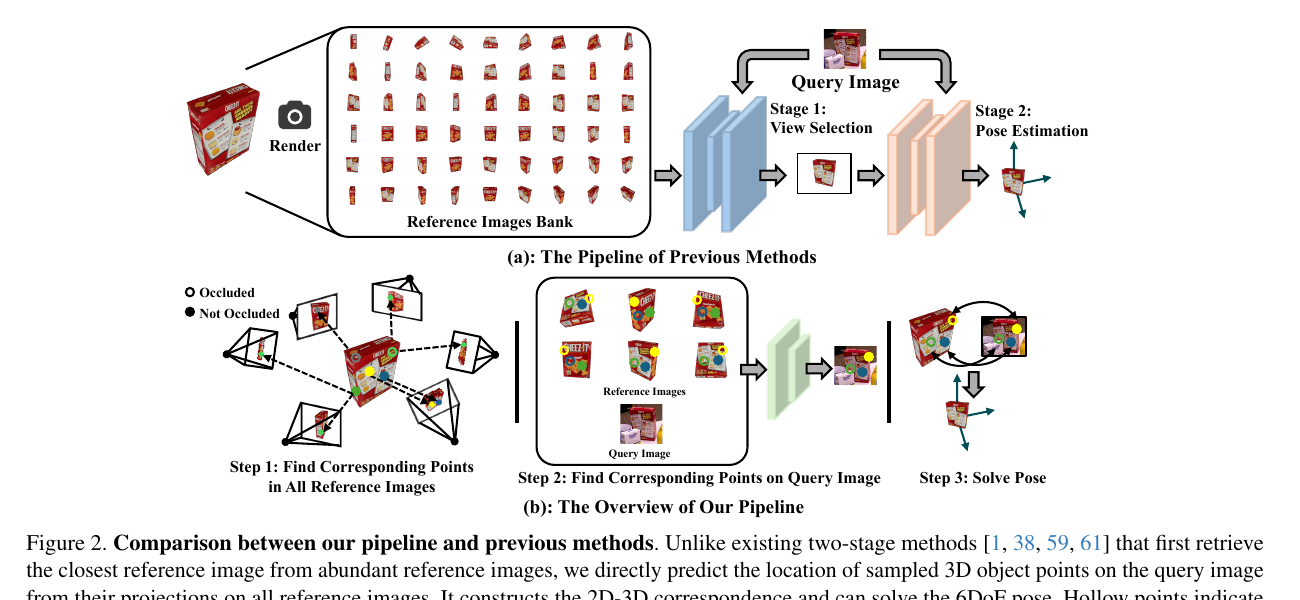
MixRI 不先检索一张“最像”的模板,而是把同一 3D 点在所有 reference views 的信息融合后直接定位到 query,再以 RANSAC-PnP 求新物体 pose,从而减少 reference 数和缓存开销。
2.1 论文图表导读
| 图表 | 看点 |
|---|---|
| Figure 2 | 上半部分是先检索再估 pose 的传统两阶段,下面是 MixRI 的 all-reference point matching。 |
3. 方法概览
- 在 reference views 上采样已知 3D object points;聚合每个点的多视角 feature,并显式预测其在 query 中是否被遮挡。
- View-Aggregated Point Matching 输出 query 2D point,再由 2D–3D correspondences + RANSAC-PnP 计算 pose。
- 训练使用合成 GSO 数据;新对象只需 CAD 渲染的 reference bank,不需要针对该对象 fine-tune。
4. 实验概览
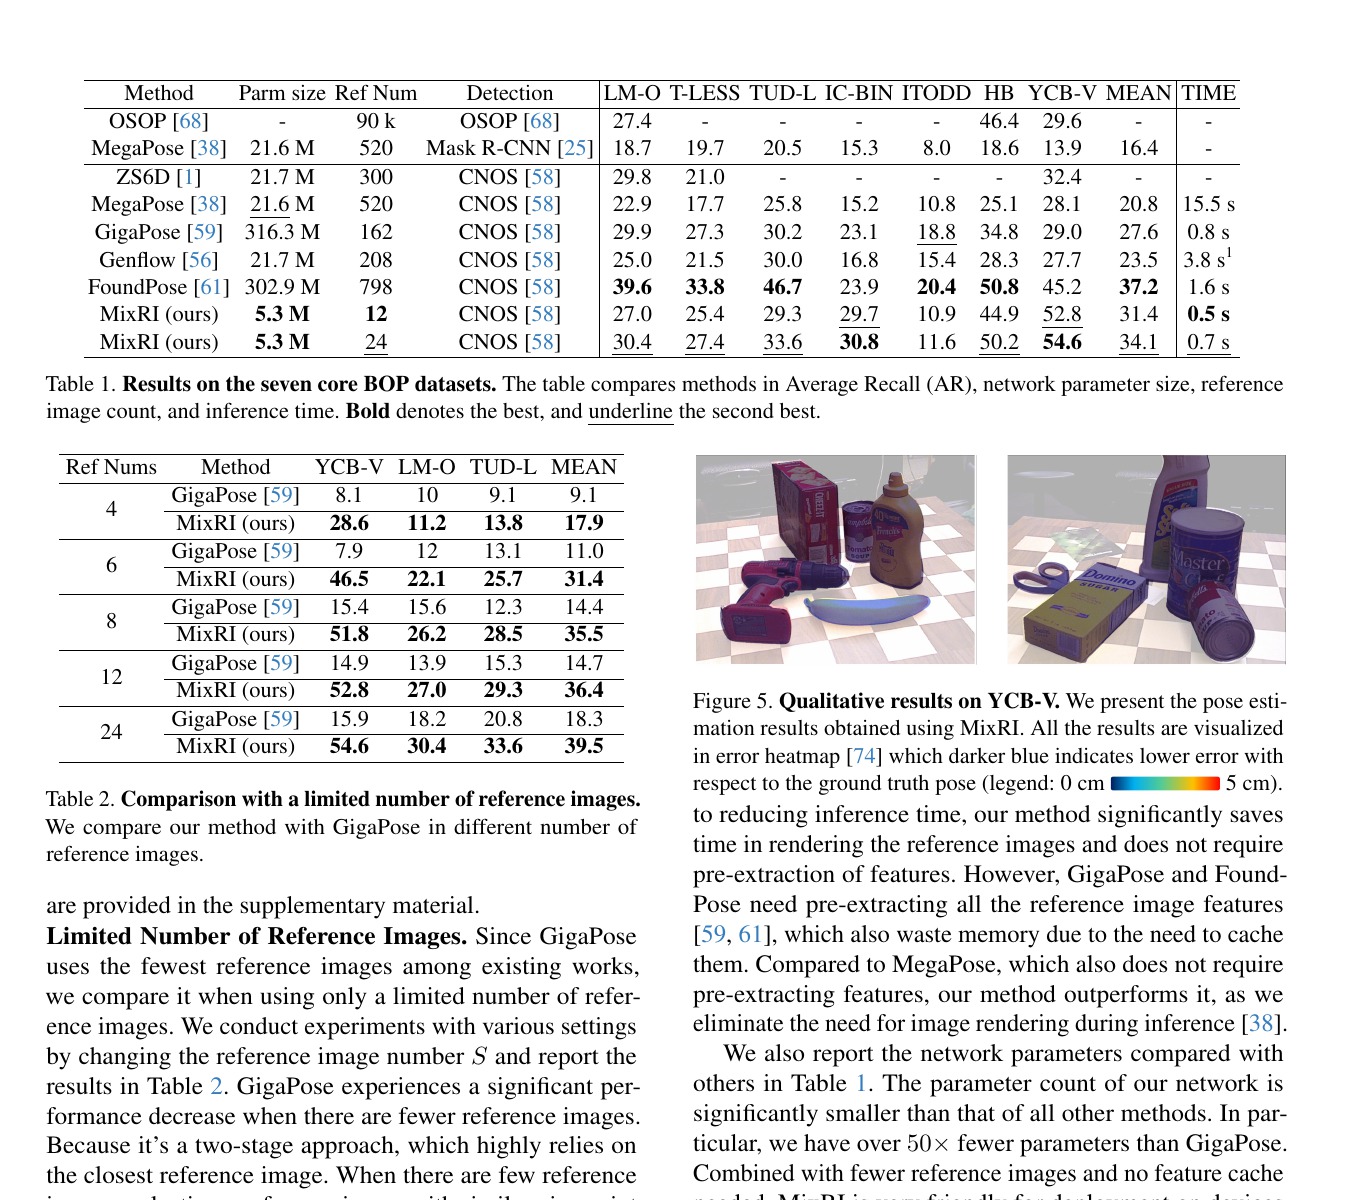
- 在 BOP 七个核心数据集上报告 AR、网络大小、reference 数和推理速度。
- 作者声称:用 12 或 24 张 reference image 即可保持与大量模板方法竞争的 AR,并降低 memory 与 inference time。
- 我的分析:它把 reference 数作为工程变量明确优化,适合边缘部署;但仍是 CAD-based setting,检测与渲染 templates 的成本没有消失。
5. 优缺点与启发
- 优点:避开单模板检索失败;PnP 输出可解释;对多 view 信息利用充分。
- 风险:仍依赖 CAD、内参和对象裁剪;遮挡标注/模拟质量会影响点对应训练。
- 启发:对多参考 pose,不必先做 view retrieval;可以直接把“同一 3D 点的可见性集合”作为匹配单元。