论文精读笔记:MK-Pose
1. 核心判断
MK-Pose 试图解决类别级 pose 的三个薄弱环节:
遮挡时 RGB-D 局部观测不完整;
人工关键点无法覆盖类别内新实例;
只做局部邻域或只做全局 pooling 都不足以兼顾细节和整体形状。
它的答案是“类别语义作为稳定条件 + 无人工标签的三维关键点 + 局部 / 全局图融合”。其中真正可量化的主要贡献是关键点与融合模块:REAL275 上完整模型 5°/2cm 为 60.8,去文本、去 feature fusion、去重建分别降至 53.3、54.1、55.2。
但论文的术语需要收紧:
shape-prior-free:不使用实例 CAD 或类别 deformable shape prior,不代表没有几何;推理显式输入深度点云。
self-supervised keypoint:96 个关键点没有人工坐标标签,但网络总体仍用 pose、size、NOCS 和重建目标监督。
zero-shot:HouseCat6D 是跨数据集 / 部分类别未见测试,论文只报告 3D box IoU,没有完整 pose threshold。
2. 输入、输出与前端依赖
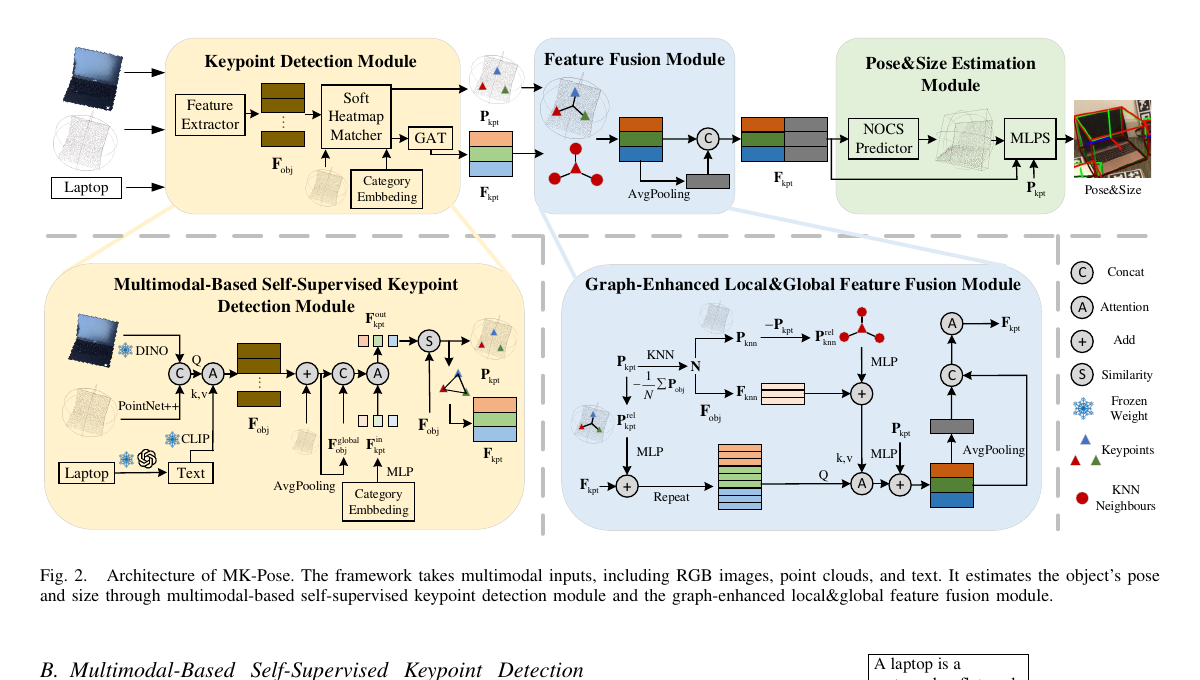
原论文 Figure 2。上方给出端到端数据流,下方展开多模态关键点检测与图增强的局部 / 全局融合。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
输入为:
224 × 224 224\times224 224 × 224 depth 经内参反投影并采样的 N = 1024 N=1024 N = 1024
对象类别名;
由 GPT-4o 离线生成的类别形状描述。
输出为旋转矩阵 R R R t t t s s s
方法属于 category-level、seen-category / unseen-instance。HouseCat6D 又加入跨数据集和部分类别未见测试,但训练与推理仍需要类别名称。
3. 三路模态到底如何融合
3.1 RGB 与点云
冻结 DINOv2-ViT-S/14 产生 F R G B ∈ R N × 128 F_{\mathrm{RGB}}\in\mathbb R^{N\times128} F RGB ∈ R N × 128
PointNet++ 产生 F P C ∈ R N × 128 F_{\mathrm{PC}}\in\mathbb R^{N\times128} F PC ∈ R N × 128
两者拼接后作为 cross-attention query。
深度点云与 RGB crop 已通过相机几何对齐。论文把二者称为 multimodal,但没有单独报告 RGB-only 或 depth-only 消融,所以不能判断性能主要来自视觉 backbone 还是点云几何。
3.2 类别文本不是在线视觉语言推理
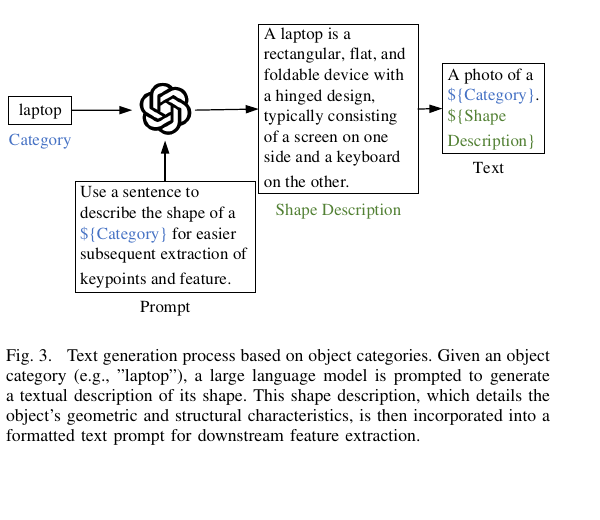
原论文 Figure 3:GPT-4o 根据类别名生成一次形状描述,再拼成“A photo of a [Category]. [Shape Description]”供 CLIP 编码;这属于类别级离线先验,不是对每张图进行视觉语言推理。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
论文提示 GPT-4o:“描述某类别的形状,以便后续提取关键点和特征”。以 laptop 为例,描述包含矩形、扁平、可折叠和铰链结构,再与模板句组合并由冻结 CLIP text encoder 得到 F t e x t F_{\mathrm{text}} F text
RGB + 点云为 query,文本为 key/value:
F o b j = softmax ( Q K ⊤ d ) V . F_{\mathrm{obj}}
=\operatorname{softmax}\left(\frac{QK^\top}{\sqrt d}\right)V. F obj = softmax ( d Q K ⊤ ) V . 文本对同一类别所有实例固定,因此它能提供类别语义,却不能恢复某张图里被遮挡部位的实例形状。论文“文本可恢复遮挡对象”的表述更准确的解释应是:它为特征提供稳定类别条件,而不是生成不可见几何。
4. 无人工标注的关键点如何产生
原始对象点特征先叠加点坐标位置编码和全局平均特征。N k p t = 96 N_{\mathrm{kpt}}=96 N kpt = 96
关键点 query 与每个对象点计算 cosine similarity,经温度 τ = 0.1 \tau=0.1 τ = 0.1 H H H
P k p t = H P , F k p t = H F o b j . P_{\mathrm{kpt}}=HP,\qquad
F_{\mathrm{kpt}}=HF_{\mathrm{obj}}. P kpt = H P , F kpt = H F obj . 因此关键点是输入点云坐标的软加权组合,不一定落在真实表面采样点上。随后全连接 GAT 更新关键点间关系。
关键点没有 GT 位置,监督来自:
L c d L_{\mathrm{cd}} L cd L d i v L_{\mathrm{div}} L div T = 0.01 T=0.01 T = 0.01 L r e c L_{\mathrm{rec}} L rec L Δ L_\Delta L Δ L n o c s L_{\mathrm{nocs}} L nocs L p s L_{\mathrm{ps}} L ps
这是一种 task-supervised keypoint discovery :不用人工关键点,但并非只靠未标注数据。
5. 局部与全局融合
每个关键点在输入点云中找 k = 16 k=16 k = 16
关键点加入相对对象中心的位置编码;
邻域点加入相对该关键点的位置编码;
关键点 feature 作 query,邻域点 feature 作 key/value,cross-attention 聚合局部几何;
再加入关键点绝对坐标编码;
对全部关键点平均得到 global keypoint feature,broadcast 回每个点;
MLP + self-attention 得到最终 F k p t F_{\mathrm{kpt}} F kpt
设计上兼顾邻域曲面与对象整体,但 KNN 建在观测点云中,重遮挡时邻域本身可能不完整。文本与全局特征只能提供统计先验,无法确保恢复某个未见实例的真实背面。
6. 对称性与 pose / size 损失
MK-Pose 预测关键点 NOCS 坐标后,沿用 DPDN 的 MLP 估计 R , t , s R,t,s R , t , s
无对称:等价旋转集合仅含单位阵;
有限对称:在预定义 R S R_S R S
无限轴对称:用 v ∈ { 0 , 1 } 3 v\in\{0,1\}^3 v ∈ { 0 , 1 } 3
总体损失为:
L = λ 1 L p s + λ 2 L c d + λ 3 L d i v + λ 4 L r e c + λ 5 L Δ + λ 6 L n o c s , L=\lambda_1L_{\mathrm{ps}}+\lambda_2L_{\mathrm{cd}}
+\lambda_3L_{\mathrm{div}}+\lambda_4L_{\mathrm{rec}}
+\lambda_5L_\Delta+\lambda_6L_{\mathrm{nocs}}, L = λ 1 L ps + λ 2 L cd + λ 3 L div + λ 4 L rec + λ 5 L Δ + λ 6 L nocs , 权重依次为 0.3、2、10、15、1、2。对称信息是人工定义的类别 / 对象先验;它解决等价 pose 的监督冲突,不等于网络从图像自动发现 symmetry group。
7. 数据、训练与指标
CAMERA25:6 类、1,085 个 ShapeNet 实例、300K 合成图,25K validation;
REAL275:13 个实例、7,000 张真实图,2,750 张 validation,测试每类含 3 个训练未见实例;
HouseCat6D:5 个测试场景、约 3K frames、10 个家庭用品类别,用于跨数据集测试。
训练混合 CAMERA synthetic 与 REAL;batch 32,单 RTX 3090 Ti。论文没有报告训练 epochs / 总步数、收敛时长、推理速度、参数量和显存。
指标:
IoU25 / IoU50 / IoU75:预测与真值 3D box intersection-over-union;
n ∘ / m cm n^\circ/m\text{cm} n ∘ / m cm n ∘ n^\circ n ∘ m m m bottle / bowl / can 允许 3D box 绕竖直轴自由旋转;mug 在 handle 不可见时按对称处理。
8. REAL275 与 CAMERA25 主结果
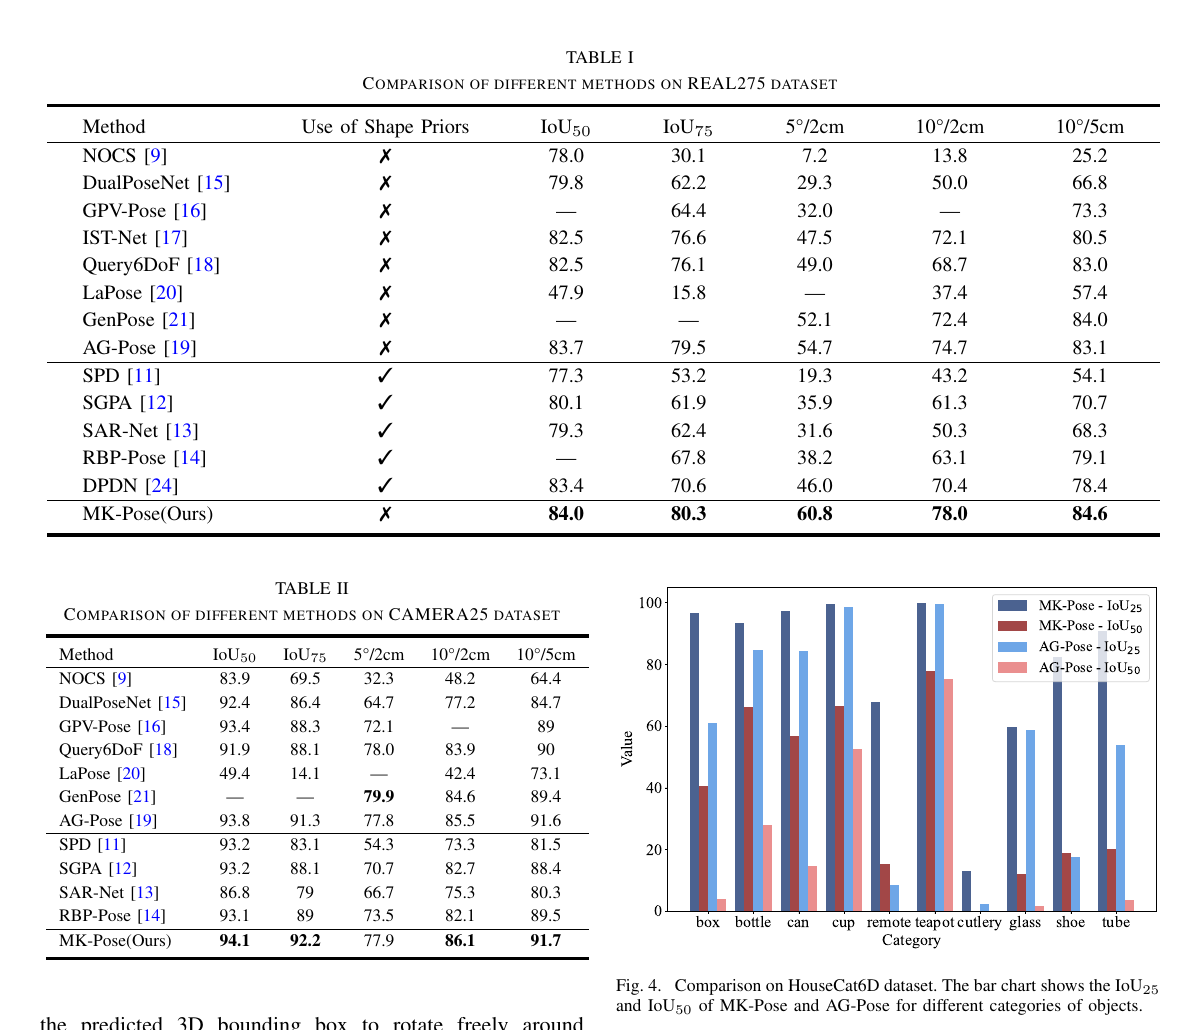
原论文 Table I–II 与 Figure 4。主表同时列 shape-prior-free 和 shape-prior-based 方法;HouseCat6D 柱状图只有 IoU 指标。来源:作者公开稿 ;图表版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
REAL275
方法 IoU50 IoU75 5°/2cm 10°/2cm 10°/5cm GenPose — — 52.1 72.4 84.0 AG-Pose 83.7 79.5 54.7 74.7 83.1 DPDN(shape prior) 83.4 70.6 46.0 70.4 78.4 MK-Pose 84.0 80.3 60.8 78.0 84.6
相对最接近的 AG-Pose,严格 pose AP 提升 6.1,IoU75 只提升 0.8。说明主要优势在姿态而非 box overlap。
CAMERA25
MK-Pose 为 94.1 / 92.2 / 77.9 / 86.1 / 91.7。5°/2cm 没有超过 GenPose 的 79.9,也仅比 AG-Pose 77.8 高 0.1;其优势主要在 IoU 与较宽的 10° 阈值。论文正文“全面领先”需要按列理解。
9. HouseCat6D 跨数据集实验
训练使用 CAMERA25 + REAL275,再直接在 HouseCat6D 测试。作者列出训练类别中没有的 box、shoe、tube,并报告:
MK-Pose:IoU25 80.1,IoU50 37.5;
AG-Pose:IoU25 63.6,IoU50 19.7。
这是跨数据集 3D box generalization 的积极证据,但仍有四个缺口:
没有 5°/2cm 等 pose 指标;
没有给出所有类别的数字表,只有柱状图;
方法含 learnable category embedding / category-conditioned query,论文未充分说明未见类别如何初始化;
未说明 HouseCat6D 的 detector / mask 是否也完全不适配。
因此更稳妥的结论是“跨数据集 IoU 泛化改善”,不能直接写成“零样本 6D pose 已验证”。
10. 消融与定性结果
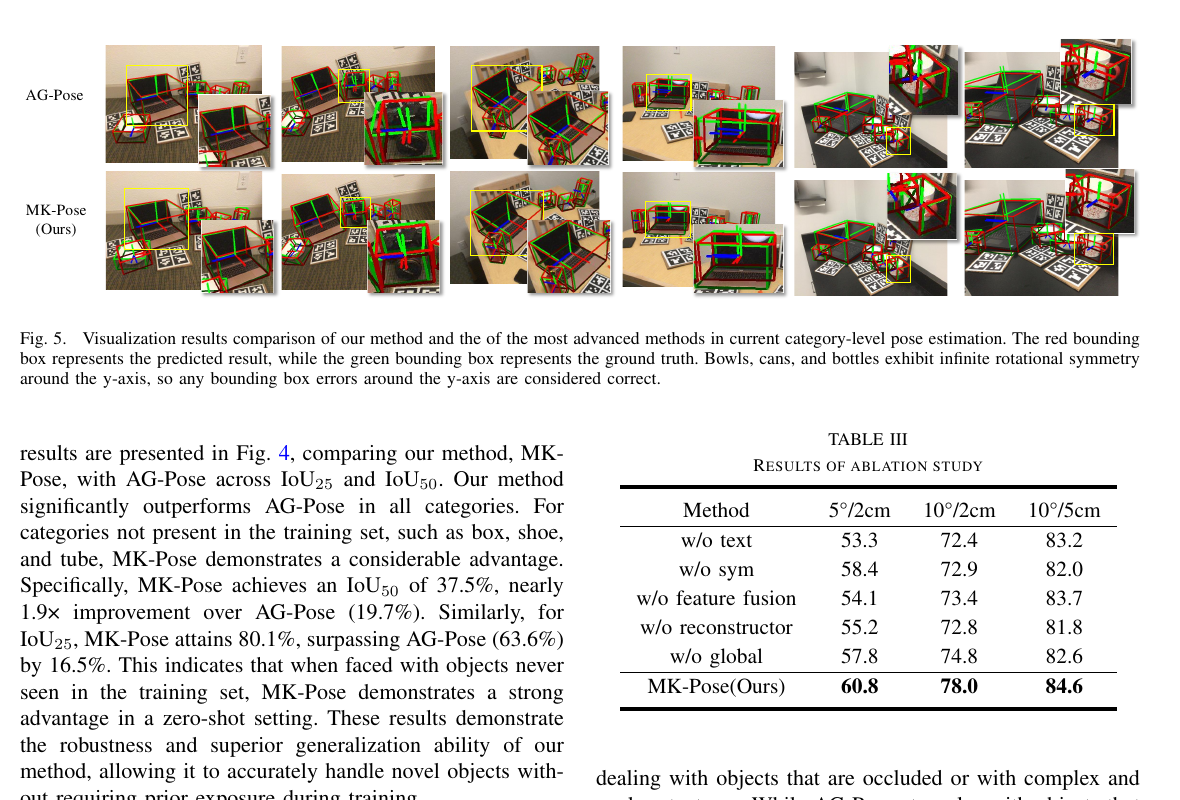
原论文 Figure 5 与 Table III。红框为预测、绿框为真值;表格在 REAL275 上逐项移除文本、对称损失、局部全局融合、重建和全局特征。来源:作者公开稿 ;图片与表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
配置 5°/2cm 10°/2cm 10°/5cm w/o text 53.3 72.4 83.2 w/o symmetry loss 58.4 72.9 82.0 w/o feature fusion 54.1 73.4 83.7 w/o reconstructor 55.2 72.8 81.8 w/o global 57.8 74.8 82.6 full 60.8 78.0 84.6
文本对严格阈值贡献 +7.5,是较大的单项差距;但论文没有更换描述、随机描述或仅类别名等 control,不能确认提升来自自然语言形状语义、CLIP 类别 embedding,还是额外参数 / 条件分支。
定性图覆盖遮挡和杂乱场景,MK-Pose 多个框更接近真值;没有展示失败案例,也没有按遮挡率、透明材质或深度缺失分桶。
11. 开源与复现风险
截至本站整理时,作者仓库已包含 train.py、test.py、模型与 REAL config,并提供 checkpoint / 日志入口,不再只是“代码即将发布”的空链接。
复现应重点核对:
GPT-4o 的具体模型版本、system prompt、temperature 与每类最终文本;
DINOv2 / CLIP 是否完全冻结,PointNet++ 是否从头训练;
RGB feature 与 1,024 点的对应、crop / resize 后内参修正;
96 个 category query 在 HouseCat6D 未见类别上的生成方式;
T = 0.01 T=0.01 T = 0.01 finite symmetry matrices 与 infinite-axis vector 的来源;
Mask R-CNN 预测 mask 和 GT mask 的区分;
论文中的 validation / test 命名及官方 NOCS split;
训练时长、网络 / detector 分段 latency 与显存。
12. 最终评价
MK-Pose 的强项是把类别文本、无人工标注关键点、局部几何和整体上下文组织成一个完整 RGB-D 类别级 pose pipeline,并在 REAL275 的严格 5°/2cm 上给出清晰提升。它最值得借鉴的是监督设计与对称损失,而不是“语言恢复遮挡”的宽泛叙事。判断其开放世界价值时,应记住 HouseCat6D 只验证 IoU,未见类别 query 和 detector 的复现细节仍不充分。