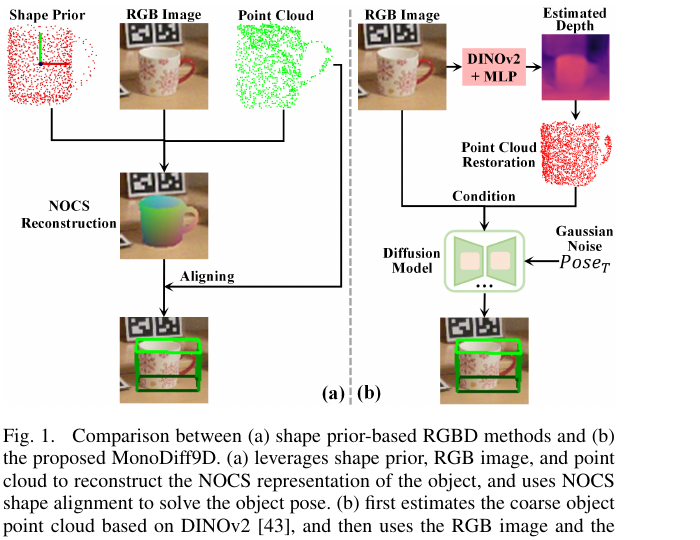
论文精读笔记:MonoDiff9D: Monocular Category-Level 9D Object Pose Estimation via Diffusion Model
1. 任务定义
给定单张 RGB、相机内参 K 和对象 mask,预测:
y=(R,t,s),
其中 R∈SO(3),t∈R3,s∈R3 为 metric size。类别级意味着目标实例未见,但属于训练类别;9D 不是单纯 6D pose,而是额外预测三轴尺度。
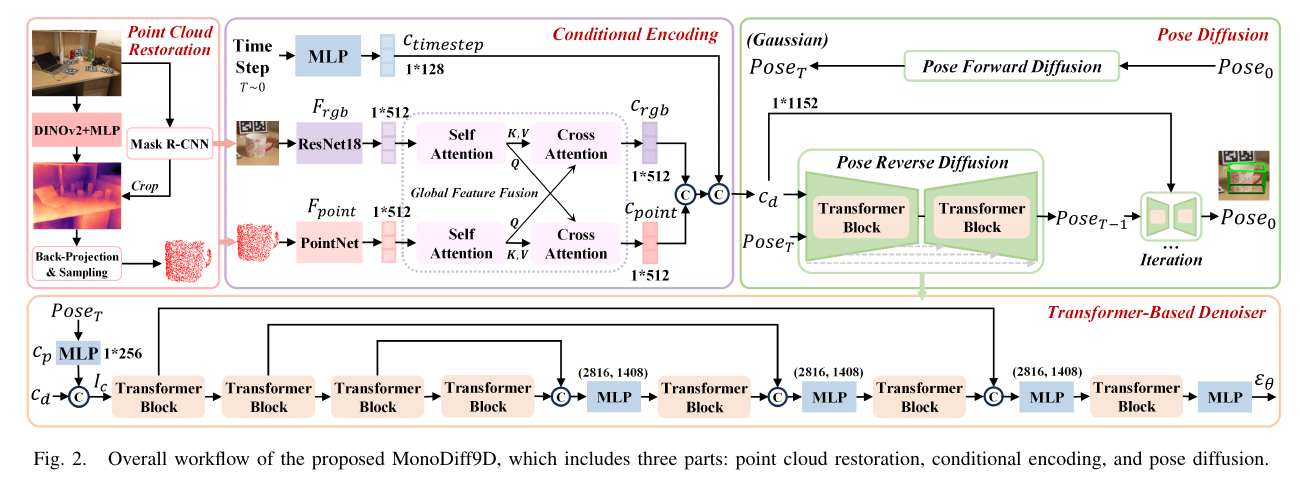 原论文 Figure 2:RGB crop 与估计深度点云分别编码,经 attention 融合后作为 Transformer denoiser 的条件,从随机 pose 逐步去噪。来源:作者公开 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
2. 从 RGB 构造几何条件
对 mask 内像素 (u,v) 和估计深度 d(u,v):
X=d(u,v)K−1[u,v,1]⊤.
这一步把单目深度变成 point cloud,使 PointNet 可以编码三维结构。要注意:若深度只有相对尺度,translation 和 object size 会共同漂移;因此训练数据中的 metric supervision 和深度模型尺度泛化非常重要。
RGB branch 用 ResNet-18 提取纹理 / 轮廓,全局 point branch 提取估计几何。Cross-attention 并不是恢复真实 depth,而是在当前有噪几何下学习可供 pose 去噪使用的条件。
3. Diffusion pose generation
前向过程逐步向 ground-truth pose vector 加噪:
q(yt∣y0)=N(αˉty0,(1−αˉt)I).
Transformer denoiser 接收 yt、timestep embedding 和视觉条件,预测噪声或 clean pose。推理时从 yT∼N(0,I) 出发,以 DDIM 逐步得到 y^0。
Diffusion 的潜在优势:
- 可表示对称 / 遮挡导致的多峰解;
- iterative denoising 比单次 regression 更容易修正各分量耦合;
- 可采样多个候选并排序。
但如果最终只输出一个样本且没有可靠 ranking,多峰建模的系统收益仍需实验验证。
4. Rotation、translation 与 size 的耦合
9D 分量的数值范围差异大。一个有效 denoiser 必须处理:
- rotation representation 的合法性;
- translation 深度与 size 的尺度耦合;
- 不同类别 canonical coordinate;
- 对称对象的多组等价 rotation。
扩散在欧氏向量上进行不自动保证每一步都位于 SO(3),需要合法 rotation 表示或解码。阅读与复现时应查看代码中的归一化、旋转投影和 symmetry-aware loss,而不能只看“用了 diffusion”。
5. 实验结果
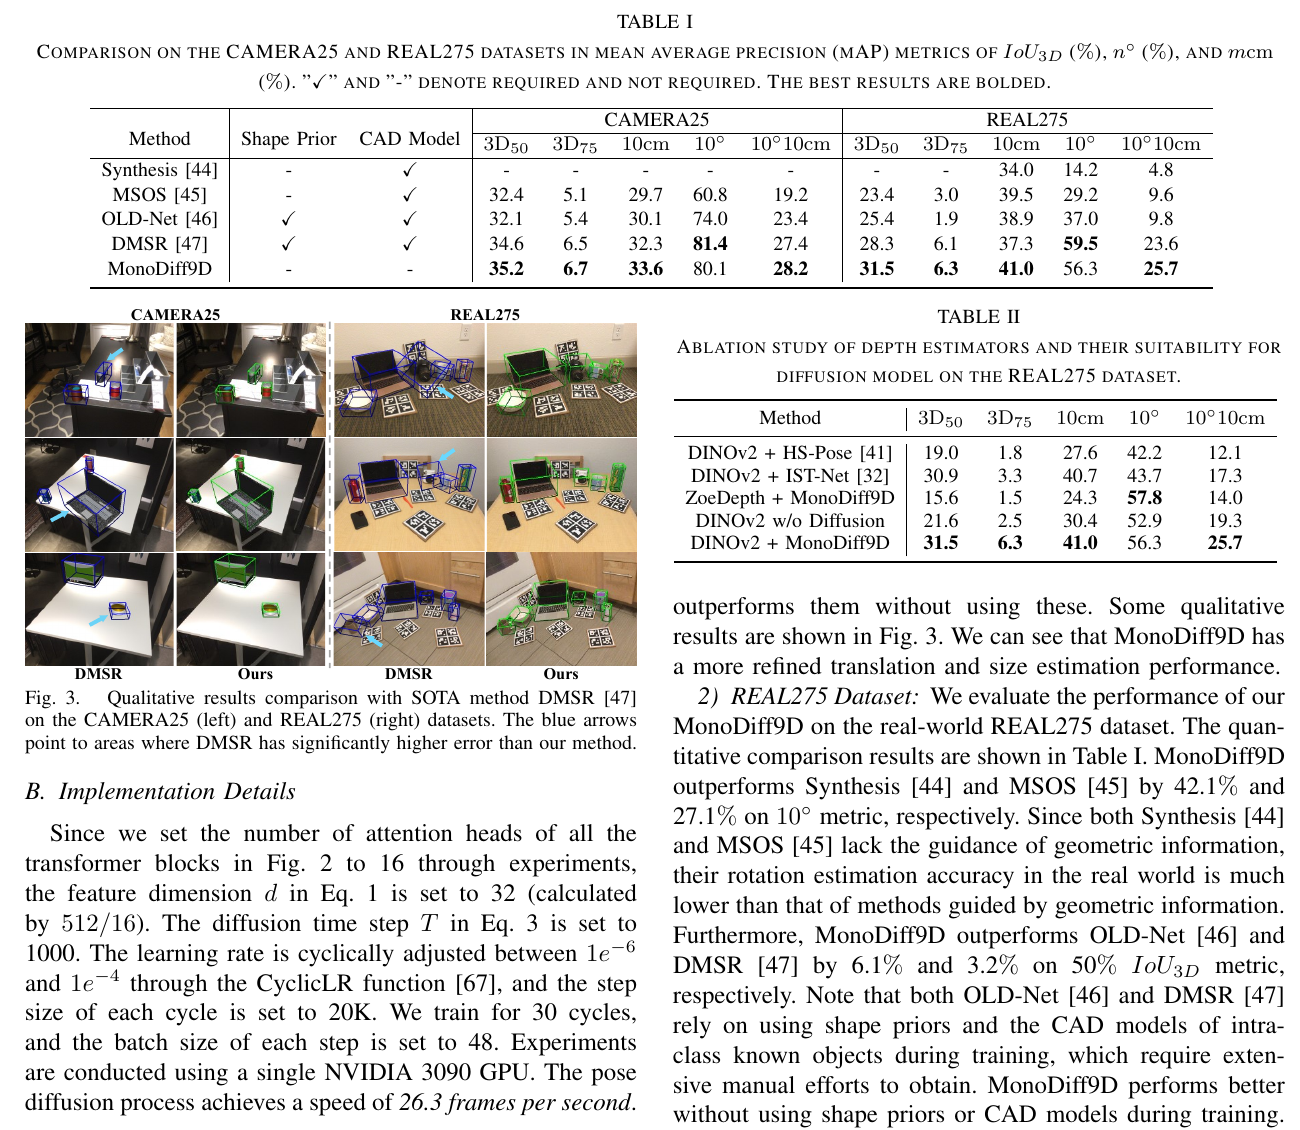 原论文 Tables I-II 与定性图:CAMERA25、REAL275 上的类别级 9D pose 指标,以及复杂真实场景中的预测框。来源:作者公开 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 数据集 | IoU50 | IoU75 | 10 cm | 10° | 10° 10 cm |
|---|
| CAMERA25 | 35.2 | 6.7 | 33.6 | 80.1 | 28.2 |
| REAL275 | 31.5 | 6.3 | 41.0 | 56.3 | 25.7 |
三个观察:
- 10° 单独指标明显高于联合 10° 10 cm,translation 是重要瓶颈;
- IoU75 只有 6–7 左右,严格尺度 / 位置对齐仍困难;
- synthetic CAMERA25 的 rotation 好于 REAL275,体现 sim-to-real 与单目深度泛化问题。
Wild6D 用于跨域泛化测试,模型不在该数据集训练。它支持“有一定跨数据集能力”,不等于跨任意新类别。
6. 速度与部署
论文报告 RTX 3090 上约 26.3 FPS。这个数字应与以下组件一起理解:
- instance mask 是否计入;
- DINOv2 depth 是否计入;
- DDIM steps 数;
- 每图对象数量;
- 是否采样多个 hypotheses。
降低 diffusion steps 能提升速度,但可能牺牲去噪质量,是最直接的工程旋钮。
7. 局限与改进方向
- 深度质量是显式瓶颈;物体边缘、透明面与反光面会产生错误点云。
- 依赖 mask 和相机内参,不是端到端开放场景系统。
- 类别级 canonical frame 仍需定义,跨类别对称规则复杂。
- 单目 metric scale 不可从任意图像稳定恢复,需要数据先验。
- 可进一步引入 multi-hypothesis ranking、uncertainty calibration 或 test-time geometric consistency。
8. 精读结论
MonoDiff9D 不是“diffusion 替换回归头”这么简单:它先把 RGB 转成带噪三维条件,再学习 9D pose 的条件分布。实验显示 rotation 已有竞争力,但严格 IoU 和联合 translation 指标仍低,恰好说明单目 metric geometry 才是系统上限。