论文精读笔记:Monocular Vehicle Pose and Shape Reconstruction via Dynamic Context Adaptation and Progressive Geometry Refinement
1. 基本信息
2. 一句话定位
MonoVPR 不是单纯的 vehicle 6D pose regressor,而是一个 pose-shape 联合重建框架:HDCA 用多尺度上下文减少 translation ambiguity,BIMR 用 template mesh 和多步 bounded offset refinement 恢复更完整的车辆几何。
2.1 论文图表导读
| 图表 | 内容 | 阅读重点 |
|---|
| Figure 1 | 远距离车辆、既有方法与 MonoVPR 的问题对比 | 论文将失败归因于多尺度上下文不足和单步形变不稳定 |
| Figure 2–4 | 总体 pipeline、GDA、BIMR | 观察 pose 与 shape 分支如何共享 object-centric feature |
| Table 1 | ApolloCar3D 主结果 | 注意 A3DP-Abs / Rel 同时衡量 translation、rotation、shape |
| Table 2–5 | HDCA/BIMR、迭代次数、GDA、不同距离的消融 | 验证模块收益是否来自完整组合 |
| Table 6–7 | 计算开销与 shape fusion weights | 判断性能提升与部署成本的权衡 |
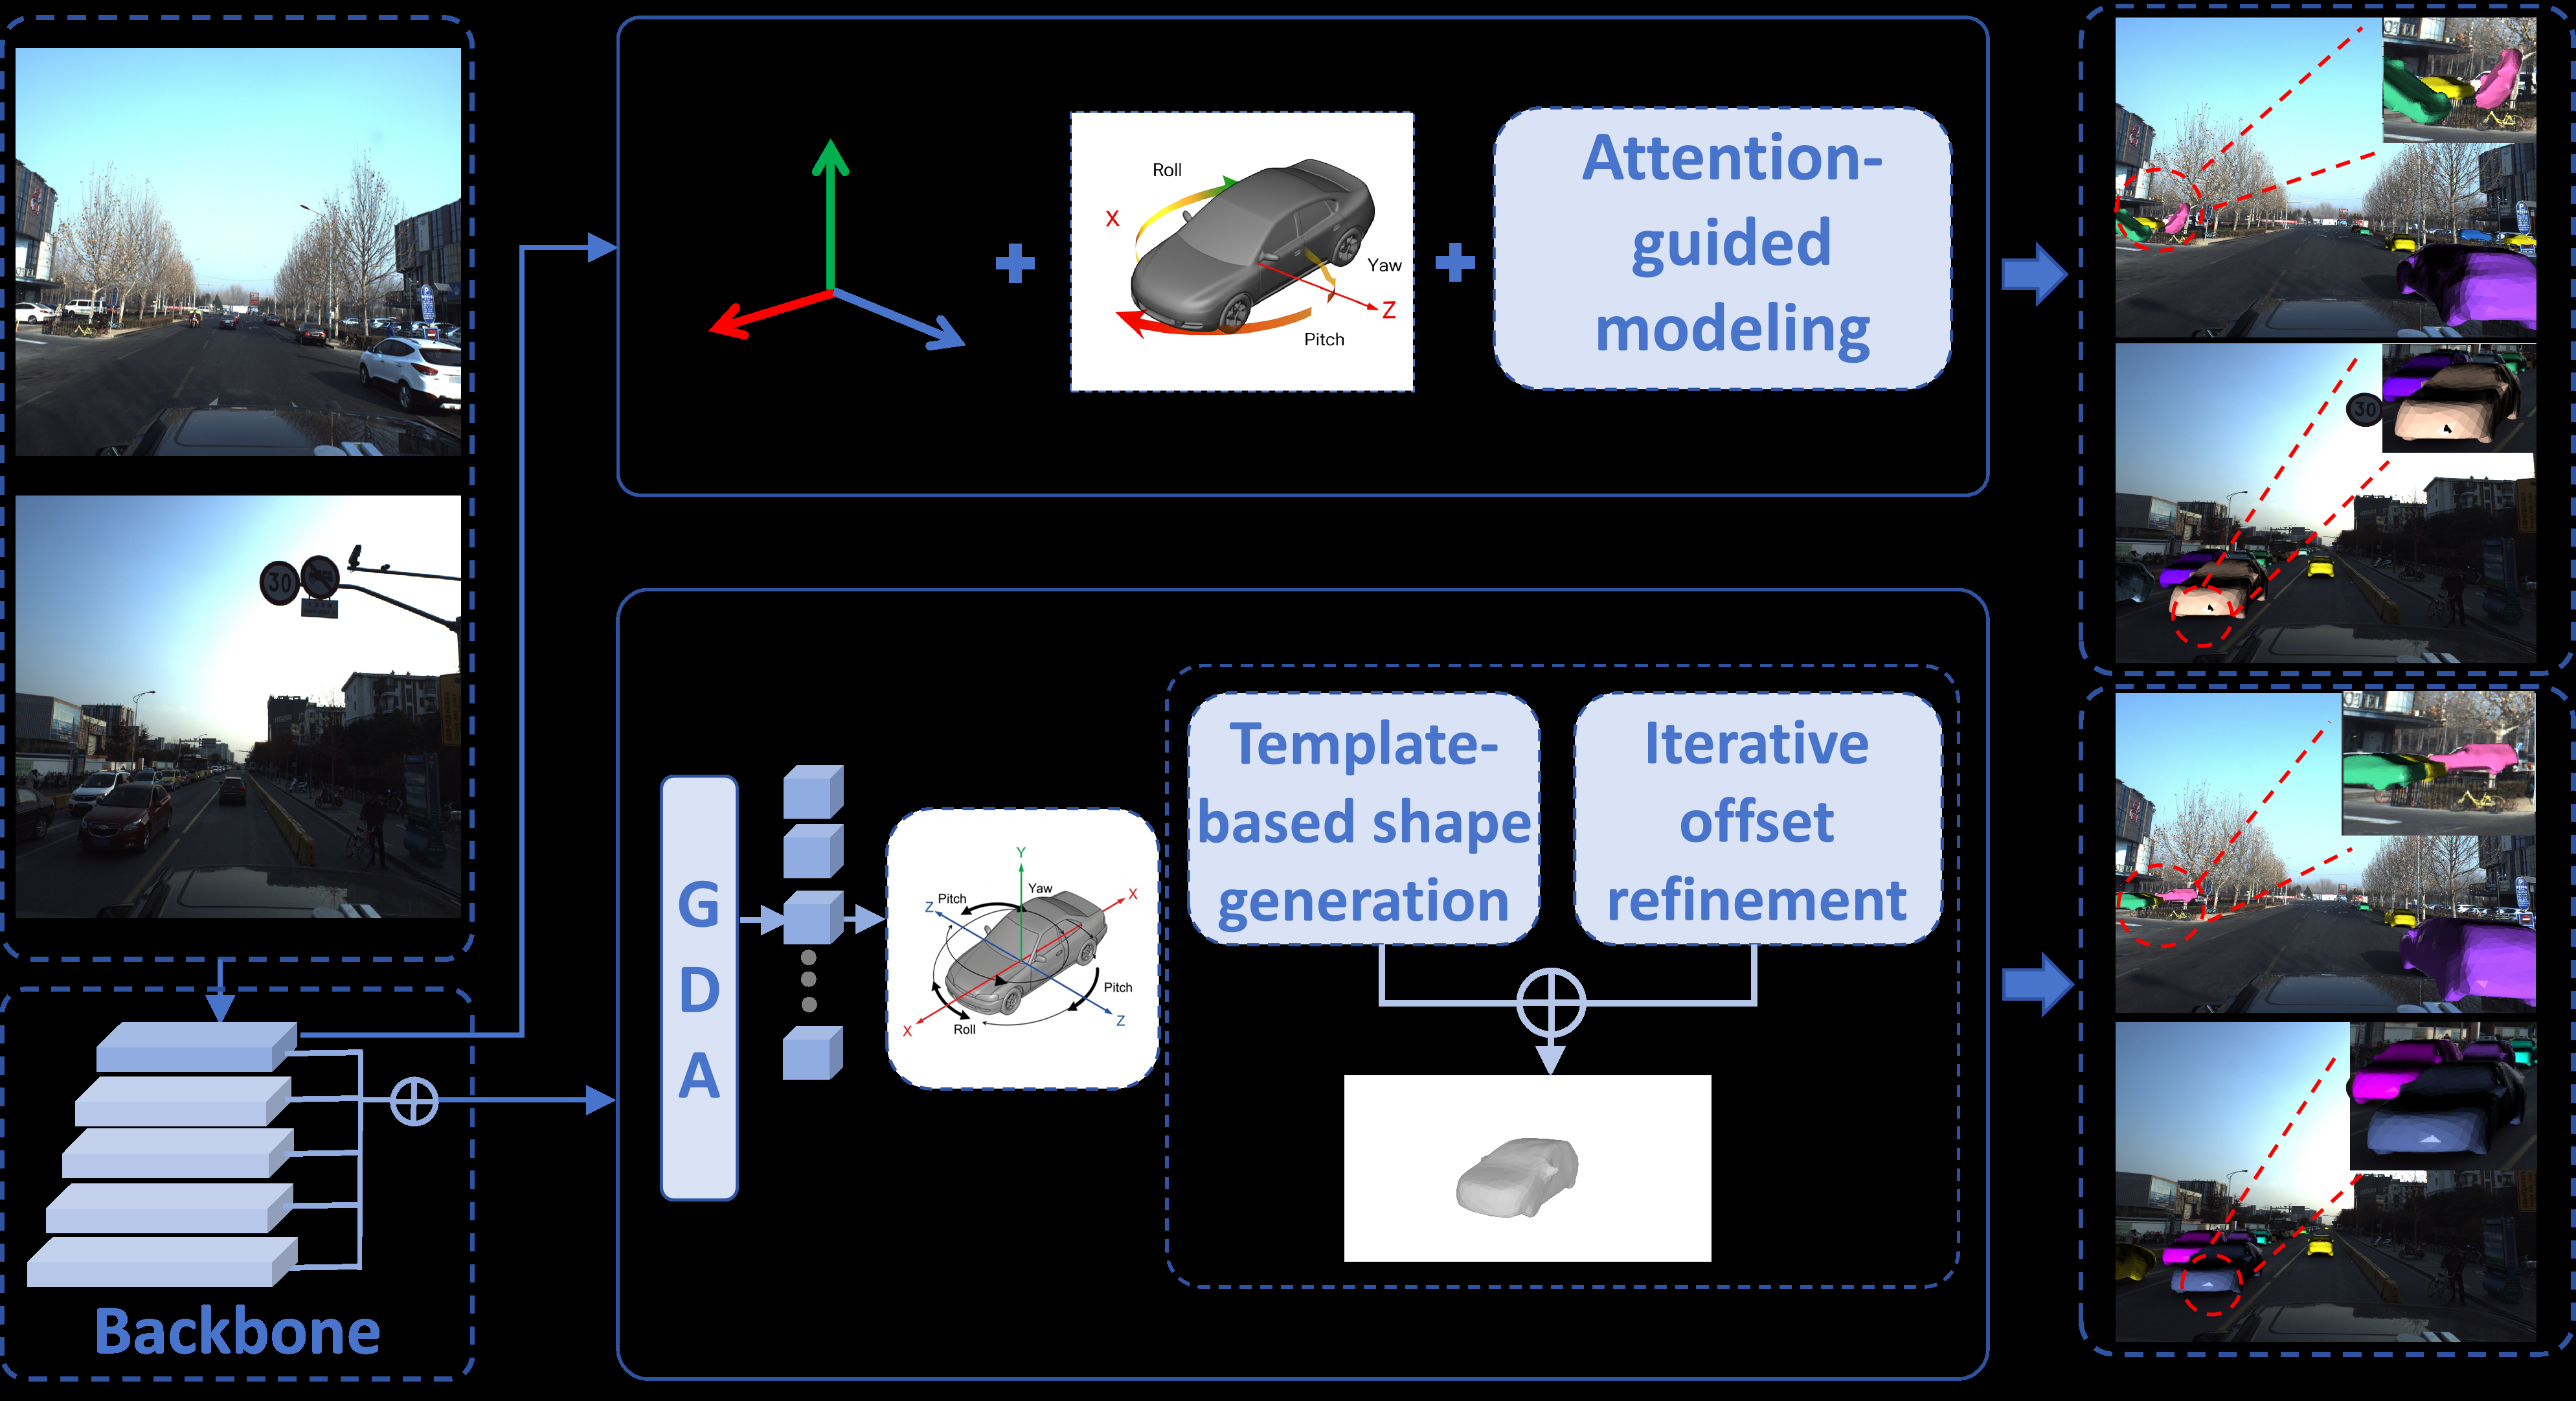 原论文 Figure 1:远距离单目车辆 pose / shape 重建中既有方法与 MonoVPR 的问题对比。来源:AAAI 官方 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 输入是单张 monocular RGB image,先由 2D detector 得到车辆实例、keypoints 和 visibility scores。
- 输出包括 3D translation、3D rotation 和车辆 mesh shape;论文更接近 monocular 3D reconstruction + pose estimation,而不是通用 BOP object pose。
- ApolloCar3D 提供 industry-grade real-scale CAD model 和 dense semantic keypoints,保证 shape supervision 与 pose evaluation。
- 不需要 depth / LiDAR 作为推理输入,但仍需要相机模型和训练阶段的 3D 标注。
- 单图 translation 存在 depth-scale ambiguity;shape estimation 还面临模板形变和非刚性外观差异。
- 论文默认目标主要是车辆,场景中的 inter-object relation 和 global scene context 可作为先验。
4. 研究脉络
- DeepMANTA、3D-RCNN 等早期方法使用 CAD library 或 PCA shape subspace。
- RoI-10D、GSNet、BAAM 将 RGB、2D keypoints、场景上下文和 shape prior 引入车辆 3D 重建。
- MonoVPR 延续 BAAM 的多任务 pose/shape 思路,但将“上下文不足”和“单步 mesh deformation”分别拆成 HDCA 与 BIMR 两个主要问题。
- 与纯 3D detection 的区别是:MonoVPR 输出 mesh-level shape,并用 shape overlap / vertex geometry 评价,而不是只预测 3D box。
5. 研究动机
作者的核心判断
- 远距离车辆需要融合 local detail 与 global scene semantics,而不是只依赖 coarse feature map。
- 单步预测所有 vertex offsets 对形状误差过于敏感,应该用多步小幅更新。
- template prior 与 instance-specific offset 需要 learnable fusion,而不是固定加权。
我的分析
论文把 shape recovery 当成 pose estimation 的几何约束,而不是独立的 reconstruction head。这样做的优点是 shape 与 pose 可相互校验;风险是模型高度依赖车辆类别先验和 dense CAD annotation。
6. 方法详解
6.1 总体 Pipeline
- Res2Net + BiFPN 从 RGB image 构建 feature pyramid。
- 2D detector 提取 vehicle instances、2D keypoints 和 visibility。
- 将检测结果编码为 object-centric feature Xo。
- HDCA 先用多尺度融合构造 scene representation,再通过 GDA 的 Local Detail Path(LDP)与 Global Gated Path(GGP)组合局部细节和全局统计。
- 进一步用 inter-object relation attention 与 scene-object cross-attention 得到 context-aware feature X~t。
- rotation 由 object feature 直接回归,translation 使用增强后的 context representation。
- BIMR 通过 template-based shape generation 得到 Mbase,并以 iterative offset branch 得到 O(T)。
- 用 learnable weights 融合 mesh,输出最终 pose 和 shape。
6.2 关键模块
| 模块 | 输入 | 输出 | 作用 | 与下一模块如何衔接 |
|---|
| Object-centric feature | detector、keypoints、visibility | Xo | 把实例外观和 2D 几何编码到统一表示 | 进入 HDCA 和 shape branch |
| GDA / HDCA | multi-scale feature pyramid | context-aware feature | 通过 LDP + GGP 融合 local detail 与 global semantics | 用于 translation / context fusion |
| Inter-object relation attention | object features | relation-aware feature | 建模多个车辆之间的空间关系 | 与 scene-object attention 残差融合 |
| Template shape generation | shape concept、basis | Mbase | 提供有结构的初始 mesh | 与 offset branch 融合 |
| Iterative offset refinement | Xo∗、previous offset | O(T) | 多步修正 instance-specific geometry | 通过 tanh update 限制形变 |
| Learnable shape fusion | Mbase、O(T) | Mfinal | 动态平衡模板先验和实例细节 | 与 pose 输出共同评估 |
6.3 BIMR 的关键更新
论文的 bounded update 为:
O(t)=O(t−1)+0.5tanh(ΔO(t)).
因此每一步的 vertex correction 被限制在稳定范围内。最终 mesh 近似写作:
Mfinal=w1Mbase+w2O(T).
论文消融显示 T=3 最优;继续增加到 4 次会出现退化,说明 refinement 并非越多越好。
6.4 训练方式与监督信号
- 两阶段训练:第一阶段使用 BAAM 预训练模型,第二阶段使用完整多任务目标端到端 fine-tune。
- 总损失:
Ltotal=λdLd+λtLt+λrLr+λshapeLshape+λ3DL3D.
- translation 使用 XY L1 和 uncertainty-aware depth L1;rotation 使用处理角度周期性的 cyclical L1;shape 用 mesh vertex L2;L3D 在 rotation-only、translation-only 和 final world space 中约束 mesh vertex error。
- 默认权重为 λd=1.0,λt=0.5,λr=1.0,λshape=3.0,λ3D=0.01。
- AdamW、global batch size 4、初始学习率 10−4,最后 10 epochs 衰减到 10−5;使用两张 RTX A6000。
7. 实验分析
7.1 数据集与指标
- ApolloCar3D:4077 training images、200 validation images;每个 vehicle instance 有 CAD model 和 dense semantic keypoints。
- A3DP 同时考虑 translation、rotation 和 shape。A3DP-Abs 使用绝对 translation error,A3DP-Rel 使用相对 translation error;shape 部分通过 100 个视角的 rendered mask mIoU 评估。
- 额外报告 rotation error(RE)、translation error(TE)和 detailed shape。
7.2 主结果
| 方法 | A3DP-Abs mean | A3DP-Rel mean |
|---|
| BAAM(重实现) | 24.20 | 21.93 |
| MonoVPR | 25.60 | 23.26 |
MonoVPR 在 loose / strict criterion 以及不同距离尺度上整体优于 BAAM;小目标(d>50m)上的 RE 从 9.64° 降到 8.15°,TE 从 1.61 m 降到 1.58 m,mIoU 从 85.99 提升到 87.62。
7.3 消融实验
| 消融项 | 关键结果 | 我的判断 |
|---|
| baseline → +HDCA | A3DP-Abs 24.20 → 24.72,A3DP-Rel 21.93 → 22.88 | HDCA 对上下文融合有效,但单独收益有限 |
| baseline → +BIMR | A3DP-Abs 25.06,A3DP-Rel 23.18 | mesh refinement 同时改善 pose-shape 耦合 |
| HDCA+BIMR | 25.60 / 23.26 | 两个模块具有互补性 |
| BIMR iterations | T=3 最好,T=4 下降 | 有界迭代需要早停或学习停止准则 |
| GDA | HDCA+GDA 25.60,高于仅 LDP / GGP | 局部细节与全局统计不能互相替代 |
| shape weights | learnable weights 优于固定 w1=w2=1 | 模板先验与实例 offset 的权重应自适应 |
7.4 计算和失败风险
- BAAM:130.99M parameters、10.22G GPU memory。
- MonoVPR:131.16M parameters、11.51G GPU memory;BIMR 本身约 0.93M parameters、0.78G memory。
- 论文没有系统报告 detector false positives、严重遮挡、夜间 / 雨雾和跨城市 domain shift 下的结果。
- 由于依赖 Mask R-CNN 等 2D detector,前端错误会同时污染 pose 与 shape,不能只看后端 head 的性能。
8. 批判性分析
优点
- 统一解释了为什么远距离 pose 和 shape 会一起退化。
- BIMR 的 bounded correction 具有清晰工程意义,可以避免一次性大形变。
- 消融覆盖模块、迭代次数、距离尺度、计算量和融合权重。
缺点与隐含假设
- 任务域非常具体:车辆、CAD template、ApolloCar3D;不能直接外推到通用 object pose。
- shape prior 仍然是核心条件,只是从固定单步 deformation 改成了动态 template + offset。
- 2D detector 仍是外部模块,真正 end-to-end 的场景级 object pose 尚未解决。
真实应用可行性
可作为自动驾驶中的 monocular vehicle geometry module,但在真实部署中需要 detector robustness、camera calibration、long-tail vehicle shape 和 weather adaptation。
9. 未来工作与可改进方向
- 端到端联合检测、pose、shape 与 uncertainty。
- 将 depth foundation model 或 temporal video cue 引入远距离车辆。
- 通过 domain adaptation 处理光照和城市分布变化。
- 研究无 CAD 或可生成 template 的 vehicle shape prior。
- 将 BIMR 的 stopping criterion 从固定 3 steps 改成 confidence-driven iterative refinement。
10. 对我的研究的启发
- 对通用物体 pose,可以借鉴 HDCA 的 object-scene dual context,但将 vehicle-specific shape basis 替换为类别无关几何表示。
- 可以将 pose estimate 的 uncertainty 反馈给 shape refinement,形成 pose-shape mutual correction。
- 评测时除了 ADD / pose error,还应增加 silhouette、visible surface 和 distance-stratified metrics。
11. 待解决问题
- MonoVPR 在 2D detector 漏检、误检和 mask 偏移下的性能是多少?
- template shape basis 是否覆盖长尾车辆,还是只在 ApolloCar3D 分布内有效?
- 论文中的 mIoU 是否能代表 occluded surface 的 3D shape quality?
- 结合视频后,HDCA 与 BIMR 是否能转化为更低延迟的 tracking system?
