论文精读笔记:M‑VTOP
1. 核心判断
论文:MERL publication · PDF
核心问题:工业插入需要毫米以下精度,外部视觉会被夹爪遮挡,触觉只看到局部表面且有 geometric aliasing,单一传感器很难同时满足全局可观性与局部精度。
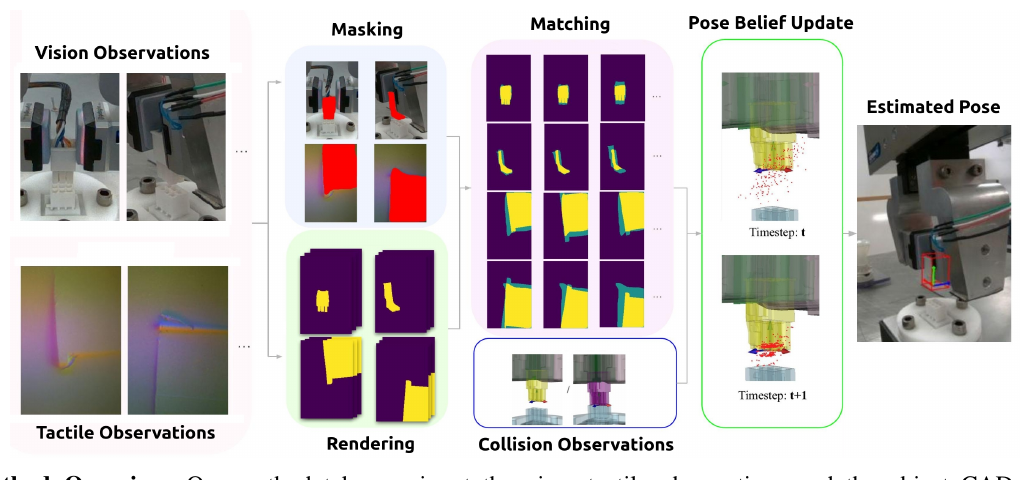
核心回答:把所有视觉 / 触觉观测转成几何 mask,以 CAD renderer 为统一 forward model,在 pose particle filter 中用 IoU 和接触 signed distance 做概率融合。
我的判断:这篇工作最成熟的是模块化接口与真实插入闭环,而不是一个新的深网络。完整融合的优势在仿真和真实 success rate 上都清楚,但端到端只有 0.4 Hz,真实每格只有 3 次抓取姿态,100% 成功率需谨慎解读。
2. 问题设定
目标是估计抓持对象在世界 / 传感器标定坐标中的 x ∈ S E ( 3 ) x\in SE(3) x ∈ S E ( 3 ) N V N_V N V N T N_T N T c ∈ { 0 , 1 } c\in\{0,1\} c ∈ { 0 , 1 }
已知量:
对象 CAD;
相机与触觉传感器内参、外参;
机器人与环境 / receptacle 几何;
end-effector 运动 u k u_k u k
对象是刚体,外部碰撞只发生在抓持物与环境之间。
因此论文的 zero-shot 指“不针对每个新 CAD 重训 pose estimator”,不是 model-free。系统精度仍受 CAD tolerance、标定误差、夹爪模型和 receptacle 安装误差限制。
3. 为什么选择 mask 作为公共观测
RGB camera 与 GelSight RGB 的 appearance domain 差异很大,直接做 feature fusion 需要大量跨模态训练。M‑VTOP 将二者都压缩成 binary object mask:
丢掉纹理 / 光照差异,保留轮廓几何;
renderer 能从任意 pose 与已知 CAD 生成同类型预测;
传感器数量和位置改变时,后端只增加观测项;
缺点是颜色、局部纹理、法向和细粒度深度信息没有直接进入 likelihood,几何相似物仍会 alias。
原论文 Figure 2:每个 pose particle 都在各相机中渲染 object / occluder mask,与观测 mask 比较后更新 posterior;下一个机器人动作继续传播 belief。来源:M‑VTOP 原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
4. 零样本 mask 选择
SAM2 / Mobile-SAM 可能为一幅图产生多个候选,包括夹爪、背景或对象的一部分。作者不是直接接受最高置信 mask,而是:
在粗 pose 集合 X \mathcal X X
对每个 reference,找到 IoU 最大的候选 mask;
将所有传感器的最佳 IoU 聚合为该 pose 的 score;
选择全局得分最高的 pose 所对应的一组 masks,保证跨模态几何一致。
粒子已经收敛后,为降低成本,promptable backend 放用由 CAD / pose 产生的 query point,不再大规模枚举 mask proposals。GelSight 对细小几何的 zero-shot segmentation 较弱,作者还利用 tactile depth 去除未形变的 contact-free 区域。
这一设计把 CAD prior 提前用于选择观测 ,而不仅是后端求 pose。好处是能过滤无关候选;风险是初始 coarse pose 集没覆盖真值时,错误 geometry prior 会反过来选中错误 mask。
5. Visuo-tactile likelihood
对粒子 x ( n ) x^{(n)} x ( n ) M ^ T , i ( n ) \hat M_{T,i}^{(n)} M ^ T , i ( n ) M ^ V , j ( n ) \hat M_{V,j}^{(n)} M ^ V , j ( n )
s ~ n = ∑ i = 1 N T γ i I o U ( M T , i , M ^ T , i ( n ) ) + ∑ j = 1 N V ν j I o U ( M V , j , M ^ V , j ( n ) ) , \tilde s_n=
\sum_{i=1}^{N_T}\gamma_i\,\mathrm{IoU}(M_{T,i},\hat M_{T,i}^{(n)})
+\sum_{j=1}^{N_V}\nu_j\,\mathrm{IoU}(M_{V,j},\hat M_{V,j}^{(n)}), s ~ n = i = 1 ∑ N T γ i IoU ( M T , i , M ^ T , i ( n ) ) + j = 1 ∑ N V ν j IoU ( M V , j , M ^ V , j ( n ) ) , 再经 temperature softmax 得到 s ( n ) s^{(n)} s ( n )
renderer 显式加入机器人与环境几何,使遮挡后的 reference mask 而不是完整 object silhouette 参与比较。这一点对夹爪遮挡场景非常关键,否则正确 pose 反而会因不可见区域不重合而被低估。
6. Particle filter 与接触 cue
belief 写为
b e l ( x k ) = p ( x k ∣ V 1 : k , T 1 : k , c 1 : k , u 1 : k ) , \mathrm{bel}(x_k)=p(x_k\mid V_{1:k},T_{1:k},c_{1:k},u_{1:k}), bel ( x k ) = p ( x k ∣ V 1 : k , T 1 : k , c 1 : k , u 1 : k ) , 并用 particles { x k ( n ) , w k ( n ) } \{x_k^{(n)},w_k^{(n)}\} { x k ( n ) , w k ( n ) }
w k ( n ) = p ( V k , T k ∣ x k ( n ) ) p ( c k ∣ x k ( n ) ) . w_k^{(n)}
=p(V_k,T_k\mid x_k^{(n)})\,p(c_k\mid x_k^{(n)}). w k ( n ) = p ( V k , T k ∣ x k ( n ) ) p ( c k ∣ x k ( n ) ) . 视觉触觉项直接取 s k ( n ) s_k^{(n)} s k ( n ) ϕ ( x ) \phi(x) ϕ ( x )
π ( x ) = σ ( τ − ϕ ( x ) σ d ) . \pi(x)=\sigma\!\left(\frac{\tau-\phi(x)}{\sigma_d}\right). π ( x ) = σ ( σ d τ − ϕ ( x ) ) . 检测到接触时取 p ( c = 1 ∣ x ) = π ( x ) p(c=1\mid x)=\pi(x) p ( c = 1 ∣ x ) = π ( x )
值得注意的是,论文公式在 c = 0 c=0 c = 0
机器人执行 u k u_k u k H ( u k ) H(u_k) H ( u k ) σ H \sigma^H σ H σ L \sigma^L σ L
7. 仿真对比
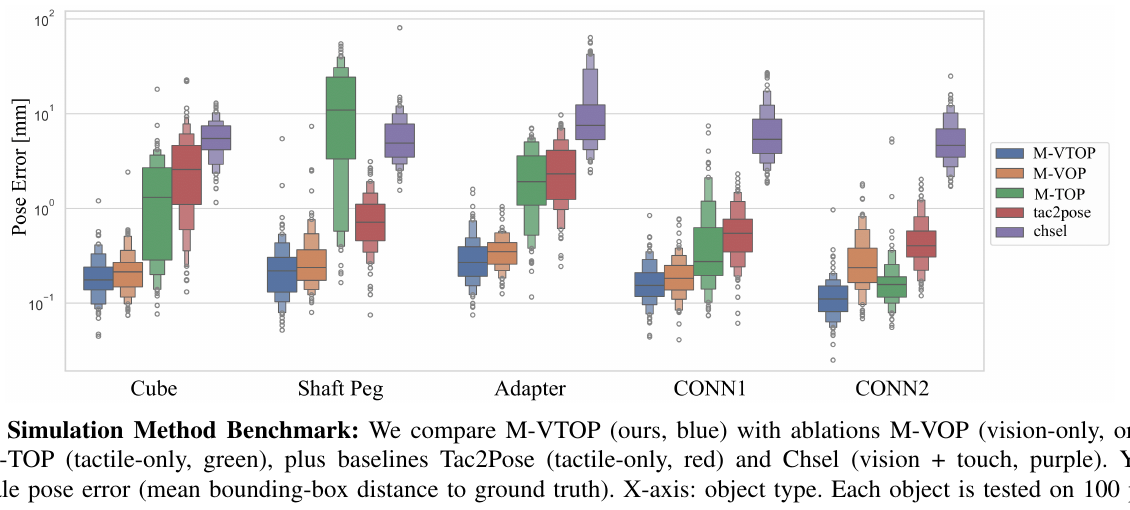
原论文 Figure 4:五个对象各 100 个 pose,纵轴为 log-scale mean bounding-box distance。完整 M‑VTOP(蓝)在所有对象上总体最低;shaft peg 的 tactile-only 因局部几何 aliasing 明显变差。来源:M‑VTOP 原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
对比:
M‑VOP:vision-only;
M‑TOP:tactile-only;
Tac2Pose:需要接触几何训练的 tactile baseline;
Chsel:vision + touch point-cloud baseline;
M‑VTOP:完整融合。
每对象渲染 100 个 pose,并加入小 depth noise。M‑VTOP 在五种几何上总体达到 sub-mm mean bounding-box distance。单独触觉在 shaft peg 上明显失败,因为局部接触 patch 在长条几何的多个位置近似相同;视觉提供全局位置后消除 aliasing。Chsel 对 noisy depth 更敏感,而 mask IoU 丢弃了深度幅值误差。
这项仿真证明“模态互补”,但不能说明真实 segmentation / calibration 下也保持同样 error distribution,因此需要结合下一节 success rate。
8. 真实插入设置
硬件包括:
MELFA Assista manipulator;
Schunk WSG-50 parallel-jaw gripper;
前 / 侧两台 Intel RealSense;
夹爪内侧一对 GelSight Mini。
五对 insertion components:
25 mm wooden cube;
8 × 12 8\times12 8 × 12 NEMA 1–15P plug adapter;
3.81 mm pitch 的 6-pin CONN1;
4.14 mm pitch 的 6-pin CONN2。
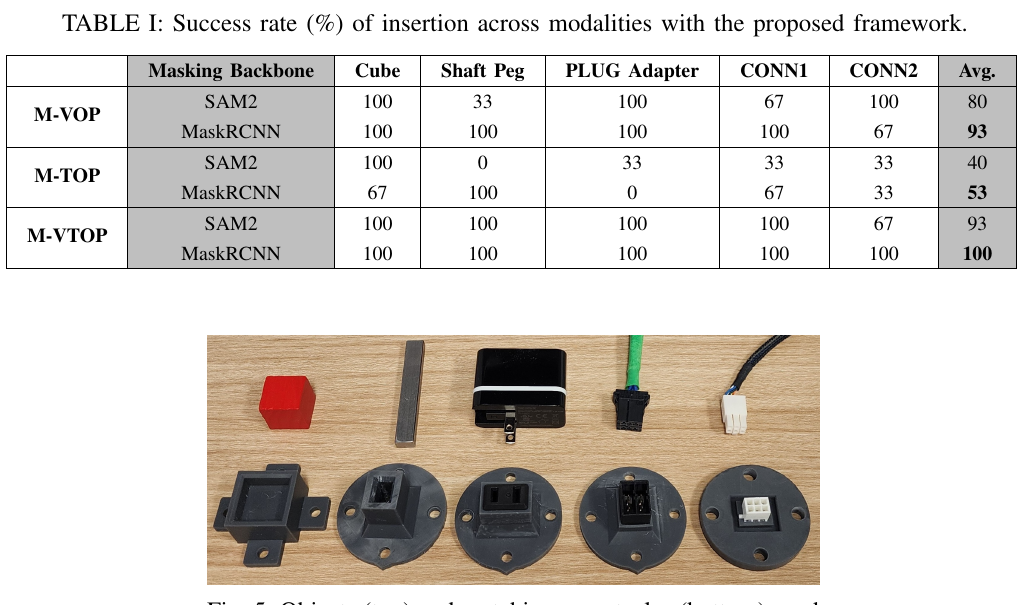
每个对象在三种不同 in-hand translation / rotation 的 grasp pose 下测试;三种 modality(M‑VOP / M‑TOP / M‑VTOP)又分别使用 SAM2 zero-shot 和 in-domain human-labeled Mask R-CNN。最终 pose 真值不是 motion capture,而是对象成功位于 receptacle 时的 nominal configuration。
9. 成功率与精度
原论文 Table I 与 Figure 5:完整融合用 SAM2 达 93%、用监督 Mask R-CNN 达 100%;每个单元格每对象只有 3 次 grasp pose,33% 即 1/3。来源:M‑VTOP 原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
配置 SAM2 平均成功率 Mask R-CNN 平均成功率 M‑VOP 80% 93% M‑TOP 40% 53% M‑VTOP 93% 100%
融合最稳定,但样本量需要还原:5 个对象 × 每对象 3 个 grasp pose,即每一行 / backend 共 15 次。100% 是 15/15,不等于已证明工业级 failure probability。
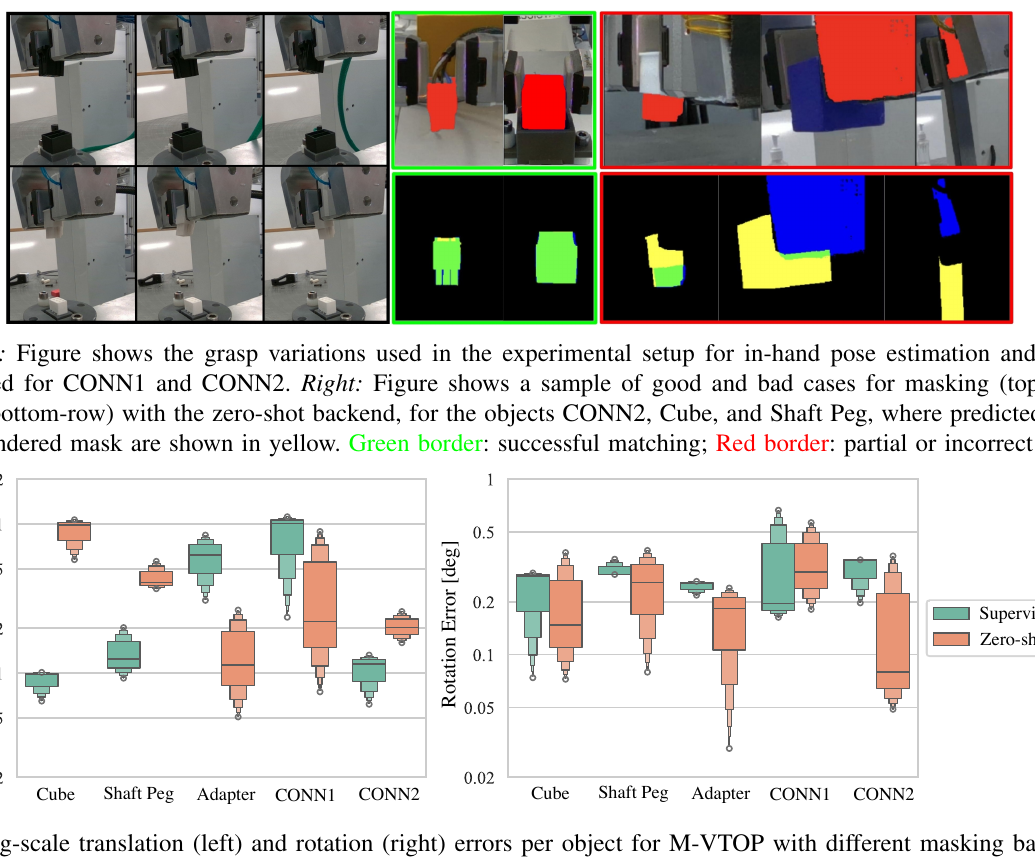
原论文 Figure 6–7:上方展示 zero-shot mask / matching 的成功与失败案例;下方给出监督和零样本 backend 的 log-scale 最终误差,论文据此报告 sub-mm translation 与 sub-degree rotation。来源:M‑VTOP 原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
Figure 7 的多数最终 translation error 低于 1 mm、rotation error 低于 1°,但不同对象差异显著:
cube zero-shot translation 较监督 backend 大;
shaft peg 的低视觉对比导致 segmentation failure;
electrical connectors 对 yaw / roll 极敏感,attached cable 还会施加 torque;
CONN2 在 M‑VTOP + SAM2 中仍只有 67%(2/3)成功。
整系统运行频率 0.4 Hz 。对于缓慢闭环 alignment 可以接受,但不能称实时 tracking;主要开销来自对大量 particles 在多传感器中逐一渲染与 proposal matching。
10. 作者讨论中最重要的限制
zero-shot mask 不稳定 :几何、纹理、光照变化会造成 under-segmentation。触觉分辨率决定精度上限 :低分辨率 sensor 可运行,但难满足紧配合插入。binary contact 信息量有限 :真正接触时 particle set 通常已很窄,soft distance cue 难以再移动 posterior。刚体与稳定 grasp 假设 :对象相对夹爪大幅滑动时 motion model 低估不确定性。计算复杂度 :对 particles 线性、对每模态 mask proposals 二次;proposal 数较小时整体近似线性于 particles。已知环境 :FCL signed distance 需要 receptacle / environment geometry 与标定。代码状态 :MERL 提供正式 PDF 和 BibTeX,但截至本站整理时未找到官方完整代码仓库。
11. 复现与改进建议
报告 particle 数量、proposal 数量、每个 renderer / IoU 阶段耗时,定位 0.4 Hz 瓶颈。
用 stratified / learned proposal 或 differentiable pose refinement 替代全量粒子渲染。
把 tactile depth / normal 不只用于 mask cleanup,而加入局部 surface likelihood。
对 c = 0 c=0 c = 0
用 SE(3) 上的 Karcher mean / mode 而非朴素 weighted pose average,避免多峰和 quaternion 平均问题。
扩大真实重复次数,按对象报告置信区间,并用独立 motion capture / calibrated fixture 测最终 6D error。
M‑VTOP 的核心启发是:多模态融合未必必须学习一个庞大联合 embedding。只要每种传感器都有可校准的 forward renderer,就能在统一的几何 belief 空间中组合证据;代价是计算量与模型 / 标定依赖,需要下一步用更高效的 proposal 和连续优化解决。