NeRF-Feat 精读
1. 核心视角:先学参考系,再学对应
经典实例级 pose 方法把 CAD 坐标系当作天然参考系;没有 CAD 时,最困难的不只是几何缺失,还缺少“预测结果究竟相对哪个三维坐标系”的定义。NeRF-Feat 用第一阶段 NeRF 的坐标系解决这个问题:密度场给出对象表面,训练相机位姿把所有图像绑定到同一空间,第二阶段再学习可跨视角匹配的表面特征。
这与直接回归 object coordinate 不同。坐标回归会要求外观相同的对称区域回到唯一坐标,监督本身存在冲突;NeRF-Feat 允许对比学习形成对称等价的特征结构,最终对应可偏向某个一致的对称配置,再交给 PnP。
2. 两阶段方法
2.1 NeRF 几何阶段
Ray generator 根据相机参数采样射线,NeRF block 的 density/color MLP 通过体渲染重建 RGB 与 mask。训练完成后,密度等值面既可以 marching cubes 提取网格,也可沿表面采样点云。这里的关键输出不是漂亮渲染,而是一个与训练 pose 一致的隐式物体坐标系。
2.2 特征阶段
Feature MLP 接收 3D 表面点并输出向量;CNN 对 query/训练图像输出逐像素特征。通过已知相机把表面点投影到图像,可构造正对应;双向对比损失同时约束“像素找点”和“点找像素”,减少单向坐标回归对对称区域的强制区分。
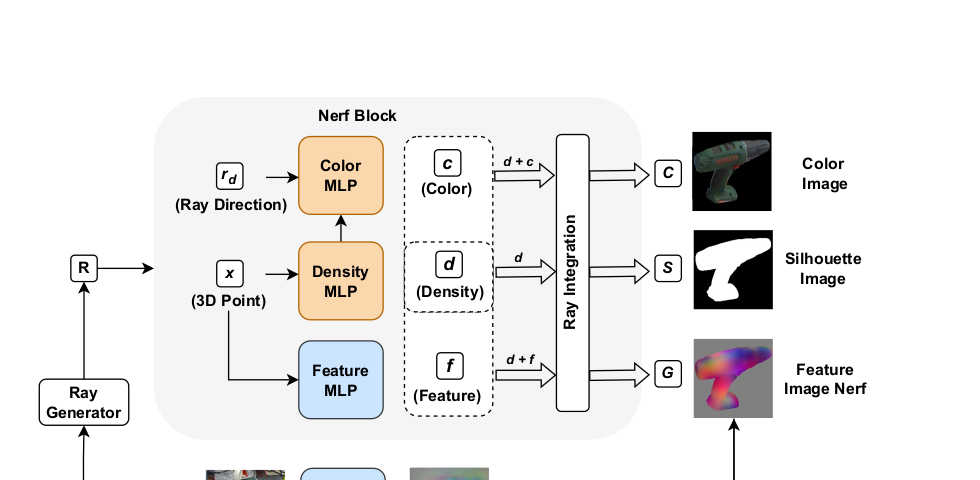 密度场固定几何和参考系,Feature MLP 与 CNN 学习共享描述子;推理阶段不需要再次优化 NeRF。来源:原论文 Figure 1;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
2.3 推理
查询图像先通过 SAM/已有 mask 限定对象区域,再与带特征的 3D 点云做余弦最近邻,产生 2D–3D correspondences,最后使用普通 PnP-RANSAC。RGB-D 版本并非完整 ICP:它只用观测深度与当前渲染深度的中位差,一次性修正相机 z 方向平移。
3. 实验读法
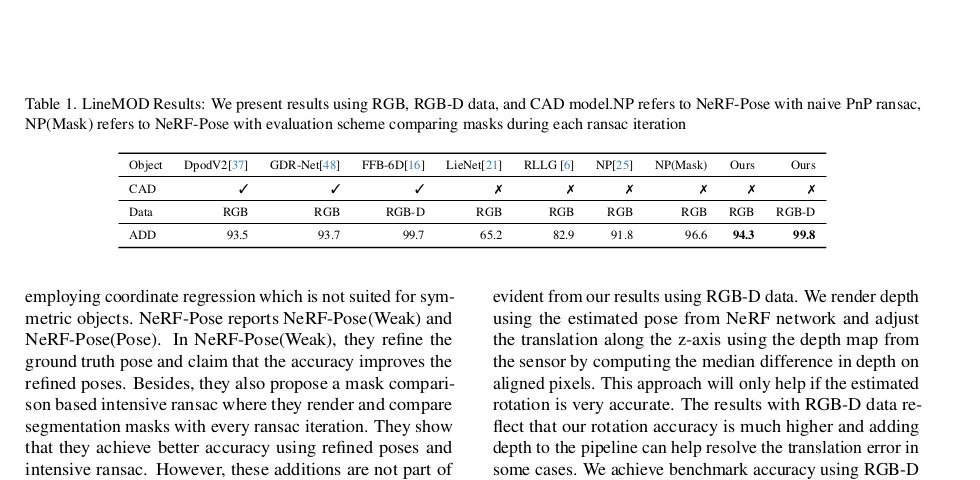 RGB-only 94.3 已接近使用 CAD 的 GDR-Net 93.7;RGB-D 的 99.8 主要说明旋转足够准时,一次深度平移修正就能消除大量 z 误差。来源:原论文 Table 1;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
LINEMOD 的高分不能单独证明强遮挡鲁棒性,因此论文还报告 LM-O:NeRF-Feat RGB 48.3,NeRF-Pose naive PnP 44.1;加入深度后 66.9,接近 FFB-6D 的 66.2。这里更合理的结论是 feature field 改善了对应和旋转,但遮挡下的平移仍是明显瓶颈。
T-LESS 包含大量连续/离散对称物体。NeRF-Feat 的 AR 为 0.58;在连续对称组从 NeRF-Pose 0.48 提到 0.52,离散对称组从 0.58 提到 0.63。提升不算巨大,却支持“双向特征比坐标回归更适合对称”的论点。
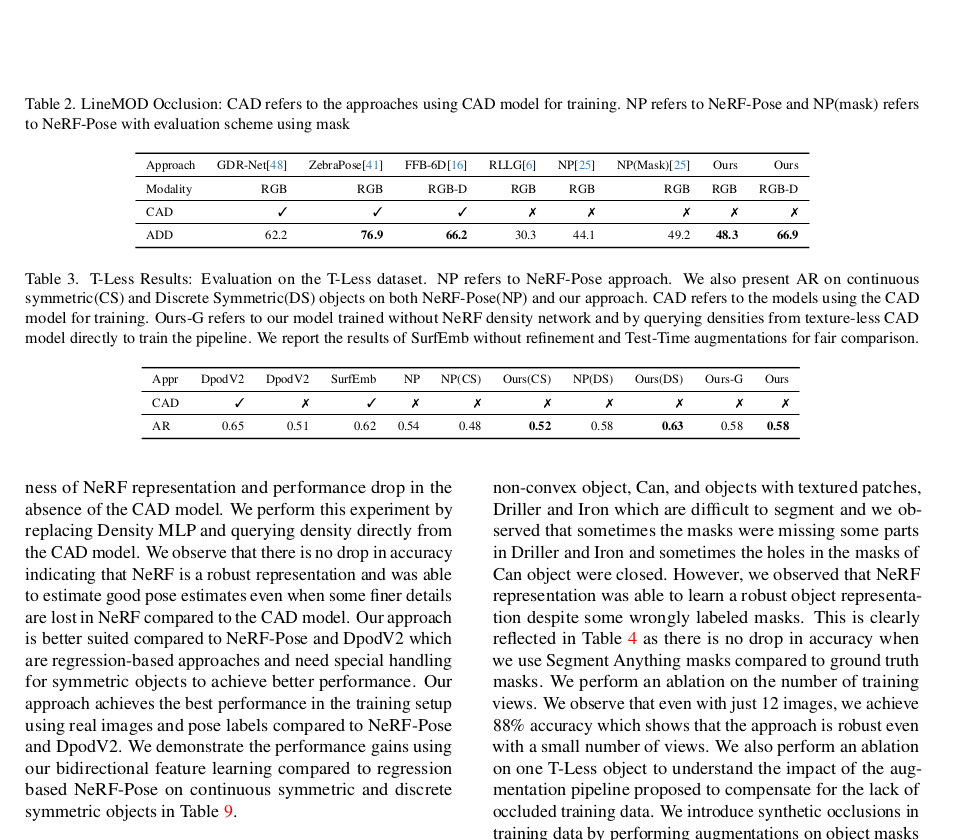 不同数据集使用 ADD 或 BOP AR,数值不可直接混排;应关注同一表内、同一输入与 CAD 条件下的差值。来源:原论文 Tables 2–3;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
4. 有价值的消融
- 12/50/150 个训练视角时,三物体平均 ADD 为 88.2/94.4/98.7,说明表示能在少视角下工作,但最终精度仍随覆盖度上升。
- SAM mask 与真值 mask 在 150 视角下平均结果均为 98.7,表明轻微 mask 噪声不是主瓶颈;该结论只来自 LINEMOD 三个对象。
- 用纹理缺失 CAD 直接提供密度的 Ours-G 与 NeRF 版本都为 0.58 AR,意味着当前 benchmark 上 NeRF 几何已足够,但并不能推导其几何与 CAD 同等精确。
5. 局限与工程判断
实例训练仍需要多视角 pose;神经场训练和 marching-cubes/表面采样增加了 onboarding 时间。最近邻对应没有显式置信度校准,重复纹理、严重遮挡和背景 mask 泄漏仍可能生成高比例错误匹配。对称对象上“偏向一个配置”在 ADD-S/AR 中可能是优点,但对要求确定物理朝向的操作任务未必满足需求。
最值得借鉴的是表示分工:用可渲染几何建立实例参考系,用独立 feature field 服务 pose correspondence。它比让 NeRF 端到端回归 pose 更容易解释、替换和调试。
