论文精读笔记:NOPE
1. 核心判断
NOPE 研究的是一个信息极少的 onboarding 协议:对训练未见的新对象,只给一张 reference RGB;之后从另一张 query RGB 估计相对 rotation。它没有 CAD、depth、多视图扫描或对象级 fine-tuning。
单视图看不到物体背面,pixel-level novel-view synthesis 必然“发明”不可见部分。生成图即使视觉合理,也未必与真实 query 是同一个实例外观,因此不适合作为精确 pose template。NOPE 的关键选择是:
不生成 RGB;
生成候选视角下所有可能外观的 平均判别 embedding ;
以 query 与这些 expected embeddings 的距离构造 pose likelihood;
保留多个高概率峰,显式表示对称、遮挡和未见部位导致的多解。
这条思路让未见类别 top-1 Acc30 达 59.8,top-5 达 87.1;同时 342 个 viewpoints 只需 1.01 s 生成,而 diffusion baseline 3DiM 需要 13 min。
2. 输出到底是不是“6D pose”
输入:
reference image I r I_r I r
query image I q I_q I q
二者都应是以同一对象为中心的 crop。
输出:
Δ R = R q R r ⊤ ∈ S O ( 3 ) , \Delta R = R_q R_r^\top \in SO(3), Δ R = R q R r ⊤ ∈ S O ( 3 ) , 以及离散 SO(3) / viewpoint space 上的概率分布。
论文不估计:
metric translation;
object scale;
detection / segmentation;
camera-space absolute pose,除非外部已知 reference absolute rotation。
因此标题中的 pose 应严格理解为 single-reference relative 3D rotation 。把 NOPE 与 BOP 的完整 R , t R,t R , t
3. 训练:预测 embedding,而非像素
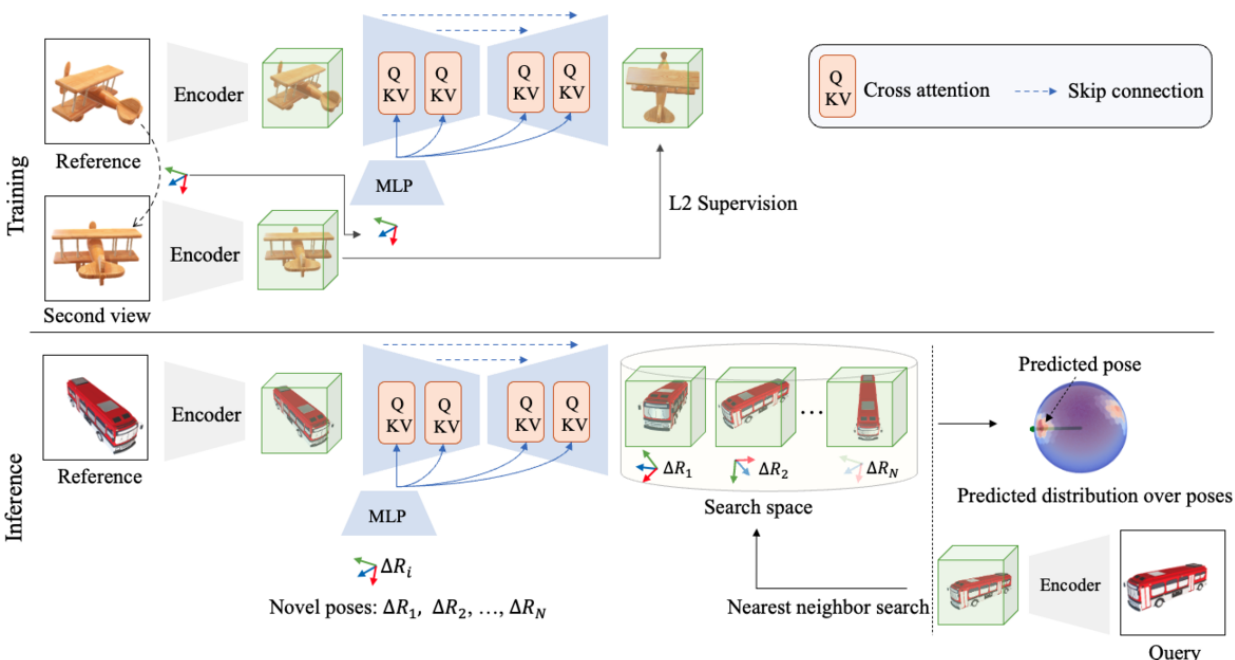
原论文 Figure 3。训练时 reference embedding 与 relative pose condition 预测 second-view embedding;测试时对 342 个 candidate rotations 一次生成 embeddings,与 query embedding 最近邻匹配。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
冻结预训练 VAE encoder E E E
e r = E ( I r ) , e q = E ( I q ) , e_r=E(I_r),\qquad e_q=E(I_q), e r = E ( I r ) , e q = E ( I q ) , embedding 空间大小为 32 × 32 × 8 32\times32\times8 32 × 32 × 8
MLP 将目标 relative rotation Δ R \Delta R Δ R
e ^ q = F ( e r , Δ R ) . \hat e_q = F(e_r,\Delta R). e ^ q = F ( e r , Δ R ) . 监督是简单 L2:
L = ∥ F ( e r , Δ R ) − e q ∥ 2 2 . \mathcal L=\|F(e_r,\Delta R)-e_q\|_2^2. L = ∥ F ( e r , Δ R ) − e q ∥ 2 2 . 训练 batch 包含同一对象的两幅图和真值相对 rotation。VAE frozen,只有 U-Net 与 pose MLP 更新。
为什么 L2 平均反而有用
给定 reference 与目标 rotation,不可见部分存在多个可能真实外观。L2 最优预测趋向 conditional mean:
F ( e r , Δ R ) ≈ E [ e q ∣ e r , Δ R ] . F(e_r,\Delta R)\approx \mathbb E[e_q\mid e_r,\Delta R]. F ( e r , Δ R ) ≈ E [ e q ∣ e r , Δ R ] . 若 query 是该 conditional distribution 的样本,query embedding 到 mean 的平方距离与其 likelihood 相关。NOPE 因而不需要猜出唯一背面纹理,只需要学习“该 pose 下 embedding 应落在哪个统计区域”。
4. 推理与 pose distribution
作者从 regular icosahedron 出发,递归细分两次,得到 342 个 candidate viewpoints:
P = { Δ R 1 , … , Δ R 342 } . \mathcal P=\{\Delta R_1,\ldots,\Delta R_{342}\}. P = { Δ R 1 , … , Δ R 342 } . 对每个候选生成 e ^ i = F ( e r , Δ R i ) \hat e_i=F(e_r,\Delta R_i) e ^ i = F ( e r , Δ R i )
i ⋆ = arg min i ∥ e ^ i − e q ∥ 2 . i^\star=\arg\min_i\|\hat e_i-e_q\|_2. i ⋆ = arg i min ∥ e ^ i − e q ∥ 2 . 距离经归一化转为 p ( Δ R i ∣ I r , I q ) p(\Delta R_i\mid I_r,I_q) p ( Δ R i ∣ I r , I q )
这里的 uncertainty 是由 embedding similarity 诱导的离散分布,不是经过 calibration 的概率,也不直接给置信区间覆盖率。
5. ShapeNet 类别不重叠 benchmark
训练集:
13 类:airplane、bench、cabinet、car、chair、display、lamp、loudspeaker、rifle、sofa、table、telephone、vessel;
每类随机 1000 instances,共 13k。
测试:
seen-category novel instances:每个训练类别 50 个新实例;
10 个完全未见类别:bottle、bus、clock、dishwasher、guitar、mug、pistol、skateboard、train、washer;
每个未见类别 100 models;
每个模型渲染 5 references 与 5 queries。
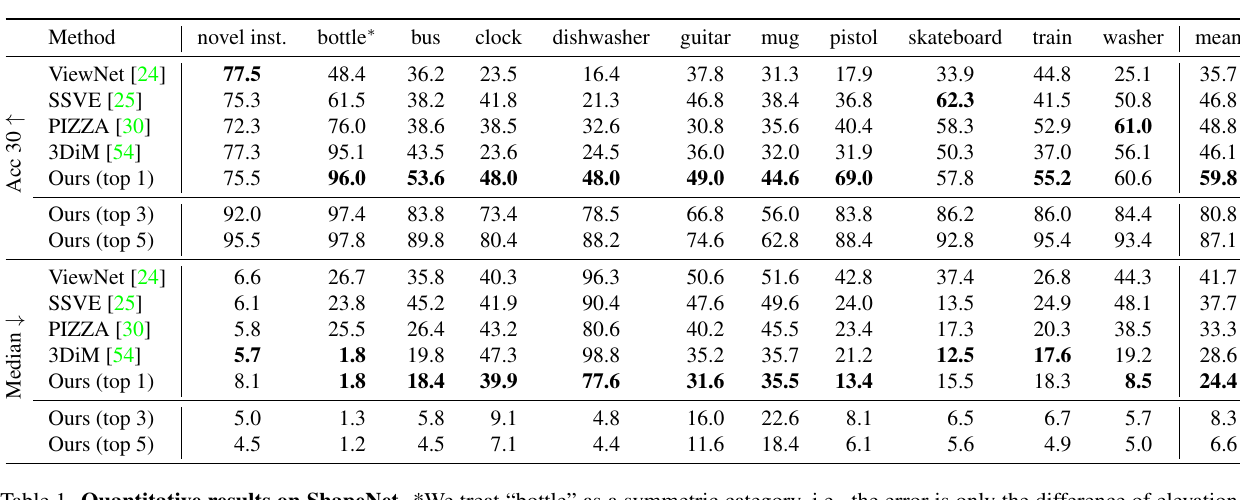
原论文 Table 1。top-k 评价检查真值是否落入概率最高的 k 个候选;top-5 大幅提升揭示不少误差来自对称 / 多峰,而非所有候选都偏离真值。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
未见类别 mean:
方法 Acc30 ↑ Median ↓ ViewNet 35.7 41.7° SSVE 46.8 37.7° PIZZA 48.8 33.3° 3DiM 46.1 28.6° NOPE top-1 59.8 24.4° NOPE top-3 80.8 8.3° NOPE top-5 87.1 6.6°
top-1 比 PIZZA +11.0 Acc30、median -8.9°。但 dishwasher top-1 median 77.6°、clock 39.9°、mug 35.5°,说明近似对称和局部细节仍难。top-5 把 dishwasher 降到 4.4°,证明分布中常已有正确 mode,只是最大峰选错。
6. T-LESS:信息量不同的比较
T-LESS 单 reference:
方法 额外输入 Seen Novel Avg VSD recall CAD-based Nguyen et al. GT CAD 60.15 58.70 59.57 CAD-based MultiPath GT CAD 43.17 43.33 43.24 PIZZA, all views 1 RGB reference 20.05 15.90 18.39 NOPE, all views 1 RGB reference 47.03 45.69 46.49 NOPE, front views 1 RGB reference 49.30 48.46 48.96
NOPE 显著优于同协议 PIZZA,并超过 CAD-based MultiPath;但仍低于最强 GT-CAD method。front-view reference 更好,说明 reference 是否展示区分性结构会影响上限。
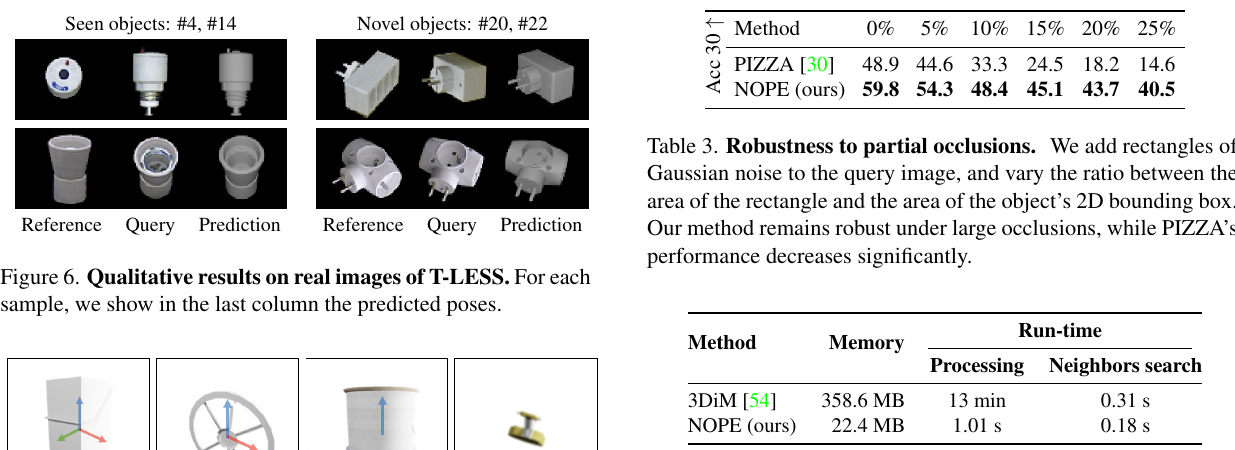
原论文 Figure 6、Table 3–4:T-LESS seen / novel 对象均可由单参考预测;遮挡 25% 时 Acc30 仍为 40.5,生成 342 views 的 embeddings 只占 22.4 MB、1.01 s。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
遮挡实验:
query bbox 遮挡比例 0% 5% 10% 15% 20% 25% PIZZA Acc30 48.9 44.6 33.3 24.5 18.2 14.6 NOPE 59.8 54.3 48.4 45.1 43.7 40.5
NOPE 从 0→25% 降 19.3 points,PIZZA 降 34.3;embedding template matching 对局部遮挡较稳。
runtime(单 V100):
NOPE candidate generation:1.01 s;
nearest-neighbor:0.18 s;
storage:22.4 MB;
3DiM generation:13 min,358.6 MB。
这说明 NOPE 相对 diffusion synthesis 极快,但完整单对象 1.19 s 仍不是实时视频 tracking。
7. 定性结果与失败模式
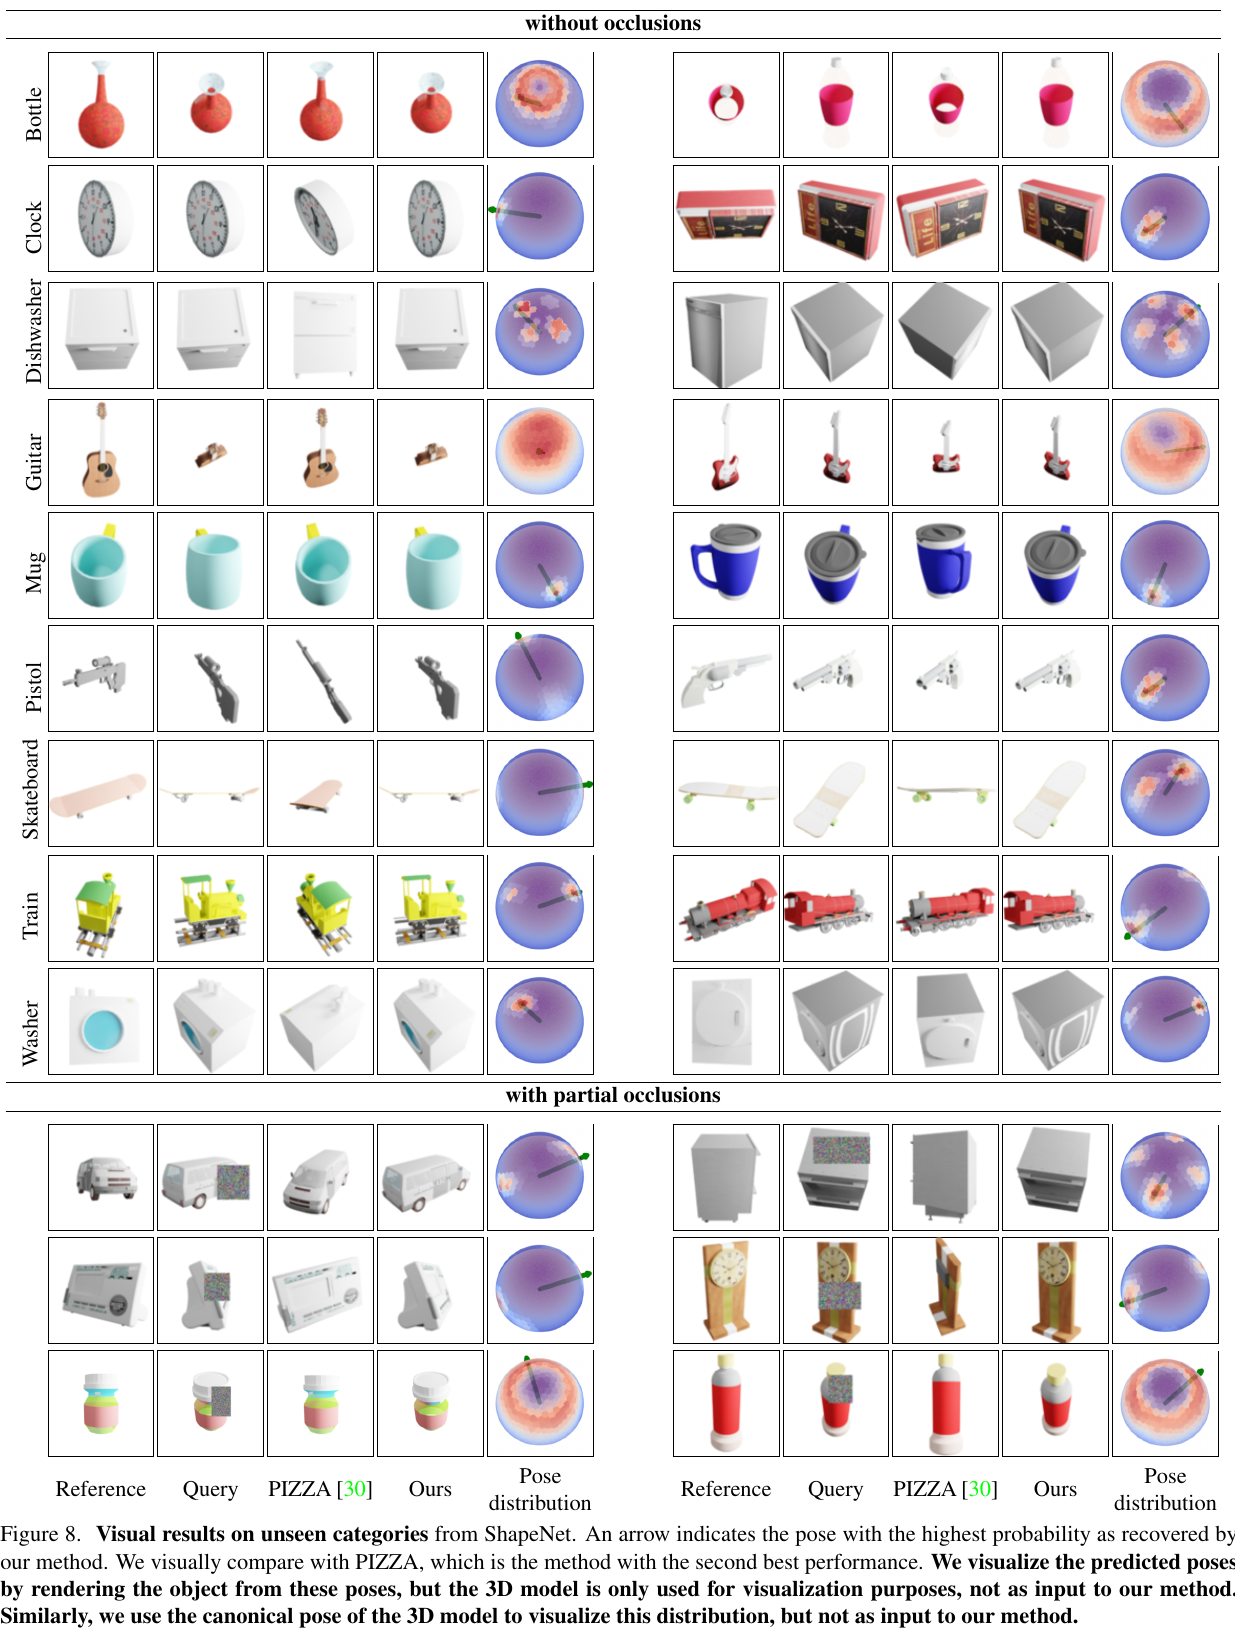
原论文 Figure 8:每组依次为 reference、query、PIZZA、NOPE 与 pose distribution;底部遮挡样例仍保留正确 mode。3D mesh 只用于把预测 rotation 渲染出来,不是 NOPE 输入。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
失败集中在:
dishwasher、clock:整体近似对称,只有小部件破坏对称;
mug:handle 在 reference 或 query 不可见;
guitar:某些视角投影极细,外观信息弱;
reference 本身缺乏区分性;
离散 342 viewpoints 的最近邻分辨率有限。
对称不是统一问题:bottle 的连续轴对称可由环状 distribution 表达;“几乎对称”的 dishwasher 会产生多个相近但不等价的峰,top-1 更容易错。
8. 与 NOPE 相邻的路线
对 PIZZA:PIZZA 直接回归相邻帧相对 pose,NOPE 显式生成 viewpoint embeddings 并搜索,可处理更大视角差与多峰。
对 DVMNet:二者都是双 RGB、无 CAD 的 relative rotation;DVMNet 以 3D voxel correspondence 闭式求解,NOPE 在离散 pose space 检索并输出分布。
对 novel-view diffusion:后者优化像素真实性,NOPE 优化 pose discrimination;目标不同。
对 Oryon:Oryon 需要两幅 RGB-D + text,可估相对 R , t R,t R , t
9. 局限与复现检查
object crop 是给定的,未评检测 / 分割误差;
不输出 translation 或 scale;
reference quality 是系统变量,真实 onboarding 可能需要主动选择视角;
342-view discretization 与 top-k protocol 会放大多峰收益;
pose likelihood 未做 calibration;
ShapeNet 是合成、物体居中,真实杂乱背景域差只部分由 T-LESS 验证;
训练需 4×V100 约 20 h;
论文未公开代码,复现需重建 frozen encoder、U-Net conditioning 与 viewpoint sampling;
瓶子按对称类别只比较 elevation,必须复现相同 metric;
图中使用 mesh 可视化不能误写成方法使用 CAD。
10. 最终评价
NOPE 最重要的思想不是“单参考模板更多”,而是 在不可辨识问题里不要强迫模型发明唯一外观或唯一 pose;生成对 pose 判别有用的统计 embedding,并把多解保留到输出分布。
类别不重叠 top-1 +11 Acc30、25% 遮挡下 +25.9,以及相对 3DiM 几个数量级的速度差,构成了扎实证据。它离完整 6D pose pipeline 仍有距离:无 translation、无 detector、非实时。但作为 single-reference、CAD-free relative rotation baseline,NOPE 对如何处理单视图不可见性和对称多解给出了清楚且有启发性的答案。