论文精读笔记:OmniPose6D
1. 核心判断
OmniPose6D 实际包含两项紧密相关但应分开评价的贡献:
数据 / 任务贡献 :定义 model-free、monocular RGB、dynamic-scene 中的短期对象相对 pose tracking,生成 4 万条合成序列;方法贡献 :在 CoTracker 上增加针对对象运动的 synthetic fine-tuning、uncertainty classification 与 track selection,再用标准 SfM / COLMAP 求 pose。
方法的价值是把“track any point”转为“选足够稳定且有几何信息的对象点,再做多视几何”。但输出是相对首帧、up to a scale 的 pose;评测还使用真值进行 7-DoF 对齐。它与输入 CAD、输出 metric translation 的 6D pose tracker 不处在完全相同的问题设定中。
2. 任务边界:这里的 6D pose 是什么
给定单目 RGB 窗口 { I t } t = 1 8 \{I_t\}_{t=1}^{8} { I t } t = 1 8
mask propagation 大体能持续覆盖同一对象;
对象表面有可追踪纹理;
窗口内有足够视差 / 旋转,能让 SfM 初始化;
对象相对相机运动可被看作“固定对象上的虚拟相机运动”。
SfM 无法从单目观测恢复绝对尺度,所以 translation 只确定到一个全局 scale。对象动、相机动或两者同时动在观测上都表现为相对运动;论文并不分解 object motion 与 camera ego-motion。
3. OmniPose6D 数据集
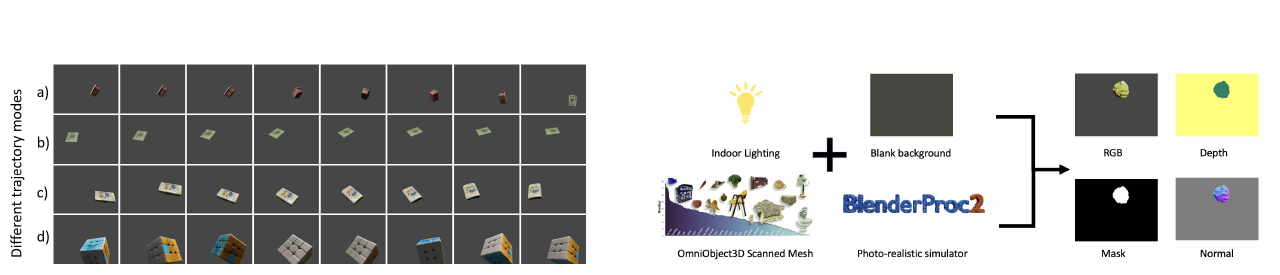
原论文 Figure 2–3。左侧展示四类轨迹,右侧展示扫描 mesh、灯光、空白背景与 BlenderProc 生成的 RGB / depth / mask / normal。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
3.1 规模与对象
40,000 sequences;
每条 100 frames,合计约 4,000,000 frames;
OmniObject3D 扫描网格经 Blender 清理和降面后保留 4,000+ meshes;
覆盖 203 categories,其中 21 类留作 validation;
每条序列只含一个前景对象。
与 ShapeNet 的人工 CAD 相比,OmniObject3D 扫描物体有更真实的几何和纹理;但训练渲染使用 blank background,场景层面的真实性主要靠 crop / mask 设定绕开,而不是完整室内合成。
3.2 四类运动
每类 10,000 sequences:
Random Walk :固定相机,对象在三维空间随机运动;Circling Camera :相机以不同高度和视角绕对象;Noisy Trajectory :在环绕轨迹上加入扰动;Real Dataset Trajectories :从 HO3D training split 提取手—物交互轨迹,切成短段后迁移到不同 mesh。
第四类轨迹让合成运动分布接近真实交互,但也意味着 HO3D 训练轨迹被用于数据生成。论文在 HO3D official evaluation set 测试,split 层面没有直接使用测试 pose;仍应将结果理解为 domain-targeted synthetic pretraining,而非完全无关域泛化。
3.3 标签与增强
BlenderProc 输出 RGB、depth、pose、normal、instance segmentation。训练 point tracks 由首帧 mask 的 grid point 通过真值 depth / pose 投到其他视图;depth consistency 与 cycle projection error 决定 visibility。
为模拟手或其他物体遮挡,作者在 mask 边界画随机扰动黑圆,半径为 mask 尺寸的 0.1–0.5;还使用 color jitter、Gaussian blur、motion blur、shade、flip、随机 crop shift / scale。它们增强了观测噪声,但遮挡形态仍比真实手部连续遮挡简单。
4. 从 mask 到点轨迹
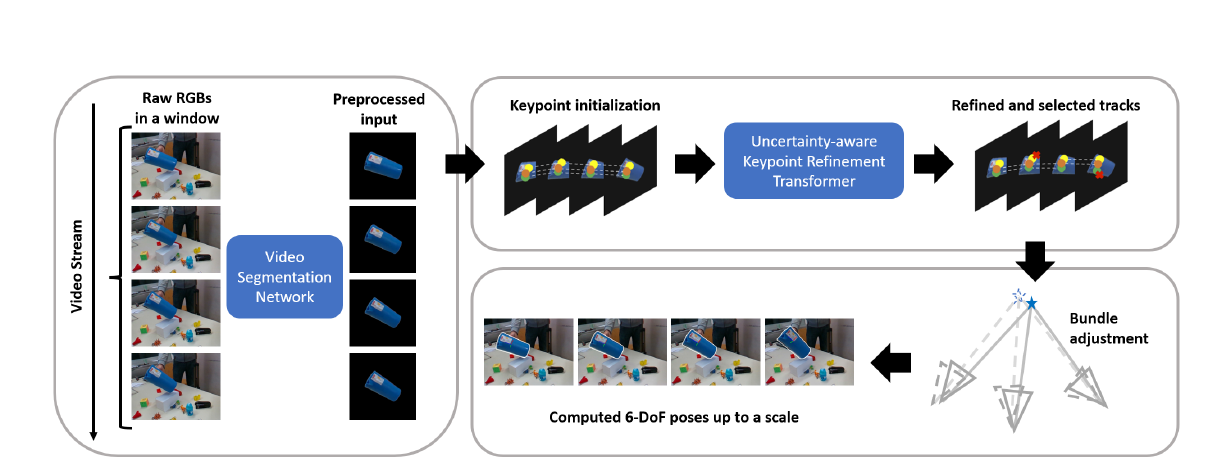
原论文 Figure 4。Track Anything 传播对象区域;首帧 mask 的 grid points 经 CoTracker-style transformer 细化并按 uncertainty 选择,最后送入 COLMAP bundle adjustment。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
Track Anything 从首帧人工 / 给定 mask 传播后续 mask,并将对象区域 crop 到 512×512。方法并不要求像素级完美分割,因为点轨迹和 uncertainty 会过滤一部分边界错误;但若 mask 长期跟错对象,后面的几何没有全局纠错机制。
训练:
每个 sample 取 N = 8 N=8 N = 8
相邻采样间隔最多 K = 4 K=4 K = 4
初始 mask grid size = 3;
随机选 500 条 tracks 以控制显存;
输入网络分辨率 384×512;
CoTracker CNN 将图像下采样 8 倍,输出 128D feature;
transformer 交替做 temporal 与 group attention,迭代更新 4 次。
推理:
8 帧 sliding window;
grid size = 3,最多随机保留 1,500 tracks;
先由简单 optical-motion threshold 选择有足够运动的 keyframes;
距离变化阈值 t d i s = 2.0 t_{\mathrm{dis}}=2.0 t dis = 2.0 t s c a l e = 1.3 t_{\mathrm{scale}}=1.3 t scale = 1.3
过于静止的帧会违反 SfM 的几何条件,因此被过滤。这意味着该 benchmark 偏向“窗口里确实发生了可观测运动”的片段。
5. Uncertainty-aware refinement
网络同时输出:
每点每帧二维位置 P ^ \hat P P ^
visibility v v v
uncertainty level。
点误差 e i e_i e i L 2 L_2 L 2
[ 1 , 3 , 5 , 10 , ∞ ] pixels . [1,3,5,10,\infty]\ \text{pixels}. [ 1 , 3 , 5 , 10 , ∞ ] pixels . uncertainty head 对五档做 softmax,并用 balanced cross entropy 训练。总损失:
L = L keypoint + 5 L visibility + 5 L uncertainty . \mathcal L
=
\mathcal L_{\text{keypoint}}
+5\mathcal L_{\text{visibility}}
+5\mathcal L_{\text{uncertainty}}. L = L keypoint + 5 L visibility + 5 L uncertainty . keypoint loss 沿四次 iterative updates 加权,折扣 γ = 0.8 \gamma=0.8 γ = 0.8 5 × 10 − 4 5\times10^{-4} 5 × 1 0 − 4
推理时先丢不可见点,再按最可能 uncertainty class 排序,保留最可靠的前 R = 0.95 R=0.95 R = 0.95
6. 由点轨迹到 pose
选中的 keypoints 被恢复到原图坐标,按所有 view pairs 组织;只保留一对视图中都有效的共视点。随后调用 COLMAP mapper 默认参数做:
pairwise geometric estimation;
camera / object-relative pose initialization;
multi-view bundle adjustment。
由于把刚体对象当作局部静态世界,求出的“相机运动”取逆即可对应对象相对相机的运动。首帧是 reference;所有 pose 仍只确定到相似变换。
论文把 learned tracker 与 classical SfM 清晰解耦,优点是几何可解释;缺点是初始化、共面退化、低视差、outlier 和窗口连接都受传统 SfM 约束。
7. 评测协议:最容易误读的部分
论文采用 KITTI odometry 风格指标:
translation error t e r r t_{\mathrm{err}} t err
rotation error r e r r r_{\mathrm{err}} r err
Absolute Trajectory Error(ATE);
Relative Pose Error(RPE translation / rotation)。
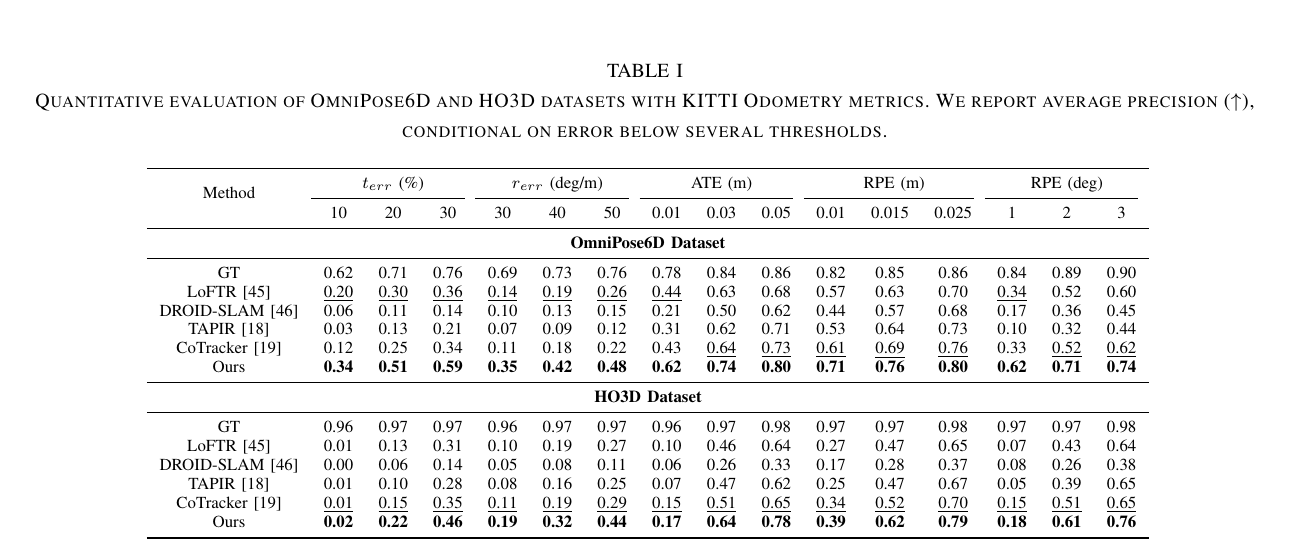
表中每个数不是平均误差,而是误差小于指定阈值时的 average precision ,越高越好。更重要的是,单目预测先以 Umeyama 做 7-DoF similarity alignment :
3D rotation;
3D translation;
1D global scale。
因此 ATE@0.03 m、RPE@0.015 m 等“米制阈值”是在真值辅助的尺度 / 坐标对齐之后计算。它们衡量轨迹形状和相对运动一致性,不证明系统独立恢复了真实世界 translation scale。
表中的 GT 也不是恒为 1,因为作者将真值可见 correspondence 送入同一 SfM,仍受遮挡、共面点和几何求解影响。它更像该 pipeline 在当前数据和取点策略下的上界。
8. 主结果
原论文 Table I。上半是 21 个未见类别的合成测试,下半是 HO3D v3;粗体为最佳预测方法,GT correspondence 行是同一 SfM 的参考上界。来源:作者公开稿 ;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
8.1 OmniPose6D validation
21 类各随机 5 sequences,共 105 条原始测试序列,再分成 8-frame windows。
方法 ATE AP@0.03m RPE trans AP@0.015m RPE rot AP@2° LoFTR 0.63 0.63 0.52 DROID-SLAM 0.50 0.57 0.36 TAPIR 0.62 0.64 0.32 CoTracker 0.64 0.69 0.52 Ours 0.74 0.76 0.71
相对直接 CoTracker + SfM,三项分别 +0.10、+0.07、+0.19;rotation gain 最大,符合数据集强调 out-of-plane rotation 的动机。
8.2 HO3D v3
使用 4 个对象、13 段超过 1,000 帧的视频;只输入 RGB,原视频先 3× downsample,再用首帧标注驱动 Track Anything。
方法 ATE AP@0.03m RPE trans AP@0.015m RPE rot AP@2° LoFTR 0.46 0.47 0.43 DROID-SLAM 0.26 0.28 0.26 TAPIR 0.47 0.47 0.39 CoTracker 0.51 0.52 0.51 Ours 0.64 0.62 0.61
相对 CoTracker 分别 +0.13、+0.10、+0.10。合成训练确实转移到真实手—物交互,但仍有明显 sim-to-real gap:例如 RPE rot@2° 从 0.71 降到 0.61。
9. 消融:数据贡献大于单一 uncertainty head
HO3D 上,CoTracker weights:
训练来源 ATE@0.03 RPE trans@0.015 RPE rot@2° 原始预训练 0.52 0.54 0.50 OmniPose6D scratch 0.60 0.54 0.53 预训练后 OmniPose6D fine-tune 0.65 0.60 0.60
这说明 synthetic dynamic pose data 是主要增益来源之一,且与 TAP-Vid-Kubric 原始预训练互补。
uncertainty strategy:
策略 ATE@0.03 RPE trans@0.015 RPE rot@2° 无 uncertainty 0.65 0.60 0.60 按 level 删除 0.62 0.62 0.59 按 ranking 保留 95% 0.64 0.62 0.61
ranking 在部分 RPE / rotation 指标上略优,但 ATE@0.03 反而比无 uncertainty 低 0.01。不能把全部主结果提升都归因于 uncertainty;fine-tuning、crop、track refinement 和 selection 共同作用。
10. 追加真实数据
附录还评估:
YCBInEOAT :5 个 YCB 对象、9 段约 1,000 帧双臂机器人视频;DexYCB S3 :20 个 YCB 对象、subject 0 的 120 段 × 72 帧视频。
YCBInEOAT 里对象常被机械臂近直线移动、旋转很小,不利于 SfM;Ours 并非每个指标都第一,例如 RPE rot@2° 为 0.24,低于 DROID-SLAM 0.34。DexYCB 中 Ours 在表列预测方法的各阈值上总体最好,例如 RPE rot@2° 0.34,CoTracker 0.21。
这些结果说明 model-free pipeline 能跨多个真实数据集工作,也暴露出“动态”不等于“几何可观测”:平移过小或近直线运动反而会让单目 SfM 更难。
11. 失败案例
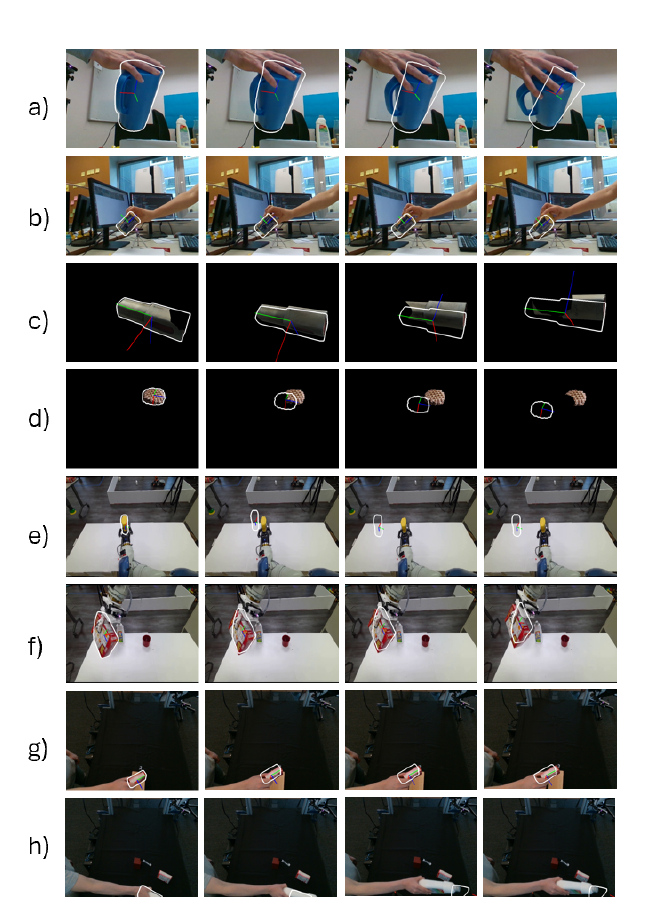
原论文 Figure 9:a–b 来自 OmniPose6D,c–d 来自 HO3D,e–f 来自 YCBInEOAT,g–h 来自 DexYCB。本站核对说明:上述分组沿用作者图注;图中 a–b 为手物交互、c–d 为无背景渲染,与数据集标签疑似不一致,归属暂待澄清,不据此自行重分组。失败由少纹理、初始点共面、大 out-of-plane rotation、小平移及遮挡组合触发。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
作者明确总结:
textureless region 无法形成稳定 track;
初始点集中在单一平面时,SfM 几何约束退化;
少纹理与大 out-of-plane rotation 同时发生;
对象平移太小,视差不足,relative pose 难初始化。
DexYCB 还包含强手部遮挡和远距离小目标。当前 pipeline 离线运行,keypoint selection 仍是经验策略。
12. 速度与部署
RTX 3090 上,一个 8-frame、512×512 crop 的窗口约需 10 秒 。耗时包含 track refinement 和 COLMAP mapping / BA,约 1.25 s/frame 的摊销速度,无法直接服务实时机器人控制。
滑窗之间如何保持全局一致、跨窗口累计 drift、跟丢后重新初始化、长视频内存与 latency 均未被解决。论文明确把 short-term 视为未来 long-term method 的基础,而不是已完成的长时 tracker。
13. 开源与可复现性
截至本站核对时间:
arXiv 与作者 publication page 可访问;
未找到论文作者提供的可验证 official code repository;
未找到 OmniPose6D 数据下载 / license 页面;
Papers with Code 也未列出 implementation。
因此元数据标记为未开源。即便未来公开,复现还需核对:
4,000+ OmniObject3D mesh 的授权与清理列表;
四类轨迹的采样范围和 HO3D trajectory extraction;
遮挡圆生成、crop jitter 与 visibility threshold;
Track Anything 版本和传播参数;
CoTracker initialization、500 / 1,500 track sampling;
COLMAP mapper 参数、失败窗口处理;
7-DoF alignment 与 conditional AP 的精确实现。
14. 最终评价
OmniPose6D 最值得保留的是“短窗、无 CAD、RGB-only 的对象相对运动”这一清晰设定,以及围绕它建立的合成数据与统一 baseline。它证明:直接把通用 point tracker 接到 SfM 还不够,面向对象旋转的数据和 track reliability selection 能在合成与真实 HO3D 上稳定提升。
但该工作距离可部署的 metric 6D pose tracker仍有明显距离:输出无尺度、评测借助真值 similarity alignment、8 帧约 10 秒、SfM 对纹理 / 视差敏感,且数据与代码尚无公开入口。把它归为“数据与短时相对 pose benchmark 代表”比归为“实时绝对位姿方法”更准确。