论文精读笔记:OrienPose: Orientation-Guided Novel View Synthesis for Single-Image Unseen Object Pose Estimation
1. 核心判断
- 论文:CVF Open Access
- 代码:GitHub
- 核心判断:OrienPose 将“生成一个看起来像目标视角的图像”改造成“生成一个与目标 orientation 一致的几何模板”,从而让 NVS 真正服务于 pose matching。
2. 一句话定位
给定单张未知物体 reference,OrienPose 以方向变量控制 novel-view synthesis,并用 orientation consistency loss 约束视角变换的几何合理性。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | 普通 NVS 的畸变来自哪里,方向引导具体在哪个 latent 位置生效? |
| Figure 2 | orientation code 如何进入 reference latent,生成结果如何反馈 pose? |
| Table 1 | 各向异性物体与近对称物体的收益是否不同? |
| Table 2 | NAVI 上的 real-object 泛化是否保留了 ShapeNet 的优势? |
| Figure 6 | OAG 与 OCL 是互补,还是只需其中一个? |
| Table 3 | 输入模糊下的性能下降是否被方向 loss 缓解? |
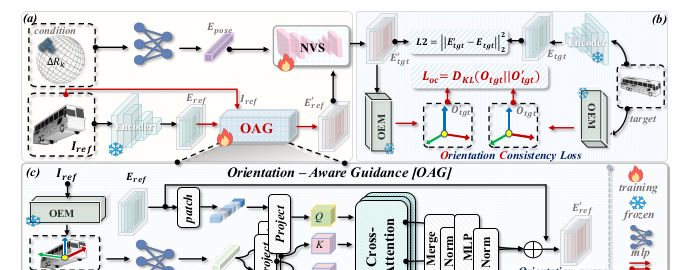 原论文图表中的相关区域:方法把 orientation cue 注入参考 latent,改善新视图的几何与可匹配性。来源:代码仓库 / CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- reference image 提供物体外观与隐式几何,query image 提供待估计姿态。
- 论文不依赖 CAD model;它用生成的 novel view 作为 pose template。
- 训练在 ShapeNet 渲染图像上进行,测试包含训练类别外的 ShapeNet 物体和 NAVI 真实实例。
- NVS 的初始 orientation 具有不确定性:如果方向定义不稳定,生成器可能得到外观相似但几何翻转的模板。
4. 研究脉络
- NVS pose 方法通常把一组离散 viewpoint 的渲染 / 生成结果与 query 做相似度匹配。
- 普通像素 loss 容易把网络引向颜色和局部纹理,而不保证 object-level orientation;遮挡和低纹理会放大这一问题。
- OrienPose 将方向变量、方向监督和 view synthesis 绑定,处于“生成式 pose estimation”与“template matching”之间。
5. 研究动机
- 单张图像的 3D 生成本身是欠定的,网络需要一个明确的 orientation coordinate。
- 仅以像素重建衡量生成质量,会产生几何扭曲、模糊和视角不一致。
- pose matching 关心的是物体方向和结构,而不是每个像素都完美复原。
- 因此作者设计 OAG 注入 orientation prior,设计 OCL 在 geometry level 监督旋转前后的一致性。
6. 方法详解
6.1 Orientation-Aware Guidance
- reference encoder 得到对象 latent;OAG 从 reference 图像估计方向分布并注入 reference embedding,NVS 另外接收相对旋转 ΔR 作为目标视角条件。
- guidance 进入 reference latent,使生成器在构造目标视角时保留明确的方向条件。
- OAG 使用 azimuth、in-plane rotation、elevation 的离散方向概率作为 guidance,并通过 cross-attention 注入 reference embedding;不能把它描述成直接使用连续 SO(3) 几何变量。
6.2 Orientation Consistency Loss
- 比较 synthesized target 与真实 target 的 orientation distributions,而非直接建立 reference / target latent 的逐点旋转对应。
- 对给定 ΔR 生成的目标视图,用三个角度方向的 KL divergence 约束其 orientation distribution 与真实 target 一致,再与像素级 L2 联合;这不等同于显式 3D 点对应约束。
- 该约束帮助减少异向物体的翻转 pose,并提高 blur / occlusion 条件下的模板可辨识性。
6.3 Pose matching
- 对多个离散相对旋转生成 novel-view candidates。
- 比较每个 candidate 与 query 的相似度。
- 选择最匹配的 viewpoint,并将离散方向转换为 pose 估计。
- 通过候选采样密度在精度和推理时间之间折中。
7. 训练与实验
7.1 数据与基线
- ShapeNet 训练和测试使用 10 个类别,测试实例 / 类别与训练划分分离。
- NAVI 提供 5 个真实世界实例,用于 zero-shot sim-to-real。
- 基线包括基于 NVS 的 NOPE、扩散 NVS Free3D、GigaPose 等。
7.2 结果解读
- ShapeNet Table 1 显示 OrienPose 在多个类别取得最佳或接近最佳表现,尤其是 bottle、bus、guitar 等具有明确方向的物体。
- NAVI Table 2 显示其仍能从合成训练迁移到真实物体;真实域存在性能下降,但方向约束能保持相对稳定的视角判断。
- 论文还报告 blur 和 occlusion 下的鲁棒性:普通 NVS 更容易输出翻转或模糊模板,OrienPose 倾向于保留更稳定的 orientation cue。
7.3 消融
- 去掉 OAG 会削弱 orientation injection,说明方向不能只寄希望于 latent 自发学习。
- 去掉 OCL 会增加几何不一致和 pose ambiguity,说明像素级 synthesis loss 不足。
- OAG 与 OCL 同时使用时性能最佳,支持“条件注入 + 几何监督”的组合设计。
8. 批判性分析
- 优势:将 NVS 的失败模式和 pose 的几何要求直接对齐,问题分析清楚。
- 局限:单图重建仍有不可观测面;对称 / 近对称物体不存在唯一方向,单个离散模板可能不能表达多解。
- 部署成本:需要生成多个 viewpoint,候选数量与分辨率决定速度;实时场景可能需要 coarse-to-fine 或缓存。
- 数据偏差:ShapeNet 到 NAVI 的 sim-to-real 结果不错,但复杂透明、反光、非刚性物体还需更广评测。
9. 对我的研究的启发
- 把 pose 估计的监督从像素误差扩展到几何、法向、深度和 orientation consistency。
- 对生成式 pose 方法,可以显式维护一个 object orientation latent,而不是仅用图像条件。
- 将多个 NVS 候选作为 pose posterior,而不是只取一个 argmax,可自然表达对称性与不确定性。
10. 待解决问题
- 如何在无 CAD、单 RGB 且目标完全未知时自动建立稳定的 canonical orientation?
- 如何把连续 SO(3) 采样和生成模型结合,降低候选 viewpoint 数量?
- 如何将 OCL 扩展到 articulated object 或可形变物体?
11. 精读补充:NVS 的 pose 约束到底带来了什么
11.1 ShapeNet 与 NAVI 的精确结果
ShapeNet 的 10 类平均结果如下,ACC 30 越高越好,Median 越低越好:
| 方法 | ACC 30 | Median |
|---|
| NOPE | 52.3 | 27.7° |
| GigaPose(需要 CAD,不参与无 CAD 排名) | 61.6 | 23.57° |
| OrienPose | 59.6 | 20.4° |
OrienPose 在 10 个类别中对 bottle / clock / bus / mug / washer / pistol / guitar / train / dishwasher / skateboard 的 ACC 30 分别为 66.1、57.1、58.7、51.9、65.5、62.6、59.6、58.9、53.2、62.1。相对 NOPE,作者报告平均 ACC 30 提升 7.3 个百分点、Median 降低 7.3°;这里的比较应限定在同一 single-image unseen-object、无 CAD 的协议。
NAVI 五个真实实例的平均 ACC 30 为 50.9,Median 为 35.7°;五个实例分别是 bull、bunny、sink、shark、schoolBus。sim-to-real 仍有明显下降,但 OrienPose 的平均性能高于 RelPose / PIZZA / NOPE,说明 orientation prior 的收益可以部分跨越渲染域差异。
11.2 OAG / OCL 的机制
- OAG:从 reference 图像估计物体的 orientation distribution,把 azimuth、in-plane rotation、elevation 的离散概率嵌入 latent,通过 cross-attention 注入 reference embedding。它不是把最终 pose 直接写进网络,而是改变 NVS 进行 viewpoint transformation 的条件。
- OCL:比较 synthesized target 与真实 target 的 orientation distributions,使用三个角度方向的 KL divergence,再与像素级 L2 联合。这样可以惩罚“看起来像,但方向统计错误”的生成视图。
- Pose estimation:预定义 viewpoint / pose candidates,生成对应 template,再与 query 比较;最相似 template 的 pose 作为估计。因而 NVS 质量和 candidate sampling 共同决定最终精度。
11.3 Robustness 结果
在 ShapeNet bus 的模糊 / 遮挡实验中,原始 ACC 30 为 58.7、Median 为 18.3°;即使 blur 强度到 40%,ACC 30 仍为 56.0、Median 24.9°;遮挡 40% 时 ACC 30 为 53.3、Median 29.0°。这支持“方向先验提供了比像素纹理更稳的几何线索”,但不能推广为对任意遮挡都鲁棒。
11.4 作者声称与我的分析
| 层次 | 判断 |
|---|
| 作者声称 | NVS 的 orientation-aware conditioning + OCL 可减少几何错位和纹理模糊,提升 pose。 |
| 论文证据 | ShapeNet 平均 ACC 30 59.6、NAVI 50.9,且 blur / occlusion 下降相对平缓。 |
| 我的保留 | 生成候选数量、NVS backbone 和 orientation estimator 的质量都可能影响结果;需要完整 OAG-only / OCL-only / baseline NVS 的表格来隔离贡献。 |
| 关键失败 | 对称或近对称物体没有唯一 canonical orientation;NVS 生成一个“合理但不唯一”的方向仍会导致 pose ambiguity。 |
12. 复现清单
- 固定 ShapeNet 的 10 类、NAVI 的 5 个实例和训练 / 测试 viewpoint 分割。
- 记录 orientation candidate 的数量、角度间隔、OAG 的 orientation bins、OCL 的 KL 权重与像素损失权重。
- 评测时同时保存生成模板的 contour、depth / normal(若有)和最终匹配分数;否则很难区分 NVS 失败与 pose matcher 失败。
- 对模糊、遮挡、透明、反光和对称物体分别报告 ACC 30 / Median;平均分不能替代 failure analysis。
