论文精读笔记:PartPose
1. 基本信息与版本归属
标题 :PartPose: Attentive 6D Pose Estimation by Focusing on Graspable Parts of Multi-Part Deformable Objects正式出版 :IEEE Robotics and Automation Letters,Vol. 10, No. 12, pp. 13082–13089,2025DOI :10.1109/LRA.2025.3627067 作者公开版 :ResearchGate ,页面与正文标明 CC BY 4.0会议关系 :ICRA 2026 的 PaperCept 日程包含该论文报告,但 DOI、卷期和 publisher 均表明其 canonical publication 是 RA-L 2025。本站因此把它放入 ICRA 2026 的“期刊论文现场报告”附录,不计入会议正式论文数。阅读模式 :精读
2. 一句话定位
PartPose 把多部件可变形对象的 6D pose 问题改写为“寻找一个稳定、可抓取、可跨真实图与 CAD 比较的刚性 ROI,并仅对该 ROI 做 render-and-compare”,由此绕开柔性线缆、袋体或绳子对整体刚体匹配的破坏。
2.1 论文图表导读
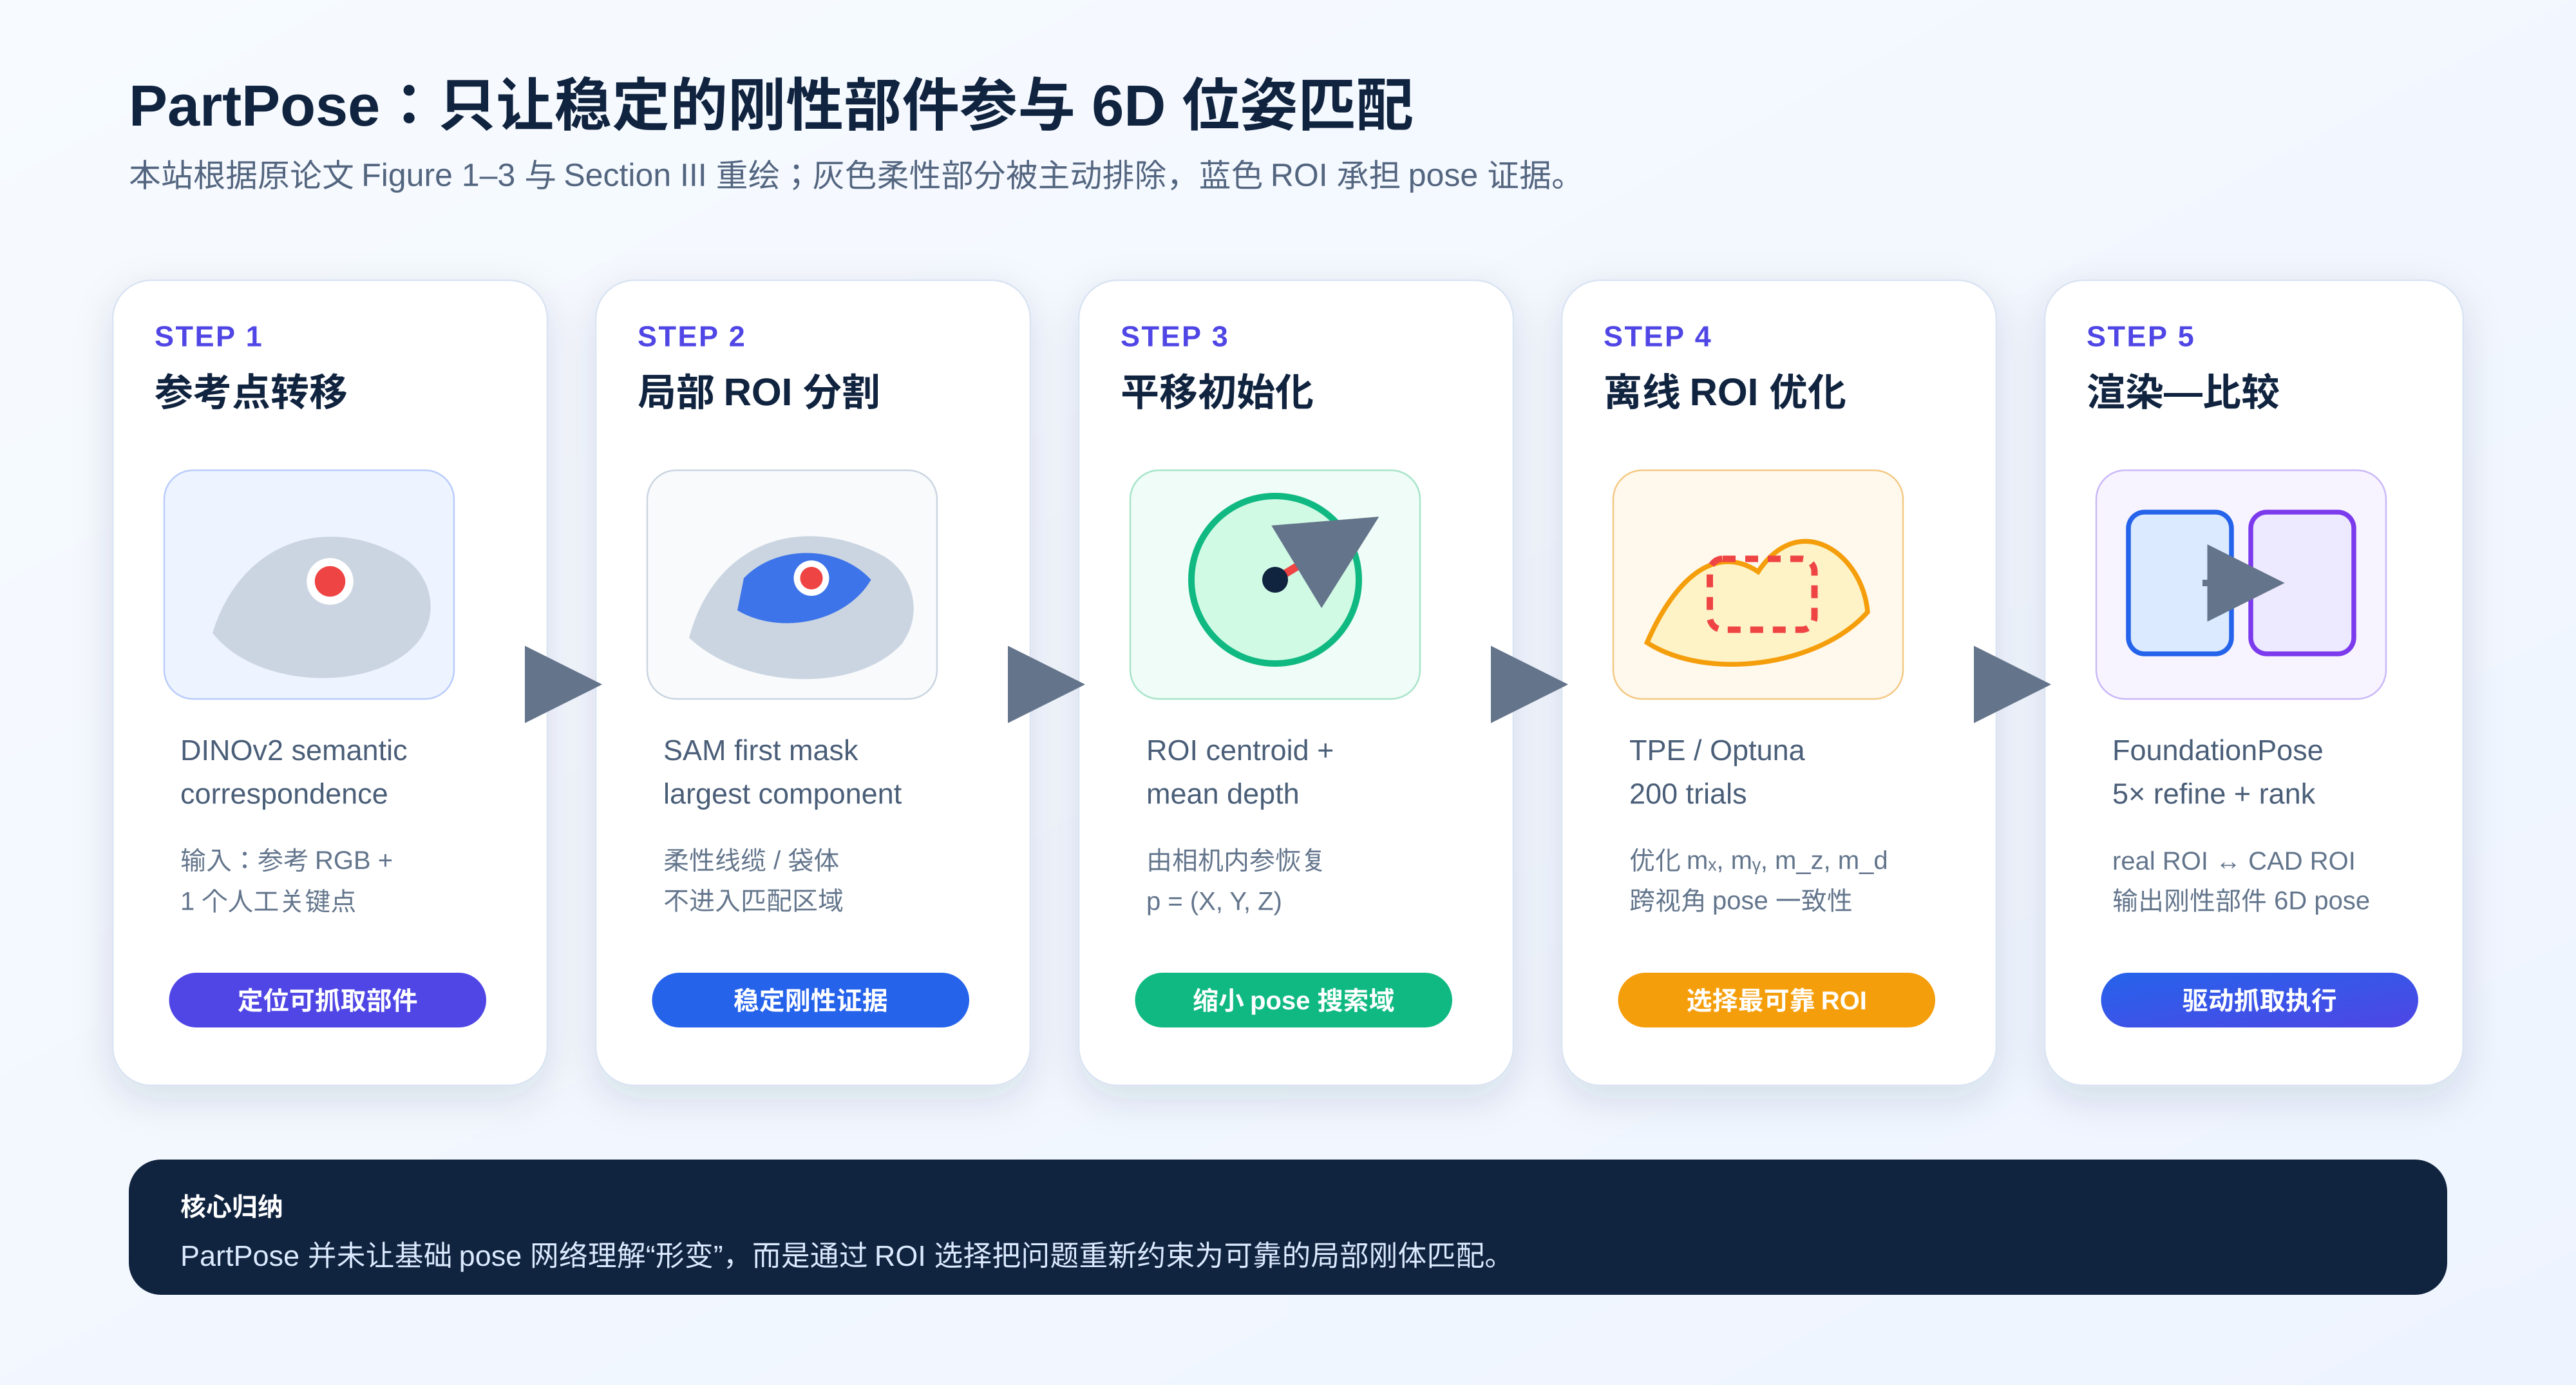
本站根据原论文 Figure 1–3 与 Section III 重绘。关键不是更换 FoundationPose,而是把输入证据约束到刚性 ROI:DINOv2 转移参考点,SAM 提供局部 mask,TPE 优化 ROI 几何,最终执行局部 render-and-compare。方法来源:RA-L 正式论文 ;作者公开版采用 CC BY 4.0。
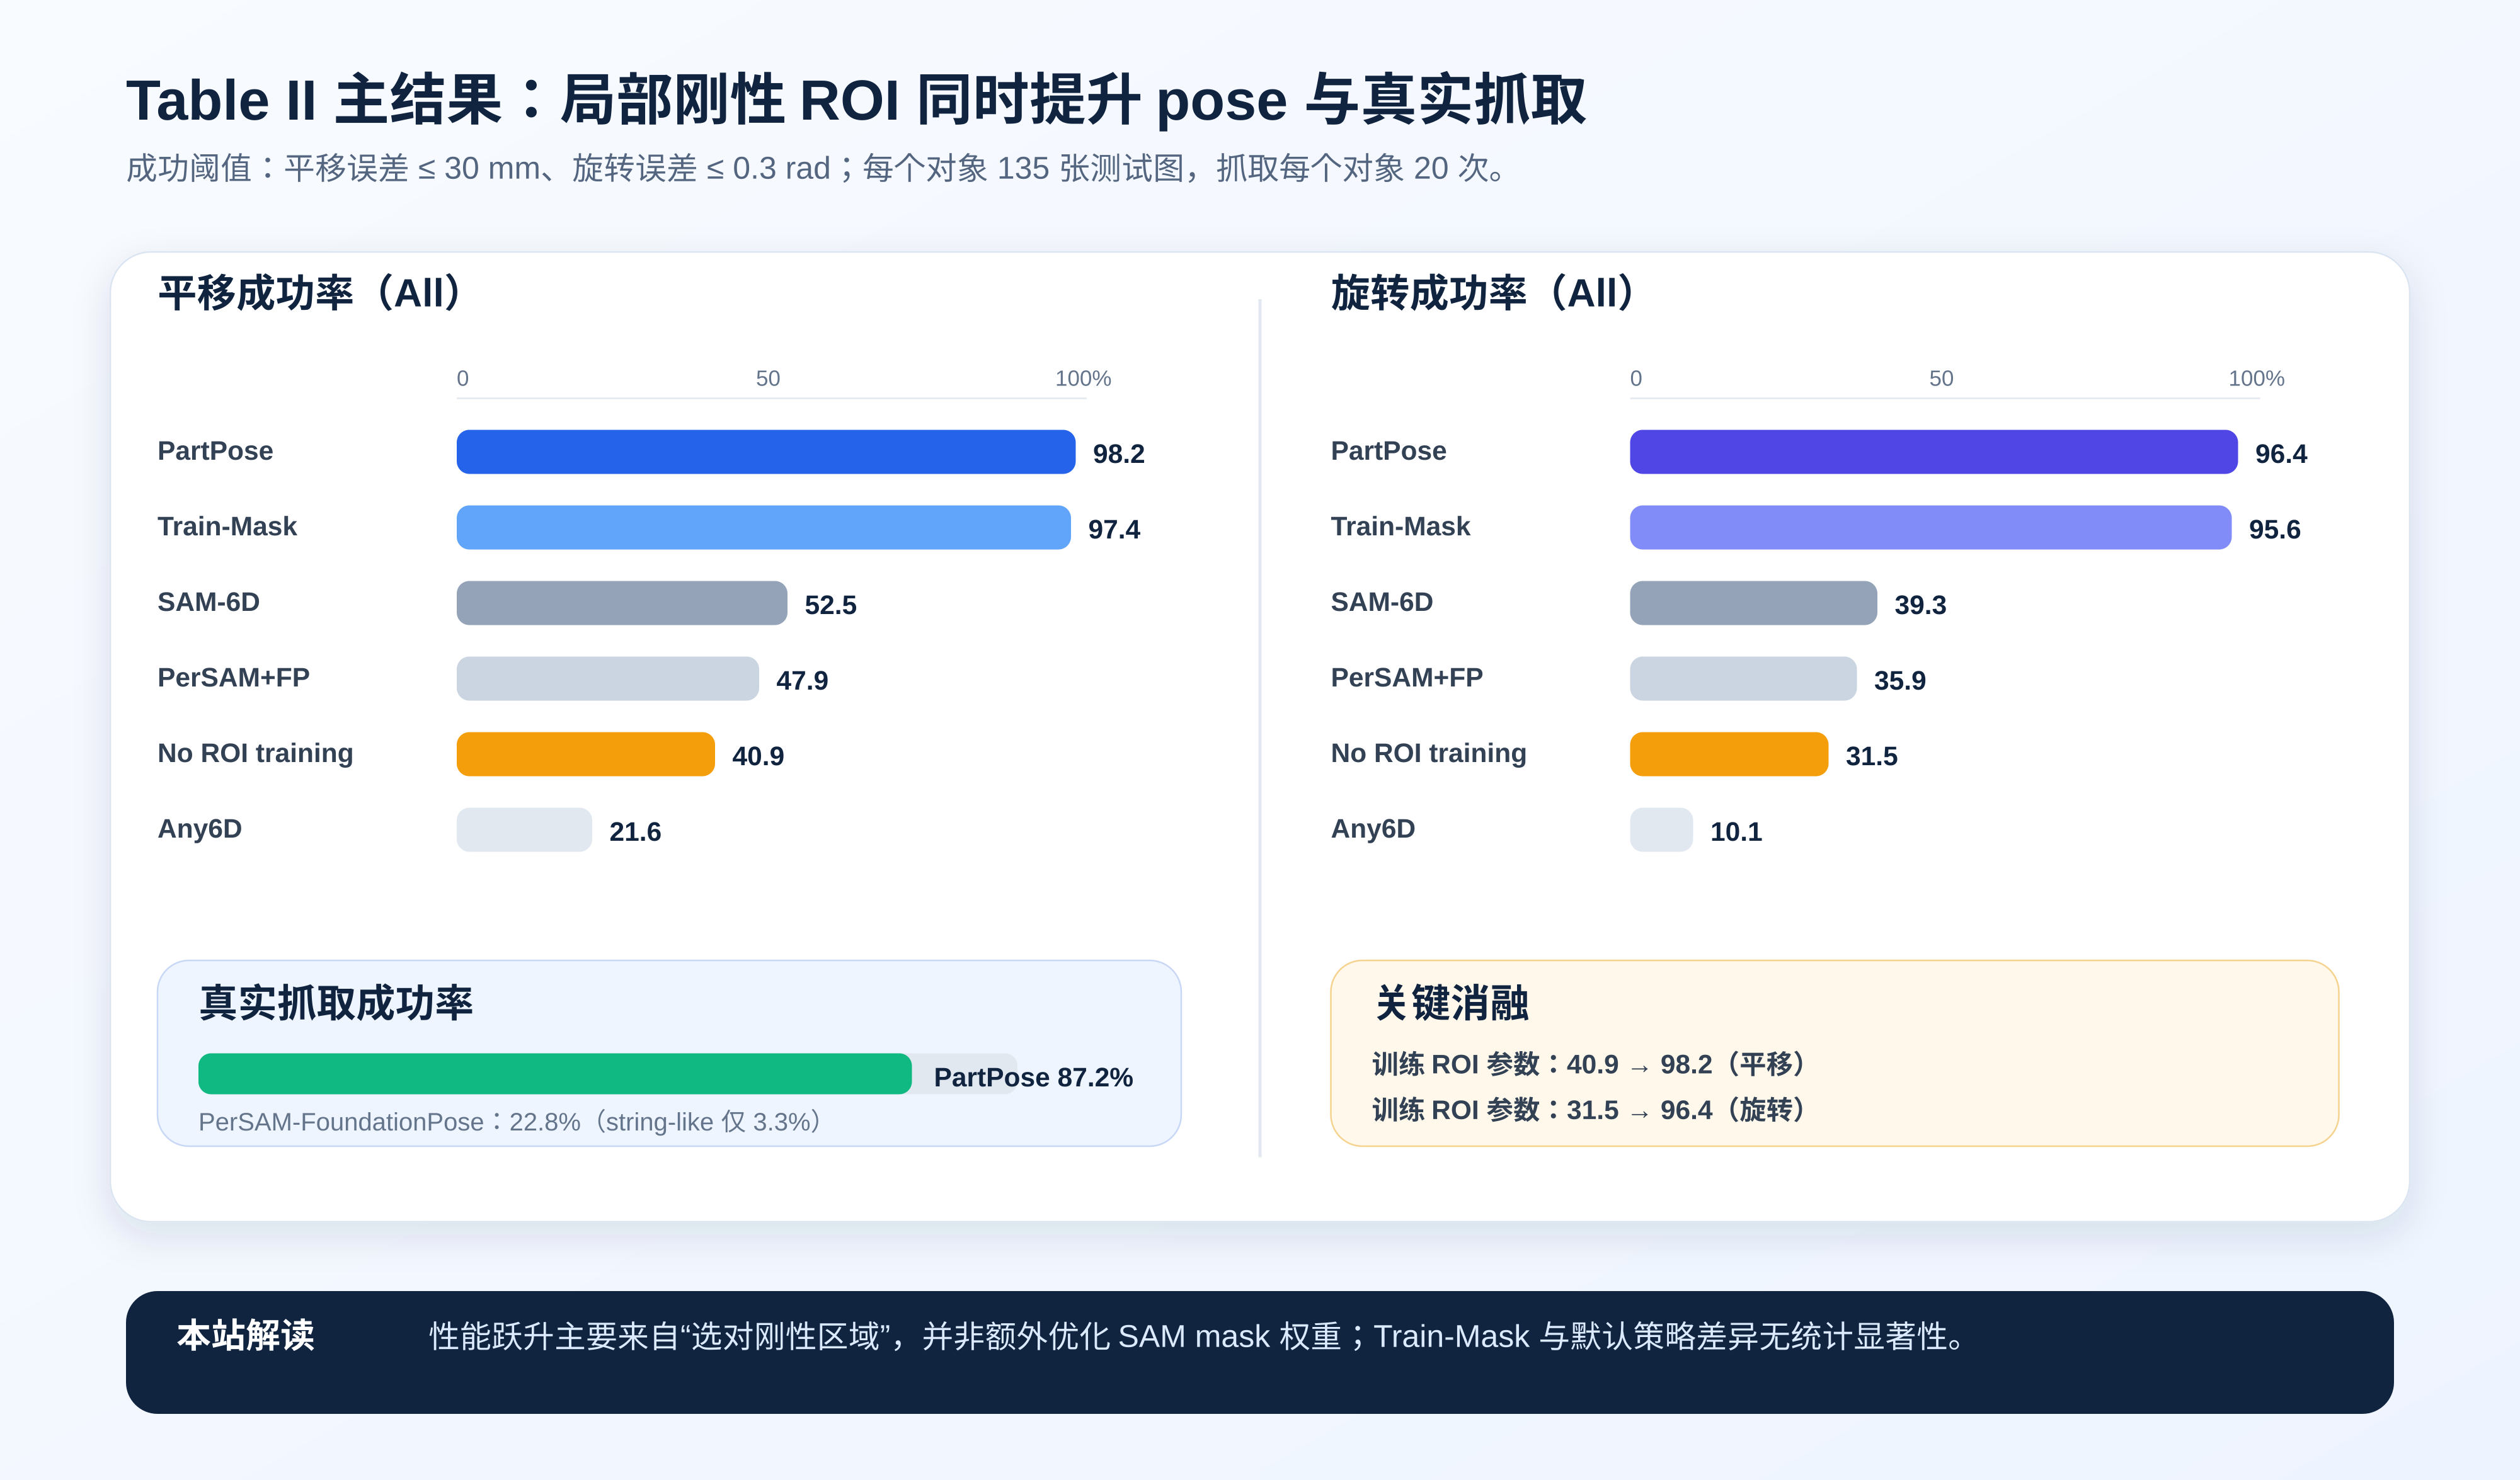
本站根据原论文 Table II 重绘:平移 / 旋转 success rate 的整体结果,以及真实抓取成功率。图中所有数字均逐项来自原表;本站未把 success rate 改写为 BOP AR。来源:CC BY 4.0 作者版 。
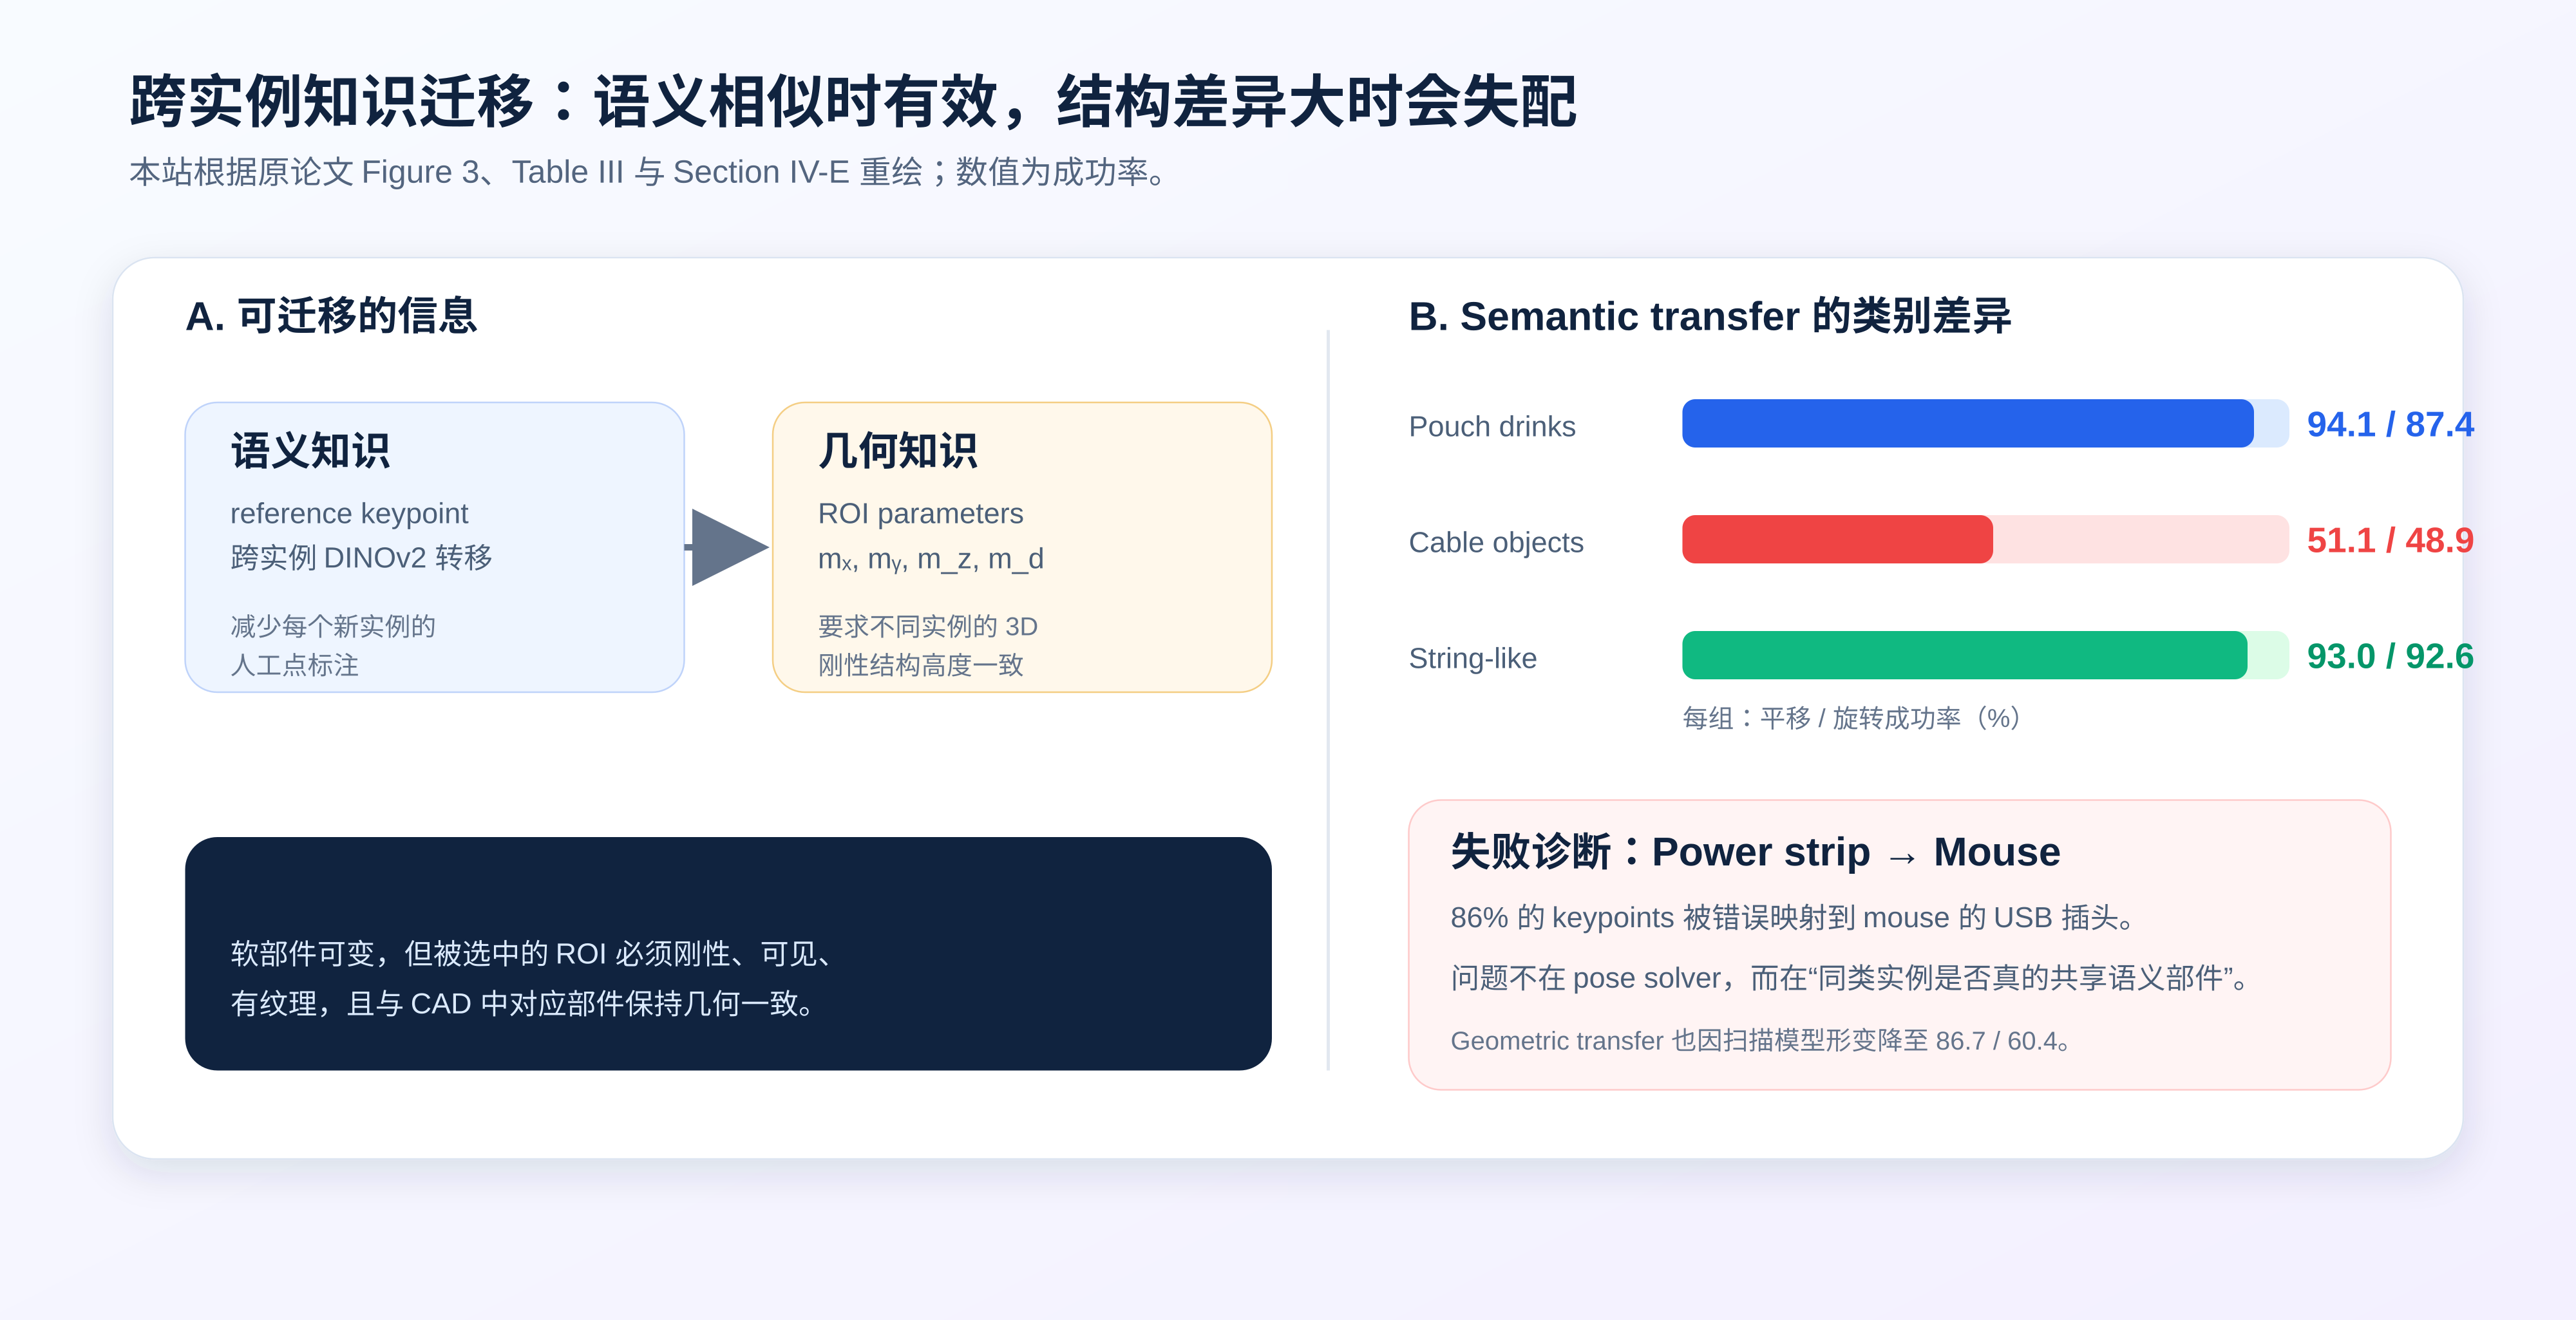
本站根据原论文 Figure 3、Table III 与 Section IV-E 重绘。语义 keypoint 迁移对 pouch / string-like 类别有效,却在线缆电器类别出现系统性错配;几何参数迁移还受扫描模型一致性限制。来源:RA-L 论文 。
3. 问题设定与任务边界
3.1 论文真正估计的 pose 是什么
设测试 RGB-D 图像为 ( I i t , I i d ) (I_i^t, I_i^d) ( I i t , I i d ) M M M K K K c i T o {}^{c_i}T_o c i T o M M M
PartPose 的做法不是定义一个随形变变化的新物体坐标系,而是在模型坐标系中选择一个 ROI:
m = ( m x , m y , m z , m d ) , m=(m_x,m_y,m_z,m_d), m = ( m x , m y , m z , m d ) , 其中前三项是 ROI 原点相对对象模型原点的偏移,m d m_d m d
3.2 输入、输出与先验
阶段 输入 输出 关键假设 离线准备 3D scan / CAD、5 个训练形态、8 个标定视角、参考图与 keypoint 每对象最优 ROI 参数 m ∗ m^* m ∗ 机器人相机位姿可用;存在稳定刚性部件 单帧初始化 测试 RGB-D、相机内参、参考图 / 点、M M M m ∗ m^* m ∗ 初始并精修的 c T o {}^{c}T_o c T o keypoint 能转移;ROI 可见且深度有效 时序跟踪 当前 RGB-D、上一帧 pose、M M M m ∗ m^* m ∗ 更新后的 c T o {}^{c}T_o c T o 帧间运动可由单候选 refinement 覆盖 机器人抓取 w T c {}^{w}T_c w T c c T o {}^{c}T_o c T o o T g {}^{o}T_g o T g w T g {}^{w}T_g w T g 对象刚性部件与 grasp frame 一致
抓取位姿由
w T g = w T c , c T o , o T g {}^{w}T_g = {}^{w}T_c,{}^{c}T_o,{}^{o}T_g w T g = w T c , c T o , o T g 得到。这说明论文评价的是“可用于刚性部件抓取的对象 frame”,而不是对柔性几何状态的完整重建。
它不预测线缆、绳子或袋体的形状与 articulation state。
它不建立非刚性对应场,也不做 deformable registration。
它假设下游抓取只依赖一个刚性部件,因此可以有意忽略其余区域。
这既是设计优势,也是严格边界:PartPose 解决的是 multi-part deformable object 中的 rigid-part pose ,不是通用 deformable object pose。
4. 研究脉络
FoundationPose、SAM-6D、FreeZe 等通用方法通常以刚体 mesh 或重建模型为参照。部分匹配可以忽略背景和遮挡,但若“被忽略之外的目标自身”发生形变,视觉相似性并不能自动区分哪一部分应服从刚体约束。
PartPose 的贡献可理解为一个任务先验层:
用 semantic correspondence 把人指定的可抓取部件定位到测试图;
用局部 mask 把 pose evidence 限定在这个部件;
用多视角一致性选择最适合 pose 的三维 ROI;
复用现成 pose refinement / ranking 网络。
因此它不是替代 FoundationPose,而是改变 FoundationPose 看见什么。
5. 方法详解
5.1 参考关键点转移
每个对象只在一张 reference image 上人工标记一个点 k r k_r k r k i t k_i^t k i t
这个环节的目的不是建立足以直接求 PnP 的多点对应,而是给 SAM 一个 spatial prompt。它把一个低成本语义提示转化为局部几何观测。
跨实例实验会把 source object 的 reference keypoint 迁移到同类别 target instance。若类别内共享明显语义部件(瓶盖、标签),该策略有效;若“线缆电器”只是一种功能性粗分类,语义点就可能落到错误部件。
5.2 局部 ROI 分割
SAM 接收测试点后输出多个候选 mask。作者采用第一次 mask 输出,而不是联合训练 mask weights。为去除碎片,保留最大 contour / connected component,其图像质心记为 ( u , v ) (u,v) ( u , v )
这里有两层 ROI:
2D mask ROI :从真实 RGB-D 中找当前可抓取部件。3D model ROI :由 m = ( m x , m y , m z , m d ) m=(m_x,m_y,m_z,m_d) m = ( m x , m y , m z , m d )
二者必须在正确 pose 下对应,后续 render-and-compare 才有意义。
5.3 平移初始化
作者取 mask 内平均深度得到 Z Z Z ( u , v ) (u,v) ( u , v ) K K K p = ( X , Y , Z ) p=(X,Y,Z) p = ( X , Y , Z )
这一步并不恢复完整旋转,只是把 FoundationPose 的 hypothesis initialization 放在正确局部附近。其风险包括透明 / 反光深度失效、mask 混入背景、被遮挡区域导致平均深度偏置。
5.4 ROI 参数的离线 Bayesian optimization
训练阶段从两个不同相机视角 c 1 , c 2 c_1,c_2 c 1 , c 2
w T o ( 1 ) = w T c 1 c 1 T o , q q u a d w T o ( 2 ) = w T c 2 c 2 T o . {}^{w}T_o^{(1)}={}^wT_{c_1}{}^{c_1}T_o,qquad
{}^{w}T_o^{(2)}={}^wT_{c_2}{}^{c_2}T_o. w T o ( 1 ) = w T c 1 c 1 T o , q q u a d w T o ( 2 ) = w T c 2 c 2 T o . 若 ROI 选得可靠,两次 world-frame pose 应一致。平移差用欧氏距离,旋转差使用四元数 geodesic distance:
d R = 2 arccos ( ∣ q 1 ⋅ q 2 ∣ ) . d_R=2\arccos(|q_1\cdot q_2|). d R = 2 arccos ( ∣ q 1 ⋅ q 2 ∣ ) . 优化目标是二者加权和,w t = 1.0 w_t=1.0 w t = 1.0 w r = 0.1 w_r=0.1 w r = 0.1
本站认为这是论文最值得注意的设计:作者没有为 ROI 采集逐像素“哪个部件最刚性”的标签,而是用跨视角 pose 一致性作为弱监督目标。
5.5 局部 render-and-compare
初始平移确定后,FoundationPose 生成 pose hypotheses。对每个 hypothesis:
在 3D model 中用 m m m
以 p p p
在候选 pose 下渲染 model,并用相同空间范围裁剪 render;
refinement network 预测 pose correction;
ranking network 在候选中选最终 pose。
初始化阶段做 5 次 refinement。tracking 阶段直接以上一帧 pose 为唯一 hypothesis,仅做 2 次 refinement,因此速度显著提高。
6. 实验设计与证据
6.1 数据采集
项目 设置 对象类别 pouch drinks、cable-attached objects、string-like objects 实例数 每类 3 个,共 9 个 传感器 Intel RealSense D405 + ring light 机器人 UR5e + ROBOTIS HAND RH-P12-RN 两指夹爪 3D model KEYENCE VL-700 扫描 工作距离 约 30 cm 训练 5 个柔性形态 × 8 视角 / 对象 测试 5 个柔性形态 × 27 视角 = 135 图 / 对象 抓取 20 次 / 对象,共 180 次
数据不公开,因此读者目前无法独立复查每个失败样本或重跑评测。它也不是 BOP 格式的广覆盖 benchmark,而是专门验证“柔性附属结构破坏刚体匹配”的小规模受控实验。
6.2 指标为何不是 ADD / VSD
ADD 默认预测 pose 与 GT pose 作用于同一刚体 model,随后比较表面点。PartPose 的真实柔性部分并不等于扫描时 model 的对应部分,所以表面距离会同时惩罚 pose error 和合法形变。
论文改用:
translation error;
quaternion rotational distance;
成功率:translation ≤ 30 mm / rotation ≤ 0.3 rad;
真实 robotic picking success rate。
这种指标选择与问题一致,但阈值相对宽,且平移 / 旋转分开统计,不能直接与 BOP AR 或 ADD(-S) 横向比较。
6.3 Ground truth 构建及其风险
GT pose 是对 5 个经可视化 overlay 人工确认正确的估计取平均,而不是外部 motion capture。作者让 5 名参与者对 pouch drink 2、power strip、beads 重复标注,得到:
平均差异:2 mm / 0.03 rad;
最大差异:6 mm / 0.07 rad。
这些值显著小于 30 mm / 0.3 rad 阈值,支持 success-rate 判定的稳定性。但这仍是“基于模型渲染的人工对齐 GT”,可能与使用同一模型的 render-and-compare 方法共享偏差;外部 mocap 会是更强验证。
6.4 主结果
方法 平移成功率 旋转成功率 抓取成功率 PartPose 98.2% 96.4% 87.2% PartPose-Train-Mask 97.4% 95.6% 未报告 SAM-6D 52.5% 39.3% 未报告 PerSAM-FoundationPose 47.9% 35.9% 22.8% Training-Free-PartPose 40.9% 31.5% 未报告 Any6D 21.6% 10.1% 未报告
分对象类别看,PartPose 的成功率都很高:
平移:pouch 96.3、cable 99.3、string 99.0;
旋转:pouch 91.1、cable 99.0、string 99.0;
抓取:pouch 83.3、cable 95.0、string 83.3。
PerSAM-FoundationPose 在 string-like 抓取仅 3.3%。这与论文动机一致:全对象 mask 会把形变最大、最不该用于 rigid alignment 的绳子也纳入匹配。
6.5 消融:真正起作用的是什么
去掉 ROI 参数优化 后,平移 / 旋转成功率从 98.2 / 96.4 跌到 40.9 / 31.5。这是最强消融,说明“把匹配限定到一个局部”仍不够;这个局部的中心与尺度必须根据 pose consistency 选择。
额外训练 SAM mask weights 只得到 97.4 / 95.6,略低于默认 PartPose。两者平均误差分别为:
PartPose:7.4 ± 12.2 7.4\pm12.2 7.4 ± 12.2 0.2 ± 0.4 0.2\pm0.4 0.2 ± 0.4
Train-Mask:8.4 ± 17.8 8.4\pm17.8 8.4 ± 17.8 0.2 ± 0.5 0.2\pm0.5 0.2 ± 0.5
5% 显著性水平的 t-test 未发现差异,因此不能声称 mask-weight optimization 带来收益。
旋转权重敏感性 中,w r ∈ { 0.01 , 0.03 , 0.1 , 0.3 , 1.0 } w_r\in\{0.01,0.03,0.1,0.3,1.0\} w r ∈ { 0.01 , 0.03 , 0.1 , 0.3 , 1.0 } w r = 0.1 w_r=0.1 w r = 0.1
6.6 跨实例知识迁移
语义 keypoint transfer 在 pouch 和 string-like 类别保持较高成功率:94.1 / 87.4 与 93.0 / 92.6(平移 / 旋转)。Cable 类别却降到 51.1 / 48.9。
原因不是简单“线缆更难”,而是类别语义定义不够一致:从 power strip 向 mouse 转移时,86% keypoints 落在 mouse 的 USB plug 上。也就是说,semantic correspondence 找到了视觉 / 功能相关部件,却不是作者希望的抓取刚性 ROI。
Geometric transfer 仅在 pouch 类别测试,降至 86.7 / 60.4。扫描模型本身会保留对象形变,导致 source 的 ROI frame 不能直接套到 target。作者据此指出,跨实例 ROI 参数迁移需要 CAD 级几何一致性。
7. 速度与部署解释
硬件为 Intel i9-14900K + RTX 3090 Ti:
环节 时间 keypoint transfer 0.20 s ROI segmentation 0.02 s hypothesis refinement + ranking 1.7 ± 0.3 1.7\pm0.3 1.7 ± 0.3 单帧初始化总计 约 1.9 s 已初始化 tracking 0.014 s / frame
因此“实时”必须准确理解:首次定位并不实时;0.014 s 对应上一帧 pose 已可用、仅一个 hypothesis、两次 refinement 的 tracking 条件。若发生长时完全遮挡或大幅跳变,系统需要重新初始化,延迟会回到秒级。
8. 作者声称与本站判断
作者主张 证据 本站判断 刚性 ROI 比整对象匹配更适合刚柔混合目标 Table II、定性 overlay、No-ROI-training 消融 支持充分 ,结果幅度大且与机制一致方法改善机器人抓取 9 对象 × 20 次真实抓取 基本支持 ,但场景受控、对象量小可向未见同类实例迁移知识 Table III 三类 transfer 部分支持 ,语义一致类别有效,cable 类明显失败适合实时 tracking 0.014 s / frame 有条件支持 ,仅限已初始化和单候选 refinement对目标函数权重鲁棒 Table IV + t-test 支持当前三对象范围 ,不应外推到更多类别
9. 隐含假设与失败案例
对象必须有可抓取刚性部件 :全柔性目标没有稳定的 6D frame。ROI 在测试时可见 :若刚性部件被杂乱遮挡,忽略柔性区后可能完全无证据。局部需要纹理 / 语义特征 :作者明确指出弱纹理会降低 keypoint transfer 和 pose matching。深度在 ROI 内可用 :反光、透明或边缘区域会破坏平移初始化。3D model 中 ROI 几何可信 :扫描时柔性状态不同会污染跨实例 geometric transfer。光照差异有限 :作者把 rendering lighting adaptation 列为未来工作。下游任务只关心刚性局部 :若操作需要理解线缆拓扑或袋体形状,PartPose 输出不够。
10. 复现难点
作者未公开代码和数据。
依赖 DINOv2、SAM、FoundationPose、Optuna / TPE 与自建机器人采集链路。
需要准确的 robot–camera extrinsics 和每个训练视角的 camera pose,否则 pose-consistency objective 本身会偏。
论文没有公开 ROI 参数、SAM 版本 / prompt 后处理的全部工程细节,也未给出随机种子。
GT 生成需要人工可视化判断与 pose averaging,复现实验协议并不只是运行网络。
建议复现时先做三项诊断,而不是直接跑完整抓取:
可视化 keypoint 是否落在目标刚性部件;
检查 mask 最大连通域是否混入柔性结构;
画出不同视角下 world-frame pose residual 随 TPE trial 的曲线。
11. 可改进方向
11.1 多 ROI belief,而不是单个固定 ROI
作者已经指出,单个 ROI 被遮挡或局部变形时会失效。可以把多个候选 rigid parts 作为 mixture components,根据可见性、render residual 和 pose covariance 动态加权;这比预先固定一个 ROI 更适合杂乱仓储。
11.2 自动发现“刚性且可抓取”的部件
可结合 VLM / part segmentation / temporal rigidity:语言提供“handle / cap / rigid housing”等语义,视频多视角提供相对刚性证据,机器人 grasp affordance 提供任务相关性。目标是去掉单个参考 keypoint 标注,同时避免 power-strip→USB-plug 这类纯语义错配。
11.3 把 ROI 选择与不确定性联动
当前 TPE 只寻找平均一致性最好的固定参数。更实用的系统应输出 pose covariance 或多峰 posterior,并在 ROI 被遮挡、深度失效时降低其权重。必要时触发相机主动换视角。
11.4 用 model-free 表示降低 CAD 成本
作者把 model-free 作为未来方向。可以用单 / 多视图重建的 3DGS、TSDF 或 point map 替代 CAD,但必须特别检查重建是否把柔性状态固化为错误几何;“没有 CAD”不等于“没有错误模型”。
11.5 更强的任务级评测
应扩展到:
更大对象库与跨仓库光照;
不同程度的刚性 ROI 遮挡;
透明 / 反光刚性部件;
长时间跟踪后重定位;
抓取后线缆缠绕、碰撞和拖拽等真正与柔性部分相关的失败。
12. 最终评价
PartPose 的价值不在于提出更复杂的 backbone,而在于暴露一个常被忽略的建模错误:对象在语义上是一个整体,并不意味着所有像素都应服从同一个刚体 pose loss。
它用很小的结构改动把这一判断落实为可复现的 pipeline,并通过离线 pose、消融和真实抓取构成闭环证据。与此同时,它仍是一个依赖 CAD、深度、人工点和受控离线采集的小规模系统。把“固定单 ROI”升级为自动发现、多 ROI belief 和主动感知,才是从漂亮原型走向仓储部署的下一步。