论文精读笔记:Pos3R: 6D Pose Estimation for Unseen Objects Made Easy
1. 核心判断
- 论文:CVF Open Access
- 关键问题:已有 2D foundation feature 在 out-of-plane rotation 下给出稀疏 / 不一致的 correspondence,导致 template selection 成为 unseen pose 的前端瓶颈。
- 核心回答:复用 MASt3R 等 3D reconstruction foundation model 的 3D-consistent feature,不做额外 pose supervision 训练。
2. 一句话定位
Pos3R 是将“3D foundation feature 已能跨视图对齐”的能力,最小改动地接入 CAD template selection 和 BOP pose pipeline 的工作。
2.1 论文图表导读
| 图表 | 应该看什么 |
|---|
| Figure 1 | DINOv2 与 MASt3R 在 in-plane / out-of-plane rotation 上的 correspondence 差异。 |
| Figure 2 | rendering、template selection、feature matching、pose solve 的完整链条。 |
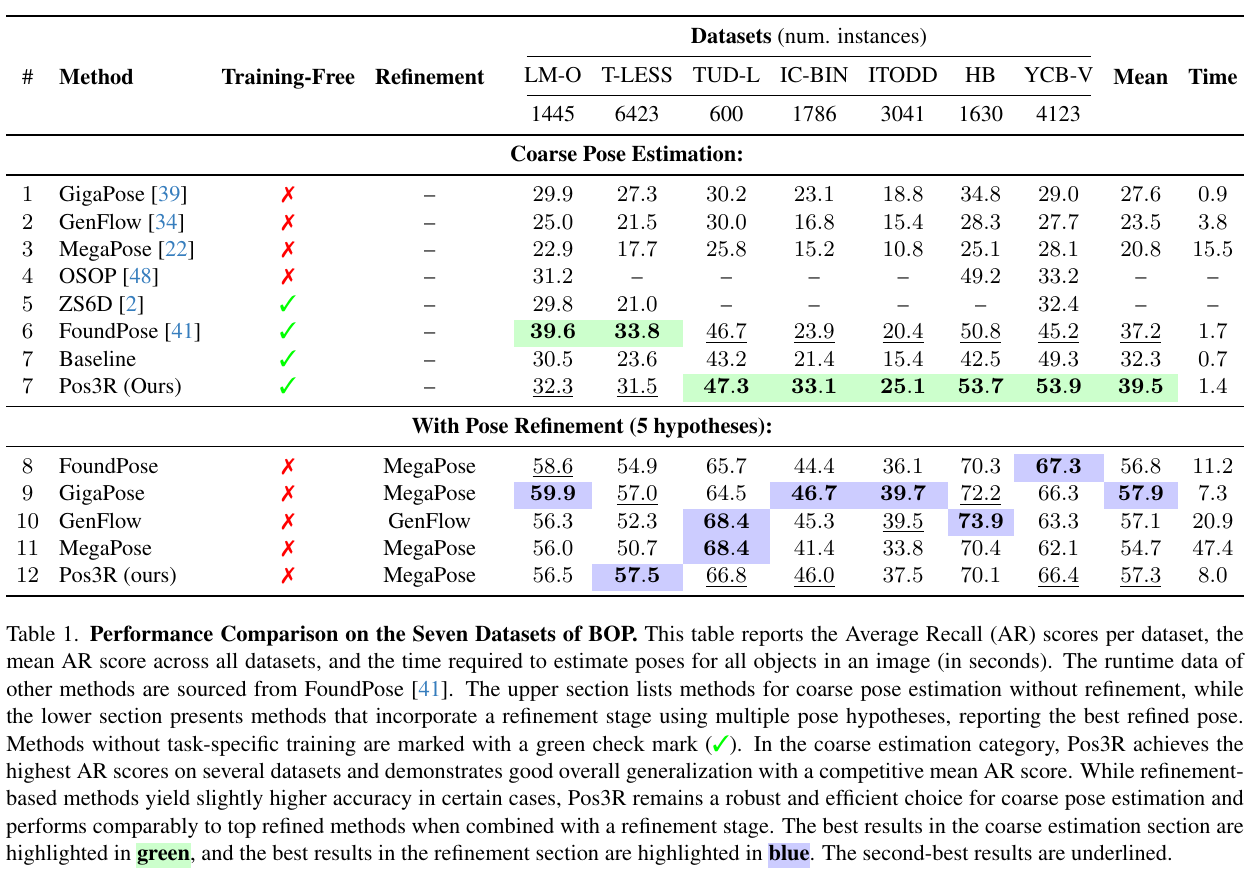
| Table 1 | BOP 七集 AR;要确认方法是否使用 refinement。 |
| Table 2–3 | predicted 3D model 与 CAD、不同 pose method 的贡献。 |
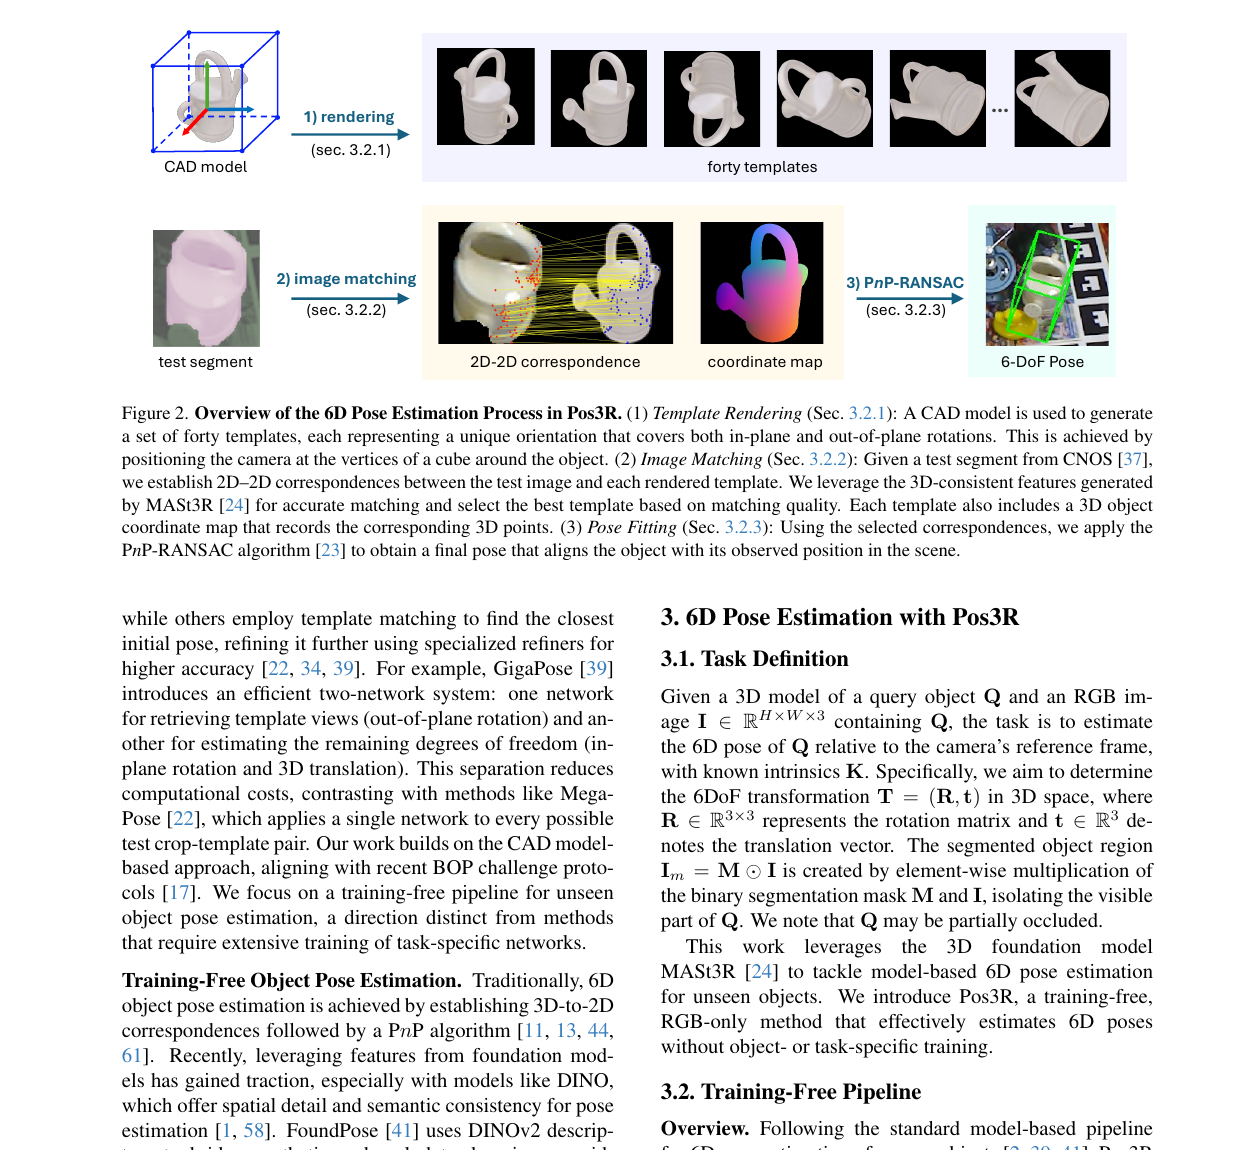 原论文 Figure 2:Pos3R 用 CAD 渲染模板,并利用 3D reconstruction foundation feature 做模板选择与对应关系估计。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- 输入为单 query RGB、目标 CAD 渲染模板;输出 BOP 相机坐标系中的 6D pose。
- 不做额外 pose training,但引入了预训练的 3D foundation model 和 CAD;因此是 training-free / model-based,不是 model-free。
- 论文还研究从预测 3D shape 出发的变化,应与 CAD 输入版本分别阅读。
4. 方法详解
- Template rendering:对 CAD 生成不同视角及相应的 3D coordinate map。
- 3D-consistent matching:使用 MASt3R 特征与 query 进行 matching;其优势在于对视角变化的几何一致性。
- Pose solve / refinement:由选择到的模板和 correspondence 求 pose;可无缝连接现有 render-and-compare refiner,作者将这作为高精度场景的可选后端。
5. 实验分析
- BOP Table 1 是七数据集 AR,核心证据是无额外 pose training 的 template pipeline 仍能匹配或超过部分 refinement-free baseline。
- Table 2 比较 predicted 3D model;这回答的是“CAD 缺失时 3D shape prior 是否仍可用”,不能和 CAD 版本混为一组。
- Table 3 分离 pose method 的影响,提醒读者性能并非只由 MASt3R feature 决定,template selection、PnP 和 refinement 都参与。
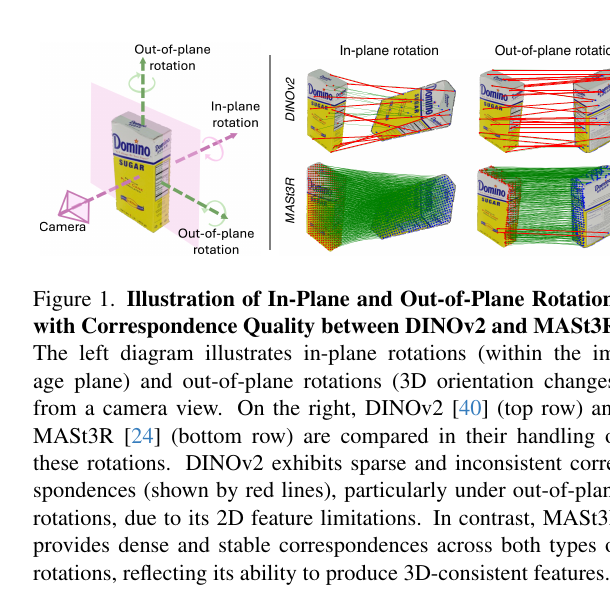 Pos3R 原论文 Figure 1:DINOv2 在 out-of-plane rotation 下对应稀疏且不稳定,MASt3R 的 3D-consistent feature 在两类旋转下保持更稠密的对应。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Figure 1 展示的是设计动机而不是定量证明:二维语义特征可在平面内旋转下保持相似区域匹配,但视角绕三维轴改变后,纹理位置与可见面同时变化;MASt3R 的 pointmap / confidence 训练目标更接近跨视图三维一致性。真正验证这一点的是后续替换实验:保持 pose pipeline 基本不变,把 MASt3R 换为 DINOv2-L11 / L9,七集 AR 都显著下降。
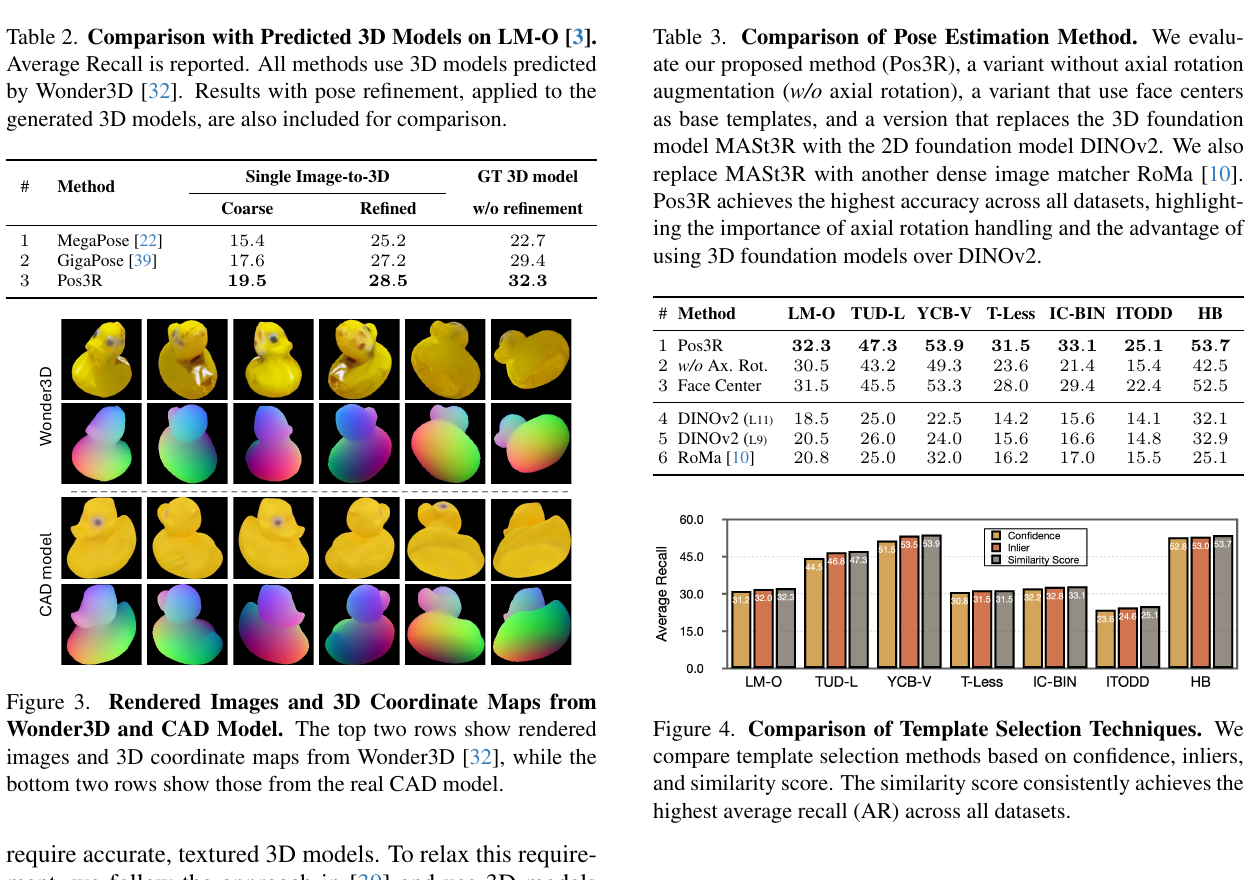 Pos3R 原论文组件分析:左侧比较 Wonder3D 单图模型与真值 CAD,右侧比较轴向旋转、face-center template、DINOv2 / RoMa 替换以及三种模板评分。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
LM-O 使用 Wonder3D 单图生成模型时,Pos3R coarse / refined AR 为 19.5 / 28.5,高于同设定 MegaPose 的 15.4 / 25.2 和 GigaPose 的 17.6 / 27.2;换回 GT 3D model 且不精修时为 32.3。13 个点的差距直接表明单图三维质量仍是 CAD-free 变体的主要上限,不能只强调它“支持预测模型”而忽略与真值 CAD 的落差。
完整 Pos3R 在 LM-O / TUD-L / YCB-V / T-LESS / IC-BIN / ITODD / HB 上的 AR 为 32.3 / 47.3 / 53.9 / 31.5 / 33.1 / 25.1 / 53.7。去掉 axial rotation 后对应降为 30.5 / 43.2 / 49.3 / 23.6 / 21.4 / 15.4 / 42.5;改用 face centers 也普遍下降。把 MASt3R 换成 DINOv2-L11 后 YCB-V 仅 22.5,换成 RoMa 为 32.0,远低于 53.9。模板选择方面 similarity score 在七集都略优于 confidence 或 inlier 数,但差距小于 foundation feature 的替换差距。
6. 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| 3D foundation model 缓解 template selection | Figure 1 的定性对应与 BOP 结果方向一致;还应量化 template top-k recall。 |
| 无 pose-specific training 也可竞争 | 可成立,但代价转移为依赖大规模预训练模型、CAD render 和前端 detection。 |
7. 复现要点与限制
- 模板 render 的相机内参与 MASt3R 输入 resize / crop 必须保持同步,否则 2D–3D 对应会系统性错位。
- 对高度对称、低纹理、CAD 与实物外观偏差大的对象,3D-consistent feature 仍可能得到多解。
- 若接 refinement,须单独报告它带来的增益,避免把前端 feature 的作用归因过度。
- BOP 主表的 coarse Pos3R 是 training-free,五 hypothesis 的 MegaPose refinement 不是;实现和页面标签应在结果层面明确拆开,避免把预训练 pose refiner 的监督误归给 MASt3R。