论文精读笔记:R²-Art: Category-Level Articulation Pose Estimation from Single RGB Image via Cascade Render Strategy
1. 基本信息
作者 / 机构:Li Zhang 等;中国科学院合肥物质科学研究院、中国科学技术大学、Astribot、浙江工业大学、中国农业大学、北京大学、合肥工业大学。
年份 / 会议:2025 / AAAI。
论文页 · 官方 PDF 阅读模式:精读。
2. 一句话定位
R²-Art 把 articulated pose 看成“root pose + joint state + per-part alignment”的联合问题;它以单 RGB 预测位姿,用可渲染的 joint-centric prior 提供由粗到细的训练监督,推理为无需额外后处理的 end-to-end 过程。
2.1 论文图表导读
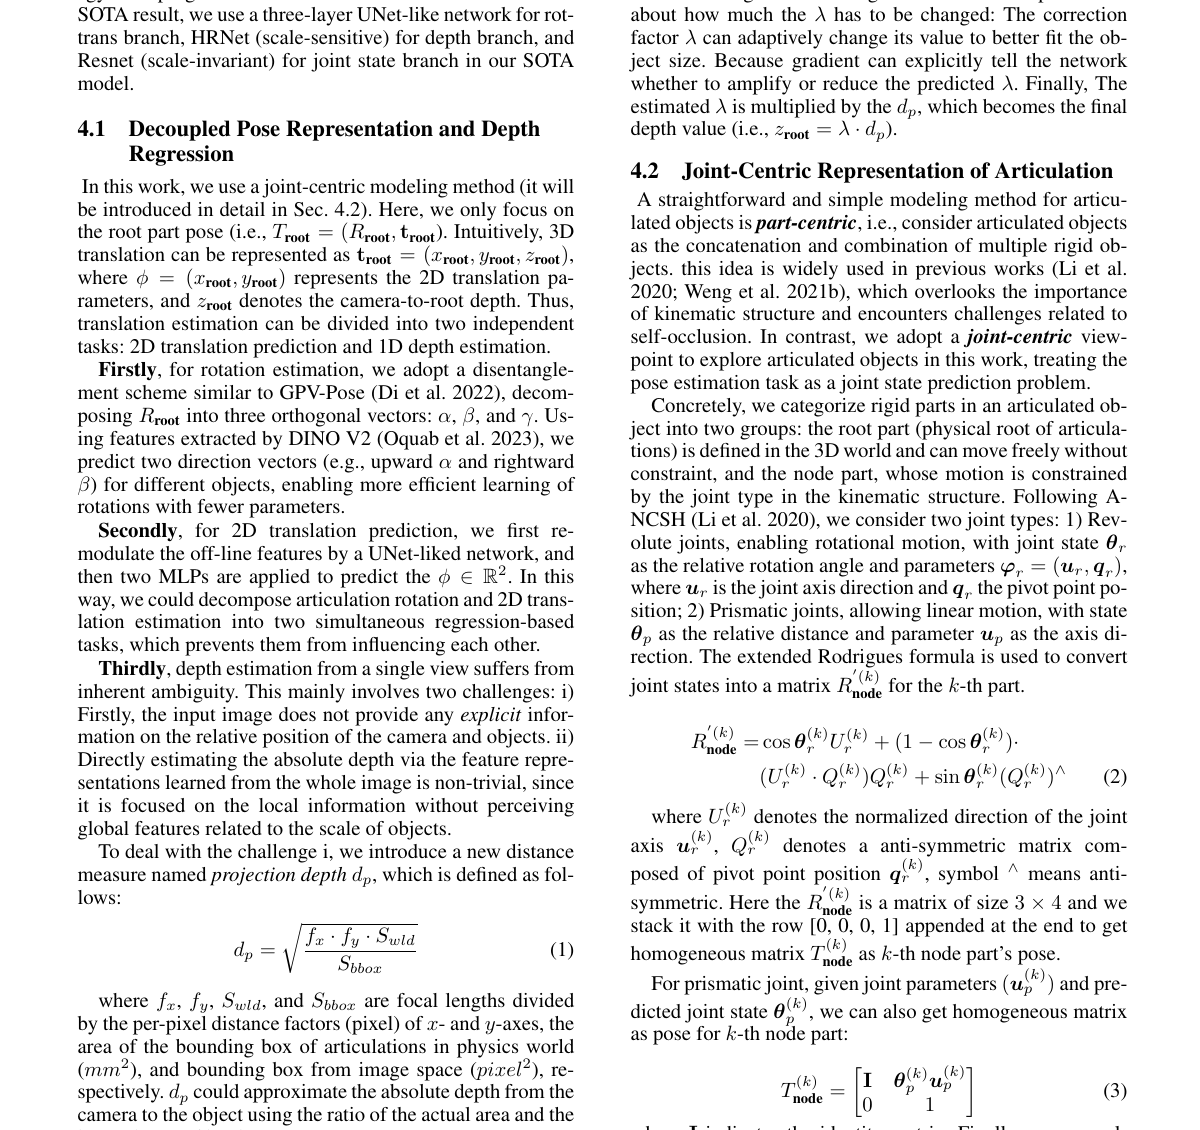
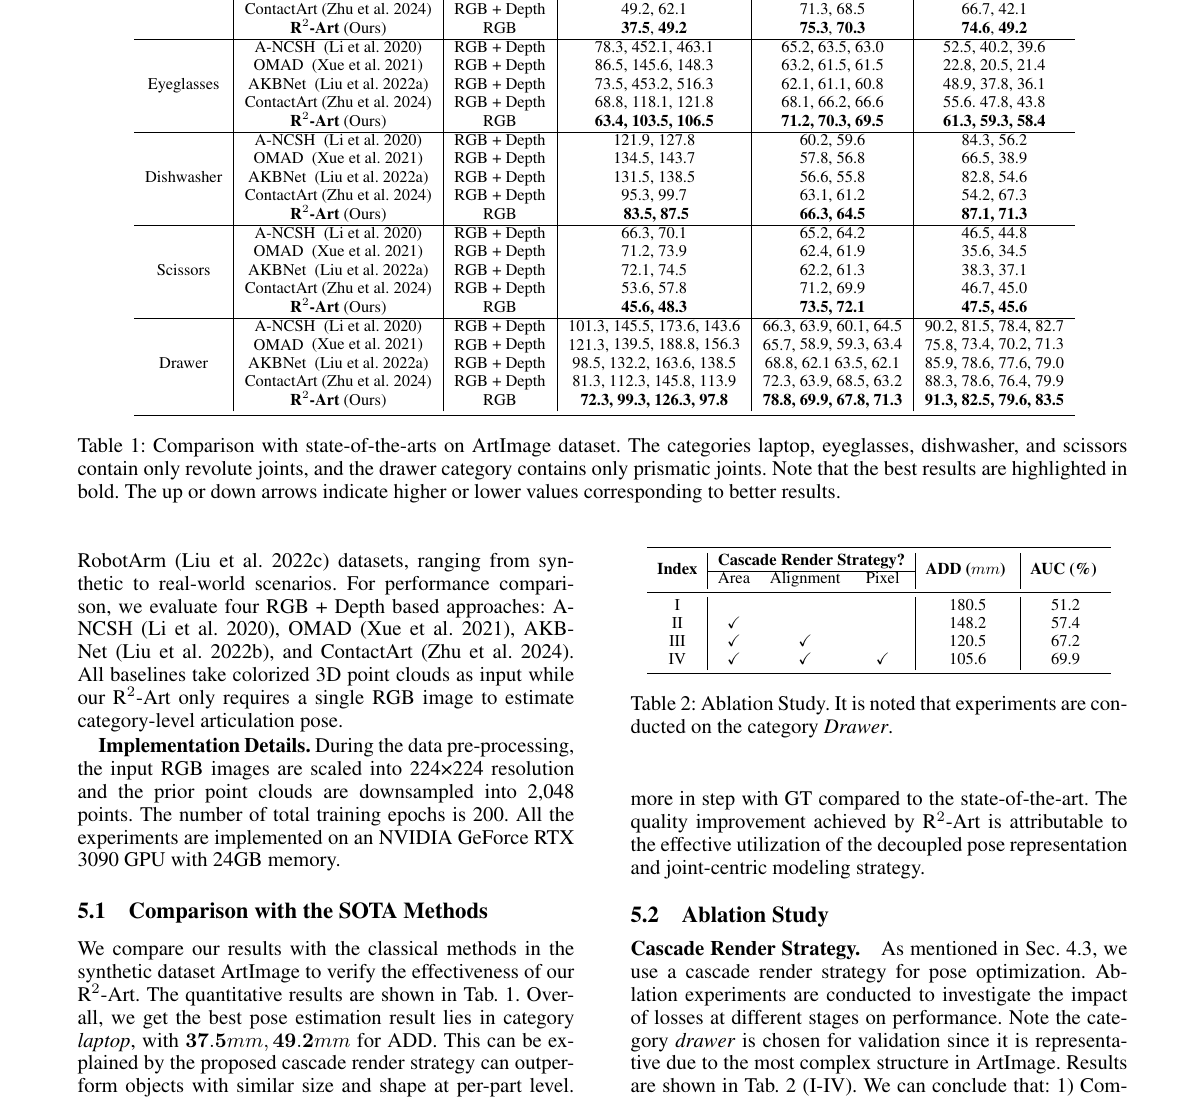
图表 阅读重点 方法 / loss 图 三阶段 rendering loss 的约束对象不同,目的是让从 3D prior 到 2D mask 的匹配逐步变严格 Table 1 ArtImage 与 RGB-D 方法并列;比较时必须注意输入模态不相同 Table 2 Drawer 上从 Stage I 到完整 cascade 的增益,最直接支持其主张
原论文 Sections 4.1–4.2 页面局部:root pose / depth 解耦回归与 joint-centric articulation 表示。来源:AAAI 官方 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
原论文 ArtImage Table 1 与 Drawer cascade ablation Table 2 页面局部;当前图片不包含 ReArtMix 或 RobotArm 结果表。来源:AAAI 官方 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 任务边界
输入是 single RGB,不输入深度或点云;仍需要类别级 articulated prior、目标区域信息与相机模型。
输出不是只给一个 rigid 6D pose,而是为可动物体各 part 估计姿态,同时估计 / 使用 joint state。
相比固定刚体,关节变化会使同一类别的表观和遮挡模式大幅改变,因此直接 template matching 很容易失配。
4. 方法详解
模块 做法 作用 初值回归 并行预测 camera-to-root translation、rotation 与 joint state 为关节建模与渲染监督提供位姿预测 Joint-centric prior 按预测关节状态变换 / 形变类别 prior 的部件 让 canonical prior 与当前 articulation 对齐 Cascade render strategy 从 area alignment 到 pixel-level 约束的多阶段渲染损失监督 训练中通过 2D 图像证据改善 per-part pose 预测
joint-centric prior 把部件运动学关联接入预测,并将 3D 解释反投影到图像中监督。Section 4.3 与 Algorithm 1 的渲染损失在训练中反向传播更新预测分支;引言说明推理不需要额外后处理。prior、mask 和 differentiable rendering 的误差会影响训练收敛。
5. 实验与数值
设置 论文报告关键数值 含义 ArtImage Drawer 第4个部件:ADD 97.8 mm、AUC 71.3% 逐部件数值,不是类别均值或 3D IoU;纯 RGB 与 RGB-D 同表比较还需注意输入不等量 ReArtMix Box ADD 30.2 / 37.2 mm,AUC 78.3 / 76.2% 两个 part 的结果,显示半合成场景中的 per-part 对齐 Drawer cascade ablation Stage I: 180.5 mm / 51.2%;Full: 105.6 mm / 69.9% 级联渲染是主要性能来源,而非只有初值网络
论文还报告 RobotArm 7-part 的定量与可视化。对我而言,真正值得复用的是消融设计:以“每多一层渲染约束,ADD 是否持续下降”来验证 refinement,而不只列一个最终数。
6. 优点、局限与启发
优点 :明确将关节状态进入几何 prior;RGB-only 设定有实际吸引力;ablation 能区分各阶段作用。
局限 :类别 / 部件 prior 是强条件;单 RGB 下的深度与遮挡歧义仍可能产生多个合理解释;论文未充分展开未知 articulation topology 的泛化。
启发 :对多部件物体可把 pose refinement 的自由度放在运动学图中,而不是让每个 part 独立回归;同时需要为不可观测部件输出 uncertainty,而不是强行给单一 pose。