论文精读笔记:RAG-6DPose
1. 核心判断
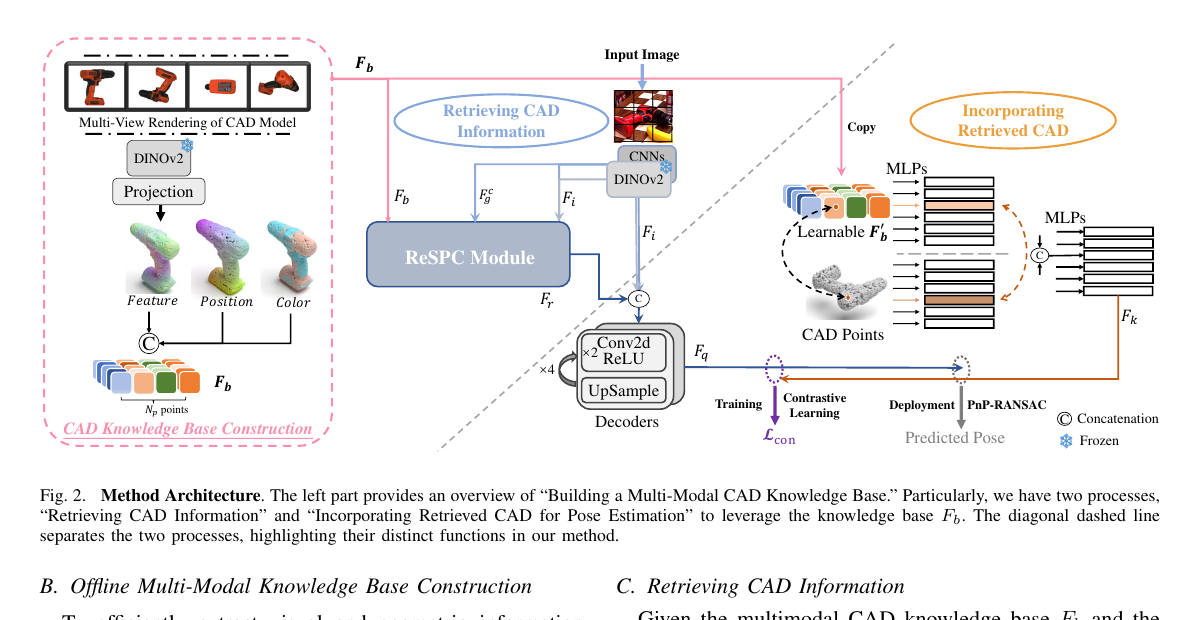
RAG-6DPose 的问题意识是:传统 RGB pose 方法要么只把 CAD 当训练监督,要么只编码 CAD 几何;CAD 可渲染出的对象外观没有在推理时被充分利用。作者把 3D CAD 表面改造成可检索的点级 memory:
每个点携带多视角 DINOv2 外观;
同时保留 3D 坐标与颜色;
查询图像通过 cross-attention 选择与当前可见区域相关的 CAD 点特征;
检索结果不是直接生成 pose,而是增强 SurfEmb 式 dense correspondence。
所以它与文本 RAG 只有“parametric model + external memory + query-conditioned retrieval”的结构类比,不含语言模型、文档检索或生成式推理。最直接的实验支持是 LM-O AR 70.0,移除 knowledge base + ReSPC 后降到 66.5。
2. 任务边界与系统依赖
原论文 Figure 2。粉色区域为逐对象离线 knowledge-base construction,蓝色区域检索,橙色区域把检索结果注入 query / CAD key features。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
方法属于 instance-level、known-object pose :
在线输入:对象 RGB crop、相机内参、对象身份;
离线输入:准确 CAD、材质 / 颜色、渲染器与一组虚拟相机;
外部前端:BOP Challenge 2023 默认 detector;
RGB-D 版本还输入 depth,并在初始 pose 后运行 ICP;
每个数据集训练一个共享网络,不为每个对象训练完整网络,但每个对象有独立 knowledge base 和少量可学习 key features。
“one pose estimator”降低了逐对象网络数量,不代表对新 CAD 无训练即可泛化。论文五个数据集均是已知对象 protocol。
3. 离线 CAD knowledge base
作者沿 CNOS 的视角选择策略,从 CAD 渲染多视角 RGB-D。每个视角:
DINOv2-Base 提取 2D feature map;
上采样到原图分辨率;
rendered depth 反投影为点云;
对 CAD 表面采样点 p k p_k p k p k p_k p k
同一 CAD 点跨所有覆盖视角的 feature 取平均。
最终每点拼接:
F b ( p k ) = [ DINO appearance , 3D positional encoding , color ] . F_b(p_k)=
[\text{DINO appearance},\ \text{3D positional encoding},\ \text{color}]. F b ( p k ) = [ DINO appearance , 3D positional encoding , color ] . 这个设计把视角相关的 2D backbone 特征平均成点级表示,方便任意查询视角检索,但也可能抹平强 view-dependent appearance。论文没有报告视角数 m m m N p N_p N p
4. ReSPC 如何“检索”
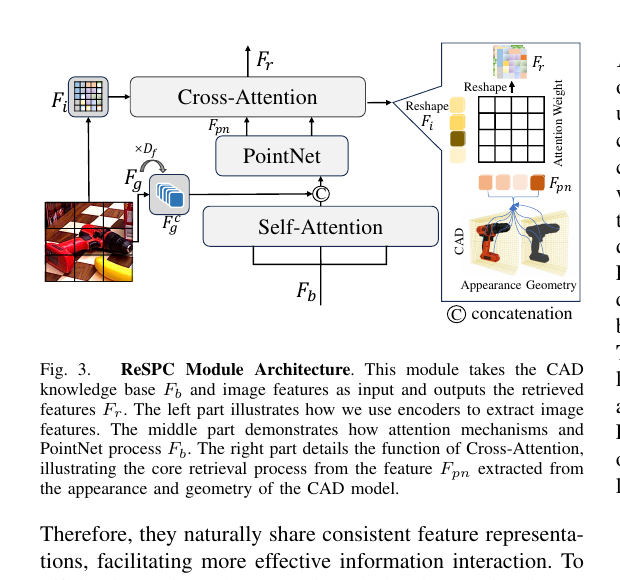
原论文 Figure 3。CAD memory 先经 self-attention 与 query-global-guided PointNet;查询图 feature 作 cross-attention query,CAD appearance / geometry feature 作 key/value,attention weights 即检索权重。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
ReSPC 分三段:
4.1 CAD self-attention
F s a = SelfAttn ( F b ) , F_{sa}=\operatorname{SelfAttn}(F_b), F s a = SelfAttn ( F b ) , 对点级 memory 建模全局与局部关系,并用 linear layer 降维。
4.2 查询全局特征引导 PointNet
查询图经 ResNet34 得到全局 F g F_g F g F g c F_{gc} F g c F s a F_{sa} F s a
F p n = PointNet ( [ F s a , F g c ] ) . F_{pn}=\operatorname{PointNet}([F_{sa},F_{gc}]). F p n = PointNet ([ F s a , F g c ]) . 因此 CAD memory 不是静态读取;同一对象在不同查询图上会产生不同 F p n F_{pn} F p n
4.3 Cross-attention retrieval
查询图还经冻结 DINOv2 与 ResNeXt-101 32×8d,拼成 dense F i F_i F i
F r = CrossAttn ( F i , F p n , F p n ) . F_r=\operatorname{CrossAttn}(F_i,F_{pn},F_{pn}). F r = CrossAttn ( F i , F p n , F p n ) . F i F_i F i F p n F_{pn} F p n
5. 检索结果如何变成 pose
Query branch
F r F_r F r F i F_i F i
U-Net style feature decoder 输出像素 query feature F q F_q F q
mask decoder 输出对象 probability。
CAD key branch
固定 knowledge base F b F_b F b F b ′ F_b' F b ′ p j p_j p j F b ′ F_b' F b ′ f j f_j f j
f k = S i ( [ S g ( p j ) , S v ( f j ) ] ) . f_k=S_i([S_g(p_j),S_v(f_j)]). f k = S i ([ S g ( p j ) , S v ( f j )]) . 训练与推理
真值 pose 渲染出的 visible object coordinates 提供正 2D–3D pair,其他均匀 CAD surface points 为负样本。总损失:
L = L I n f o N C E + α L m a s k . L=L_{\mathrm{InfoNCE}}+\alpha L_{\mathrm{mask}}. L = L InfoNCE + α L mask . 推理时计算 F q F_q F q F k F_k F k
6. 数据、训练和指标
LM-O、IC-BIN、HB、YCB-V:使用合成训练图;
TUD-L:合成 + 真实训练图;
image crop:224×224;
optimizer:Adam,固定 learning rate 3 × 10 − 5 3\times10^{-5} 3 × 1 0 − 5
hardware:RTX A6000 与 RTX 3090;
query backbone:DINOv2-Base + ResNeXt-101 32×8d;
detector:BOP Challenge 2023 默认结果。
BOP AR 是 VSD、MSSD、MSPD 三组阈值 recall 的平均。它比单一 ADD(-S) 更全面,也 symmetry-aware;但跨论文比较仍需确认 detector、test targets、refinement 和 BOP toolkit 版本相同。
7. RGB 与 RGB-D 主结果
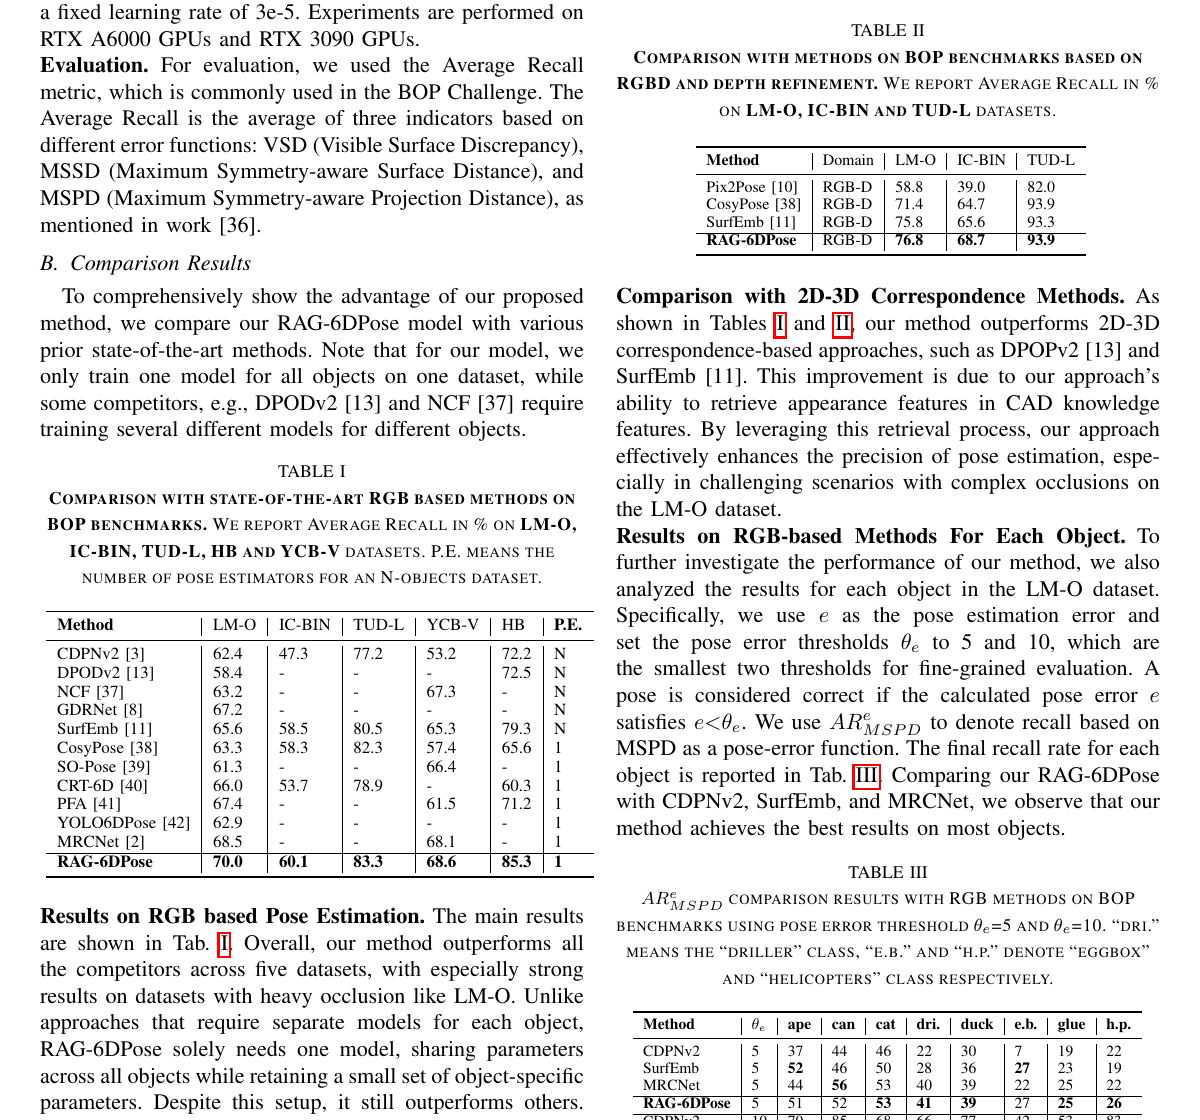
原论文 Table I–III。Table I 为 RGB,Table II 为 RGB-D / depth refinement,Table III 展开 LM-O 的每对象 MSPD recall。来源:作者公开稿 ;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
RGB BOP AR
方法 LM-O IC-BIN TUD-L YCB-V HB SurfEmb 65.6 58.5 80.5 65.3 79.3 MRCNet 68.5 — — 68.1 — RAG-6DPose 70.0 60.1 83.3 68.6 85.3
相对 SurfEmb 的五数据集差值为 +4.4、+1.6、+2.8、+3.3、+6.0,平均 +3.62。对 MRCNet 的提升较小:LM-O +1.5、YCB-V +0.5。
LM-O 每对象严格 MSPD threshold 5 下,RAG 不是每类第一:ape 51 低于 SurfEmb 52,can 52 低于 MRCNet 56;在 cat / driller / duck / holepuncher 等多类领先或并列。threshold 10 下 eggbox 59 低于 SurfEmb 70,holepuncher 87 低于 MRCNet 90,说明平均领先不等于所有 symmetry / texture 情况都更稳。
RGB-D + ICP
方法 LM-O IC-BIN TUD-L SurfEmb 75.8 65.6 93.3 CosyPose 71.4 64.7 93.9 RAG-6DPose 76.8 68.7 93.9
RGB→RGB-D 后 RAG 分别 +6.8 / +8.6 / +10.6,说明 depth refinement 是重要组成部分;不能把 RGB-D 数字归因于 retrieval 单模块。
8. 消融与遮挡定性
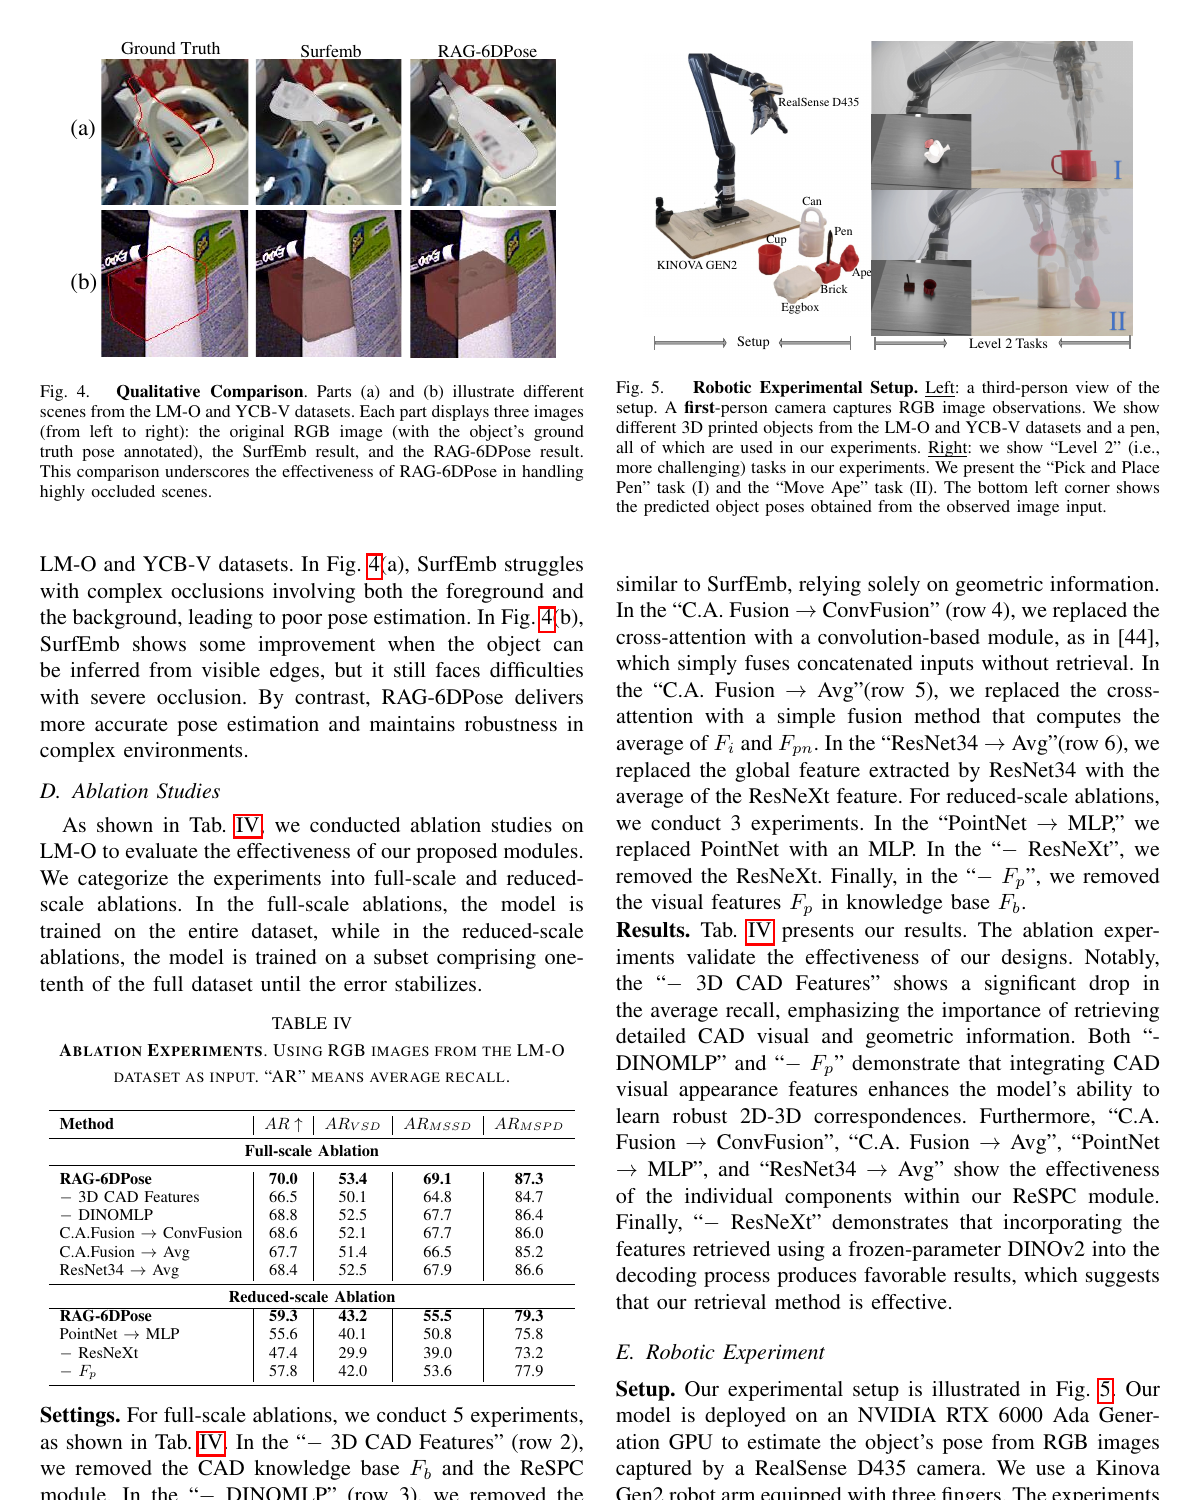
原论文 Figure 4–5 与 Table IV。上方比较重遮挡下的 SurfEmb / RAG overlay,并给出机器人设置;左下是完整与 1/10 数据消融。来源:作者公开稿 ;图片与表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
Full-scale LM-O:
配置 AR ARVSD ARMSSD ARMSPD full 70.0 53.4 69.1 87.3 − CAD knowledge base / ReSPC 66.5 50.1 64.8 84.7 − learnable DINO memory copy 68.8 52.5 67.7 86.4 cross-attention→ConvFusion 68.6 52.1 67.7 86.0 cross-attention→average 67.7 51.4 66.5 85.2 ResNet34 global→average 68.4 52.5 67.9 86.6
知识库整体贡献 +3.5;cross-attention 相对简单平均 +2.3,支持“查询条件检索”而非只增加 CAD feature。Reduced-scale 的 −ResNeXt 从 59.3 降到 47.4,但与 full-scale 使用不同训练量,不能跨分组比较绝对值。
定性图只有两个作者选择的成功样例,没有失败案例或按遮挡率分桶。它支持直观解释,但定量遮挡鲁棒性主要仍来自 LM-O 平均结果。
9. 机器人实验与速度
Kinova Gen2 + RealSense D435 + RTX 6000 Ada:
任务 成功 / 10 Grasp Brick 10 Grasp Cup 10 Grasp Eggbox 10 Pick and Place Pen 9 Move Ape 9
Level 2 需要先后估计两个对象 pose;pen 本身不在训练集,但动作主要依赖 brick / cup 的 pose,不构成“RAG 对 unseen pen 做 6D pose”的证据。每项 10 次样本很少,没有与 baseline、失败类型、耗时或置信区间比较。
论文正文不报 runtime。作者项目页补充:TUD-L 单对象 query encoder-decoder 约 65 ms,MRCNet 为 61 ms;含 PnP-RANSAC 的总时间与 SurfEmb 接近,但没有给精确总数。这个数字不含离线 CAD onboarding,且硬件 / batch 细节不足。
10. 开源与复现风险
官方仓库已公开,基于 SurfEmb,包含训练命令、BOP evaluation 和 custom BOP-format preprocessing。需要重点核对:
CNOS 视角数量与采样、render resolution、材质、光照;
DINOv2 feature layer、patch alignment、上采样方式;
CAD 点数、nearest assignment、未被视角覆盖点与多视角平均;
knowledge base dtype、每对象存储和 F b ′ F_b' F b ′
ResNet34 global、ResNeXt dense 与 DINOv2 feature 的分工;
ReSPC head 数、feature dimension、PointNet 结构;
positive / negative sampling、InfoNCE temperature 和 mask 权重 α \alpha α
detector、PnP-RANSAC、score refinement、ICP 的参数与分段 latency。
11. 局限
仍需精确且带合理外观的 CAD,材质错误会污染 memory;
对新对象需重新渲染、编码并可能训练 object-specific features;
offline knowledge-base 成本与存储未量化;
多视角平均可能抹平镜面 / view-dependent appearance;
没有透明、反光、纹理域差的专门评测;
机器人实验规模小,且预定义 grasp policy 掩盖了 end-to-end 操作误差;
RGB-D 提升与 ICP 耦合,retrieval 本身的增益应以 RGB 消融判断;
一套 detector / benchmark protocol 下领先,不代表开放场景检测已解决。
12. 最终评价
RAG-6DPose 是一篇结构完整的 CAD-based dense matching 工作:它把多视角渲染特征锚定到 CAD 点,查询图通过 ReSPC 读取相关外观与几何,再回到可解释的 2D–3D correspondence + PnP。与 SurfEmb 的稳定增益、知识库消融和开放代码使其值得优先阅读;部署判断则必须把逐对象 onboarding、detector、PnP / ICP 与知识库存储一并计入。