论文精读笔记:RCGNet
1. 核心判断
RCGNet 的关键并不是“用 DINOv2 替代 CNN”本身,而是把 RGB-only 类别级 pose 的缺失深度问题拆成两个阶段:训练时允许读取真值对象点云,把其 NOCS 几何特征当作监督信号;推理时只保留 RGB 分支,让网络预测一个近似几何表示。随后它仍采用类别级 pose 中较成熟的“prior deformation + correspondence + PnP”路线。
因此,论文中“RGB-only”应严格理解为部署输入只有 RGB,而不是不使用几何先验或几何监督。方法仍需要每类别 prior point cloud、训练样本点云、对象 mask 和 camera intrinsics。这个区分决定了它与真正 model-free / geometry-free 方法的边界。
2. 任务边界与变量
输入对象 crop 为 Io∈RH×W×3,类别先验点云为 Pr∈RNr×3,论文设 H=W=224、Nr=1024。网络输出:
- 先验点云 deformation D;
- 将变形后先验点映射到图像像素的 correspondence matrix A;
- 相对类别 benchmark scale sb 的尺度偏移 ΔS;
- 最终旋转 R、平移 t 和尺寸 s。
对象类别固定为 NOCS benchmark 的 bottle、bowl、camera、can、laptop、mug;测试实例可以在训练中未见。它不是开放类别识别,也不是给任意新类别提供一个 CAD 就能运行的 zero-shot estimator。
3. 完整 pipeline
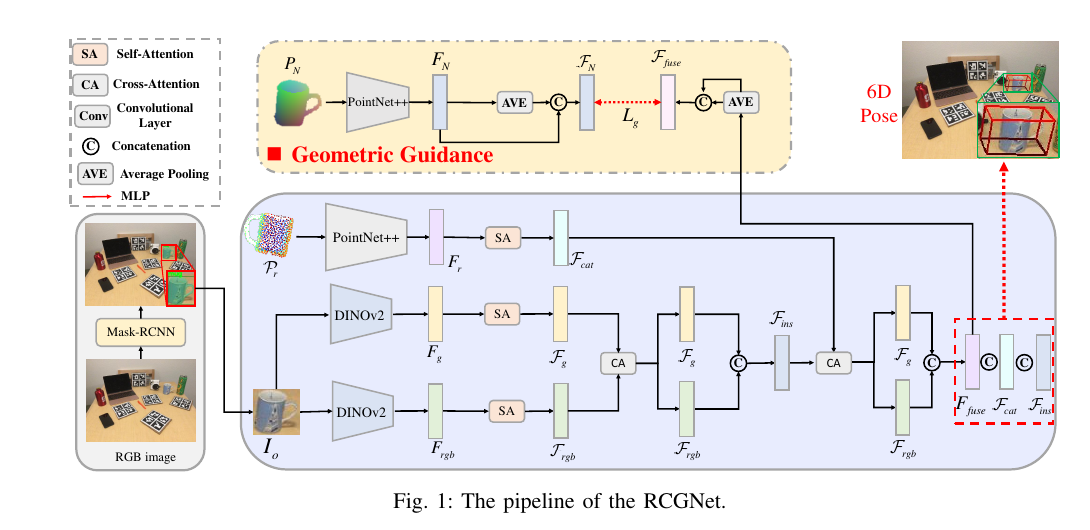 原论文 Figure 1。红色虚线所示的 geometric guidance 只在训练时使用;真正进入 PnP 的是 RGB / 预测几何 / 类别点云融合表示。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
3.1 对象裁剪与双 DINOv2 表示
论文先用 Mask R-CNN 获取实例 mask 和 crop。两个冻结 DINOv2 分支读取同一 RGB patch:一个产生 Frgb,强调外观语义;另一个产生 Fg,被训练为几何特征预测器。每个分支先经 self-attention:
Frgb=SA(Frgb)+Frgb,Fg=SA(Fg)+Fg.
随后进行双向 cross-attention:几何特征以 RGB 为 key/value,RGB 特征也以几何特征为 key/value。两者拼接得到实例特征 Fins。这种结构意在让“从颜色推出来的几何”不能脱离图像语义,同时让 RGB 表示获得形状敏感信息。
论文把 DINOv2 权重冻结,因此 pose 数据主要训练 attention、MLP 和后续点云 / correspondence 模块。冻结 backbone 降低训练开销,却也意味着几何能力主要来自后接分支与损失,而不是对 DINOv2 全量适配。
3.2 类别 prior 与实例特征融合
PointNet++ 编码类别 prior point cloud 得到 Fr,经 self-attention 汇聚为 Fcat。网络再将 Fcat 与 Fins 通过 cross-attention 融合为 Ffuse。
这里的 prior 不是查询实例的 CAD,而是该类别共享的规范点集。网络通过预测 D 把它形变为当前实例:
D=MLP(Fcat,Ffuse),Pinstance≈Pr+D.
这让方法具备类别内实例适应性,但上限仍受 prior 拓扑与训练类别限制。
3.3 Geometric guidance
训练时,作者把真值对象点云 Po 用真值 R,t,s 变换到 NOCS:
PN=(Po−t)/s⋅R.
PointNet++ 从 PN 提取真实 NOCS 几何特征 FN。网络对 Ffuse 做 average pooling、repeat 和拼接,再用
Lg=MSE(Ffuse,FN)
让 RGB 分支的融合表示接近真实几何特征。推理阶段没有 Po 与 FN,因此这更接近 feature-level geometry distillation。
这一设计的隐含假设是:训练集的 RGB–点云对齐和 NOCS pose 标注足够准确;若几何监督本身受深度噪声、对称坐标不一致或 mask 偏差影响,网络也会学习这些偏差。
3.4 尺度、对应与 PnP
RGB 缺乏绝对尺度,作者为每类设 benchmark scale sb,网络只回归相对变化:
s=sb+sbΔS.
另外,网络预测 correspondence matrix A,将变形并缩放后的 prior 点与 crop 像素对应;最后使用
R,t=PnP(PI,s⋅A(Pr+D))
恢复姿态。RANSAC 负责降低错误对应的影响。总损失由 scale loss、correspondence loss 和 geometry guidance 组成,论文设置 λ1=1,λ2=0.1,λ3=100。
需要注意:scale branch 不是可选附属项。PnP 中 3D 坐标的尺度直接影响平移,消融也显示不使用类别基准尺度会明显损害结果。
4. 数据、训练与指标
- CAMERA25:约 300K 合成训练图,25K evaluation images。
- REAL275:4,300 张真实训练图、2,750 张真实评测图。
- Wild6D:用 CAMERA25 + REAL275 训练的网络做跨数据集定性测试。
- 训练:RTX 3090,PyTorch 1.12.1,batch size 16,120 epochs。
- 前端:按既有类别级工作使用 Mask R-CNN 检测 / 分割。
指标包括 3D IoU50、IoU75,以及误差阈值 10 cm、10°、10°10 cm 下的 mAP。它们分别强调 3D box overlap、translation、rotation 和二者联合成功率。论文没有报告标准 BOP VSD / MSSD / MSPD,也没有按类别列出误差分布。
5. 主结果
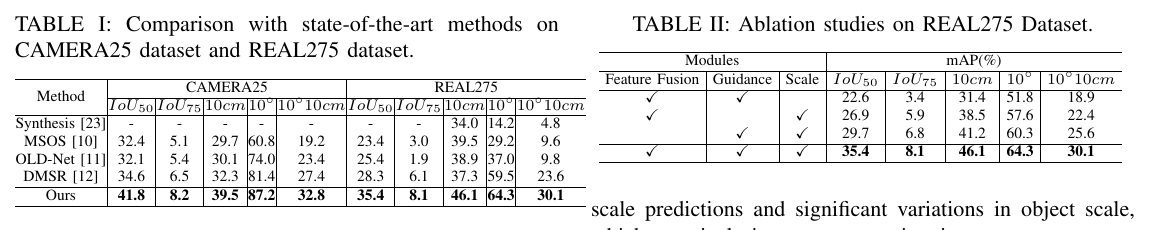 原论文 Table I–II。Table I 只与 RGB-based category-level baselines 比较;Table II 在 REAL275 上逐项验证 feature fusion、guidance 与 scale。来源:作者公开稿;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
| 数据集 | IoU50 | IoU75 | 10 cm | 10° | 10°10 cm |
|---|
| CAMERA25 | 41.8 | 8.2 | 39.5 | 87.2 | 32.8 |
| REAL275 | 35.4 | 8.1 | 46.1 | 64.3 | 30.1 |
在 CAMERA25 上,DMSR 的五项结果为 34.6 / 6.5 / 32.3 / 81.4 / 27.4;RCGNet 分别提高 7.2、1.7、7.2、5.8、5.4 个 mAP 点。在 REAL275 上,DMSR 为 28.3 / 6.1 / 37.3 / 59.5 / 23.6,RCGNet 分别提高 7.1、2.0、8.8、4.8、6.5 点。
结果支持论文在 RGB-only baseline 内的相对优势,但绝对 IoU75 仍只有约 8%,说明准确尺寸和紧致 3D box 对该设定仍很困难。论文没有把这些结果与使用真实 depth 的强 RGB-D 类别级方法放在同一表中,因此不能据此声称 RGB-only 已追平 RGB-D。
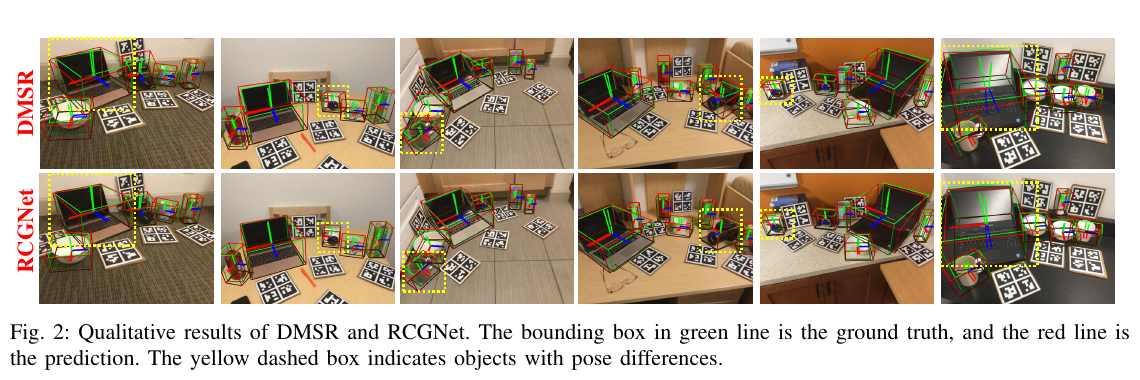 原论文 Figure 2:绿色框为真值,红色框为预测;黄色虚线框标出 DMSR 与 RCGNet 差异较明显的对象。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
定性图显示相机、笔记本等复杂对象的姿态框更贴近真值;但图中场景和样本由作者挑选,不能代替每类别统计或失败案例。
6. 消融
REAL275 的四组设置为:
| Feature fusion | Guidance | Scale | IoU50 | IoU75 | 10 cm | 10° | 10°10 cm |
|---|
| ✓ | ✓ | — | 22.6 | 3.4 | 31.4 | 51.8 | 18.9 |
| ✓ | — | ✓ | 26.9 | 5.9 | 38.5 | 57.6 | 22.4 |
| — | ✓ | ✓ | 29.7 | 6.8 | 41.2 | 60.3 | 25.6 |
| ✓ | ✓ | ✓ | 35.4 | 8.1 | 46.1 | 64.3 | 30.1 |
三项模块都有贡献:
- 去 scale 的联合阈值从 30.1 降至 18.9,是最大降幅;
- 去 geometric guidance 降至 22.4,说明训练期真实几何监督确实重要;
- 用直接拼接替代 cross-attention fusion 时为 25.6,说明融合不是无关紧要的结构装饰。
不过表中没有报告随机种子、均值 / 标准差,也没有把 guidance 换成其他 feature distillation loss,因此无法判断 MSE 与高权重 λ3=100 是否最优。
7. 跨数据集泛化与作者自述限制
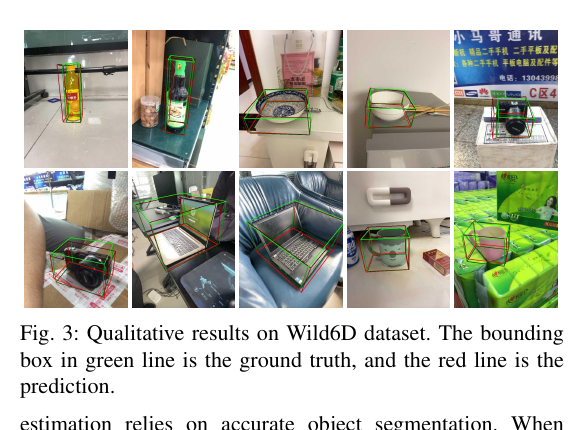 原论文 Figure 3:模型只在 CAMERA25 与 REAL275 训练,在 Wild6D 展示跨数据集预测;论文没有给出这部分定量指标。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
作者明确列出三个限制:
- 依赖准确 object recognition / segmentation,前端位置偏差会传入 pose;
- 合成与真实图像仍有 domain gap;
- RGB-based 精度与 RGB-D 方法之间仍存在差距。
Wild6D 图只能证明 pipeline 可以运行并产生看似合理的 box,不能支持“在 Wild6D 上达到某个精度”或“跨任意类别泛化”的更强结论。
8. 本站批判性分析
优点
- 清楚区分训练期几何监督与推理期 RGB-only;
- 不先生成显式 depth / normal map,减少一项可能积累误差的中间预测;
- correspondence + RANSAC-PnP 保留了几何可解释后端;
- 主结果、消融、跨数据集图和作者限制形成较完整证据链。
局限与隐含假设
- 几何 guidance 要求训练数据有深度 / 点云和准确 pose,因此没有降低标注侧几何成本;
- 类别 prior point cloud 与 benchmark scale 仍是硬先验;
- Mask R-CNN 前端不是端到端共同训练,检测错误无法由 pose loss 纠正;
- benchmark 只含 6 个室内日常类别,尚未验证细长、透明、反光或开放类别;
- 没有 runtime、参数量、显存与 RANSAC 迭代开销,摘要中的“highly efficient”缺少完整系统数字;
- 对称对象只通过现有 NOCS / correspondence 监督间接处理,没有给出对称等价 pose 的专门分析。
9. 复现检查表
- 明确每类别 prior point cloud、坐标朝向与 benchmark scale;
- 复现 Mask R-CNN crop、224×224 resize 和像素坐标回映;
- 固定 DINOv2 型号、冻结层、token resolution 和 attention channel;
- 核对 Po→PN 的旋转左右乘约定与尺度单位;
- 保存 geometry guidance 分支的特征维度、pool / repeat 细节和 λ3;
- 报告 RANSAC-PnP 阈值、候选点数、失败返回规则;
- 区分 GT mask 与 predicted mask,分别报告 pose;
- 对每类别与对称对象补充 IoU / rotation / translation 误差和多随机种子结果。
10. 最终评价
RCGNet 为“训练时看几何、推理时只看 RGB”的类别级 pose 提供了简单而有效的实现。其证据足以支持:在 CAMERA25 / REAL275 的 RGB-based baselines 中,几何引导、attention fusion 和尺度分支共同带来提升。它尚不能支持:摆脱几何先验、追平 RGB-D、或对开放类别稳健泛化。把这三条边界写清后,这篇论文很适合用来理解 RGB-only 类别级 pose 中几何知识究竟藏在哪里。
