论文精读笔记:SCAPO: Self-Supervised Category-Level Articulated Pose Estimation from a Single 3D Observation
1. 核心判断
- 论文:CVF Open Access
- 项目 / 代码:SCAPO project / GitHub
- 核心判断:SCAPO 的贡献在于把 articulated object 的“形状、全局 pose、部件、关节”放入一个可循环重建的 canonical representation;它不是只预测 joint angle,而是学习一个可解释的结构空间。
2. 一句话定位
单次 3D 观测经过 SE(3)-equivariant canonicalization 后,在共享 canonical shape 上用 blend-skinning 推断部件与关节,并通过 observed↔canonical cycle reconstruction 自监督训练。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | 输入、canonicalization、part segmentation、joint parameter 的数据流是否闭合? |
| Figure 2 | SE(3) autoencoder 和 joint-aware deformation 如何衔接? |
| Table 1 | 合成数据上 segmentation、direction、pivot、part pose 是否同时改善? |
| Table 2 | 无 pose supervision 的模型能否迁移到真实扫描? |
| Table 3 | 各正则项分别解决什么几何问题? |
| Figure 3 | 真实点云中的边界噪声是否集中在部件边界而非内部? |
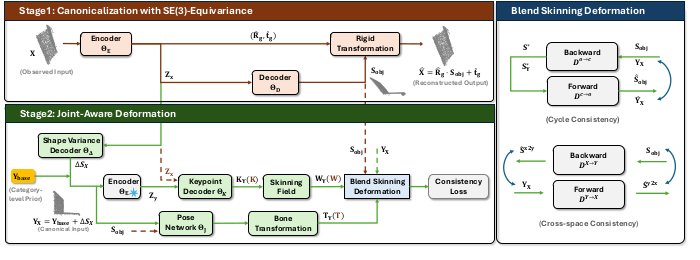 原论文图表中的相关区域:方法从任意姿态的观察中输出 canonical geometry、rigid part segmentation 和 joint parameters。来源:项目页 / CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 设物体由 P 个刚性部件组成,输入是一个带全局 pose 和 articulation state 的单次点云。
- 每个部件有一个 SE(3) transform,连接部件共享相应 joint pivot,旋转或平移受关节类型限制。
- 目标是得到共享 canonical frame、部件软分割、部件 pose 和 joint attributes,而非只输出整体 6D pose。
- 合成自监督设置无 GT labels、无 category-specific template、无多帧 motion cues;真实 Table 2 则提供 segmentation / joint 监督而不提供 pose 监督,不能将全部真实结果视为无标注训练。
4. 研究脉络
- PartMobility 依赖动态序列,UPPD 使用隐式场,EAP 学习 latent part transform,OP-Align 做单点云 canonical reconstruction。
- 这些方法或缺少显式 pivot / axis,或难以同时解耦 shape variation 与 articulation。
- SCAPO 采用 vector-neuron 的 SE(3)-equivariant encoder,把全局 pose 与 pose-invariant shape 分开,再以 blend-skinning 解释部件运动。
5. 研究动机
- 单帧观测无法直接观察关节运动,因此需要用形状、部件和运动学的一致性来约束解。
- 类别内实例差异大,固定 canonical template 会把形状差异误认为 articulation。
- 关节参数如果没有几何约束,pivot 容易漂离表面,axis 方向也会有符号歧义。
- 因此作者引入 learnable template + instance residual、cycle reconstruction 和一组结构正则项。
6. 方法详解
6.1 SE(3)-equivariant canonicalization
- vector-neuron encoder 对输入点云提取随旋转共同变换的特征。
- encoder-decoder 预测 global transform,将任意姿态实例映射到 canonical frame。
- cycle reconstruction 要求 canonical shape 经 inverse transform 后能重建原始观察,避免 canonicalization 只学到任意的低损失坐标系。
6.2 Canonical template 与 residual shape
- learnable canonical template 表达类别共享几何。
- instance-specific residual shape 保留某个实例的尺寸、厚度和局部差异。
- 该分解降低“形状差异被当成关节运动”的风险,也让新实例可以落在共享结构空间。
6.3 Joint-aware blend-skinning
- keypoint network 预测 part centroids / bone anchors。
- joint pose network 预测 pivot、axis 和 articulation state。
- skinning field 为每个点预测受各 bone 的软影响权重,形成从 canonical 到 observed 的可微 deformation。
- 逆向 cycle 让部件分割与 joint transform 互相约束:分割边界应随部件运动,部件内部保持一致。
6.4 自监督正则
- shape variance regularization 避免 canonical template 吸收过多实例差异。
- joint direction alignment 约束 axis 与局部几何的主方向。
- joint-to-shape proximity 保证 pivot 靠近物体表面 / 关节结构。
- joint-to-boundary attraction 让 pivot 靠近合理的部件边界。
7. 实验分析
7.1 数据与指标
- 合成:HOI4D 与 Shape2Motion,五个 articulated categories。
- 真实:五类 RGB-D scans,无 mesh ground truth,点云由深度和实例 mask 融合得到。
- 指标:part segmentation IoU、joint direction error、joint pivot error、mean part rotation / translation error,以及 real benchmark 的 joint / part mAP。
7.2 主结果
- 合成数据平均 segmentation IoU 84.98%,joint direction error 3.89°、joint pivot error 0.075、part rotation error 5.78°、translation error 0.086。
- 相比 OP-Align 的 82.24 IoU、4.60 direction、0.104 pivot、6.73 rotation,SCAPO 在大多数结构指标上更好。
- 真实数据按原 Table 2 标注的 segmentation mIoU(75% / 50% 阈值)为 91.89% / 98.29%,mean joint mAP 为 62.51 / 89.59 / 95.91。原表 Ours 使用 segmentation / joint 监督但无 pose 监督,不能把这些结果当作完全无标注的真实域迁移。
7.3 消融
- 去掉 shape variance regularization 后 segmentation IoU 从 84.98 降至 80.15,joint direction error 从 3.89 增至 10.63,说明 template/residual 解耦很关键。
- 去掉 direction alignment 后 joint direction error 约升至 8.54,pivot 误差也上升。
- 去掉 joint-to-shape proximity 后 pivot error 增至 0.137,说明几何位置约束能防止关节漂移。
- 在 heavy occlusion 或 missing parts 下,结构证据不足仍会造成 joint 误估和 segmentation drift。
8. 批判性分析
- 优点:输出结构化、可解释,self-supervised setting 的监督假设很低。
- 局限:需要点云质量和类别内共享运动学;未知拓扑、软体和非刚性变形不在当前模型范围内。
- 歧义:单观测下多个 articulation state 可能产生相近可见表面,cycle loss 可能只能选出一个合理解。
- 真实部署:mask 错误、深度空洞和严重遮挡会同时伤害 canonicalization、部件分割和 joint prediction。
9. 对我的研究的启发
- canonicalization 可以作为 object pose 与 articulation pose 的共同底座。
- 对静态 6D pose,instance residual 也可以表达“类别共享结构 + 新物体局部差异”。
- 关节 pivot / axis 的几何正则值得迁移到可动家具、工具和机器人末端物体的 pose pipeline。
10. 待解决问题
- 如何从单次观测自动发现未知部件数和 articulation graph?
- 如何将多解 joint posterior 和对称性显式建模?
- 如何与 RGB 语义、触觉和主动操作闭环,改善不可见部件的推理?
11. 精读补充:SCAPO 的结构化自监督
11.1 输入、输出与自监督来源
SCAPO 从一个 articulated object 的 RGB-D / 3D observation 推断结构;合成自监督不需要类别模板、动作序列或 joint annotation,真实 Table 2 则使用 segmentation / joint 监督但无 pose 监督。SE(3)-equivariant vector-neuron autoencoder 先把全局 pose 因子化,映射到共享 canonical space;之后 joint-aware blend-skinning 从 canonical shape 生成 articulated observation。输出不止是一个整体 pose,还包括 canonical geometry、rigid-part segmentation、joint pivot、axis 和 articulation state。
11.2 数据划分
合成实验沿用 EAP,选取 HOI4D 与 Shape2Motion 的五类:laptop、safe、oven、washer、eyeglasses。真实实验使用另一组五类:basket、laptop、suitcase、drawer、scissors;真实 RGB-D scan 没有 mesh ground truth,因此更能检验 self-supervised 结构是否依赖精确 CAD。
11.3 精确主结果
| Synthetic mean | Segmentation IoU | Joint direction error | Pivot error | Part rotation | Part translation |
|---|
| SCAPO | 84.98% | 3.89° | 0.075 | 5.78° | 0.086 |
| OP-Align | 82.24% | 4.60° | 0.104 | 6.73° | 0.115 |
真实数据按原表 75% / 50% 阈值标注的 segmentation mIoU 为 91.89% / 98.29%,joint mAP 在 5°5cm、10°10cm、15°15cm 阈值下为 62.51 / 89.59 / 95.91;OP-Align 为 90.02% / 97.18% 和 61.37 / 87.72 / 92.73。换句话说,SCAPO 的真实数据优势不仅体现在最终 pose,也体现在 part segmentation 与 joint geometry 的联合输出。 这些真实结果来自带 segmentation / joint 监督而无 pose 监督的设置。
11.4 Ablation 的因果解释
| 去掉模块 | Seg. IoU | Joint direction | Pivot |
|---|
| 完整 SCAPO | 84.98 | 3.89° | 0.075 |
| 去掉 shape variance | 80.15 | 10.63° | 0.175 |
| 去掉 direction alignment | — | 8.54° | 0.086 |
| 去掉 joint proximity | — | — | 0.137 |
shape variance decoder 负责类别共享形状之外的 instance residual;去掉它会同时伤害分割和关节几何。direction alignment 主要压低轴方向误差,joint proximity 主要防止 pivot 漂移。这样的模块—指标对应关系比只报告总 mAP 更能解释方法为何有效。
11.5 作者声称与我的分析
| 作者声称 | 我的判断 |
|---|
| 单个 3D observation 足以恢复 canonical shape 与 articulation | 合成 / 真实结果支持,但前提是类别内存在共享结构和可观测关节证据。 |
| pose-invariant canonicalization 解决 shape 与 motion disentanglement | SE(3) 等变 encoder + cycle reconstruction 的设计有说服力;仍应测试未知 joint graph 与多解 articulation。 |
| self-supervision 降低标注成本 | 合成无标注设置支持这一点;真实扫描虽无 mesh GT,Table 2 仍使用 segmentation / joint 监督,RGB-D、mask 和类别数据也是先验。 |
12. 复现要点与扩展
记录 vector-neuron 的坐标变换、canonical frame 定义、blend-skinning 权重温度、cycle / cross-space consistency 权重和 joint keypoint 数量。对被遮挡的关节,建议报告 posterior 而非单一轴;对机器人,可把 SCAPO 的 pivot / axis 直接连接到抓取点和关节限位,形成从感知到可执行运动的结构化接口。
