Reading Notes
粗读 / 精读
已生成 src/paper-notes/sdfit-iccv2025/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:SDFit: 3D Object Pose and Shape by Fitting a Morphable SDF to a Single Image
1. 基本信息
- 年份 / 会议:2025 / ICCV;阅读模式:粗读。
- 任务:单 RGB 图像中联合恢复类别级 3D object pose 与 shape。
- 原文:ICCV Open Access;项目页:SDFit。
2. 一句话定位
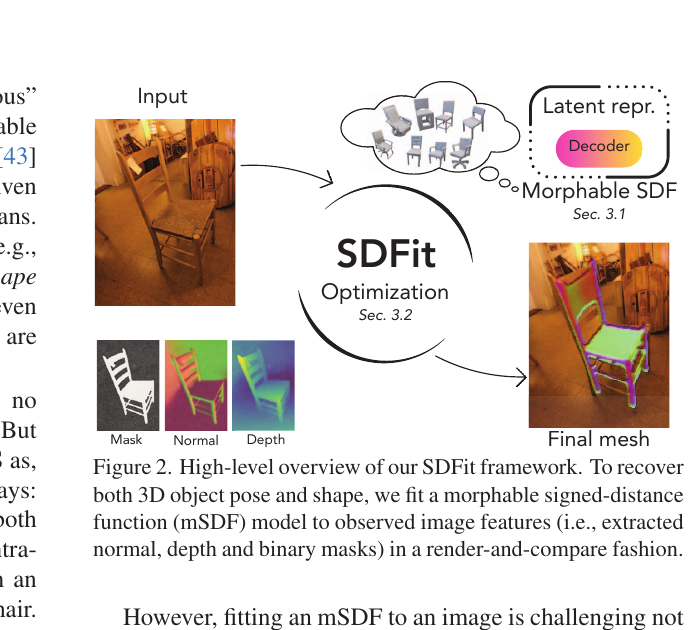
SDFit 用 learned morphable SDF 将 shape search 限制在有效流形内,再用 foundation features 初始化 2D–3D correspondences,并通过 render-and-compare 同时迭代 shape 与 pose。
2.1 论文图表导读
| 图表 | 看点 |
|---|---|
| Figure 2 | 单图输入、morphable SDF latent prior、可微拟合与最终 mesh / pose 的闭环。 |
3. 方法概览
- 先通过 foundation model 的跨模态检索从 shape database 找初始 mSDF latent;再借助 image/mSDF feature 对应初始化 pose。
- 以 image mask、normal 与 depth-like feature 的 render-and-compare 损失迭代更新 shape latent、pose 与尺度。
- DIT mSDF 是类别特定但可变形的 shape prior;因此它不需要为每张 in-the-wild 图像重训,却也不是没有类别模型的开放世界 pose。
4. 实验概览
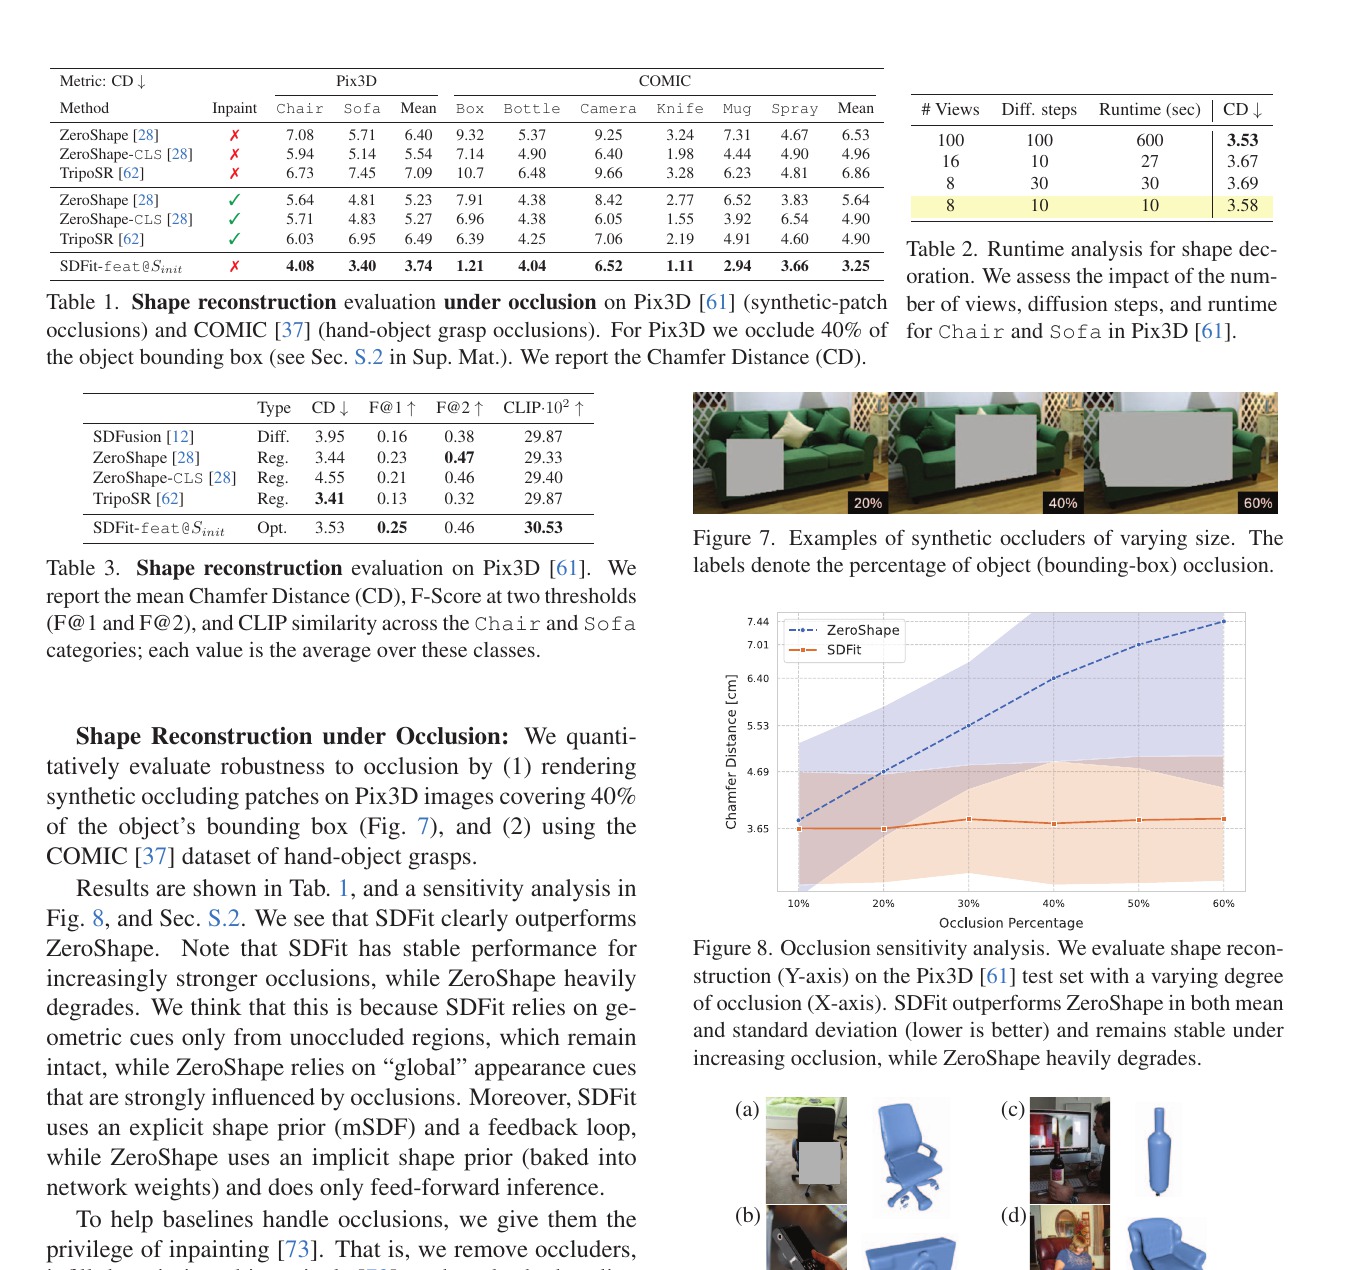
- 数据集:Pix3D、Pascal3D+、COMIC;重点比较遮挡、常见/非常见姿态与图像对齐。
- 作者声称:无明显遮挡时与 feed-forward baseline 相当,遮挡和非常见姿态下更稳,并能在自然图像上免重训工作。
- 我的分析:这是一条“显式优化回归到视觉”的路线;质量和速度高度依赖 shape prior、初始化和 test-time optimization,不应按实时 6D pose 系统理解。
5. 优缺点与启发
- 优点:shape 和 pose 联合 refinement、对拓扑变化保留一定弹性、反馈回路可解释。
- 风险:需要 category mSDF、内参/视觉 cue 和分钟级优化预算;复杂杂乱多物体场景尚非主设定。
- 启发:对于遮挡和 OOD image,显式 shape manifold 比单次 feed-forward 回归更值得保留。