论文精读笔记:Confronting Ambiguity via Score Diffusion on SE(3)
1. 核心判断
单 RGB 的 6DoF pose 并不总是函数 I ↦ ( R , t ) I\mapsto(R,t) I ↦ ( R , t )
在 mode 之间取平均;
依赖人工 symmetry annotations;
忽略由当前可见性动态产生的歧义。
本文直接学习:
X ∼ p ( X ∣ I ) , X = ( R , T ) ∈ S E ( 3 ) . X\sim p(X\mid I),\qquad X=(R,T)\in SE(3). X ∼ p ( X ∣ I ) , X = ( R , T ) ∈ S E ( 3 ) . 与只在 S O ( 3 ) SO(3) S O ( 3 )
2. 为什么必须区分 S E ( 3 ) SE(3) S E ( 3 ) R 3 S O ( 3 ) \mathbb R^3SO(3) R 3 S O ( 3 )
两种参数化都含 R , t R,t R , t
独立乘积:
( R 2 , T 2 ) ( R 1 , T 1 ) = ( R 2 R 1 , T 2 + T 1 ) . (R_2,T_2)(R_1,T_1)
=(R_2R_1,T_2+T_1). ( R 2 , T 2 ) ( R 1 , T 1 ) = ( R 2 R 1 , T 2 + T 1 ) . 刚体运动群:
( R 2 , T 2 ) ( R 1 , T 1 ) = ( R 2 R 1 , T 2 + R 2 T 1 ) . (R_2,T_2)(R_1,T_1)
=(R_2R_1,T_2+R_2T_1). ( R 2 , T 2 ) ( R 1 , T 1 ) = ( R 2 R 1 , T 2 + R 2 T 1 ) . S E ( 3 ) SE(3) S E ( 3 ) R 3 S O ( 3 ) \mathbb R^3SO(3) R 3 S O ( 3 ) S E ( 3 ) SE(3) S E ( 3 )
SYMSOL-T 是专门为此建立的 synthetic testbed:在 SYMSOL 五个对称形状上增加随机 translation,使 viewpoint ambiguity 同时涉及 R , t R,t R , t
3. Lie-group score matching
对群 G G G X X X z z z
X ~ = X Exp ( z ) , z ∼ N ( 0 , Σ ) . \tilde X=X\operatorname{Exp}(z),
\qquad z\sim\mathcal N(0,\Sigma). X ~ = X Exp ( z ) , z ∼ N ( 0 , Σ ) . 网络学习扰动分布的 Stein score:
s θ ( X ~ , σ ) ≈ ∇ X ~ log p σ ( X ~ ∣ X ) . s_\theta(\tilde X,\sigma)
\approx\nabla_{\tilde X}\log p_\sigma(\tilde X\mid X). s θ ( X ~ , σ ) ≈ ∇ X ~ log p σ ( X ~ ∣ X ) . 反向采样用 Geodesic Random Walk:
X ~ i + 1 = X ~ i Exp ( ϵ i s θ ( X ~ i , σ i ) + 2 ϵ i z i ) . \tilde X_{i+1}
=\tilde X_i\operatorname{Exp}
\left(
\epsilon_i s_\theta(\tilde X_i,\sigma_i)
+\sqrt{2\epsilon_i}z_i
\right). X ~ i + 1 = X ~ i Exp ( ϵ i s θ ( X ~ i , σ i ) + 2 ϵ i z i ) . 所有更新都通过 Exp / Log 留在群上,而不是把 4×4 transform 当普通欧氏向量相加。
4. Surrogate Stein score
在 S O ( 3 ) SO(3) S O ( 3 )
J l ( z ) = J r ⊤ ( z ) , J l − 1 ( z ) = J r − ⊤ ( z ) , J_l(z)=J_r^\top(z),\qquad
J_l^{-1}(z)=J_r^{-\top}(z), J l ( z ) = J r ⊤ ( z ) , J l − 1 ( z ) = J r − ⊤ ( z ) , 且 J l ( z ) z = z J_l(z)z=z J l ( z ) z = z
∇ X ~ log p σ ( X ~ ∣ X ) = − 1 σ 2 z . \nabla_{\tilde X}\log p_\sigma(\tilde X\mid X)
=-\frac{1}{\sigma^2}z. ∇ X ~ log p σ ( X ~ ∣ X ) = − σ 2 1 z . R 3 S O ( 3 ) \mathbb R^3SO(3) R 3 S O ( 3 ) S E ( 3 ) SE(3) S E ( 3 ) Q ( ρ , ϕ ) Q(\rho,\phi) Q ( ρ , ϕ ) X ~ \tilde X X ~ X X X
作者不计算昂贵的 Jacobian / autodiff score,而把:
s ~ X ( X ~ , σ ) = − 1 σ 2 z \tilde s_X(\tilde X,\sigma)
=-\frac{1}{\sigma^2}z s ~ X ( X ~ , σ ) = − σ 2 1 z 作为 surrogate target。单个大步在曲率空间会有偏差,但将一步切成多个小 sub-steps 后,局部近似逐渐接近正确逆变换。这是一个带工程动机的近似,不是“SE(3) 真 score 恰好等于欧氏 Gaussian score”。
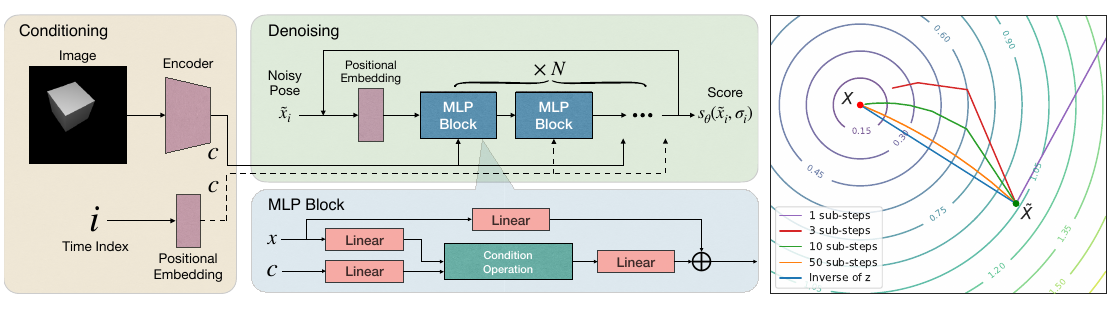
原论文 Figure 2 的图形区域:图像条件与时间条件在 MLP blocks 中融合;右侧以 SE(2) 示意 surrogate direction 经更多子步积分后逼近真实 inverse。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
5. 条件网络
网络拆成:
conditioning:ResNet 对 RGB 编码一次,得到 c c c
denoising:pose / noise level positional embedding + 多个 MLP blocks;
output:Lie algebra vector score。
图像特征不在每个 step 重算,是 20–250 FPS 的基础。作者发现普通 scale-bias conditioning 在周期 S O ( 3 ) SO(3) S O ( 3 )
f i ( x , c ) = ∑ j W i j [ A j ( c ) cos ( π x j ) + B j ( c ) sin ( π x j ) ] . f_i(x,c)=
\sum_j W_{ij}
\left[
A_j(c)\cos(\pi x_j)
+B_j(c)\sin(\pi x_j)
\right]. f i ( x , c ) = j ∑ W ij [ A j ( c ) cos ( π x j ) + B j ( c ) sin ( π x j ) ] . 周期函数及其导数仍是周期的,这一 inductive bias 更适合 rotation manifold。
6. SYMSOL 与 SYMSOL-T
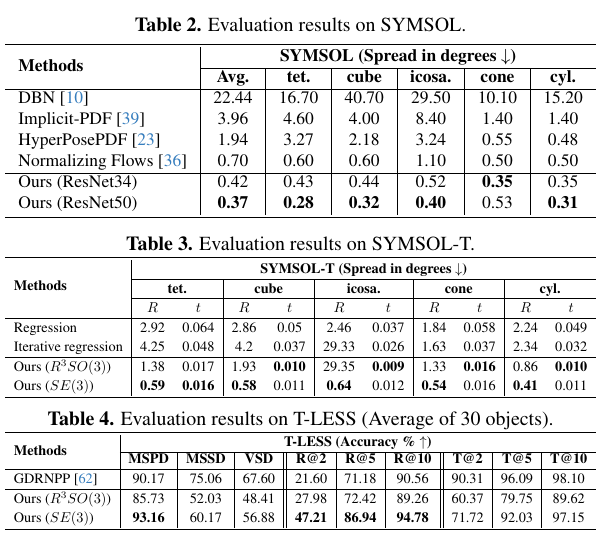
原论文 Tables 2–4。SYMSOL 衡量 rotation density;SYMSOL-T 同时报告 rotation spread 与 translation distance;T-LESS 则报告 symmetry-aware BOP recalls 和阈值准确率。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
SYMSOL 五形状包括 tetrahedron、cube、icosahedron、cone、cylinder,前 3 个离散对称,后 2 个连续对称:
方法 平均 rotation spread Implicit-PDF 3.96° HyperPosePDF 1.94° Normalizing Flows 0.70° 本文 ResNet34 0.42° 本文 ResNet50 0.37°
在 SYMSOL-T,最值得看的是 icosahedron:
R 3 S O ( 3 ) \mathbb R^3SO(3) R 3 S O ( 3 ) S E ( 3 ) SE(3) S E ( 3 ) 0.64° 。
独立扩散没有正确捕获 perspective-induced coupling,联合群模型则恢复多模态 rotation。另一方面,独立模型部分 translation 数字更低,因为它避免 R , t R,t R , t
7. 多模态可视化
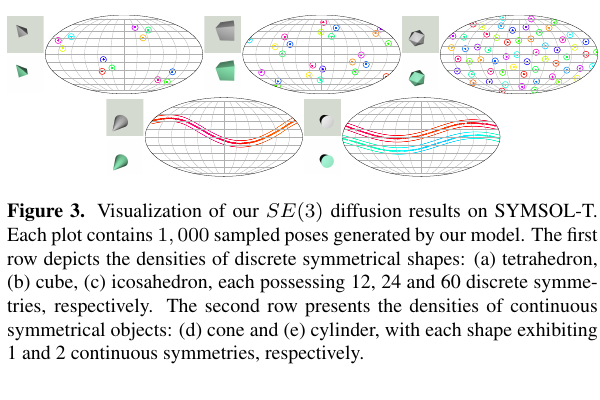
原论文 Figure 3:每图 1,000 个 samples。tetrahedron、cube、icosahedron 分别形成 12、24、60 个离散 modes;cone 与 cylinder 沿一条或两条连续 symmetry orbit 分布。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
这张图说明模型不是简单加 Gaussian uncertainty:离散对称会形成分离 modes,连续对称会形成 manifold 上的环带。对 pose 系统而言,这比输出一个 covariance 更符合真实拓扑。
8. T-LESS:可见性诱导的动态歧义
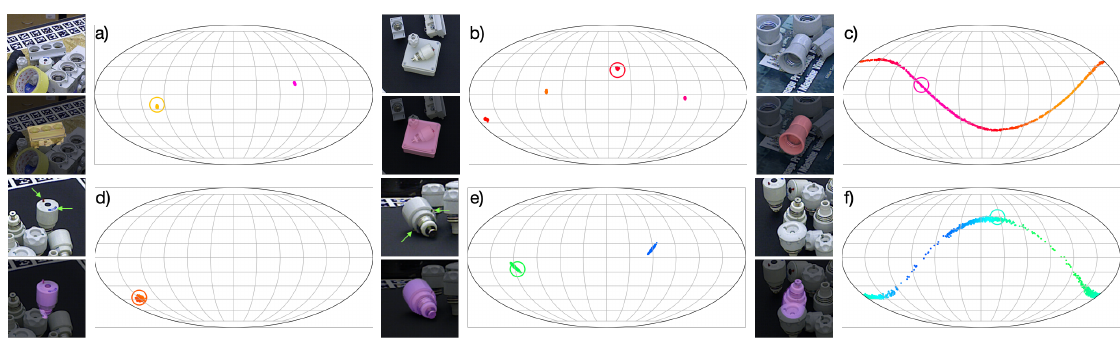
原论文 Figure 4 的图形区域:上排展示离散 / 连续对称对象;下排同一个 object 4 随顶部特征、底部孔洞是否可见,posterior 从单峰变成双峰或连续 mode。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
object 4 的人工标注是一个连续 symmetry,但图像可见性决定实际 posterior:
顶部 feature 可见:无歧义,单一 mode;
顶部遮挡、底部两个孔可见:两个离散 modes;
孔也被遮挡:近似连续 symmetry。
固定 object-level symmetry annotation 无法表达这种 image-conditioned change;生成式 posterior 是本文最强的概念贡献。
定量:
方法 MSPD MSSD VSD R@2 R@5 R@10 T@2 GDRNPP 90.17 75.06 67.60 21.60 71.18 90.56 90.31 R 3 S O ( 3 ) \mathbb R^3SO(3) R 3 S O ( 3 ) 85.73 52.03 48.41 27.98 72.42 89.26 60.37 S E ( 3 ) SE(3) S E ( 3 ) 93.16 60.17 56.88 47.21 86.94 94.78 71.72
SE(3) rotation 明显更好,translation / surface metric 则低于 GDRNPP。作者解释 GDRNPP 用 3D model geometry 改善 depth;本文不使用 CAD。
9. 速度与 step trade-off
T-LESS、ResNet34、224×224、RTX 2080 Ti:
steps FPS MSPD MSSD VSD 100 20 93.16 60.17 56.88 50 38 93.00 59.96 56.64 10 161 92.79 60.35 57.08 5 250 92.40 59.30 56.15
10 steps 几乎不损精度,说明 surrogate score 与网络条件足以做大幅度 step reduction。不过“每 sample FPS”不等于“每图完整 posterior FPS”:若需要 1,000 samples 估计完整分布,总成本仍会线性增长。
10. 实验协议边界
T-LESS 使用:
30 个训练中已知对象;
GT bounding boxes;
visible-part segmentation masks;
单模型跨 30 objects;
hard image augmentation 与 Dynamic Zoom-In。
因此表中没有检测、分割与新对象泛化误差。论文说“不使用 3D model / symmetry annotation”是成立的,但前端条件比实际系统更理想。
11. 局限与复现检查
T-LESS translation 较弱,缺少 CAD / depth geometry 仍是核心瓶颈。
训练必须有 GT pose;方法不是 self-supervised。
未展示 calibration、NLL、coverage 等 posterior quality 指标,主榜更多衡量 sample accuracy。
真实协议用 GT box / mask,部署需增加前端并检验 distribution 是否对分割噪声稳定。
samples 数、聚合成最终单 pose 的策略、随机种子会影响 reported accuracy。
surrogate score 是近似;大步数减少虽经验有效,但没有保证对所有群上分布成立。
正文没有官方代码链接,Lie-group convention、Exp / Log、左乘右乘和单位尺度都需谨慎复现。
12. 最终评价
这篇论文把“对称性”从静态物体属性提升为 图像条件下的 posterior topology 。T-LESS object 4 随可见部件改变 mode structure 的例子,比单一 AR 数字更有说服力。
方法在 rotation 与 ambiguity 上很强,在 translation、真实前端和 posterior calibration 上仍不完整。它最适合作为 ambiguity-aware pose estimation 的方法论基线:若后续系统需要可靠抓取,可把多峰 samples 交给可见性验证、碰撞检查或任务代价,而不是过早压成一个姿态。