论文精读笔记:SE(3)-PoseFlow
1. 核心判断
论文:arXiv 2511.01501
项目页:SE(3)-PoseFlow
核心问题:对称、遮挡和 partial observation 会让多个 6D poses 同时符合 RGB-D;deterministic regressor 输出一个 pose 时往往过度自信,也无法把歧义交给下游机器人决策。
核心回答:在 S E ( 3 ) = S O ( 3 ) × R 3 SE(3)=SO(3)\times\mathbb R^3 S E ( 3 ) = S O ( 3 ) × R 3
我的判断:这是“分布先于点估计”的完整系统展示,最强证据来自 active perception 和 grasping;但 samples 是否经过概率校准、不同 mode 的质量如何评估,仍未由标准 uncertainty metrics 回答。
2. 输入与前端
输入是 RGB-D,但方法假设前级 detector / segmentation 已给出对象区域。论文在不同场景使用 Mask R-CNN、CNOS 或 SAM2 mask tracking:
根据 mask 裁剪 object-centric RGB;
从 depth 反投影 partial point cloud;
点云减去均值,以降低 camera-frame absolute translation 对训练的影响;
RGB 进入冻结 DINOv2 ViT;
point cloud 进入从头训练的 PointNet++;
两路投影到 256D feature space。
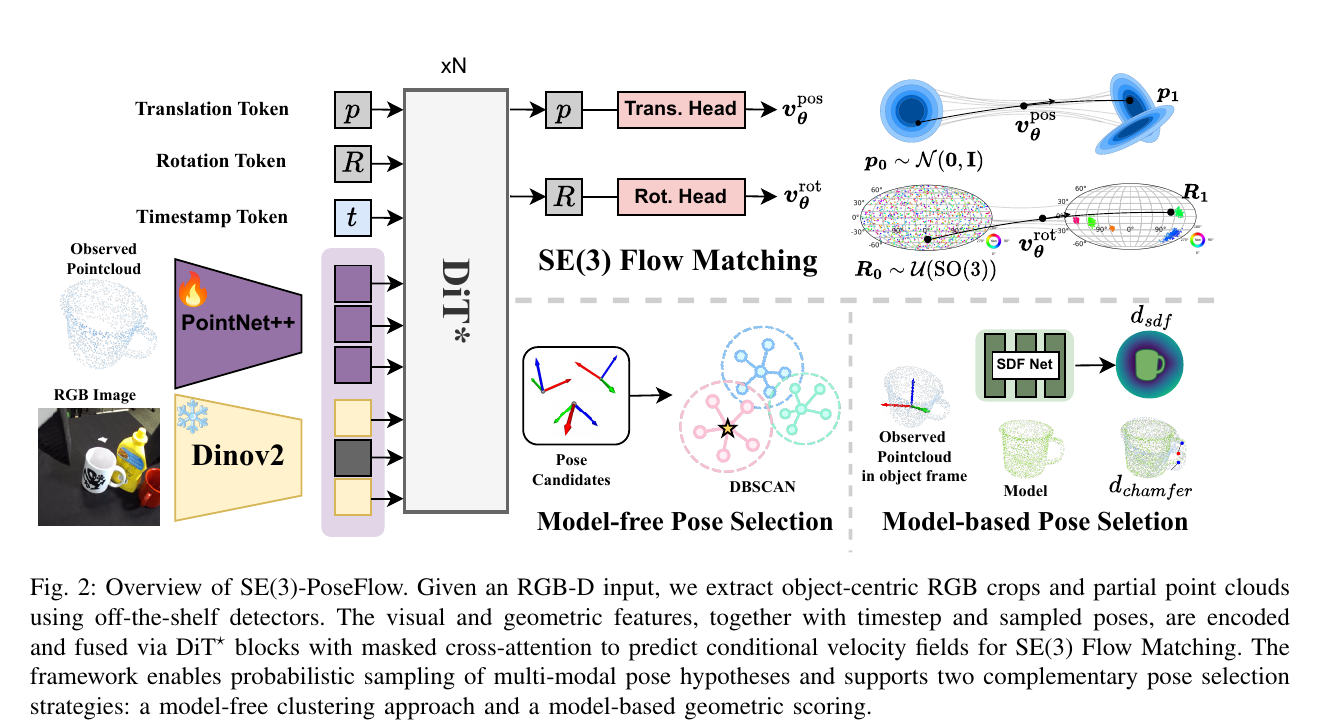
平移 pose token、旋转 pose token 和 Fourier time token 进入 DiT*。与原始 DiT 的 self-attention 不同,作者使用 masked cross-attention:pose tokens 查询视觉 / 几何 tokens,segmentation-derived binary mask 排除背景;复杂度相对全 token self-attention 从 O ( n 2 ) O(n^2) O ( n 2 ) O ( n ) O(n) O ( n )
原论文 Figure 2:translation / rotation 分离成 pose tokens 和输出 heads;下方分别展示 DBSCAN model-free selection 与 SDF / Chamfer model-based selection。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
3. S E ( 3 ) SE(3) S E ( 3 )
目标是条件分布 p ( R , p ∣ O , I ) p(R,p\mid O,I) p ( R , p ∣ O , I ) R ∈ S O ( 3 ) R\in SO(3) R ∈ S O ( 3 ) p ∈ R 3 p\in\mathbb R^3 p ∈ R 3 O O O I I I
训练时从随机初始 pose ( R 0 , p 0 ) (R_0,p_0) ( R 0 , p 0 ) ( R 1 , p 1 ) (R_1,p_1) ( R 1 , p 1 )
p t = ( 1 − t ) p 0 + t p 1 , R t = R 0 exp ( t log ( R 0 ⊤ R 1 ) ) . p_t=(1-t)p_0+tp_1,
\qquad
R_t=R_0\exp\!\left(t\log(R_0^\top R_1)\right). p t = ( 1 − t ) p 0 + t p 1 , R t = R 0 exp ( t log ( R 0 ⊤ R 1 ) ) . 平移沿 Euclidean straight line,旋转沿 S O ( 3 ) SO(3) S O ( 3 )
p ˙ t = p 1 − p t 1 − t , r ˙ t = 1 1 − t log ( R t ⊤ R 1 ) . \dot p_t=\frac{p_1-p_t}{1-t},\qquad
\dot r_t=\frac{1}{1-t}\log(R_t^\top R_1). p ˙ t = 1 − t p 1 − p t , r ˙ t = 1 − t 1 log ( R t ⊤ R 1 ) . 网络两头分别预测 v θ p o s v_\theta^{pos} v θ p os v θ r o t v_\theta^{rot} v θ r o t
L F M = E [ λ ℓ p o s + ℓ r o t ] , \mathcal L_{\rm FM}
=\mathbb E[\lambda\ell_{pos}+\ell_{rot}], L FM = E [ λ ℓ p os + ℓ r o t ] , 实验设 λ = 10 \lambda=10 λ = 10
与 diffusion 相比,rectified flow 的吸引力是路径和 target velocity 简单,少数 ODE steps 已有不错结果。它不是把 rotation 当欧氏 3-vector 加 Gaussian noise,而是显式使用 Lie algebra log / exp 保持 manifold geometry。
4. 从样本到代表 pose
推断从随机 samples 积分到 t = 1 t=1 t = 1 { T i } \{T_i\} { T i }
4.1 Model-free selection
DBSCAN 距离联合 rotation geodesic angle 和 translation:
d ( T 1 , T 2 ) = ( θ ( R 1 , R 2 ) ϵ R ) 2 + ( ∥ t 1 − t 2 ∥ ϵ t ) 2 . d(T_1,T_2)=
\sqrt{\left(\frac{\theta(R_1,R_2)}{\epsilon_R}\right)^2+
\left(\frac{\|t_1-t_2\|}{\epsilon_t}\right)^2}. d ( T 1 , T 2 ) = ( ϵ R θ ( R 1 , R 2 ) ) 2 + ( ϵ t ∥ t 1 − t 2 ∥ ) 2 . 取最大 cluster,并在 s e ( 3 ) \mathfrak{se}(3) se ( 3 )
4.2 Chamfer selection
将 object model M M M P P P
4.3 Neural SDF selection
对 normalized object-frame observed points 计算 learned SDF residual。SDF 提供连续、全局 surface feedback,小幅 misalignment 下比离散 Chamfer 更平滑;但每个对象需要高质量 mesh / dense points 训练,监督稀疏时会 collapse。该模块让 YCB-V / LM-O 获益,却削弱了“无需对象模型”的通用性。
论文正文一处写 model-based retain top 20%,实验段统一比较时写 top 40%;整理结果时应以具体表格协议为准,不把二者混为同一固定超参数。
5. Tracking
pose estimation 从随机 S E ( 3 ) SE(3) S E ( 3 )
这说明 35.2 FPS 的 one-step tracking 不是 detector-to-pose 的全局恢复速度,而是 near-correct initialization 下的局部 refinement。对遮挡后重定位、长时漂移和 mode switching,论文尚未展示完整序列指标。
6. 基准设置
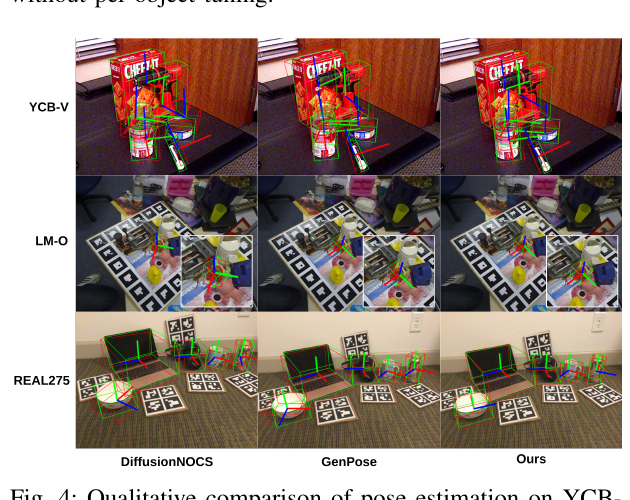
REAL275 :NOCS real test,6 类对象、较大类内变化,category-level;YCB-Video :92 段视频、21 个 YCB objects,cluttered instance-level;LM-O :8 个弱纹理对象、重遮挡 instance-level。
指标是 α ∘ β \alpha^\circ\beta α ∘ β
原论文 Figure 4:YCB-V、LM-O 与 REAL275 的定性结果;本站只截取论文结果图与原 caption,不使用首页截图。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
7. 基准定量结果
7.1 REAL275
方法 5°2 cm 5°5 cm 10°2 cm 10°5 cm DiffusionNOCS – 35.0 66.6 77.1 GenPose 52.1 60.9 72.4 84.0 SE(3)-PoseFlow 48.8 56.3 76.3 89.1
论文在宽 rotation threshold 下更好,但最严格两项低于 GenPose。作者归因于 REAL275 缺少 mesh / dense cloud,只能用 noisy partial points 做 Chamfer re-ranking;GenPose 的 learned energy network 更贴合该数据集。不能笼统写“所有阈值 SOTA”。
7.2 YCB-V 与 LM-O
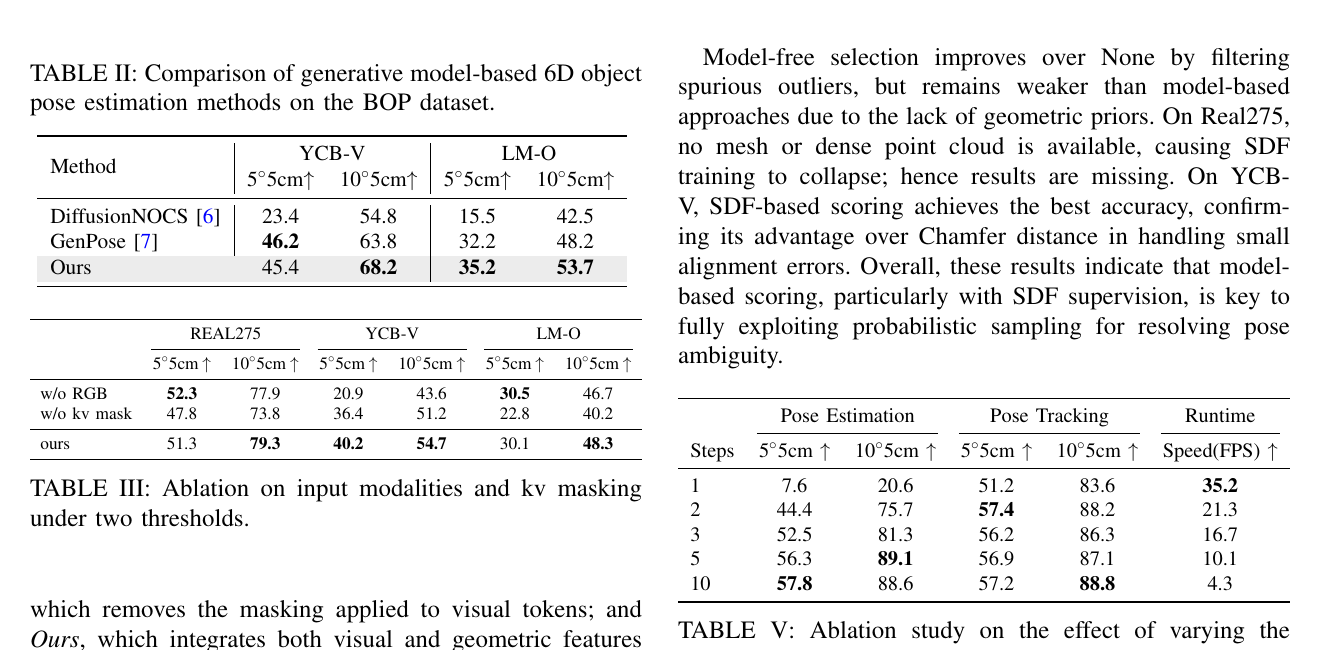
原论文 Tables II、III、V:YCB-V / LM-O 比较、RGB 与 mask 消融,以及 ODE steps 对精度和速度的影响。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
YCB-V 的 5°5 cm / 10°5 cm 为 45.4 / 68.2,LM-O 为 35.2 / 53.7。YCB-V 严格项略低于 GenPose 46.2,但 10°5 cm 高 4.4;LM-O 两项均最高。这里 SDF scoring 的强几何 prior 是关键,不能把提升全部归因于 flow matching。
8. 消融解读
8.1 RGB、point cloud 与 mask
不做 pose selection 时:
REAL275:point-cloud-only 5°5 cm 52.3,完整方法 51.3;对象多对称 / 纹理弱,RGB 未提供明显收益。
YCB-V:point-cloud-only 20.9,完整方法 40.2,纹理 cues 很关键。
去掉 key/value mask 在三数据集均下降,说明 mask 主要抑制 background tokens。
因此不是“RGB-D 总比 depth 好”,而是 RGB 收益高度依赖 texture distribution。
8.2 Pose selection
REAL275 5°5 / 10°5:
none 51.3 / 79.3;
model-free 52.5 / 88.2;
Chamfer 56.3 / 89.1。
YCB-V:
none 40.2 / 54.7;
model-free 42.5 / 65.6;
Chamfer 43.1 / 67.5;
SDF 45.4 / 68.2。
样本本身给出多模态表达,但 leaderboard 上的单 pose 精度很大一部分来自 re-ranking。
8.3 推断 steps
REAL275 pose estimation 1 / 2 / 3 / 5 / 10 steps 的 10°5 cm 是 20.6 / 75.7 / 81.3 / 89.1 / 88.6,速度 35.2 / 21.3 / 16.7 / 10.1 / 4.3 FPS。5 steps 后精度基本饱和。
tracking 的一步 10°5 cm 已有 83.6,10 步为 88.8;near-correct start 使速度场只需局部修正。
9. 主动感知
Franka Panda 腕部 ZED Mini 在 object-centric sphere 上采样 viewpoints。对每个 viewpoint 预测 pose hypotheses,rotation 在 S O ( 3 ) SO(3) S O ( 3 )
这是 sampling approximation,不是解析 next-best-view。论文展示机器人绕物体移动以暴露歧义方向,但正文没有给像抓取一样清晰的大样本成功率表。因此可以说“展示可用性”,不宜宣称主动视角策略已全面优于强 baseline。
10. 多假设抓取
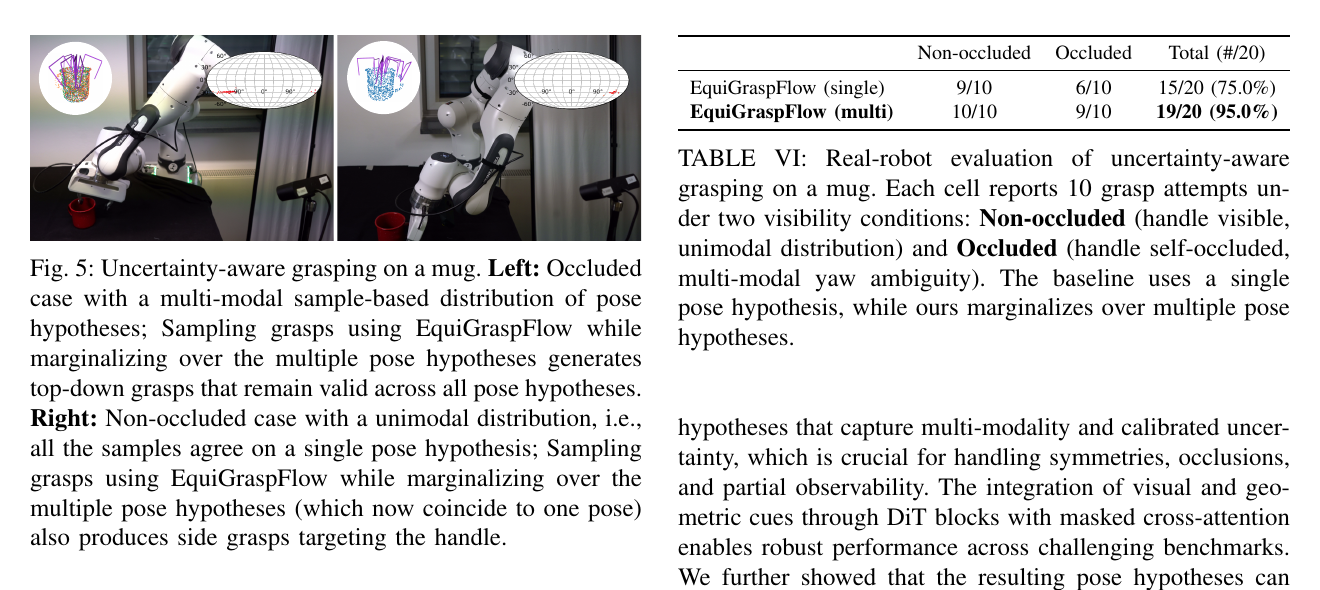
EquiGraspFlow 对每个 object pose hypothesis 生成 grasp velocity field;作者不先选一个 pose,而是在 velocity level 对 K K K
v ˉ ( M , t ) ≈ 1 K ∑ k = 1 K v θ ( M ~ k , t ) . \bar v(M,t)\approx\frac1K\sum_{k=1}^{K}v_\theta(\tilde M_k,t). v ˉ ( M , t ) ≈ K 1 k = 1 ∑ K v θ ( M ~ k , t ) . 如果 mug handle 可见,pose distribution 单峰,仍会产生 handle side grasps;若 handle 自遮挡,yaw 多模态,与不确定朝向绑定的 side-grasp modes 被平均抑制,top grasps 在各种 plausible yaw 下都有效。
原论文 Figure 5 与 Table VI:单 hypothesis 为 15/20,多 hypothesis marginalization 为 19/20;遮挡条件从 6/10 提升到 9/10。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
实验只用同一个 mug,每条件 10 次。结果有说服力但规模有限;还不能说明对多对象、clutter collision、不同 grasp generators 都稳定。
11. 局限与未回答问题
校准缺失 :未报告 NLL、ECE、coverage 或 mode recall,sample covariance 是否等于真实误差概率未知。前级依赖 :detector / mask / depth error 会系统性影响 distribution。几何 re-ranking 依赖 :最佳 instance-level 结果依赖 mesh 或 dense cloud 与 SDF training。类别泛化不统一 :作者明确承认并非所有 categories 都能 seamless generalize。跨模态 gap :image tokens 与 point-cloud tokens 难形成统一表示,论文建议 point map。样本使用缺乏 Bayesian 原则 :samples 如何加权、更新和做 temporal posterior 尚未解决。tracking 评测有限 :上一帧初始化,不含长序列重定位和 multi-modal transition。多对象未覆盖 :联合 pose distributions 和跨对象相关性留待未来。代码尚未公开 :截至本站整理时项目页标注 Code Coming Soon。
12. 复现清单
锁定 DINOv2 variant、PointNet++ architecture、256D projection 与 DiT* depth。
记录 point-cloud centering、translation units、λ = 10 \lambda=10 λ = 10 S O ( 3 ) SO(3) S O ( 3 )
区分 50 hypotheses、ODE steps、top-k retention 和最终 Karcher mean。
为 Chamfer / SDF 分别报告 model availability 和 training data。
重做 uncertainty calibration,而不只画 Mollweide samples。
评测 mask perturbation、depth dropout、symmetry mode recall、relocalization。
抓取实验扩展到多对象、多抓取类型并报告 collision / planning failures。
13. 方法启发
SE(3)-PoseFlow 的关键启示不是简单用 flow 替换 diffusion,而是让“多解”成为下游输入。位姿估计长期习惯在对称性处理后给一个 canonical pose;这篇工作说明,在机器人操作里保留所有 plausible poses 有时比更激进地选出一个数字更安全。下一步真正值得推进的是 calibrated S E ( 3 ) SE(3) S E ( 3 )