论文精读笔记:Shape-Biased Texture Agnostic Representations for Improved Textureless and Metallic Object Detection and 6D Pose Estimation
1. 基本信息
简称 :Randomized Texturing / Shape Bias作者 :Peter Hönig、Stefan Thalhammer、Jean-Baptiste Weibel、Matthias Hirschmanner、Markus Vincze机构 :TU Wien、UAS Technikum Vienna会议 :WACV 2025正式论文页 :CVF Open Access 代码 :randomized_texturing 阅读模式 :精读
2. 先给结论
论文把无纹理 / 金属对象的 synthetic-to-real 问题解释为一种训练捷径:如果同一 CAD surface 在合成数据里总呈现固定纹理或低频纯色,CNN 可以依赖 appearance correlation,而不必充分学习轮廓、曲面投影、遮挡和阴影。作者不改模型结构,只在 BlenderProc PBR rendering 中把对象表面的均匀随机颜色换成随机自然纹理 UV mapping,用 1,226 种互不一致的 appearance 干预破坏这条捷径。
从实验看,这个解释得到的是有边界的支持 ,不是“纹理不重要”的普遍证明:
T-LESS 上,完整 shape-biased detector + pose pipeline 将 GDR-Net 的 BOP AR 从 56.29 提至 58.32,Pix2Pose 从 46.68 提至 50.13;
ITODD 上分别从 10.70 到 11.10、从 12.90 到 15.30,但绝对精度仍很低;
Gaussian noise、shot noise 和 brightness change 下改善明显,motion / Gaussian blur 下几乎无改善,符合“减少 appearance shortcut、但不能恢复丢失几何细节”的机制;
detector 与 pose estimator 之间存在强交互:Pix2Pose 在 T-LESS 上单独改 pose training 几乎没变,必须连 YOLOx 一起 shape-bias 才出现 3.45 AR 的总提升;
准确 CAD 的作用远大于 texture intervention:Pix2Pose 的 CAD + shape bias 为 62.95 AR,reconstructed mesh + shape bias 只有 46.57;
部分旧检测器或增强配置会退化,所以它不是无需调参的 universal augmentation;
论文只覆盖 CNN、实例级逐对象训练、T-LESS / ITODD,不能外推为 ViT、diffusion feature、类别级或未见物体 pose 的既定结论。
这篇论文最值得借鉴的是一种实验思路:把材质分布视为可干预变量,把 detector、pose estimator、image corruption、online augmentation 与 geometry prior 分开控制。
2.1 关键图表与证据层级
证据 控制变量 能支持的结论 不能支持的结论 Figure 2 只替换对象颜色 / 纹理生成方式 方法容易接入标准 BOP PBR 流程 网络内部一定形成显式 3D shape representation Table 3 T-LESS classification、同为 ResNet50 UV mapping 比本文复现的 AdaIN style transfer 更有效 对所有 style-transfer 方法都占优 Table 4 两数据集、两 pose models、YOLOx detections shape bias 在所测 6D pose 配置中持平或提升 对所有 detector / pose architecture 普遍提升 Figure 6 T-LESS、GT detections、GDR-Net 噪声和亮度鲁棒性改善,模糊不改善 对检测误差或全部 real-world corruption 同样有效 Figure 7 Pix2Pose / YOLOx、T-LESS online augmentation 与 shape bias 有超参数交互 存在一个跨模型通用的增强强度 Table 6 Pix2Pose、T-LESS、GT detections appearance randomization 不能替代准确 geometry reconstructed mesh 一定不值得使用
3. 任务定义与术语辨析
3.1 本文的 pose 是什么
论文把 instance-level 6D object pose 写成:
T C O = [ R ∣ t ] , \mathbf{T}_{CO} = [\mathbf{R}\mid\mathbf{t}], T C O = [ R ∣ t ] , 其中 R ∈ S O ( 3 ) \mathbf{R}\in SO(3) R ∈ S O ( 3 ) t ∈ R 3 \mathbf{t}\in\mathbb{R}^3 t ∈ R 3 每个对象训练一个 estimator 。
因此它不属于:
category-level pose;
model-free / reference-free pose;
unseen-object generalization;
只估方向或相对旋转的任务。
主结果使用 BOP 的 VSD、MSSD、MSPD Average Recall,确实评价完整位姿,但系统仍需要 CAD 或 reconstructed mesh 来生成训练数据和定义 object geometry。
3.2 什么是 texture bias
这里的 texture bias 不是说输入纹理一定错误,而是指 CNN 在多个可用 cue 中倾向依赖局部 texture statistics。对 ImageNet classification,这类局部 cue 可能足以识别类别;对无纹理工业对象 pose,它容易成为脆弱捷径:
synthetic image 中对象颜色连续、稳定;
real image 中 appearance 被光源、曝光、镜面反射和阴影改变;
网络学到的局部外观与 pose-discriminative geometry 不一致;
合成到真实迁移失败。
3.3 什么是本文的 shape bias
作者通过训练分布设计让网络更偏向 shape-related evidence。这个“shape”包括投影轮廓、边界、遮挡结构、曲面纹理形变、真实 PBR 光照与阴影等图像线索;论文没有显式监督 3D coordinates,也没有证明 feature map 中存在可解码的完整三维形状。
所以更严格的表述是:
Randomized texturing 降低了固定对象 appearance 与 label / pose 的统计耦合,使跨纹理稳定的几何投影线索在风险最小化中更有价值。
“texture agnostic”同样应理解为相对鲁棒,而不是数学意义上的纹理不变性。
4. 从训练分布角度理解方法
设对象 mesh 为 M M M o o o p p p z z z a a a
I = R ( M o , p , z , a ) . I = \mathcal{R}(M_o, p, z, a). I = R ( M o , p , z , a ) . 传统 texture-biased baseline 对无纹理对象从均匀 RGB 颜色采样:
a = ( r , g , b ) , r , g , b ∼ U ( 0.1 , 0.9 ) . a = (r,g,b), \qquad r,g,b\sim\mathcal{U}(0.1,0.9). a = ( r , g , b ) , r , g , b ∼ U ( 0.1 , 0.9 ) . 尽管颜色变化了,每张对象内部仍是大面积低频、连续材质;network 可能学到与 synthetic pipeline 特有的 surface statistics。
本文建立纹理集合:
T = { T 1 , T 2 , … , T n } , n = 1226 , \mathcal{T}=\{T_1,T_2,\ldots,T_n\}, \qquad n=1226, T = { T 1 , T 2 , … , T n } , n = 1226 , 并对每次渲染均匀采样:
T i ∼ U ( T ) , a = UVMap ( M o , T i ) . T_i\sim\mathcal{U}(\mathcal{T}), \qquad a=\operatorname{UVMap}(M_o,T_i). T i ∼ U ( T ) , a = UVMap ( M o , T i ) . 训练目标本身不变:
min θ E o , p , z , T i [ L ( f θ ( R ( M o , p , z , T i ) ) , y ( o , p ) ) ] . \min_\theta\;\mathbb{E}_{o,p,z,T_i}
\left[\mathcal{L}\big(f_\theta(\mathcal{R}(M_o,p,z,T_i)),y(o,p)\big)\right]. θ min E o , p , z , T i [ L ( f θ ( R ( M o , p , z , T i )) , y ( o , p ) ) ] . 当同一 o , p o,p o , p T i T_i T i T i T_i T i
这个解释接近 appearance intervention,但要注意并非严格因果实验:随机纹理同时改变局部频谱、边缘密度、颜色分布与 PBR interaction,论文没有逐一拆分这些成分。
5. 渲染流程与实现细节
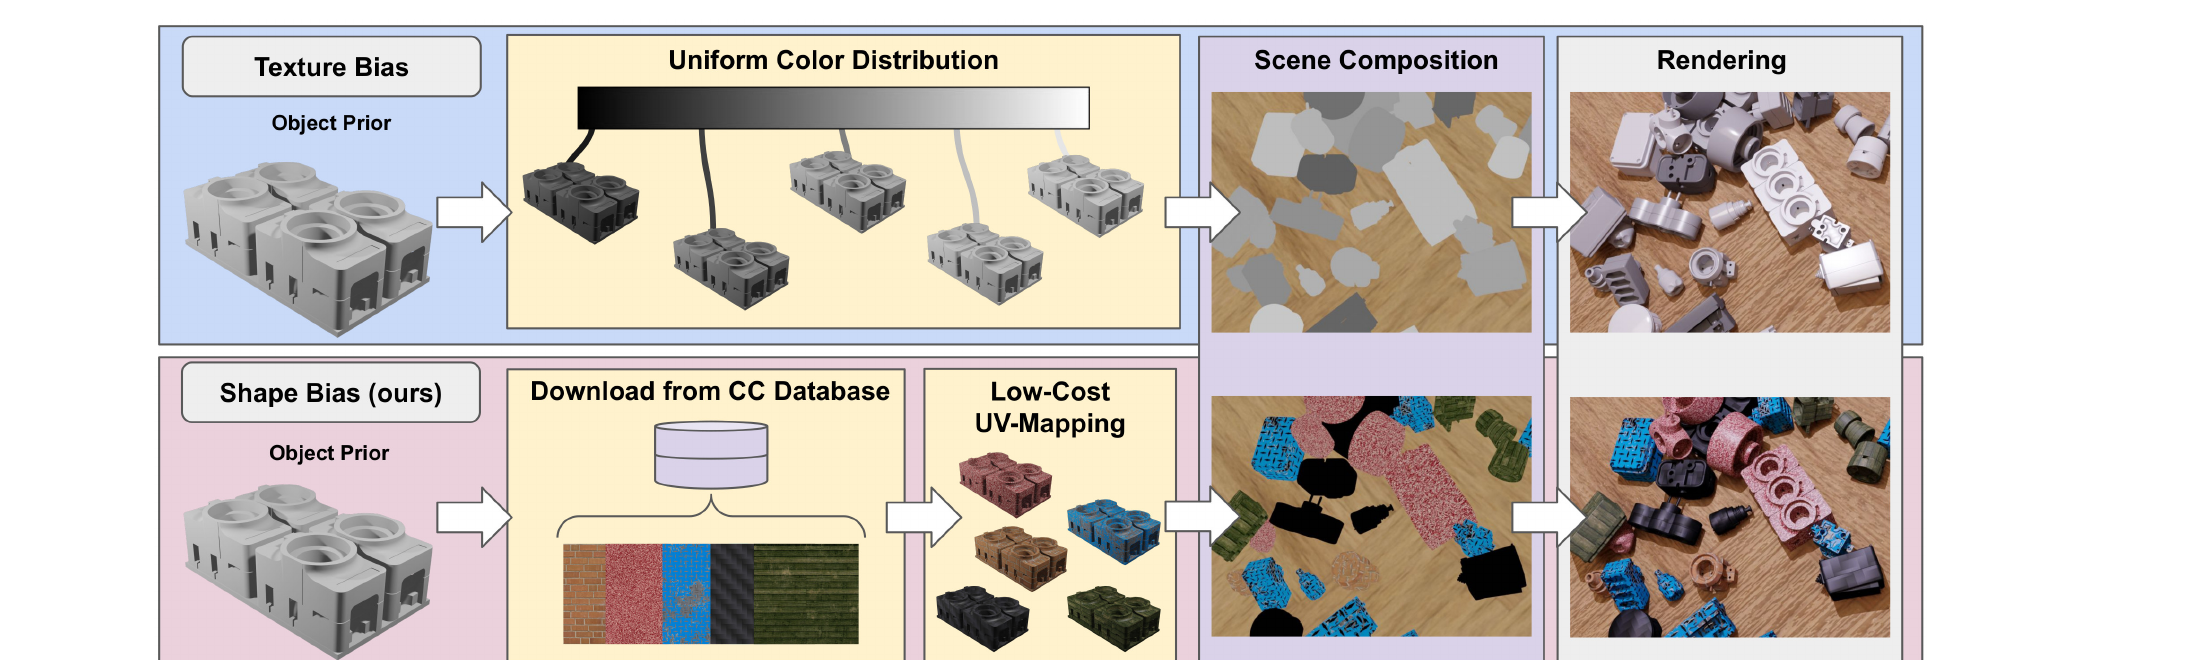
原论文 Figure 2:上方 baseline 通过均匀颜色采样改变对象外观;下方方法从 Creative Commons 纹理库采样并对 CAD surface 做 UV mapping。两条路线之后使用相同的场景组合与 PBR rendering。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
5.1 与 BOP PBR pipeline 的关系
作者使用 BlenderProc 和 BOP standard configuration。常规 domain randomization 继续覆盖:
背景纹理;
相机视角;
对象位置与旋转;
场景中对象组合;
光源与阴影;
specularity 与 roughness。
本文新增的变量是前景对象表面纹理 。这很重要,因为随机背景主要帮助 foreground–background separation,却没有破坏对象内部 appearance shortcut。
5.2 两个材质配置
参数 Texture-biased baseline Shape-biased variant specularity U ( 0 , 1 ) \mathcal{U}(0,1) U ( 0 , 1 ) U ( 0 , 1 ) \mathcal{U}(0,1) U ( 0 , 1 ) roughness U ( 0 , 1 ) \mathcal{U}(0,1) U ( 0 , 1 ) U ( 0 , 1 ) \mathcal{U}(0,1) U ( 0 , 1 ) surface color RGB 各通道 U ( 0.1 , 0.9 ) \mathcal{U}(0.1,0.9) U ( 0.1 , 0.9 ) 从 1,226 张纹理均匀采样并 UV-map scene / camera / lighting BOP standard 相同
两组都随机 specularity 与 roughness,所以主结果不能简化为“本文额外随机了反射参数”。真正差异是纯色 prior 与随机空间纹理 prior。
5.3 纹理库
来源为论文当时使用的 Creative Commons texture database;
半透明 texture 被移除;
最终可用 opaque textures 为 1,226 张 ;
一张 texture 可用于多个对象,单个对象也在不同 rendering 中不断更换 texture;
Figure 2 只展示 5 张示例,不代表训练只用 5 张。
论文把这个过程称为 low-cost UV mapping。它不要求为每个工业零件人工绘制语义纹理,目标只是制造足够多样、和对象 identity 无稳定关系的 surface pattern。
5.4 数据规模与计算成本
完整 synthetic dataset 包含 50,000 张 renderings 。作者强调:相较标准 PBR 数据生成和网络训练,随机取纹理并 UV-map 的额外开销可以忽略。这个结论是工程层面的:没有新增推理模块,也不改变模型 FLOPs;但实际数据生成速度仍受 texture I/O、材质缓存和 renderer 设置影响,复现时应记录。
6. 为什么 UV mapping 可能比 style transfer 更合适
AdaIN 类 style transfer 在二维图像上重新分配 style statistics,可以提高 classification shape bias;但 pose estimation 依赖精确空间线索。作者提出 UV mapping 的三点直觉:
纹理被绑定到真实 3D surface :透视缩放、曲面形变、遮挡和阴影由 renderer 统一处理;纹理与对象 identity 解耦 :不同 surface appearance 共享同一 pose label;同一数据生成方式可服务 classification、detection、segmentation 与 pose ,无需为每个任务设计单独 style-transfer pipeline。
T-LESS classification 的受控实验使用 ResNet50、GT bounding box crop,结果为:
训练方式 Top-1 accuracy Top-5 accuracy 纯色 texture bias 63.22 86.27 AdaIN style-transfer shape bias 75.88 91.16 UV-mapping shape bias 87.27 97.37
相对 AdaIN,UV mapping 的 top-1 / top-5 相对改善为 15.01% / 6.81% 。这证明的是本文设置下的 classification representation 更好,不足以单独证明 pose 提升;真正的 pose 证据仍来自 Table 4。
7. 实验设计
7.1 数据集选择
T-LESS
T-LESS 含大量无纹理工业对象,许多对象几何相近、存在对称性,真实测试中又有遮挡与 clutter。它适合检验固定颜色 prior 是否让模型忽视形状差异。
ITODD
ITODD 以金属工业对象为主,外观强烈依赖 incident light、镜面反射和曝光。它是本文“appearance changes”动机更直接的压力测试。
但论文明确写出:ITODD test set 的 ground-truth annotations 不公开,作者通过 BOP evaluation server 获得结果,且 Figure 4 无法展示 detection GT。结论段也把“更完整的金属对象评价”列为未来工作。因此 ITODD 结果可证明 leaderboard metric 改善,不能支撑全面的 per-object / failure-type 归因。
7.2 检测器
Faster R-CNN;
RetinaNet;
YOLOx;
YOLOv8;
YOLOv10。
这组模型横跨 two-stage / one-stage 与不同年代,但并不包括 transformer detector。作者观察到较新的单阶段 YOLO 系列整体受益更稳定,并把它归因于更高学习容量与架构差异;这是论文解释,不是被单独控制的因果变量。
7.3 Pose estimators
模型 Backbone 协议 GDR-Net ResNet34 每对象训练一个 estimator;使用 YOLOx detections Pix2Pose ResNet50 每对象训练一个 estimator;使用 YOLOx detections
两者都属于 CNN-based multi-stage instance-level pose。检测框既影响 crop,也影响后续 correspondence / regression,因此 Table 4 分别控制 object detection bias(O.D.)与 pose estimation bias(P.E.)。
7.4 指标
BOP 总 AR 由三项平均:
A R B O P = A R M S P D + A R M S S D + A R V S D 3 . AR_{BOP}=\frac{AR_{MSPD}+AR_{MSSD}+AR_{VSD}}{3}. A R B O P = 3 A R M S P D + A R M S S D + A R V S D .
MSPD :最大对称感知投影误差,偏图像空间对齐;MSSD :最大对称感知表面距离,偏三维表面错位;VSD :可见表面差异,处理遮挡和可见区域;每项先跨多个误差阈值求 Average Recall。
对 textureless / symmetric objects,只用 ADD 或角度误差容易误罚对称等价姿态;采用 BOP 三项更合适。
8. 检测实验:收益不是普遍单调的
论文的检测结果比“shape bias 提升五个 detector”更复杂。
8.1 默认增强配置
作者报告的相对变化包括:
T-LESS:Faster R-CNN 与 RetinaNet 分别提升 247.03% 与 200.87%;这些巨大相对增益来自较低 baseline,不能脱离绝对 mAP 解读;
ITODD:Faster R-CNN 提升 11.37%,RetinaNet 下降 7.91% ;
T-LESS 的 YOLOx / YOLOv8 / YOLOv10 分别相对提升 51.52%、9.73%、6.78%;
ITODD 的三个 YOLO 分别相对提升 60.31%、44.91%、28.49%。
8.2 Tuned online augmentation
当每种设置重新调在线增强:
T-LESS 的 Faster R-CNN 与 RetinaNet 分别下降 3.34% 与 5.80%;
ITODD 上二者分别提升 0.87% 与 6.51%;
ITODD 的 YOLOx / YOLOv8 / YOLOv10 分别相对提升 6.03%、46.20%、27.47%。
这说明 randomized texturing 与 online augmentation 会发生重叠或冲突。若已有强 color / contrast / noise augmentation,shape bias 的边际收益可能缩小;错误的增强强度还会破坏 detector training。
因此论文真正支持的说法是:对较新的 YOLO 系列,所测数据集与配置中收益较稳定;对所有 detector 并非无条件提升。
9. 6D Pose 主结果
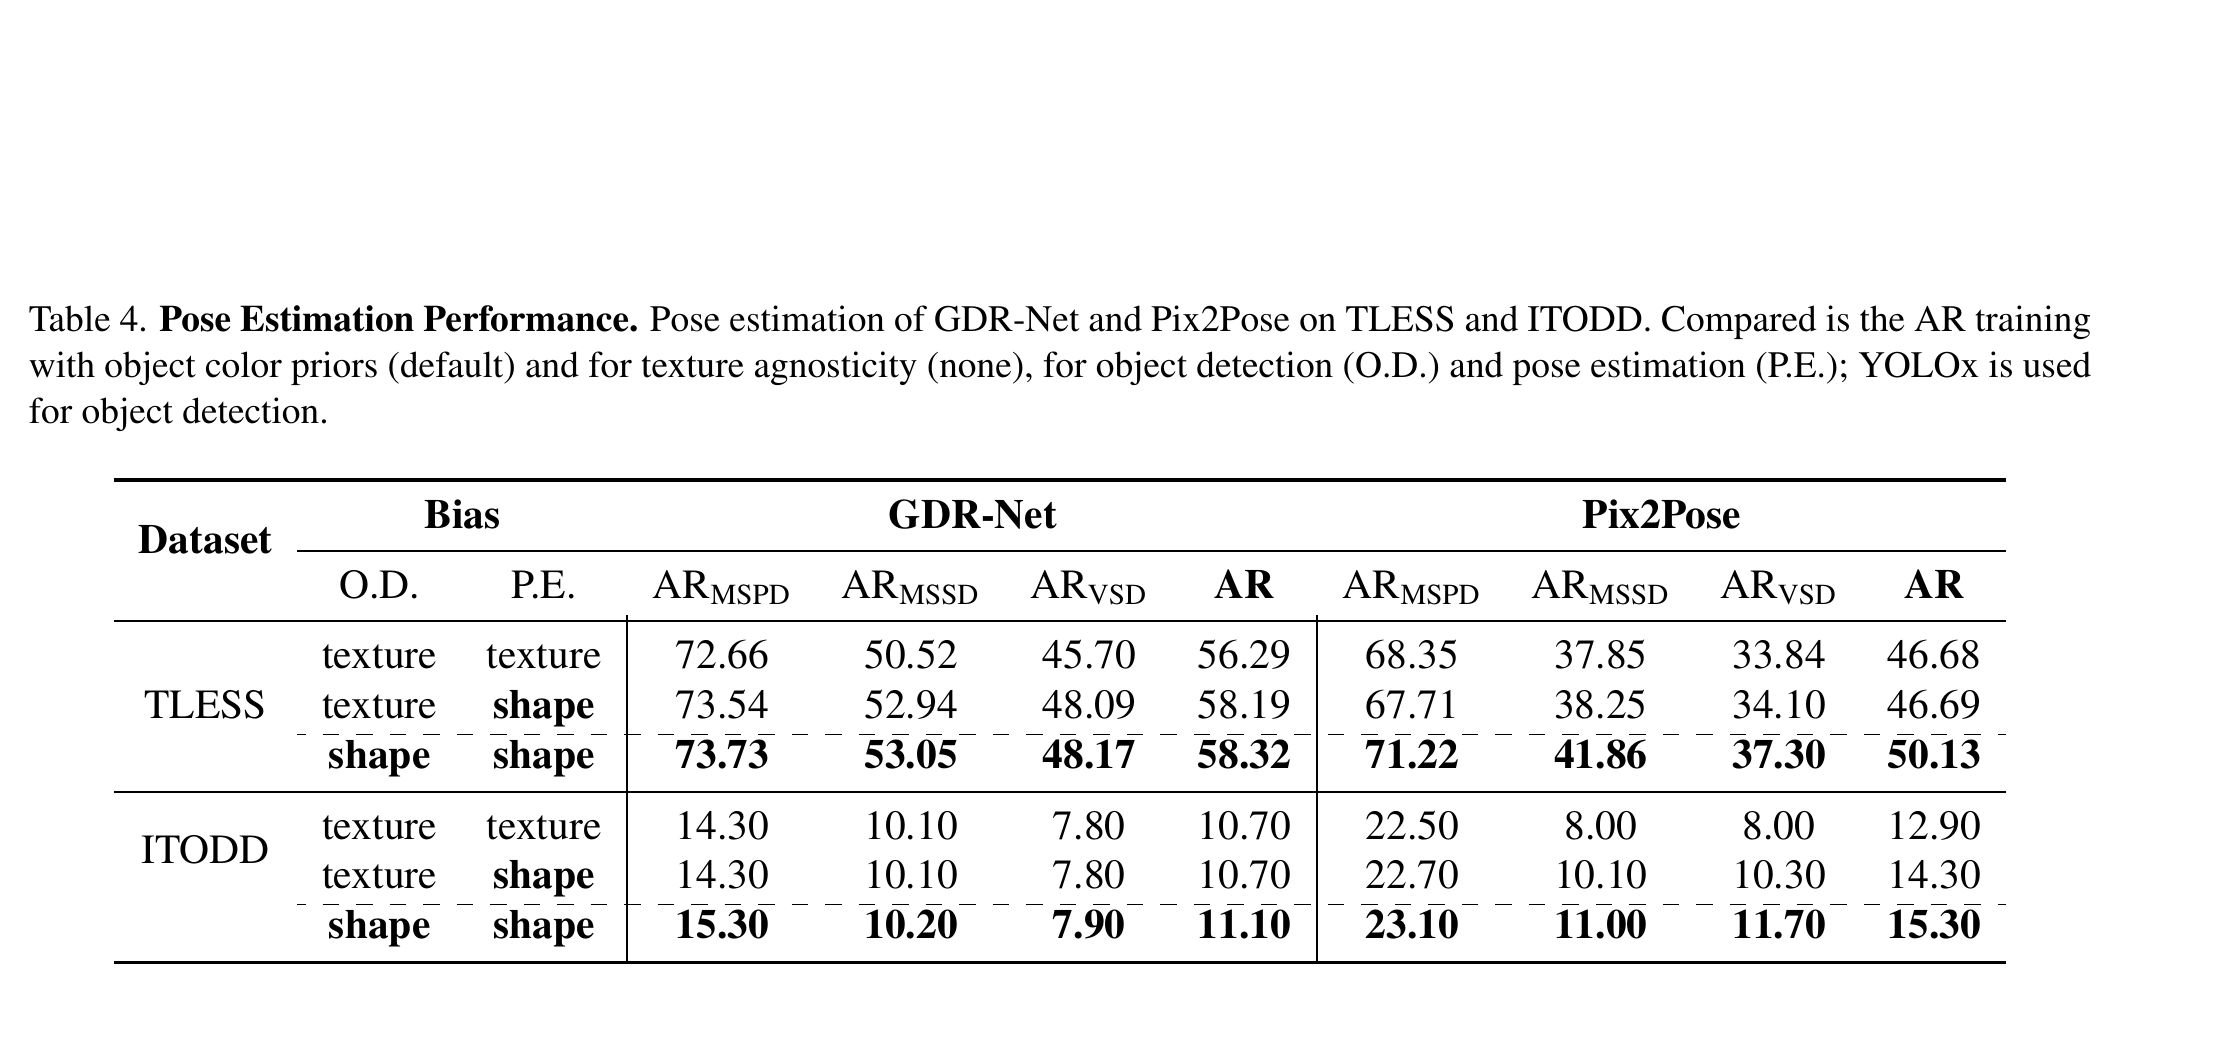
原论文 Table 4:分别改变 YOLOx detector(O.D.)与 pose estimator(P.E.)的 texture / shape bias,可将收益拆成 pose 端与 detection 端。粗体为两端均采用 shape bias。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
9.1 完整数值
Dataset Model O.D. P.E. MSPD MSSD VSD AR T-LESS GDR-Net texture texture 72.66 50.52 45.70 56.29 T-LESS GDR-Net texture shape 73.54 52.94 48.09 58.19 T-LESS GDR-Net shape shape 73.73 53.05 48.17 58.32 T-LESS Pix2Pose texture texture 68.35 37.85 33.84 46.68 T-LESS Pix2Pose texture shape 67.71 38.25 34.10 46.69 T-LESS Pix2Pose shape shape 71.22 41.86 37.30 50.13 ITODD GDR-Net texture texture 14.30 10.10 7.80 10.70 ITODD GDR-Net texture shape 14.30 10.10 7.80 10.70 ITODD GDR-Net shape shape 15.30 10.20 7.90 11.10 ITODD Pix2Pose texture texture 22.50 8.00 8.00 12.90 ITODD Pix2Pose texture shape 22.70 10.10 10.30 14.30 ITODD Pix2Pose shape shape 23.10 11.00 11.70 15.30
9.2 把收益拆成 pose 端与 detector 端
T-LESS / GDR-Net
baseline:56.29;
只改 pose estimator:58.19,+1.90 AR ,相对 +3.38%;
detector 也改:58.32,再 +0.13 AR ;
完整链路相对 baseline:+3.61%。
GDR-Net 的主要收益来自 pose training 本身,YOLOx 改善是小幅追加。
T-LESS / Pix2Pose
baseline:46.68;
只改 pose estimator:46.69,几乎不变;
detector 也改:50.13,再 +3.44 AR ;
完整链路相对 baseline:+7.39%。
Pix2Pose 的结果提醒我们:不能把最终提升全部归因于“pose representation 更 shape-biased”。在这个配置中,更好的 / 分布更一致的 detector 是关键中介变量。
ITODD / GDR-Net
baseline:10.70;
只改 pose estimator:10.70,无变化;
detector 也改:11.10,+0.40 AR;
完整链路相对 baseline:+3.74%。
ITODD / Pix2Pose
baseline:12.90;
只改 pose estimator:14.30,+1.40 AR,相对 +10.85%;
detector 也改:15.30,再 +1.00 AR;
完整链路相对 baseline:+18.60%。
这里的 relative gain 很醒目,但绝对 AR 只有 15.30。低 baseline 下应同时报告绝对 +2.40 AR,避免“18.60%”给人问题已大幅解决的错觉。
9.3 三项 metric 的变化说明什么
T-LESS / GDR-Net:MSPD、MSSD、VSD 都提升,说明不是仅修正二维框位置;
T-LESS / Pix2Pose:完整链路中 MSPD 从 68.35 到 71.22,MSSD 从 37.85 到 41.86,VSD 从 33.84 到 37.30,三项一致改善;
ITODD / GDR-Net:提升主要来自 MSPD 14.30 到 15.30,MSSD / VSD 仅 +0.10;
ITODD / Pix2Pose:MSSD 与 VSD 的相对改善更明显,说明其 surface alignment 确有变化,而不只是 detector crop。
但 Table 4 没有 uncertainty、multi-seed variance 或 per-object breakdown,无法判断平均收益由多数对象小幅提升,还是少数困难对象显著提升驱动。
10. 图像扰动实验:机制边界最清楚的一组证据
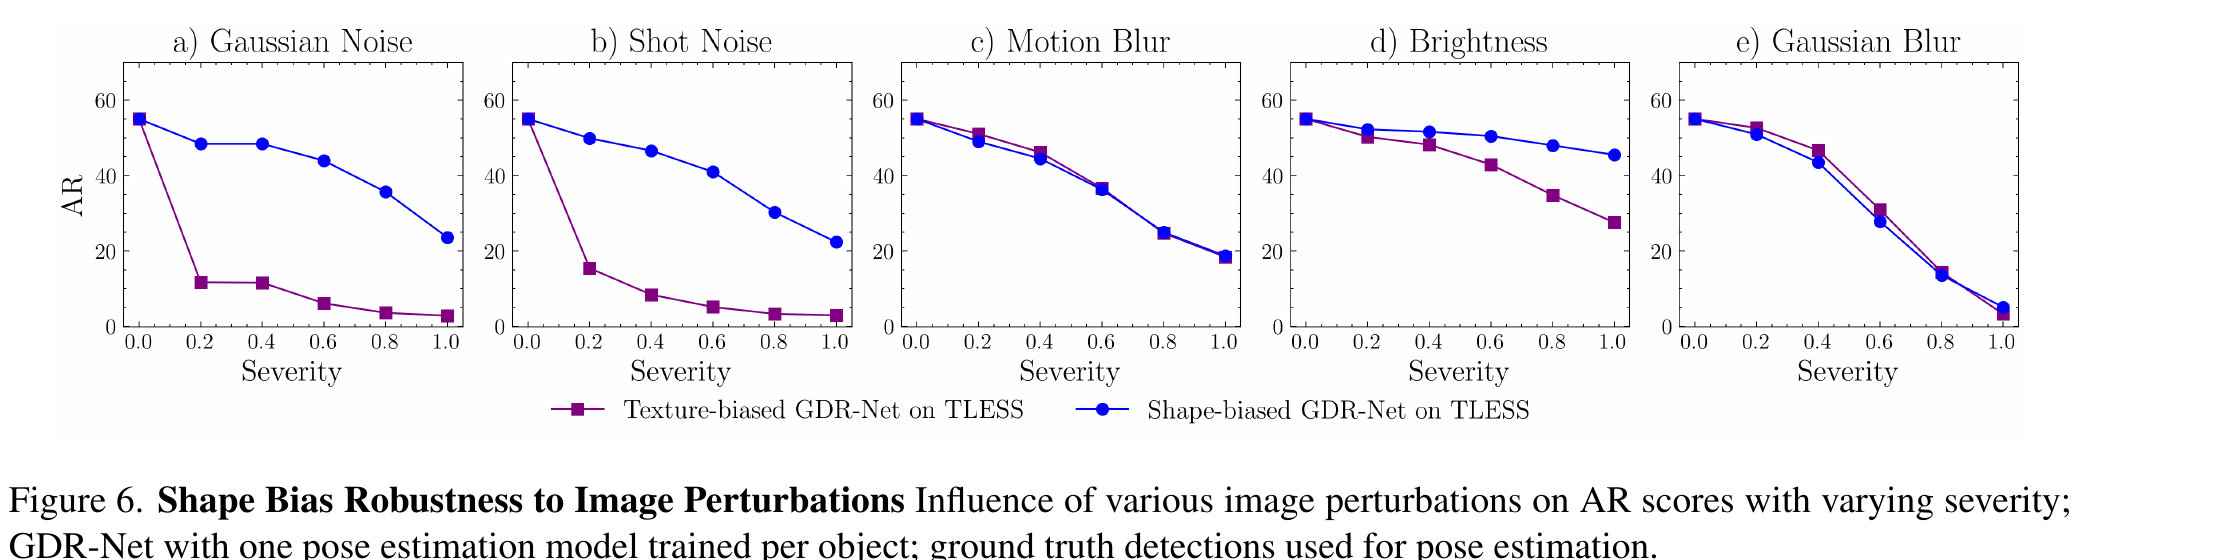
原论文 Figure 6:在 T-LESS 上使用 GT detections,比较 texture-biased 与 shape-biased GDR-Net。随机纹理对 Gaussian / shot noise 与 brightness change 明显有效,对 motion blur 与 Gaussian blur 几乎没有稳定帮助。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
10.1 协议
dataset:T-LESS;
estimator:GDR-Net;
每对象一个 pose model;
使用 ground-truth detections ,隔离 detector error;
对 test image 施加不同 severity 的 corruption;
比较 texture-biased 与 shape-biased training。
10.2 Gaussian noise 与 shot noise
baseline 在很低 severity 后 AR 就骤降到低位,shape-biased model 则随 severity 较平滑下降。由于随机 surface texture 让训练图像包含更丰富的局部高频模式,network 可能不再依赖某一组稳定像素统计。
这里“可能”很重要:论文没有用 frequency response、feature attribution 或 linear probe 直接验证内部机制。
10.3 Brightness
shape-biased model 在中高 severity 下保持明显更高 AR。这个结果与金属对象动机一致:如果 identity / pose feature 不强绑定固定颜色和强度,整体亮度变化更难破坏预测。
10.4 Motion blur 与 Gaussian blur
两种训练方式基本同轨下降。blur 会直接移除轮廓、局部边缘和细粒度空间结构,而这些恰是 shape-biased model 更依赖的 cue。随机纹理只改变训练分布,不能恢复输入中不存在的几何信息。
这是非常有价值的负结果:它防止把 shape bias 误解为通用 corruption robustness。
10.5 协议限制
使用 GT detections 有利于隔离 pose backbone,却比真实 pipeline 更理想。真实噪声 / 亮度变化也会先伤害 detector,Figure 6 不能证明完整 detector + pose chain 在同样 severity 下保持相同优势。
11. 消融实验
11.1 随机纹理数量
Figure 5 在 T-LESS 上用 YOLOx detection mAP 研究纹理集合大小:
n = 1226 n=1226 n = 1226 n = 5 n=5 n = 5 n = 100 n=100 n = 100
这反映 diminishing returns。少量纹理已经能破坏“对象 = 固定颜色”的捷径,后续纹理主要增加局部 pattern 和频谱覆盖。
复现时应注意:这些比例来自 YOLOx / T-LESS 的 detector ablation,不应写成“所有 pose model 使用 100 张纹理都达到 99.63%”。
11.2 Shape bias 与 online augmentation
作者把常用增强的 probability 乘以缩放系数 λ ∈ [ 0 , 1 ] \lambda\in[0,1] λ ∈ [ 0 , 1 ]
Figure 7 的结论:
Pix2Pose pose 最佳约在 0.2 ≤ λ ≤ 0.4 0.2\leq\lambda\leq0.4 0.2 ≤ λ ≤ 0.4
YOLOx detection 最佳约在 λ = 0.4 \lambda=0.4 λ = 0.4
pose 端在多个增强强度下 shape bias 都有收益;
detector 端必须重新调强度才能得到最好 mAP。
这说明两类 randomization 有三种关系:
互补 :surface randomization 改材质,online augmentation 改成像;冗余 :两者都可能改变颜色、对比度和局部统计;冲突 :过强 augmentation 会同时破坏 texture 与 shape cue。
11.3 Mesh origin:几何误差无法被 appearance randomization 消除
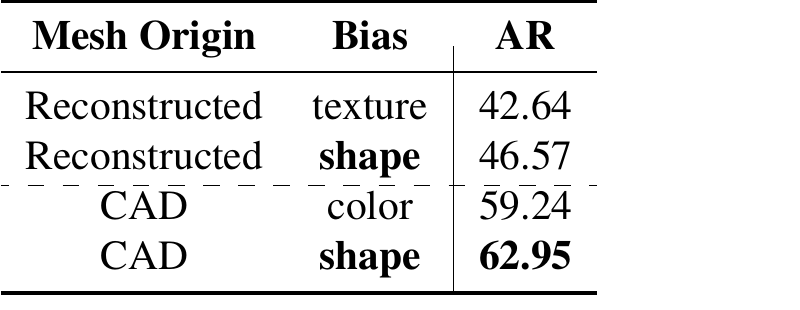
原论文 Table 6:T-LESS、Pix2Pose、GT detections、在线增强缩放系数 0.2。shape bias 在两种 mesh 上都改善,但准确 CAD 相比 reconstructed geometry 仍有约 16 AR 的明显优势。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Geometry prior Appearance prior AR reconstructed mesh reconstructed texture 42.64 reconstructed mesh randomized texture / shape 46.57 CAD randomized grayscale color 59.24 CAD randomized texture / shape 62.95
两个正交效应都很清楚:
同一 mesh 内,shape bias 分别提升 +3.93 与 +3.71 AR;
同一 bias 类型下,CAD 相比 reconstruction 分别提升 +16.60 与 +16.38 AR。
这意味着 geometry prior 的质量是更大的主效应,randomized texture 是其上的增益。若 CAD-free pipeline 的 reconstruction 尺度、轮廓或局部结构错误,仅靠纹理随机化无法弥补 coordinate supervision 的系统偏差。
12. 为什么不同模型收益不同
论文把 Pix2Pose 更大的提升归因于其 ResNet50 feature extractor 相对 GDR-Net ResNet34 有更高容量。这个解释有一定合理性,但当前实验还混合了:
network head 与 training loss 不同;
correspondence / regression 机制不同;
crop 与 detector sensitivity 不同;
baseline absolute AR 不同;
online augmentation protocol 不同。
因此不能从两组模型直接推出“backbone 越大,shape bias 收益越高”。更严谨的验证需要在同一 architecture 上只替换 backbone scale,或做 matched-capacity experiments。
一个更可靠的观察是:shape bias 的收益受模型如何利用局部 appearance、如何处理 detector crop、以及训练分布是否一致共同决定。
13. 方法的真正强项
13.1 插件式改动
它不新增 inference branch,不改变 pose output,也不需要额外 real annotations。只要 synthetic renderer 能给 mesh 分配材质,就可以接入。
13.2 对无纹理 / 金属对象动机吻合
这类对象真实 appearance 对光照敏感,固定 synthetic color 先验尤其脆弱。随机纹理虽不逼真,却故意扩大 appearance support,让 network 学习更稳定 cue。
13.3 实验不只看 clean accuracy
论文用 image corruption、texture count、augmentation strength、mesh origin 进一步检查“为什么有效、哪里无效”,比只展示单张主表更可信。
13.4 Detector 与 pose 分阶段控制
Table 4 的 texture/shape 组合揭示了两阶段系统的中介变量。尤其 Pix2Pose / T-LESS 例子说明:如果只看最终 shape/shape 与 texture/texture,会错误地把 detector 带来的大部分增益归给 pose estimator。
14. 局限与因果边界
14.1 只覆盖 CNN
论文结论明确写出未研究 Vision Transformer 和 Diffusion model。现代 DINO / ViT feature 本身可能有不同的 shape / texture preference,随机纹理的收益、最佳纹理数量与增强强度都需重新测量。
14.2 任务只到已知实例逐对象训练
每对象训练 estimator 意味着 network 可以把对象 geometry 烘焙进权重。未见物体方法依赖跨实例 feature matching 或 CAD template retrieval,随机纹理是否会帮助或破坏 reference-query matching 并不确定。
14.3 ITODD 证据不完整
test GT 不公开,无法在论文内部做完整 error analysis。金属对象是标题重点,但最可诊断的 robustness 与 mesh ablation主要在 T-LESS 上完成。
14.4 缺少统计不确定性
主表没有展示多随机种子均值、标准差或置信区间。T-LESS / GDR-Net 最终只比 pose-only shape setting 多 0.13 AR,这类小差异是否超过训练随机性无法由表中证据判断。
14.5 “Shape representation”没有被直接测量
准确率与 robustness 是行为证据,但不等于 feature geometry probe。可以进一步做:
texture-swap consistency;
silhouette / edge occlusion sensitivity;
feature linear probe for object coordinates / normals;
cross-texture correspondence stability;
centered kernel alignment 比较不同训练分布的 representation。
14.6 随机纹理可能伤害细纹理判别任务
对 T-LESS / ITODD,真实对象本就缺少稳定纹理;对几何近乎相同、但依靠 logo 或印刷图案区分的商品实例,强行 texture-agnostic 可能删除有效 cue。理想策略可能是 shape-biased 与 texture-faithful data 混合,而不是全量替换。
14.7 不解决几何、检测与模糊
reconstructed geometry 误差仍造成约 16 AR gap;
detector 的增强需重新调参;
motion / Gaussian blur 不改善;
ITODD 绝对 AR 仍低。
所以它是数据分布的一个维度,不是完整 industrial pose solution。
15. 复现清单
15.1 数据准备
获取 T-LESS / ITODD CAD、BOP camera / pose annotations;
准备与许可证相容的 texture library;
移除带 alpha / 半透明或 renderer 无法稳定处理的 texture;
固定 texture pool 的版本与文件列表,记录 n n n
为每个对象确认 UV mapping 不产生严重尺度异常或未映射区域。
15.2 两套严格可比的 rendering
Texture baseline:
RGB 每通道从 0.1–0.9 均匀采样;
specularity / roughness 各从 0–1 采样。
Shape variant:
相同 specularity / roughness;
从 texture pool 均匀抽样;
通过 UV mapping 应用到 object surface。
其余 scene composition、camera distribution、lighting、background、object count、render count、resolution 与 random seed policy 应一致。否则结果会混入额外 domain-randomization 差异。
15.3 训练
每个 variant 使用相同 network initialization policy、epoch、optimizer 与 batch schedule;
baseline 与 shape variant 都单独搜索合理 online augmentation;
detector 与 pose estimator 分别训练,保留四种组合中至少三种:texture/texture、texture/shape、shape/shape;
若成本允许,加入 shape detector + texture pose,完整分解交互;
至少 3 个随机种子,报告均值与标准差。
15.4 评价
clean BOP AR、AR_MSPD、AR_MSSD、AR_VSD;
detector mAP 与 recall,避免 pose 增益被 detector 隐藏;
GT detections 下的 pose-only result;
predicted detections 下的 end-to-end result;
noise、brightness、motion blur、Gaussian blur;
per-object 与 symmetry group breakdown;
runtime / rendering overhead;
texture count 与 augmentation strength ablation;
CAD / reconstructed mesh 分层。
15.5 容易犯的复现错误
只随机背景,不随机前景对象表面;
baseline 不随机 specularity / roughness,导致不公平;
把 5 张示例纹理误当成论文完整设置;
shape variant 沿用 baseline 的最优 augmentation,却不给它重新调参;
只报告相对百分比,不报告绝对 AR;
用 GT detections 的 robustness 结果声称完整 pipeline 同样鲁棒;
把 ITODD 的定性框对齐图当作有公开 detection GT 的量化证据;
把“texture agnostic”写成完全纹理不变。
16. 对后续研究的启发
以下是基于论文证据的延伸建议,不是作者已经验证的结论。
16.1 自适应 texture–shape mixture
对无纹理 / 金属对象提高 randomized-texture ratio,对有可靠 logo / printing 的对象保留一部分真实 texture。可令混合概率依赖对象材质与 geometry symmetry:
I ∼ { R ( M , T r a n d o m ) , q ( o ) R ( M , T f a i t h f u l ) , 1 − q ( o ) . I\sim
\begin{cases}
\mathcal{R}(M,T_{random}), & q(o)\\
\mathcal{R}(M,T_{faithful}), & 1-q(o).
\end{cases} I ∼ { R ( M , T r an d o m ) , R ( M , T f ai t h f u l ) , q ( o ) 1 − q ( o ) . 这样既防 appearance shortcut,也不主动丢掉真实判别纹理。
16.2 与材质物理随机化结合
论文已经随机 roughness / specularity,但纹理仍来自普通 opaque surface。可进一步覆盖 metallic BRDF、anisotropy、clear coat、environment map 与曝光响应,并单独消融“随机图案”和“随机物理材质”的贡献。
16.3 面向 foundation feature 的再验证
在 DINOv2、DINOv3、CLIP / SigLIP、diffusion correspondence 或 ViT detector 上重复 texture swap consistency 与 BOP evaluation,检查 foundation features 是否已经具备更强 shape bias,以及额外随机纹理是否仍有边际收益。
16.4 用 feature-level consistency 代替纯数据干预
同一 object / pose 渲染多个 texture views,除原任务 loss 外加入 feature consistency:
L i n v = ∥ f θ ( I T i ) − f θ ( I T j ) ∥ , \mathcal{L}_{inv}=\left\|f_\theta(I_{T_i})-f_\theta(I_{T_j})\right\|, L in v = f θ ( I T i ) − f θ ( I T j ) , 并只在对应 surface region 对齐。这样能更直接约束 texture invariance,但也可能过度抹除真实纹理,需要与 faithful branch 平衡。
16.5 联合 geometry-quality curriculum
Table 6 表明 geometry gap 是主效应。可同时随机 mesh noise、missing surfaces、normal errors 与 texture,训练 estimator 对现实 reconstruction asset 更稳;不过必须避免让不准确 geometry supervision 本身污染 pose label。
17. 与 6D pose 技术路线的关系
这篇论文不是新的 correspondence、PnP、render-and-compare 或 direct regression 方法。它位于系统前端的 training-data layer:
CAD / reconstructed mesh
        ↓
材质与纹理分布设计  ← 本文贡献
        ↓
BlenderProc PBR synthetic images
        ↓
object detector + instance-level pose estimator
        ↓
BOP 6D pose metrics
它与其他方向的互补关系是:
与 synthetic data :扩展 domain randomization 到 foreground surface;与 correspondence :可能让 2D feature 更依赖几何,但论文未直接测 correspondence;与 model-based pose :仍依赖 CAD / mesh;与 CAD-free reconstruction :可改善使用 reconstructed mesh 的训练,但无法消除 geometry gap;与 robustness :改善 noise / brightness,不能解决 blur;与 unseen-object pose :动机相关,但本文未验证跨对象泛化。
18. 精读结论
Randomized Texturing 是一个“小改动、强实验边界”的工作。它最可信的结论不是“CNN 已经学会形状”,而是:
在 T-LESS / ITODD 的 CNN-based instance-level detection 与 pose pipeline 中,把对象表面从均匀随机颜色改为大量随机 UV texture,能够降低对固定 appearance 的依赖;该干预在所测 pose 配置中持平或改善 clean BOP AR,并显著增强 Gaussian / shot noise 与 brightness robustness,但收益依赖 detector、pose architecture、online augmentation 与 geometry prior。
工程上可以把它作为 BlenderProc / BOP pipeline 的低成本默认候选,尤其是无纹理、反光工业对象;研究上则应继续做多种子统计、feature-level probe、ViT / diffusion 验证、真实材质混合和 full-pipeline corruption evaluation。
最后要保留三个防止过度宣传的数字:
T-LESS 的完整提升是 GDR-Net +2.03 AR 、Pix2Pose +3.45 AR ;
ITODD 的 Pix2Pose 虽相对提升 18.60% ,绝对结果仍只有 15.30 AR ;
CAD + shape bias 比 reconstructed mesh + shape bias 高 16.38 AR 。
它解决的是 appearance shortcut 的一部分,不是工业 6D pose 的全部困难。