论文精读笔记:SMORE: Simultaneous Map and Object REconstruction
1. 基本信息
2. 一句话定位
SMORE 面向旋转式车载 LiDAR 的动态城市序列:把背景与每个动态刚体放进一个连续时间的全局表面优化,通过 deskew、鲁棒 ICP 和 neural surface reconstruction 交替校正自车 pose、对象 pose 与地图,而不是把 bbox annotation 当作最终运动真值。
2.1 论文图表导读
| 图表 | 内容 | 阅读重点 |
|---|
| Figure 1 | 只用人工 pose 聚合 vs 联合优化后的地图 | 可视化展示 pose 误差如何变成表面重影与拖影 |
| Figure 2 | 动态对象由粗框、pose 优化、再到 deskew | 说明连续扫描时间不仅影响 ego,也影响运动对象 |
| Table 1–2 | 表面质量、actor ATE 与 annotation subsampling | 判断系统是否能从稀疏 / 粗轨迹回收对象状态 |
| Table 3–4 | LiDAR NVS 与 ego pose 评估 | 将几何重建与 pose 质量交叉验证 |
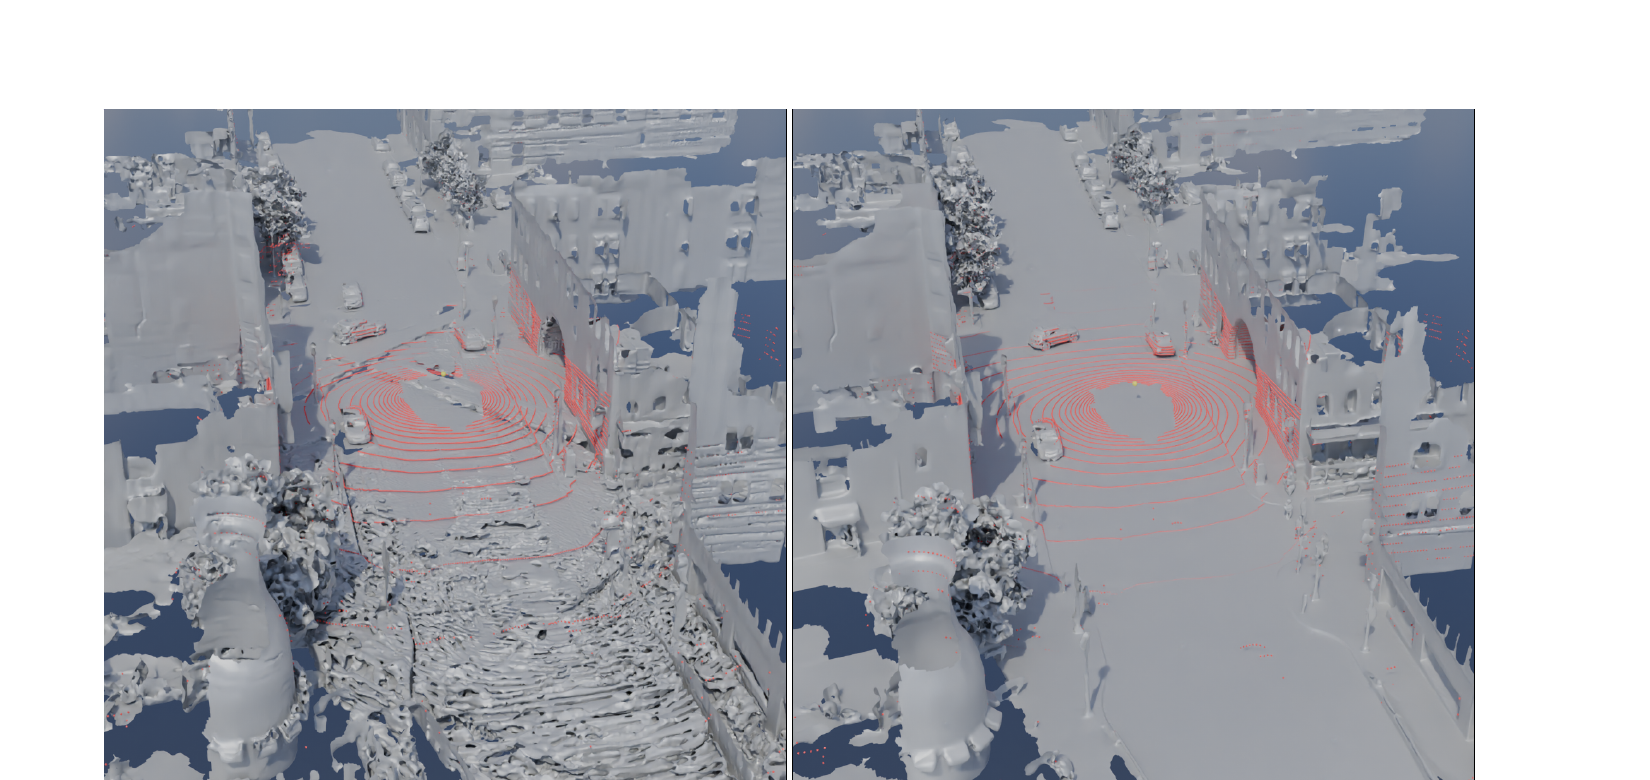 原论文 Figure 1:用人工初始 pose 聚合 LiDAR(左)与 SMORE 联合优化后(右)的表面重建。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
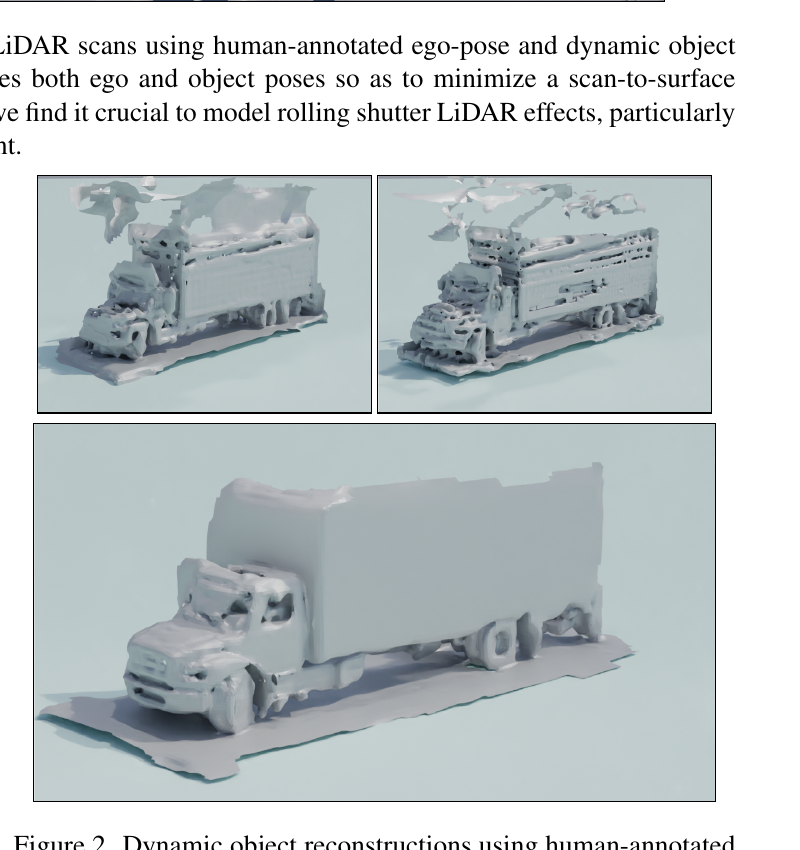 原论文 Figure 2:动态对象的粗标注、object-pose optimization 与 deskew 后的重建对比。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与对象 pose 的含义
- 输入是连续的 spinning LiDAR sweeps、初始 ego pose、动态对象 3D boxes / tracks;每束激光在 sweep 内的时间不同。
- 输出为背景和 actor 的 surface、每个对象的时序刚体 pose、以及校正后的 ego trajectory。
- 任务本质是 simultaneous map and object reconstruction。object pose 是序列里的全局刚体状态,不是单帧 RGB object-to-camera pose。
- 系统假设动态对象近似刚体、可被 detector / tracker 关联;旋转 LiDAR 的 timestamp 可取得。
4. 为什么要显式建模 continuous-time LiDAR
一帧 spinning LiDAR 不是全局快门:自车行驶、对象移动时,同一扫描前后的点处在不同真实相对 pose。只用某个 sweep timestamp 回投会把一辆车拉成拖影,或把静态地图叠出重影。传统 ego deskew 只能补相机运动;SMORE 进一步为每个 actor 的运动去畸变。
作者的关键判断是:如果 pose 错,表面 reconstruction 必然错;但如果能重建局部表面,点到表面的 registration 又可以反过来纠正 pose。这使 pose 与 geometry 成为交替优化的两个变量组。
5. 方法详解
5.1 状态表示与交替优化
SMORE 把背景和各动态 actor 的 scan points 转到各自的 canonical / world frame。ego 与对象均由连续时间 SE(3) 轨迹描述,以解释点的精确采样时刻。流程可概括为:
- 由 LiDAR odometry 和检测 / 关联初始化 ego、actor trajectories。
- 根据当前轨迹 deskew 并聚合 sweeps,分别对背景、每个对象重建 neural kernel surface。
- 将 scan point 对齐到对应表面,优化 ego 与 object pose;point-to-plane loss 使用鲁棒 Huber kernel。
- 更新 pose 后重新合成点云与表面,迭代至 registration error 收敛或早停。
| 组件 | 解决的问题 | 与 pose 的关系 |
|---|
| continuous-time deskew | 同一扫描内的时序畸变 | 使每个点回到正确 observer / actor pose |
| object-centric surfaces | 动态物体被背景淹没 | 为 actor pose 提供局部几何锚点 |
| point-to-plane ICP | 仅靠 bbox 难以精确定位 | 用法线方向误差校正刚体变换 |
| joint ego / actor update | ego error 与对象 error 相互耦合 | 避免固定一端时把误差嫁接给另一端 |
5.2 表面与优化器不是端到端学习模型
论文使用 Neural Kernel Surface Reconstruction 作为 surface step,而不是训练一个 end-to-end pose network。每次表面更新后,再在训练 / 测试 sweep 上做 refinement;论文描述测试中约进行 100 次 refinement iterations,并对平均 registration error 设早停。这个选择带来可解释性,但也意味着 run time 与 initialization 敏感性需要单独评估。
6. 实验分析
6.1 评价口径
- nuScenes、Argoverse 2;动态对象来自 LT3D 等检测 / tracker 输出或人工标注。
- surface:input-to-surface nearest-neighbor distance、10 cm / 5 cm relaxed / strict coverage。
- pose:用 held-out bounding-box labels 的 Average Translation Error(ATE)评价 actor location。
- LiDAR NVS:Chamfer distance、median depth error;还用 NeuRAD 在不同 ego pose 上拟合后的 PSNR / SSIM / LPIPS 等间接验证 pose。
作者也明确指出,公开的“ground truth” actor / ego annotations 本身不够精确,不能简单将其视为表面重建的绝对上界。这是论文选择多种互补指标的理由,也意味着一些 pose 结论是通过 reconstruction quality 间接支持的。
6.2 关键数字
| 结论 | 数值 | 解读 |
|---|
| NKSR + GT tracks | NN distance 0.071;strict 0.76 | 只拿初始轨迹聚合,表面仍较差 |
| SMORE + GT tracks | 0.048;0.91 | 联合 pose / surface 后几何更一致 |
| SMORE + LT3D tracks | 0.048;0.90 | tracker 初始化下仍能逼近 GT-track 结果 |
| actor ATE(1 / 0.5 / 0.25 Hz) | 0.20 / 0.22 / 0.52 m | 低频标注下比 linear interpolation 更稳 |
| LiDAR NVS | CD 0.26,median depth 0.0002 | 论文报告优于 NeuRAD 与其 pose 变体 |
6.3 应如何理解结果
作者主张“从 noisy annotation 恢复更准确 pose”,Table 1–2 和 Figure 1–2 给予直接支持,尤其是低 annotation rate 的 actor ATE。对 ego pose 的主张则更间接:用同一 NeRF 后端分别拟合 nuScenes、odometry、SMORE pose,SMORE 获得更好 rendering / geometry score。这是合理证据,但不等同于有高精度独立 GNSS/INS 真值的绝对 pose benchmark。
7. 局限、失败模式与可复现性
- 关联错误:detector 漏检、ID switch 或粗 box 偏移会给错误对象建立 surface,ICP 可能收敛到错误局部解。
- 低可观测性:远距离、遮挡或点密度稀疏的对象没有足够几何约束;“表面反证 pose”的闭环会变弱。
- 动态假设:对非刚性行人、开合部件、强反射/多径 LiDAR,没有相同保证。
- 离线成本:NKSR、反复 deskew 和 ICP 更适合高质量数据重处理;不能按论文主结果宣称在线部署速度。
8. 对动态 object pose 的启发
- 物体轨迹不应只由 temporal interpolation 决定;若传感器可提供 dense geometry,应以 surface consistency 做后验纠正。
- ego / object pose 的误差耦合必须在建模中显式存在,否则对象轨迹会吸收相机漂移。
- 后续可尝试把显式 surface residual 与 learning-based uncertainty / track association 结合,令系统在几何证据不足时停止过度校正。
