论文精读笔记:TwinTrack
1. 核心判断
- 论文:arXiv 2505.22882
- 项目:TwinTrack
- 核心问题:未知物体在碰撞、弹跳或手内操控时会突然改变速度,同时被环境或手指遮挡;单纯视觉 tracker 恰好会在最需要更新状态时失去观测。
- 核心回答:从视觉历史建立对象几何,再用真实接触轨迹校正碰撞几何和物理参数;在线把接触模拟的一步预测当作第二个 pose cue,与视觉匹配按置信度融合。
- 我的判断:论文真正的贡献不是“物理能帮助视觉”这一口号,而是把资产重建、系统辨识、实时视觉跟踪和接触模拟放进异步闭环。结果支持一步 / 短时预测有效,但不支持无视觉长时 rollout,也不应把辨识参数解读为精确物性测量。
2. 问题设定与假设
输入为单目 RGB-D 序列 (Ik,Dk),机器人在场时还输入 proprioception。对象在测试前未知、没有 CAD;第一帧需要给 SAM2 一个 prompt。输出是相机坐标中的逐帧 6D pose qk。
系统隐含的部署条件包括:
- 单一刚体,场景中的墙、地面或机器人几何可在 simulator 中表达;
- 首帧视觉状态足够准,否则错误 pose 会污染重建、碰撞几何和后续动力学;
- 学习轨迹要包含足够丰富的接触激励,否则摩擦、质量和惯量不可观;
- depth、相机内参以及机器人—相机标定可用;
- 慢后端可以异步运行,而在线前端必须只做一步模拟。
因此 “unknown object” 是无需对象 CAD,不是无需环境模型、分割器和物理引擎。
3. 总体架构:两个时间尺度的闭环
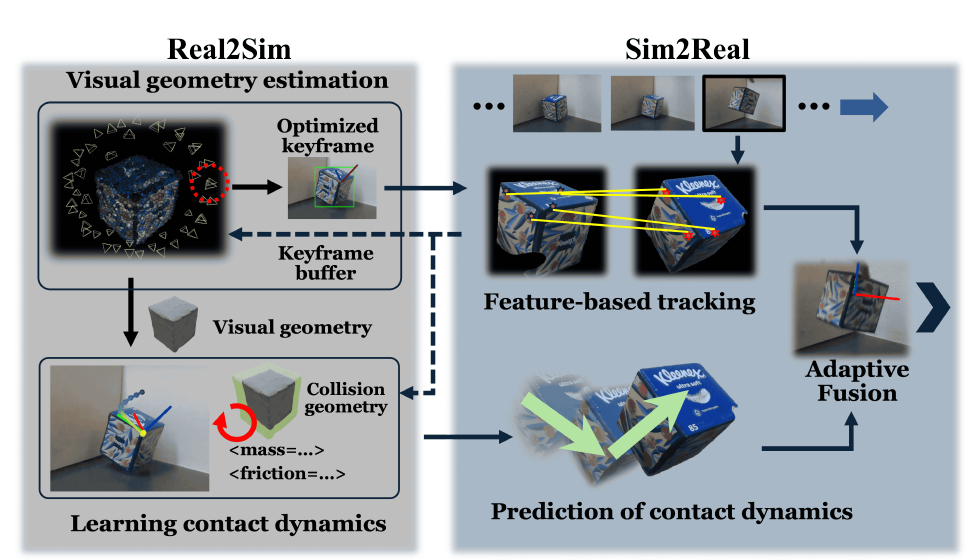 原论文 Figure 2:Real2Sim 接收 keyframe 与跟踪历史,返回优化 keyframe 和 simulation-ready contact model;Sim2Real 每帧融合视觉对应与一步物理预测。来源:TwinTrack 原论文。图片版权归论文作者所有,本站仅作学术解读展示。
Sim2Real 每帧输出 pose,并维护稀疏 keyframe buffer 与轨迹历史;Real2Sim 异步读取这些数据,更新:
- 带一致 pose 的 keyframe;
- 对象 visual geometry;
- 可查询碰撞的 SDF;
- 质量、惯量、摩擦等物理参数。
更新后的模型再返回在线端。启动初期物理模型不可靠,系统主要依靠视觉;随着接触数据积累,物理 cue 才逐渐有资格在遮挡时接管。这种设计避免把昂贵的 GS / SDF / 参数辨识塞进逐帧路径。
4. Real2Sim:从“看起来像”到“碰起来对”
4.1 视觉几何与 keyframe pose 联合优化
对象外观用 Gaussian Splats Ggs 表示。对 keyframe 集合 K,作者联合优化 GS 与各 keyframe pose:
{qi},Ggsmini∈K∑λphoEipho+(1−λpho)Eigeo,
其中 photometric loss 比较渲染 RGB 与观测 RGB,geometric loss 比较渲染 depth 与观测 depth。优化后的 keyframe pose 是在线视觉匹配的 anchor;GS 的渲染深度经 ray-casting sampling 学成
ϕ=SDFvision(p).
这是值得注意的表示分工:GS 适合多视图外观 / 深度优化,neural SDF 适合碰撞距离查询。论文没有强迫一个表示同时承担渲染和物理。
4.2 接触几何 residual
视觉重建在遮挡区或低质量 depth 处可能缺一块、鼓一块;这对图像渲染影响有限,却会改变碰撞发生时刻。作者定义
SDFcollision(p)=SDFvision(p)−δ(p).
论文当前实现把 δ(p) 限制成常数 δ,等价于对整个物体统一膨胀或收缩。这样表达能力有限,但稀疏、间歇接触不足以稳定拟合一个空间神经 residual;标量参数更容易辨识,也能修正常见的整体偏厚 / 偏薄。
定制 MJX 会从地面、墙和手指表面采样点,查询 neural SDF 进行碰撞检测。JAX 让大量候选物性和轨迹模拟可在 GPU 并行。
4.3 物理参数辨识
待估参数为
θ={mobj,diag(Ix,Iy,Iz),μ,δ}.
目标函数是 Sim2Real 历史轨迹上的一步预测误差:
L(θ)=(qk,vk,qk+1)∈Dtracking∑∥simθ(qk,vk)−qk+1∥W2.
接触动力学非光滑,MJX 的局部梯度无法为跨 contact mode 的全局搜索提供稳定方向。因此作者使用 CEM 变体:每轮并行采样参数,不只平均 elite,而用 loss 的 softmax 权重更新采样均值,形式上接近 MPPI。
这里辨识的目标是预测等价性,不是系统辨识教科书意义上的真参数恢复。Table II 的 learned mass 与真实质量仍有显著差距,例如 Spam can 在自由落体场景估为 15±5 g、真值 28 g。原因包括:
- 某些轨迹对摩擦 / 惯量激励不足;
- MJX point / rigid contact 与真实接触有 model bias;
- 质量和摩擦可相互补偿;
- LEAP 仿真手与硬件控制参数存在偏差。
只要组合参数能拟合一步运动,它仍可能帮助跟踪,但不能据此声称完成了准确材质测量。
5. Sim2Real:视觉与物理的自适应融合
5.1 视觉分支
第一帧 prompt 启动 SAM2;当前帧与最近的优化 keyframe 之间:
- SuperPoint 提取对象区域特征,并由 depth 提升为 3D 点;
- LightGlue 匹配;
- RANSAC 剔除错误对应并估计相对 pose;
- 新视角与既有 keyframe 的旋转距离超过阈值时加入 buffer。
选择 keyframe 而不是总与前一帧匹配,可减少连续积分漂移;Real2Sim 又会反向优化这些 keyframe pose。
5.2 融合目标
最终 pose 通过
qkminwkLvision(qk)+(1−wk)Ldynamics(qk)
求得。视觉项是当前帧与 keyframe 的匹配 3D 点距离;物理项为
Ldynamics(qk)=∥qk−sim(qk−1,vk−1)∥22.
wk 由 RANSAC 后可靠匹配数的 sigmoid-like 函数决定:
- 特征多:说明遮挡 / 模糊较轻,视觉获得高权重;
- 特征少:让接触动力学的一步预测填补观测;
- 两者都不是硬开关,避免在置信度边界突然跳变。
这比常速度 prior 更适合碰撞:碰撞正是速度不连续处,而 simulator 显式计算 impulse 和接触约束。
6. Real2Sim 实验:几何 residual 是否真的有用
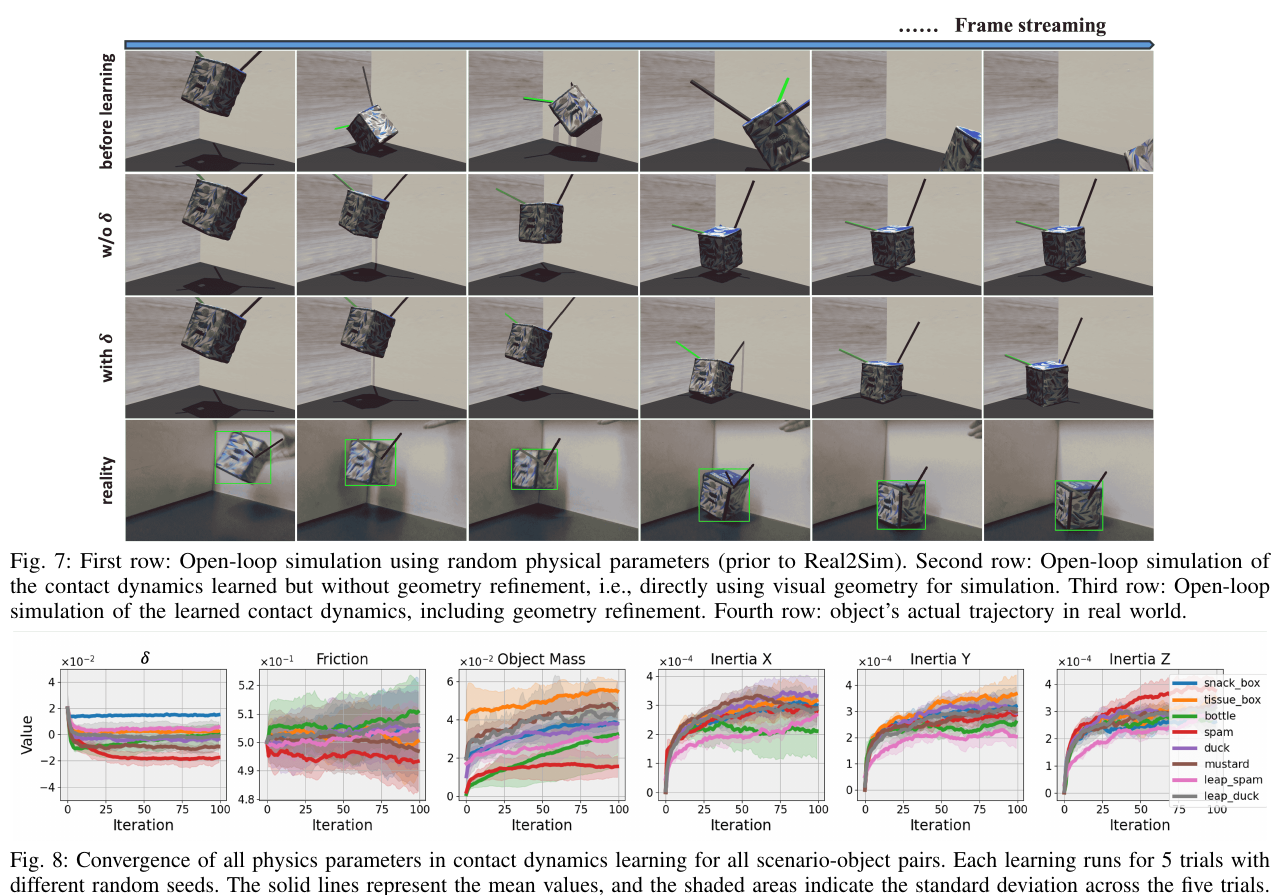 原论文 Figure 7–8:随机参数产生错误弹跳;只学物性、不修几何时会在错误接触位置悬浮;加入统一几何 residual 后,接触时刻与落定过程更接近真实轨迹。下方曲线同时显示物理参数虽收敛,却不一定收敛到真实值。来源:TwinTrack 原论文。图片版权归论文作者所有,本站仅作学术解读展示。
Table I 的一步 prediction error 定义为 100× position error 加 quaternion error。8 个对象—场景组合中:
| 条件 | snack | tissue | bottle | spam | duck | mustard | LEAP spam | LEAP duck |
|---|
| 随机参数 | 18.78 | 9.57 | 9.82 | 7.24 | 5.13 | 10.18 | 4.18 | 23.03 |
| 学物性、无 δ | 0.29 | 0.47 | 0.87 | 1.16 | 0.38 | 0.56 | 0.18 | 0.38 |
| 学物性与 δ | 0.20 | 0.22 | 0.70 | 0.43 | 0.21 | 0.15 | 0.13 | 0.28 |
统一几何 residual 在全部组合继续降低误差,说明视觉几何的毫米级偏差确实会被放大为接触预测误差。不过 Figure 7 的漂亮多步 rollout 不能外推为长时可预测:作者明确指出接触动力学对初值和表面细节高度敏感,方法适合一步 / 少步并由新视觉持续纠偏。
7. 跟踪主结果与正确口径
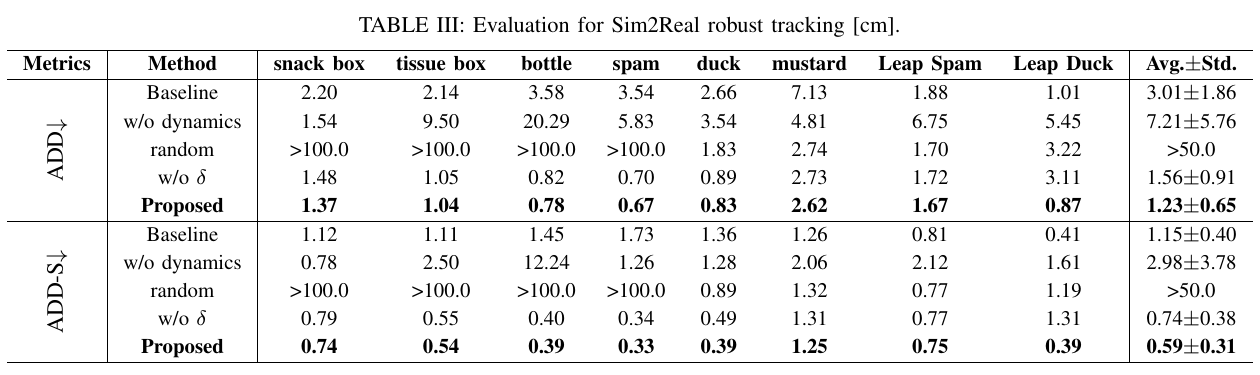 原论文 Table III:完整方法在 8 个组合上的平均 ADD / ADD-S 为 1.23 / 0.59 cm;随机物理在多个自由落体对象上超过 100 cm,说明错误物理比不用物理更危险。来源:TwinTrack 原论文。图片版权归论文作者所有,本站仅作学术解读展示。
| 方法 | 平均 ADD ↓ | 平均 ADD-S ↓ | 含义 |
|---|
| visual baseline | 3.01 ± 1.86 cm | 1.15 ± 0.40 cm | FoundationPose,使用同一组 keyframe |
| w/o dynamics | 7.21 ± 5.76 | 2.98 ± 3.78 | 视觉 + 常速度 prior |
| random physics | >50 | >50 | 未对齐物理会灾难性误导 |
| learned physics, w/o δ | 1.56 ± 0.91 | 0.74 ± 0.38 | 物性有效,碰撞几何仍偏 |
| 完整 TwinTrack | 1.23 ± 0.65 | 0.59 ± 0.31 | 物性 + 几何 residual |
需要同时说明三点:
- “w/o dynamics” 比纯 FoundationPose baseline 更差,表明不适合碰撞的常速度模型会拉偏估计。
- random physics 大量发散,说明自适应 fusion 不能替代 simulator alignment。
- ground truth 是先用 Scaniverse 离线获得高质量 textured mesh,再以 FoundationPose 产生的伪真值,不是外部 motion capture;结果可能与同族视觉估计器共享偏差。
8. 实时性
RTX 4090 / Ryzen 5955WX 上的单帧分解:
| 模块 | 时间 |
|---|
| SAM2 | 12 ms |
| SuperPoint | 8 ms |
| keyframe selection + LightGlue | 15 ms |
| neural-SDF contact 一步预测 | 5 ms |
| adaptive fusion | 5 ms |
| 其他 | 3 ms |
总计约 48 ms,即超过 20 Hz。这个数字指已拥有可用 Real2Sim 模型后的在线前端;论文没有把异步 GS 重建和 CEM 辨识摊入每帧 latency,也没有给出从首次观测到物理模型可靠所需的墙钟时间。
9. 局限与复现清单
- 初始化链式依赖:初始 pose 错误会导致 GS、SDF、接触位置与物性一起偏。
- 长时失明仍漂移:长时间无视觉时,只靠一步模型反复 rollout,model bias 会累积。
- 几何 residual 过于全局:标量 δ 不能修正只发生在某一面的凹凸误差。
- 单刚体限制:当前不能处理多对象互碰或可变形对象。
- 可观性:要为质量、摩擦、惯量设计包含滑动、碰撞、转动的 excitation;只在平面缓慢移动不足。
- 评测真值:复现时应增加 motion capture 或独立 marker-based GT,避免 FoundationPose 伪真值的共享误差。
- 不确定性传播:当前 wk 主要由匹配数决定;更完整的版本应同时估计视觉 covariance、物理参数 posterior 与接触 mode uncertainty。
- 开源状态:项目页提供论文、视频和演示,但截至本站整理时未发现完整代码仓库,因此不标为开源。
10. 可迁移启发
TwinTrack 给 6D pose 系统一个重要工程原则:物理模型不应作为永久正确的硬约束,而应成为一个经真实轨迹校准、带置信度进入融合器的传感器。视觉提供状态修正和几何初始化,接触提供视觉最弱时的运动证据;真正有效的是二者围绕误差和时间尺度的闭环,而不是简单把 physics loss 加进网络训练。
