论文精读笔记:Unsupervised Category-Level 3D Pose from Object-Centric Videos
1. 核心判断
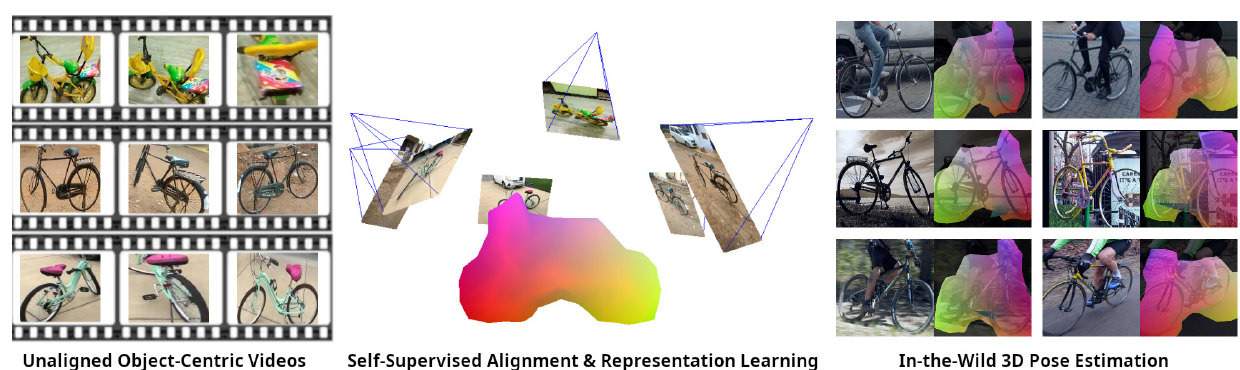
这篇论文解决的不是普通“无 pose label 训练一个回归器”,而是更基础的规范系缺失问题:同一类别的每段视频都有自己的 SfM 坐标,若不先把这些坐标对齐,模型无法知道“自行车朝前”在不同视频中应对应哪个方向。
作者将问题拆成:
instance neural mesh alignment :用几何、DINOv2 外观与 3D cycle consistency,把同类视频的粗重建放进统一 canonical frame;category neural mesh learning :在统一坐标中学习 viewpoint-invariant surface embeddings;single-image pose fitting :测试时以 template matching 初始化,再 render-and-compare 优化 rotation。
最重要的边界是:“无监督”不等于“无几何工具”。训练仍依赖 SfM、完整环绕视频、粗 mesh 和 differentiable rendering,只是不需要人工姿态、类别 CAD 或深度传感器。
2. 数据流与监督来源
原论文 Figure 1 的方法区域。训练时的多视图视频提供 SfM 几何与视角覆盖;对齐完成后,模型把这些知识蒸馏进类别 neural mesh 和单图 correspondence network。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
训练原料:
同一类别的多个 object-centric RGB videos;
off-the-shelf SfM 给每段视频相对 camera poses 与粗 point cloud;
点云经清理、watertight mesh 重建;
frozen DINOv2 给图像 patch feature。
不使用:
人工 pose labels;
类别或实例 CAD;
RGB-D camera;
PASCAL3D+ / ObjectNet3D 的姿态标签训练。
评测用的 CO3D GT alignment 来自 ZSP protocol,只用于算 Acc30 / Acc15。论文还必须人工规则过滤 SfM 失败或视角覆盖差的视频,因此数据选择本身仍是关键工程先验。
3. Neural mesh 表示
一个 neural mesh 写成:
S = { V , F } , V = { v i ∈ R 3 } , F = { { f i k ∈ R D } k = 1 ∣ F i ∣ } . S=\{V,F\},
\quad
V=\{v_i\in\mathbb R^3\},
\quad
F=\{\{f_i^k\in\mathbb R^D\}_{k=1}^{|F_i|}\}. S = { V , F } , V = { v i ∈ R 3 } , F = {{ f i k ∈ R D } k = 1 ∣ F i ∣ } . 每个 vertex 可以存多个 feature,因为 DINOv2 外观随观察视角变化。训练第一阶段时,作者将 mesh vertices 投影到每帧 DINOv2 feature map,把可见 patch feature 聚合到 vertex。这比只存平均 feature 更能保留 viewpoint-dependent appearance。
第二阶段的 category neural mesh 则学习 viewpoint-invariant vertex feature:任意视角中同一规范表面位置都应映射到相同 vertex prototype,才能从单图建立稳定 2D–3D correspondence。
4. 自监督跨实例对齐
给 source neural mesh S = ( V , F ) S=(V,F) S = ( V , F ) S ˉ = ( V ˉ , F ˉ ) \bar S=(\bar V,\bar F) S ˉ = ( V ˉ , F ˉ ) T T T
min T D geo ( V , V ˉ ) + D app ( S , S ˉ ) . \min_T
D_{\text{geo}}(V,\bar V)
+D_{\text{app}}(S,\bar S). T min D geo ( V , V ˉ ) + D app ( S , S ˉ ) . 几何项使用双向 Chamfer-like nearest-neighbor distance;外观项则按 DINOv2 feature nearest neighbor 找跨 mesh 对应。仅用几何会受 topology variation 与 symmetry 影响;仅用外观又会受到 patch ambiguity 和重建噪声影响。
4.1 3D cyclic distance
若 source vertex v i v_i v i v ˉ j \bar v_j v ˉ j v ˉ j \bar v_j v ˉ j v i ′ v_{i'} v i ′
d cycle ( v i , f i ) = ∥ v i − v i ′ ∥ 2 . d_{\text{cycle}}(v_i,f_i)=\|v_i-v_{i'}\|_2. d cycle ( v i , f i ) = ∥ v i − v i ′ ∥ 2 . 回到原点意味着 correspondence 较可靠。论文用 softmax temperature τ \tau τ
最终距离:
L ( S , S ˉ ) = ( 1 − α ) D geo \* + α D app \* . \mathcal L(S,\bar S)
=(1-\alpha)D_{\text{geo}}^\*
+\alpha D_{\text{app}}^\*. L ( S , S ˉ ) = ( 1 − α ) D geo \* + α D app \* . 作者取 α = 0.2 , τ = 100 \alpha=0.2,\tau=100 α = 0.2 , τ = 100
5. 从对齐视频到单图 pose
对齐后的所有视频提供同一 canonical frame。模型学习 image feature f i f_i f i f r f_r f r β \beta β
实现:
DINOv2 ViT-S/14,21M 参数;
输入 448×448,得到 32×32×384 feature;
第二阶段冻结 DINOv2,加三个 ResNet blocks;
最终 64×64×128 dense feature;
Adam,10 epochs;
单类别训练在 RTX 2080 上少于 1 小时。
推理时,先枚举预定义 camera poses,用 render-and-compare joint likelihood 选初始化;再通过 differentiable renderer 迭代更新 pose。允许前景像素由 background feature 解释,以减轻 clutter。
6. CO3D 对齐结果
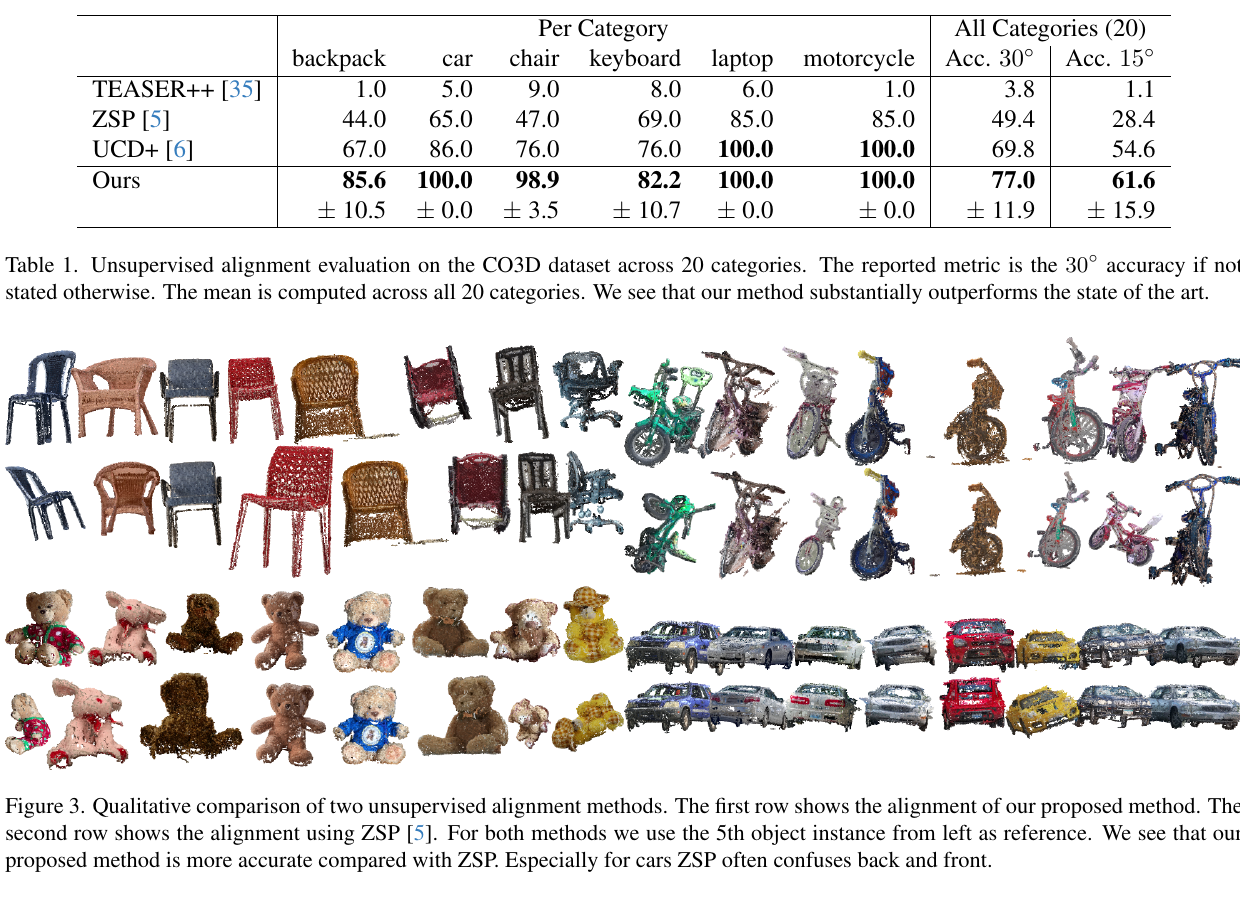
原论文 Table 1 与 Figure 3:上方是 20 类平均对齐准确率,下方将本文与 ZSP 的实例 mesh 对齐可视化;车辆前后混淆是 ZSP 的典型错误。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
方法 Acc30 Acc15 TEASER++ 3.8 1.1 ZSP 49.4 28.4 UCD+ 69.8 54.6 本文 77.0 61.6
每类随机选择五个 reference videos,报告 reference 变化下的均值与标准差。本文 Acc30 标准差 11.9,说明 canonical frame 仍受 reference choice 显著影响。对 laptop、motorcycle 达 100%,不代表所有 20 类都饱和;展示的六类是部分结果。
7. In-the-wild 单图结果
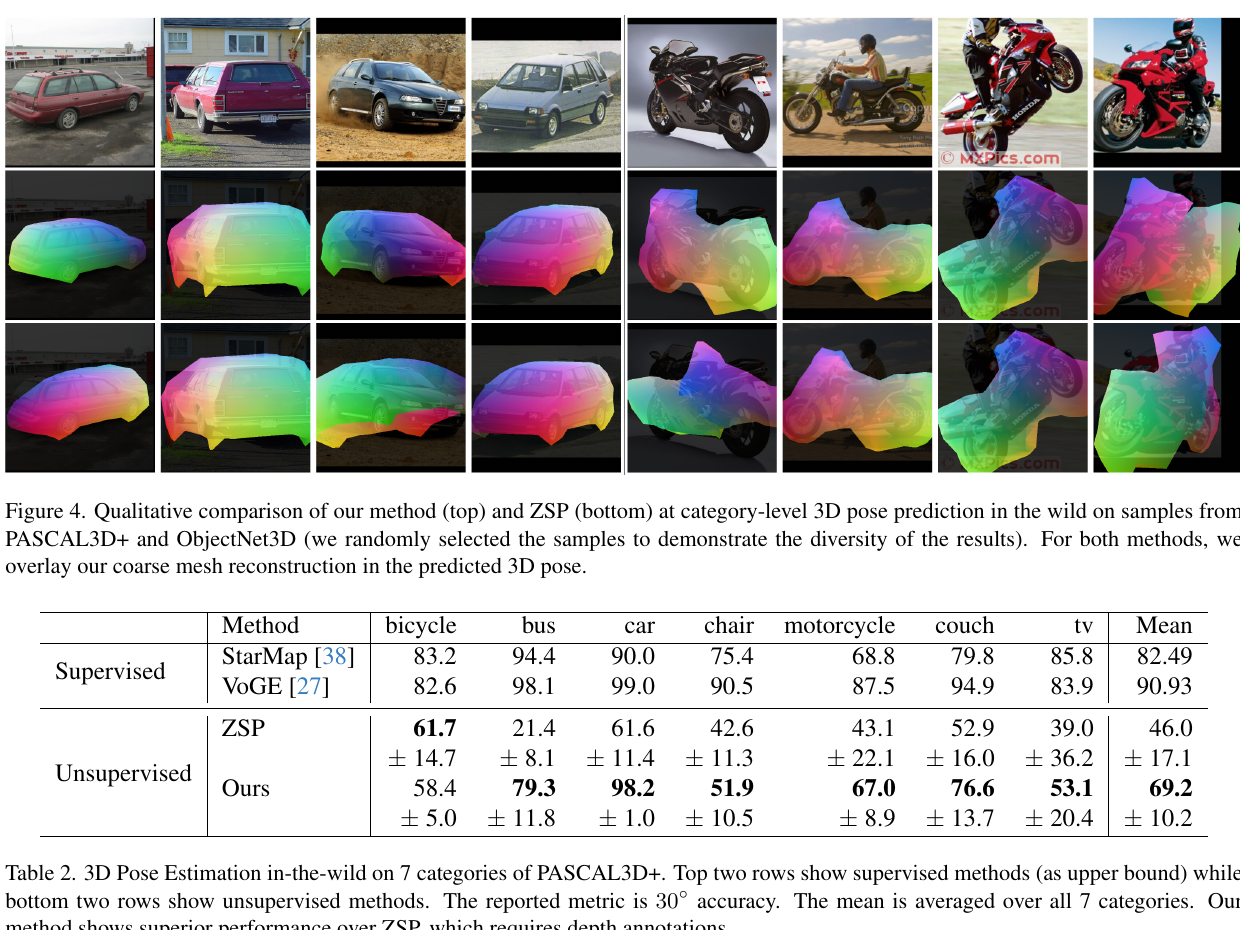
原论文 Figure 4 与 Table 2:彩色 coarse mesh 以预测旋转叠加到 PASCAL3D+ / ObjectNet3D 图像;表中 PASCAL3D+ 七类平均 Acc30 为 69.2。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
PASCAL3D+ 七类:
方法 监督 Acc30 StarMap pose labels 82.49 VoGE pose labels 90.93 ZSP reference depth / CAD / pose 46.0 本文 无人工 pose supervision 69.2
本文在 bicycle 上 58.4,略低于 ZSP 61.7;但 bus 79.3 vs 21.4、car 98.2 vs 61.6,提升很大。类别平均不能掩盖差异:拓扑稳定、视频多的 car / couch 更好,chair 等形变大的类别更难。
ObjectNet3D 20 类:
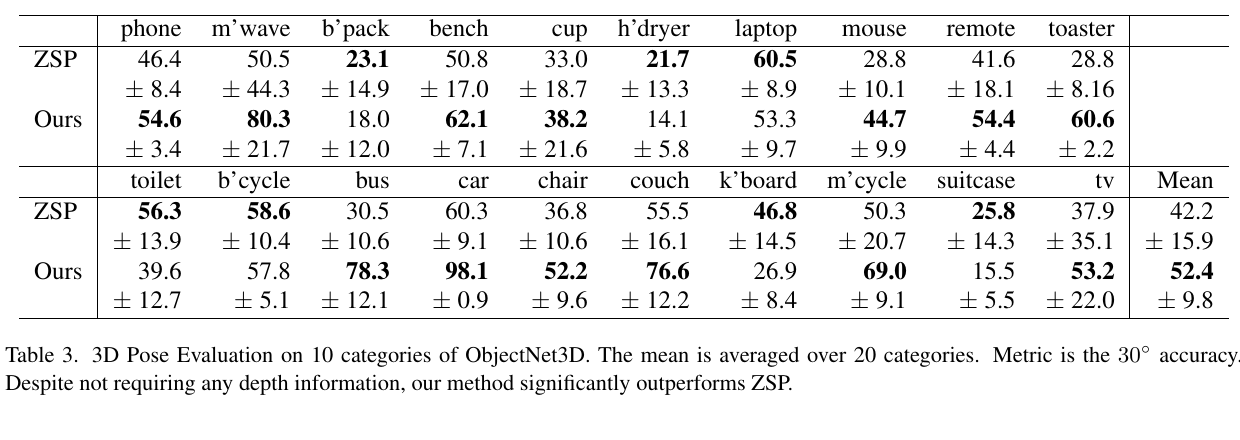
原论文 Table 3 的主体:ObjectNet3D 20 类平均 Acc30 为 52.4,ZSP 为 42.2;per-category 上 toilet、backpack、hairdryer 等并非本文占优,说明视频数量与拓扑差异仍是瓶颈。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
数据集 ZSP Acc30 本文 Acc30 本文 Acc15 PASCAL3D+ 46.0 69.2 41.3 ObjectNet3D 42.2 52.4 25.5
推理时间本文 0.22 s / sample,ZSP 10.92 s。该加速来自把多参考图匹配转成已学习的 category template,但 0.22 s 仍包含姿态初始化和 differentiable pose optimization,不是一次回归。
8. 为什么不用直接 rotation regression
论文比较同一 backbone 直接回归 6D rotation representation:
数据 直接回归 Acc30 / Acc15 Neural mesh Acc30 / Acc15 PASCAL3D+ 66.0 / 25.8 69.2 / 41.3 ObjectNet3D 44.5 / 16.4 52.4 / 25.5
Acc15 的提升比 Acc30 更明显,说明显式 surface correspondence + render-and-compare 对精细角度更有帮助。直接回归容易把对称与类别内变化压成平均方向。
9. 数据筛选与可复现性
CO3D 共约 1.5M frames、50 categories、19k scenes,但作者发现原始视频并不都适用:
视角变化太小导致 SfM 失败;
相机不围绕对象中心;
拍摄过近、缺少全物体几何。
目标每类 50 videos,remote 仅 17、mouse 15、TV 16、toilet 7 等。不同类别的数据量不均与 ObjectNet3D 低分直接相关。复现时过滤规则、mesh 清理、reference video 和 object centering 都可能比网络超参数更敏感。
10. 局限
刚性 category template 难以覆盖 chair 等大拓扑变化或可变形对象。
需要近 360° 视频和可用 SfM;透明、反光、弱纹理物体难重建。
canonical orientation 由随机 reference 定义,存在类别语义方向漂移。
测试假设 object-centered crop,未评估 detection / segmentation。
仍低于 fully supervised methods,尤其严格 Acc15。
论文正文未给出官方代码链接,工程复现成本高于开源方法。
11. 最终评价
该工作最值得借鉴的是 先解决训练数据坐标系,再学习 pose 。许多“无监督 pose”方法直接设计 equivariance loss,却忽略不同视频根本不共享 canonical frame;本文用 SfM 几何、DINOv2 外观和 cycle consistency 显式建立这个桥梁。
它没有消除采集与重建成本,而是用普通 RGB 视频替代昂贵人工 pose annotation 和 CAD。对于能采集环绕视频、但难标姿态的新类别,这是现实可行的折中;对于单张训练图、强拓扑变化或 SfM 不可靠的对象,仍需更弱监督或生成式 3D prior。