论文精读笔记:VAPO
1. 核心判断
VAPO 的关键观察不是“关键点网络还不够准”,而是:遮挡或自遮挡时,一部分预定义 3D 关键点在当前 RGB 图像中根本没有直接视觉证据。继续回归这些点会制造离群 3D–2D 对应,并把压力转嫁给 RANSAC / PnP。
论文因此把 pose pipeline 拆成两个决策:
当前视角下哪些关键点可见、哪些邻近点仍有定位价值;
只对重要点解码 2D 位置,再恢复 pose。
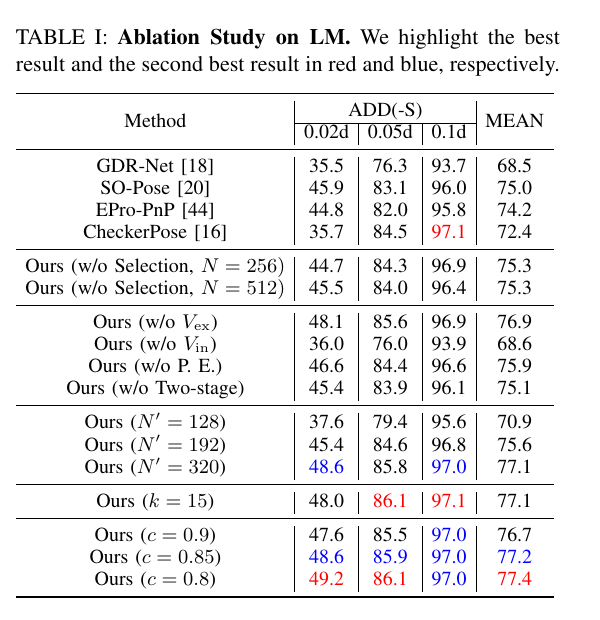
这比“固定取更少关键点”多了一个输入自适应的 visibility selection 问题。消融中固定选 256 或 512 点的均值都为 75.3,而默认动态选择达到 77.2,严格阈值 0.02d 从 44.7 / 45.5 提升到 48.6,证据与问题定义一致。
2. 任务边界与完整流程
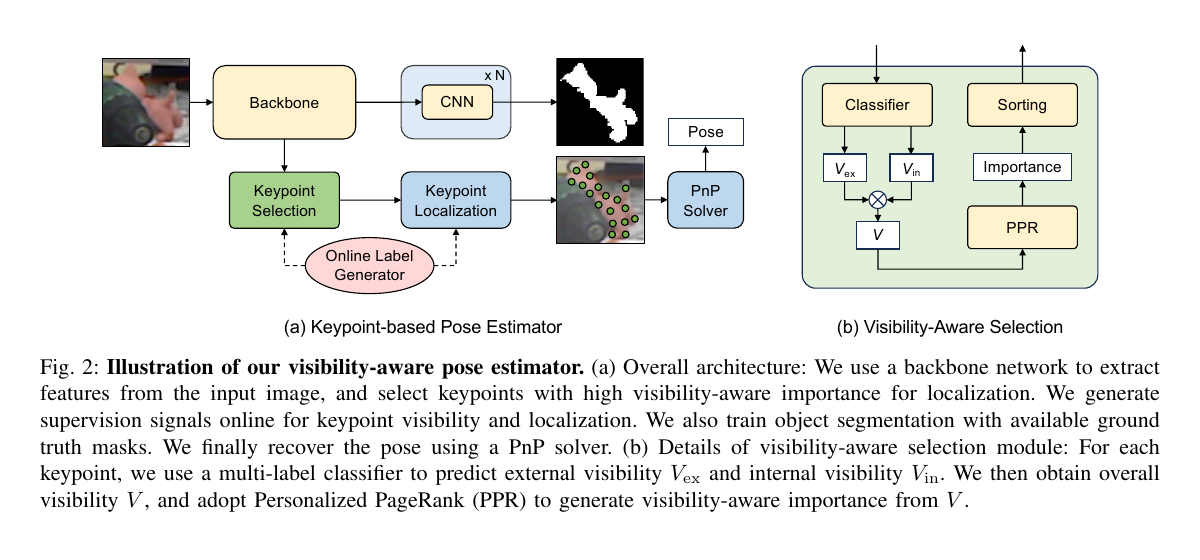
原论文 Figure 2。网络先预测对象 mask 和每个预定义关键点的内、外可见性,经 PPR 排序后只解码动态子图中的关键点,最后使用 PnP。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
VAPO 是 instance-level、RGB-only、训练对象已知 的绝对位姿方法。它以 CheckerPose 为关键点定位主干:
对检测得到的对象 RoI 提取图像特征;
预测 segmentation mask;
为 N = 512 N=512 N = 512
在对象固定的 k-NN 图上计算 PPR 重要度;
选前 N ′ = 256 N'=256 N ′ = 256
用 GNN 和二进制编码定位这些点的二维坐标;
Progressive-X 运行 400 次迭代,以 2 px 重投影阈值剔除离群点并恢复 pose。
“RGB-only”仅描述查询时的观测模态。系统仍需要相机内参、对象检测 / crop、对象几何和对象级训练数据。
3. 从对象级标注生成可见性监督
3.1 外部与内部可见性
对关键点 p p p
V ( p ) = V e x ( p ) V i n ( p ) . V(p)=V_{\mathrm{ex}}(p)V_{\mathrm{in}}(p). V ( p ) = V ex ( p ) V in ( p ) .
V e x V_{\mathrm{ex}} V ex p p p V i n V_{\mathrm{in}} V in d p ( c ) d_p^{(c)} d p ( c ) n p ( c ) n_p^{(c)} n p ( c ) d p ( c ) ⋅ n p ( c ) > 0 d_p^{(c)}\cdot n_p^{(c)}>0 d p ( c ) ⋅ n p ( c ) > 0
内部判据近似图形学 back-face culling,计算便宜,不做逐射线遮挡检测。对于凸表面通常合理;对孔洞、凹陷或被同一物体其他部分挡住的点,它可能把“法向朝向相机”误当成“真正可见”。
作者预先采样 CAD 表面关键点和法向,训练时结合真值 pose、mask 在线生成标签,避免人工关键点可见性标注。
3.2 对称对象为何需要重新规范 pose
一个对称物体的同一图像可对应多个等价旋转。数据集只保存其中一个 pose;如果直接用标注 pose 生成内部可见性,外观相近样本可能得到不同标签,visibility classifier 会面对自相矛盾的监督。
作者从等价 pose 中选取一个规范表示,使固定关键点子集 P s y m P_{\mathrm{sym}} P sym
离散对称:离线在 2,562 个 SO(3) 采样旋转中寻找稳定子集,训练时枚举有限等价变换;
单连续对称轴:把等价旋转写成绕轴角 θ \theta θ ( R ⊤ t ) ⊤ n p (R^\top t)^\top n_p ( R ⊤ t ) ⊤ n p
连续对称再叠加离散对称:先解析消除连续歧义,再枚举离散等价项;
多连续轴:按轴依次应用同类推导。
这一步是在 统一标签规范 ,不是恢复不可观测的对称角度;最终 benchmark 仍需用 symmetry-aware ADD(-S) 评价。
4. 从二值可见性到 PPR 重要度
仅选二值可见点也不够稳:mask 或法向标签可能出错,且位于可见区域邻域的点即使自身标签为 0,也可能有足够局部图像证据。VAPO 在固定 3D 关键点集合上建立有向 k-NN 图,默认 k = 20 k=20 k = 20
把可见点上的均匀概率作为 restart vector s s s
r = c T ⊤ r + ( 1 − c ) s , r = ( 1 − c ) ( I − c T ⊤ ) − 1 s . r=cT^\top r+(1-c)s,
\qquad
r=(1-c)(I-cT^\top)^{-1}s. r = c T ⊤ r + ( 1 − c ) s , r = ( 1 − c ) ( I − c T ⊤ ) − 1 s . 默认 damping factor c = 0.85 c=0.85 c = 0.85
T p p r = ( 1 − c ) ( I − c T ⊤ ) − 1 T_{\mathrm{ppr}}=(1-c)(I-cT^\top)^{-1} T ppr = ( 1 − c ) ( I − c T ⊤ ) − 1 可以离线预计算,在线只需用预测 visibility 构造 s s s r r r
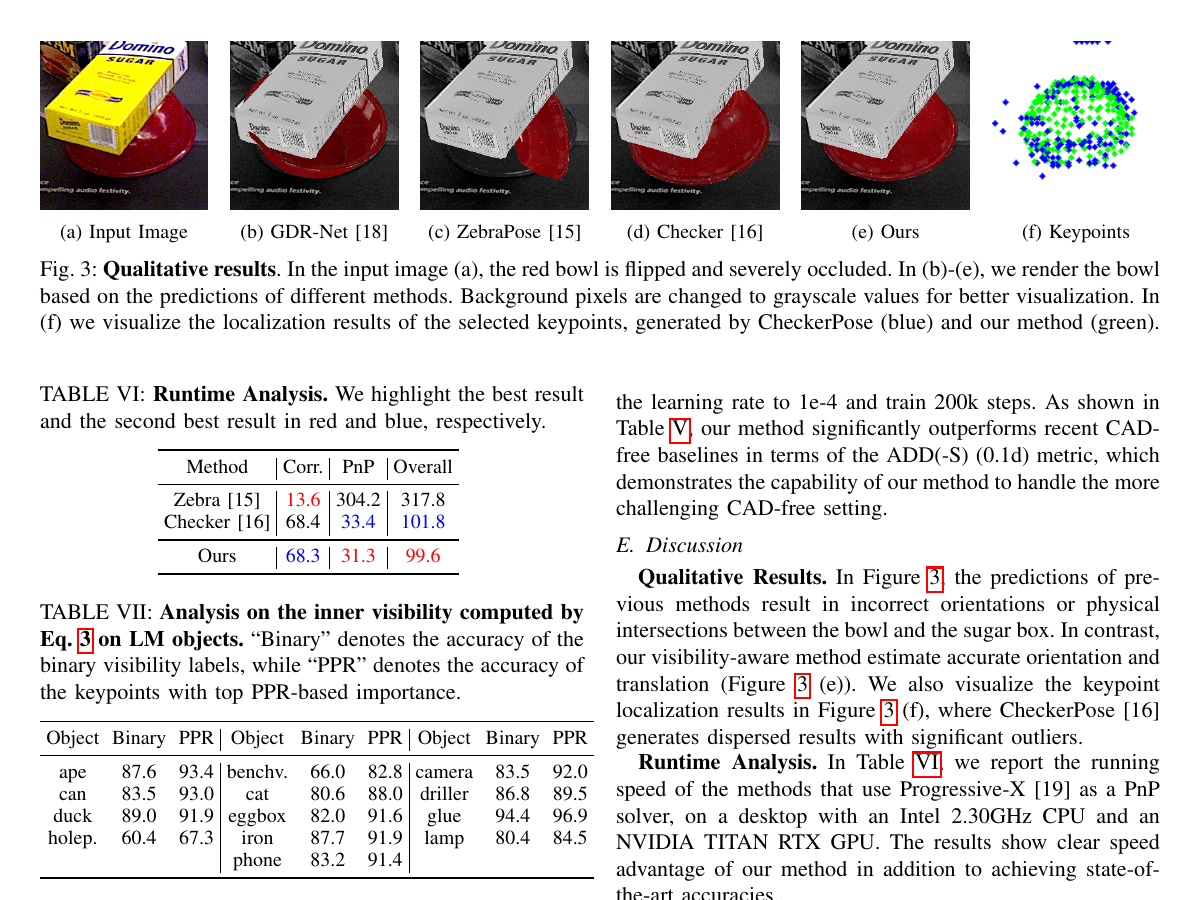
PPR 的作用不是估计真实光线可见率,而是把脆弱的 0/1 标签平滑成排序信号。Table VII 也显示:以 ray tracing 标签为参照,简单内部可见性在 holepuncher / benchvise 上只有 60.4% / 66.0%,但 PPR 选出的高重要度点准确率为 67.3% / 82.8%。
5. 动态子图如何接入 CheckerPose
选择前 256 个点后,GNN 的节点集合会随图像变化。若 visibility predictor 尚未收敛,训练早期的子图不断跳变,关键点定位分支很难稳定学习。VAPO采用:
64D 位置编码:由关键点 3D 坐标通过浅层 GNN 产生,与原关键点 embedding 拼接;
两阶段训练:第一阶段只训练外部 / 内部可见性、1-bit indicator 和二维二进制坐标的前几个编码位;第二阶段再训练完整网络;
visibility 和 binary code 使用 BCE,segmentation mask 使用 L 1 L_1 L 1
LM 消融中,去掉位置编码均值从 77.2 降至 75.9;去掉两阶段训练降至 75.1。两项差距不算巨大,但都针对动态子图带来的训练不稳定。
6. CAD-free 扩展究竟去掉了什么
没有精确 CAD 时,作者用 Wonder3D 从 m = 8 m=8 m = 8 N / m N/m N / m
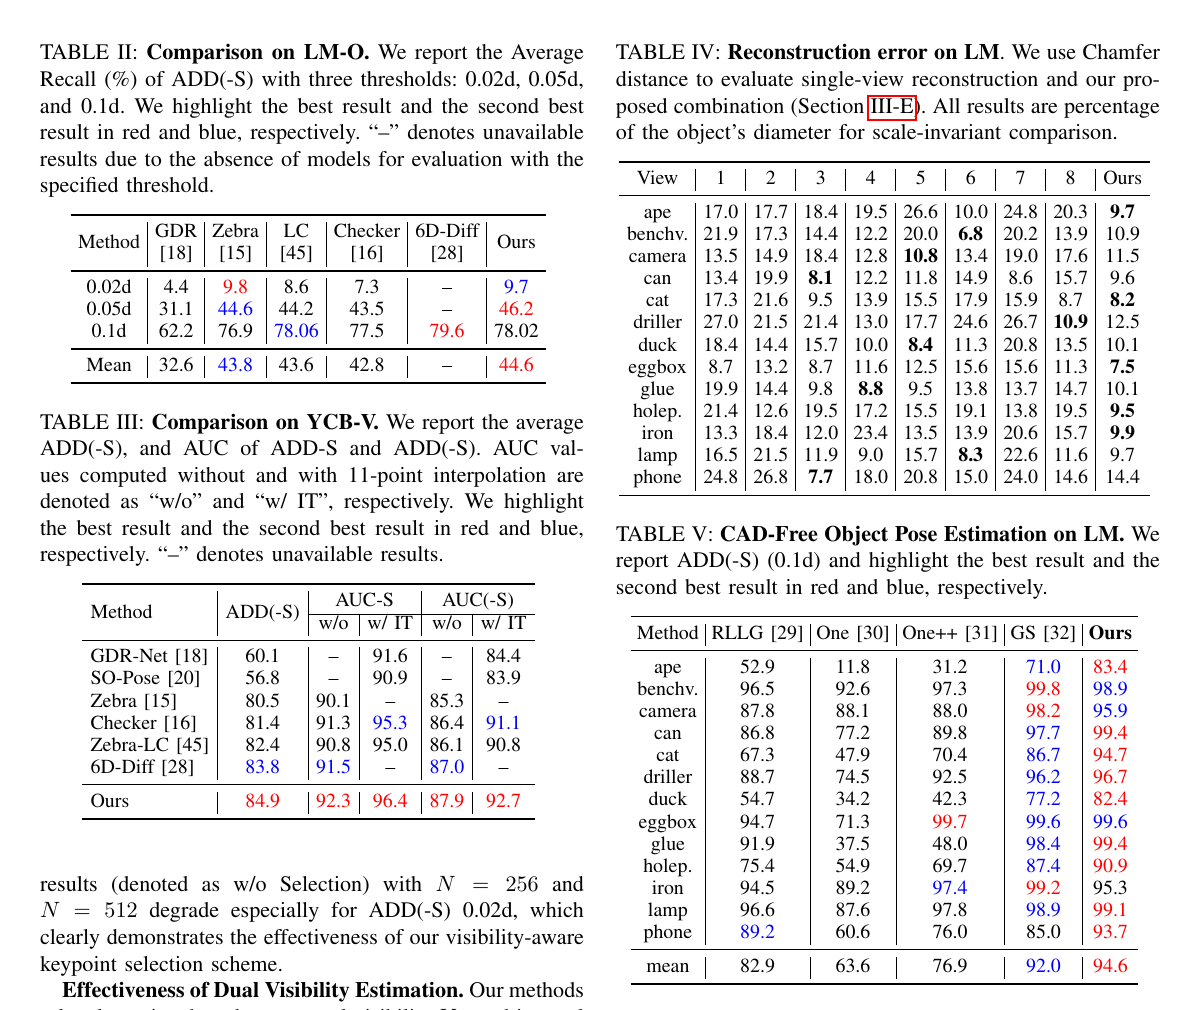
原论文 Table II–V。左侧为 LM-O / YCB-V,右上量化单视图与多视图组合重建误差,右下为 CAD-free LM 的 ADD(-S)@0.1d。来源:作者公开稿 ;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
合并可见表面减少了单一重建视角缺失背面的风险。LM 的尺度归一化 Chamfer error 中,组合结果在 13 个对象里有 6 个最优,并非每个对象都优于最佳单视图;它的价值是降低选错参考视角的敏感性。
这里的 CAD-free 不等于 reference-free 或 zero-shot:
仍需 8 张对象参考图并离线重建;
仍为 LM 13 个已知实例训练统一 pose estimator;
仍需要对象 mask / pose 监督与相机内参;
如果没有对称性先验,作者直接假设所有对象非对称。
7. LINEMOD 消融
原论文 Table I。默认报告行为 \(N'=256,k=20,c=0.85\),三阈值均值 77.2;表中 \(c=0.8\) 得到最高均值 77.4,但默认配置使用更常见的 0.85。来源:作者公开稿 ;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
配置 0.02d 0.05d 0.1d 均值 固定 256 点,无选择 44.7 84.3 96.9 75.3 固定 512 点,无选择 45.5 84.0 96.4 75.3 去掉外部可见性 V e x V_{\mathrm{ex}} V ex 48.1 85.6 96.9 76.9 去掉内部可见性 V i n V_{\mathrm{in}} V in 36.0 76.0 93.9 68.6 默认 c = 0.85 c=0.85 c = 0.85 48.6 85.9 97.0 77.2 c = 0.8 c=0.8 c = 0.8 49.2 86.1 97.0 77.4
LM 外部遮挡较轻,所以去掉 V e x V_{\mathrm{ex}} V ex V i n V_{\mathrm{in}} V in
关键点数量从 128→192→256 时均值 70.9→75.6→77.2;增到 320 为 77.1,说明 256 附近已经饱和,继续增加定位预算无明显收益。
8. 基准结果该如何读
8.1 LM-O
VAPO 的 ADD(-S) recall:
方法 0.02d 0.05d 0.1d 三阈值均值 CheckerPose 7.3 43.5 77.5 42.8 VAPO 9.7 46.2 78.02 44.6
相对主干的提升集中在更严格阈值:+2.4 / +2.7 / +0.52。6D-Diff 在 0.1d 为 79.6,但没有报告 0.02d、0.05d,不能与三阈值均值直接比较。
8.2 YCB-V
VAPO 的 ADD(-S) 为 84.9;AUC-S 不带 / 带 11 点插值为 92.3 / 96.4,AUC(-S) 为 87.9 / 92.7。CheckerPose 分别为 81.4、91.3 / 95.3、86.4 / 91.1。改进存在,但幅度约 1–3.5 个点,不应写成压倒性领先。
8.3 CAD-free LM
ADD(-S)@0.1d 的 13 对象均值:
RLLG:82.9
OnePose:63.6
OnePose++:76.9
GS-Pose:92.0
VAPO:94.6
该比较只覆盖 LM、0.1d 一个阈值,并使用 VAPO 自己的 8 视角 Wonder3D 表示;它证明 CAD 替代路线可用,不足以证明跨数据集 zero-shot 泛化。
9. 定性、速度与非凸物体
原论文 Figure 3 与 Table VI–VII:严重遮挡 bowl 案例中,VAPO 的关键点更集中且 CAD overlay 更合理;表格同时给出 TITAN RTX 运行时间和法向近似可见性的误差。来源:作者公开稿 ;图片与表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
作者展示一个红碗被糖盒遮挡的成功案例:CheckerPose 的蓝色点更分散,VAPO 绿色点集中在可见区域,预测 CAD 没有明显穿插。该图只有一个作者选择案例,不能替代按遮挡率分桶的定量实验。
在 NVIDIA TITAN RTX 与 Intel 2.30 GHz CPU 上:
方法 correspondence PnP 总计 ZebraPose 13.6 ms 304.2 ms 317.8 ms CheckerPose 68.4 ms 33.4 ms 101.8 ms VAPO 68.3 ms 31.3 ms 99.6 ms
VAPO 相比 CheckerPose 只快 2.2 ms;“efficient”主要指不解码全部关键点仍维持约 10 FPS,而不是网络阶段数量级加速。跨 ZebraPose 比较时,PnP 后端行为占主导。
10. 局限与风险
论文结论明确把“没有对象级标注时如何高效生成 visibility 标签”和“扩展到 zero-shot pose”留作未来工作。结合实验还有:
内部可见性没有 ray tracing,非凸遮挡只靠法向近似;
外部可见性依赖对象 mask,检测 / 分割错误会同步污染关键点排序;
对称规范需要已知 symmetry transforms,CAD-free 未知对称时假设非对称;
已见实例训练,不支持输入一个新 CAD 就直接推理;
只在 LM、LM-O、YCB-V 旧基准验证,未给 BOP AR、T-LESS 强对称工业件或跨域结果;
RoI detector 时间没有计入 Table VI,99.6 ms 不是完整场景级感知延迟;
PPR 基于欧氏 k-NN,不一定沿物体真实表面测地线连接,薄片或相邻但不连通表面可能产生跨面边;
没有按遮挡比例、mask 质量或关键点 visibility calibration 报告分层结果。
11. 复现检查表
明确 512 个关键点的表面采样、法向方向和坐标单位;
核对 pose 方向、投影、mask 边界和 d p ( c ) ⋅ n p ( c ) d_p^{(c)}\cdot n_p^{(c)} d p ( c ) ⋅ n p ( c )
复现离散 / 连续对称的规范 pose,而不是只在评价时用 ADD-S;
固定 k-NN 图方向、k = 20 k=20 k = 20 c = 0.85 c=0.85 c = 0.85
复现 64D 位置编码、前 256 点诱导子图和低可见点数量时的均匀退化策略;
严格执行两阶段训练;记录 LM、LM-O、YCB-V 各自训练步数和统一 / 分对象模型差异;
Progressive-X 使用 400 iterations、2 px threshold;
CAD-free 复现 8 视角 Wonder3D、每视角 N / 8 N/8 N /8
分开记录 detector、network、PPR、correspondence 和 PnP 时间。
12. 最终评价
VAPO 是一篇问题切口清楚的关键点 pose 论文:它不把不可见关键点当成普通回归噪声,而是显式生成可见性监督,再用 PPR 将局部不可靠标签转成可排序的重要度。最有说服力的证据是内部可见性消融与严格 pose 阈值提升;最需要保留的边界是它仍是已知实例、依赖对象级标注与几何先验的方法,CAD-free 也不是 zero-shot。