论文精读笔记:ViTa-Zero: Zero-Shot Visuotactile Object 6D Pose Estimation
1. 研究定位
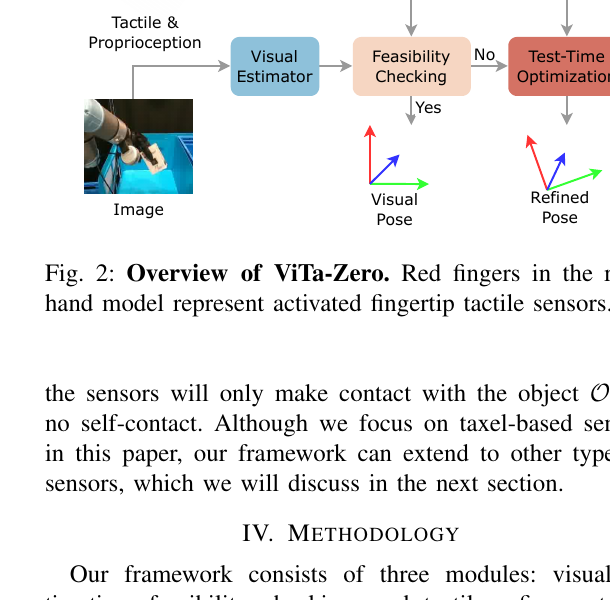
ViTa-Zero 不是从头训练新的视觉—触觉网络,而是一个 test-time pose correction layer:
T^vfeasibility check{T^v,TTO(T^v,C,H),feasibleinfeasible
其中 T^v 来自 FoundationPose 或 MegaPose,C 是 tactile contacts,H 是机器人手和运动学几何。
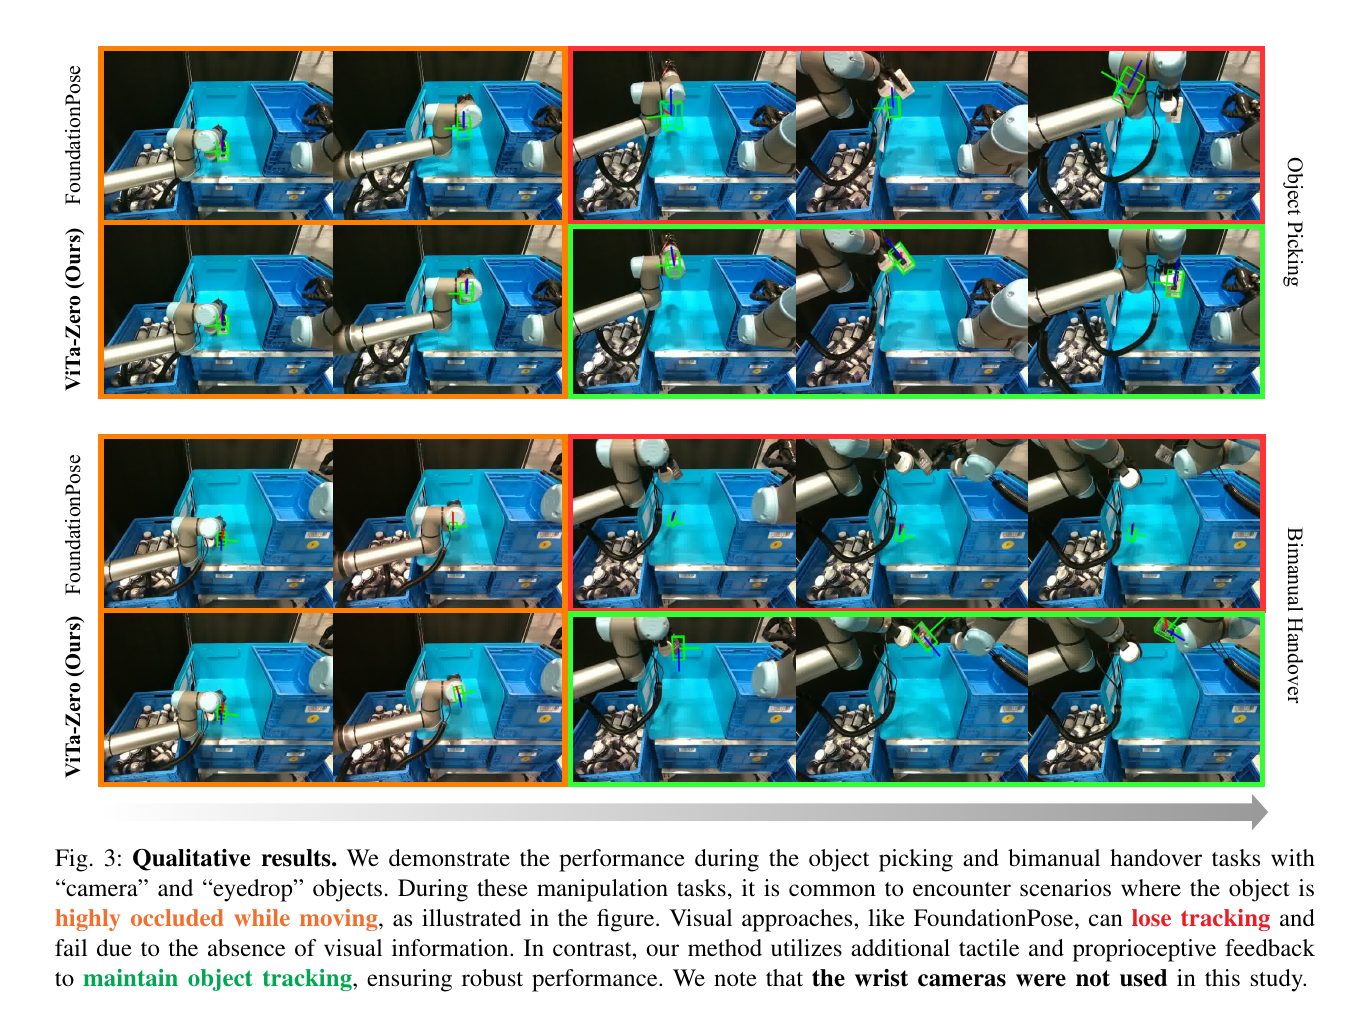 原论文 Figure 3:视觉结果在遮挡下会漂移或穿入手部,触觉—运动学约束将对象模型修正到与真实接触更一致的位置。来源:作者公开 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
2. 三类 feasibility constraints
被触发 taxel 应靠近对象表面。可定义吸引残差:
econtact=p∈C∑d(p,TM)2,
其中 M 为对象 mesh。
2.2 Penetration
对象不应穿过机器人手实体。对发生碰撞的点施加 repulsive force / penalty。只用 contact attraction 会把模型吸进手内,因此 penetration 是不可缺少的负约束。
2.3 Kinematic consistency
taxel 和 link 的空间位置由 forward kinematics 决定。机器人关节状态将接触证据变成统一坐标下的几何约束,也可限制不合理的跨帧跳变。
3. Spring–mass test-time optimization
论文把对象 pose 看成受虚拟弹簧作用的刚体:
- 接触点与对象表面之间产生吸引;
- 穿透区域产生排斥;
- L2 regularization 防止偏离视觉初值过远。
这不是纯 ICP:ICP 只寻找最近表面对齐,可能把接触点吸到错误表面,也不理解手部不可穿透。完整 loss 同时使用正、负接触与视觉 prior。
4. 实验平台与任务
- 两台 UR5e;
- Ability Hands;
- Intel RealSense D455 / L515;
- 5 个训练未见日常对象;
- 单臂 picking 与双臂 handover;
- RGB-D backbone FoundationPose,RGB backbone MegaPose。
测试对象少,结果主要证明方法可行性,而非覆盖广泛材质、形状和抓持模式。
5. 定量结果
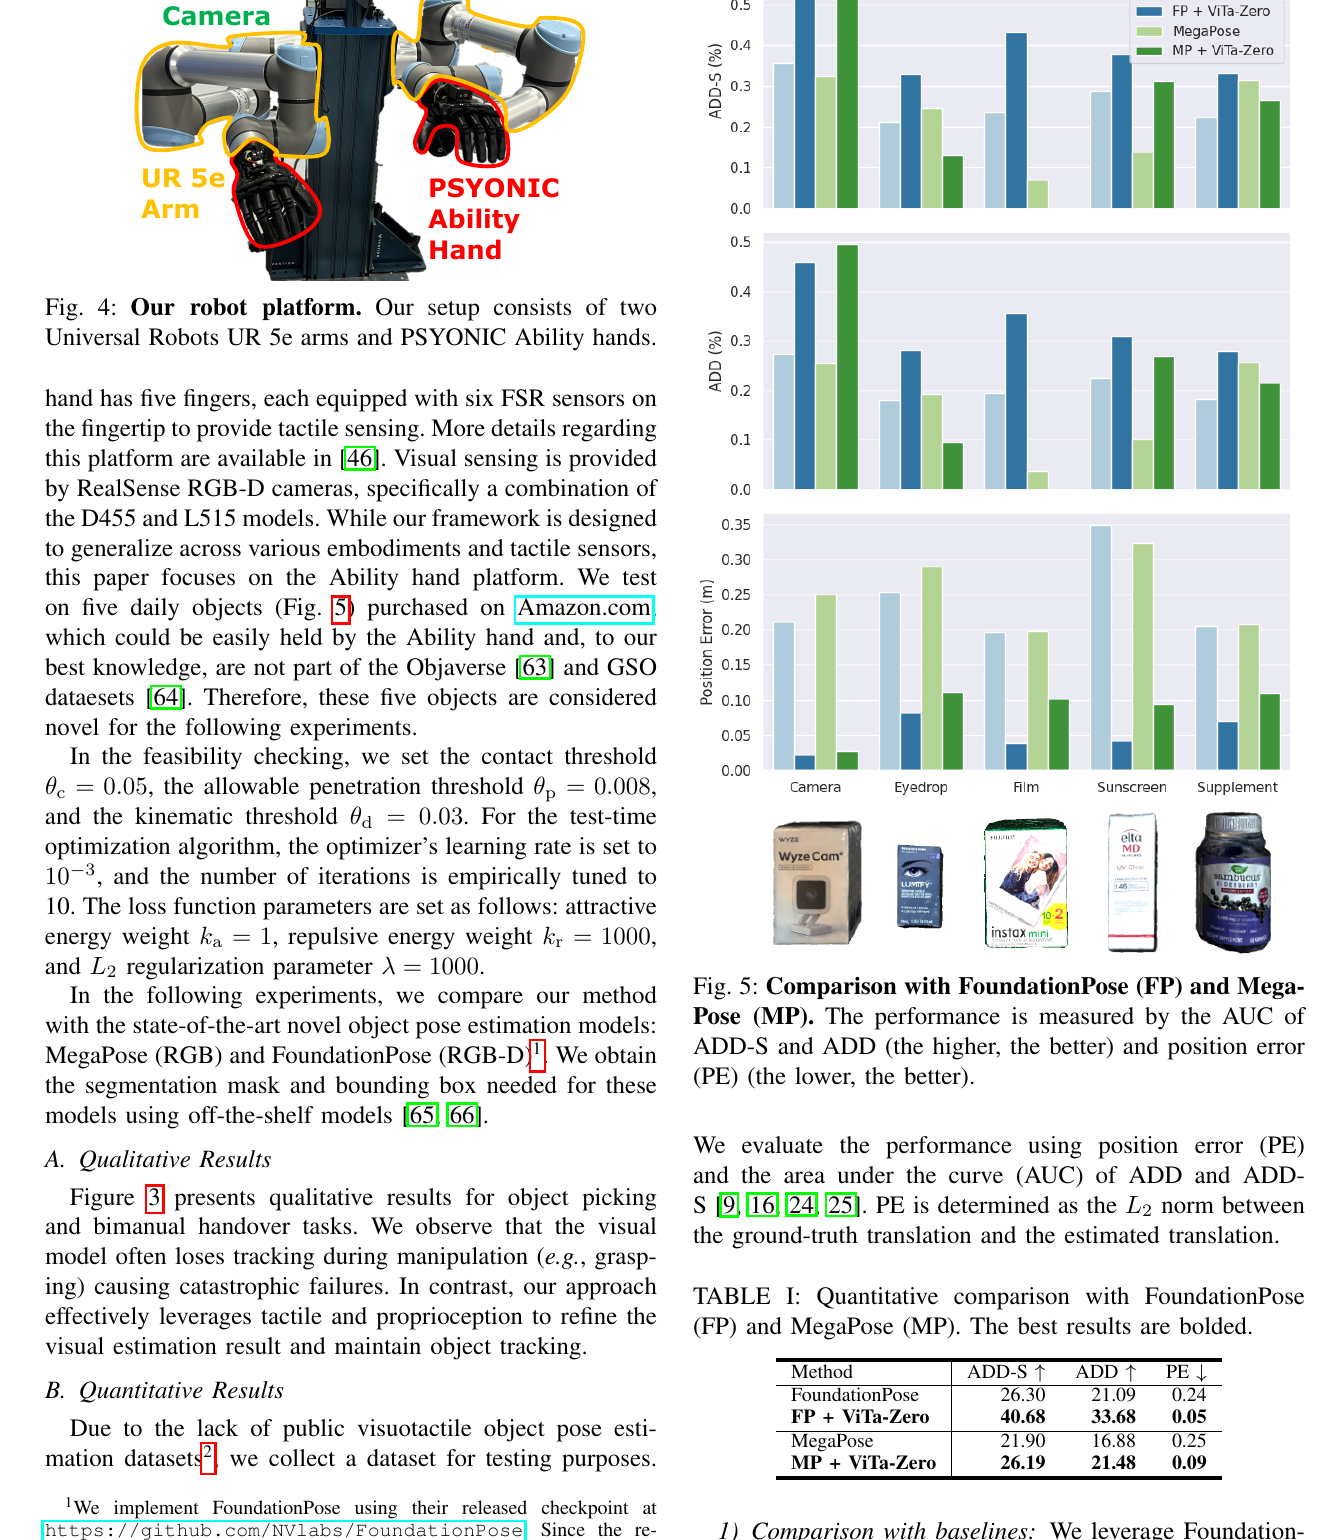 原论文 Figures 4–5 / Table I:机器人平台、五个对象上两种视觉 backbone 的 ADD-S / ADD AUC 与 position error,以及总体结果;该裁图不含物理 loss 消融或任务时序,相关正文另据原表 / Figure 3。来源:作者公开 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 方法 | ADD-S AUC ↑ | ADD AUC ↑ | PE ↓ |
|---|
| FoundationPose | 26.30 | 21.09 | 0.24 |
| FoundationPose + ViTa-Zero | 40.68 | 33.68 | 0.05 |
| MegaPose | 21.90 | 16.88 | 0.25 |
| MegaPose + ViTa-Zero | 26.19 | 21.48 | 0.09 |
FoundationPose 的收益更大,可能因为 RGB-D 初值已接近正确 basin,触觉优化更容易收敛;也可能与两种 backbone 的误差分布不同有关,不能简单推断 ViTa-Zero 只适合 FoundationPose。
完整 loss 达 40.68 / 33.68 / 0.05。普通 ICP 为 28.37 / 23.64 / 0.05:两者 position error 相同,但完整方法的表面对齐 AUC 更高,说明仅修正中心位置还不足以恢复 rotation 与完整几何一致性。
6. 运行速度
| 模块 | 时间 | 频率 |
|---|
| Pose tracking | 0.011 s | 90.9 Hz |
| Feasibility check | 0.006 s | 166.7 Hz |
| TTO | 0.051 s | 19.6 Hz |
系统瓶颈是 test-time optimization。作者在 i9-14900K / RTX 4090 上、视觉精修两次与 TTO 十次时报告在线刷新约 20 Hz;Table V 只列模块时间,不能把单项 TTO 频率直接等同于串行完整闭环频率。可行 pose 不触发 TTO 时可以更快,部署时仍需测量整体调度与端到端延迟。
7. “Zero-shot”的准确含义
- 不对五个测试对象训练 visuotactile network;
- 复用 FoundationPose / MegaPose 的 novel-object 能力;
- 测试时仍需对象 CAD 或重建模型;
- 仍需机器人 forward kinematics、hand geometry 与 tactile calibration;
- 测试时有迭代优化,所以不是 zero-computation adaptation。
8. 局限
- CAD / reconstructed model 误差会使 contact 与 penetration loss 产生系统偏差。
- 软物体、软指尖和 compliant grasp 不符合刚性 spring–mass 假设。
- 触觉接触稀疏时,某些 rotation 仍不可观测。
- 五对象验证规模较小。
- 作者项目页说明代码与数据因公司政策不能公开,复现门槛较高。
9. 精读结论
ViTa-Zero 展示了一种很实用的组合方式:视觉 foundation model 负责全局初始化,触觉与机器人几何只负责把结果投影回物理可行集合。它没有承诺触觉独立识别物体,而是把接触当作测试时约束。主结果和 ICP 对比说明,真正的收益来自 contact + penetration + prior 的联合建模,而非简单最近点对齐。