论文精读笔记:WALDO: Where Unseen Model-based 6D Pose Estimation Meets Occlusion
1. 基本信息
简称 :WALDO作者 :Sajjad Pakdamansavoji、Yintao Ma、Amir Rasouli、Tongtong Cao机构 :Huawei Technologies Canada会议 :WACV 2026正式论文页 :CVF Open Access 公开预印本 :arXiv:2511.15874 阅读模式 :精读
2. 先给结论
WALDO 的真正贡献是把“遮挡”从一种笼统的数据困难,拆成多阶段 model-based pipeline 中可被建模的四个对象:前端 mask 误差、点级不可见概率、初始 pose 多解、以及 benchmark 对高可见样本的统计偏置。它沿用检测—模板—点匹配—SVD 的主干,却让 coarse matching 同时输出多个 pose hypotheses 和逐点背景 / 遮挡概率,再以这些概率重分配 dense matching 预算,并反复细化候选。
论文的主要结果可以压缩成三句话:
相对主要 baseline SAM6D,BOP-Core* 的 UAR / AR 从 0.54 / 0.71 提到 0.56 / 0.73 ,单图耗时从 4.37 s 降到 1.53 s ;
收益集中在遮挡更强的 ICBIN(UAR 0.50→0.56)与 YCB-V(0.52→0.56),TUD-L 无 UAR 改善;
WALDO 仍低于 FRTPose 的 0.70 UAR、FreeZe 的 0.66 和 Co-op 的 0.61,因此它的优势是速度—遮挡鲁棒性折中 ,不是“全面刷新最高精度”。
精读时还必须保留以下边界:
测试需要 RGB-D observation、对象 CAD / mesh、模板渲染与相机信息;
BOP-Core* 是本文选择的五个集合,不是完整 BOP benchmark 的同义词;
UAR 是作者新定义的可见度等权聚合,不能和官方 AR 混为一个指标;
论文摘要的 “2% / 5% improvement”对应 UAR 的绝对 point 差,例如 0.54→0.56、0.50→0.56;
公开版本没有给出可核验的官方代码链接,多个基础模块的版本和复现接口仍需自行拼接。
2.1 证据矩阵
论文主张 主要证据 能证明什么 不能证明什么 更适合遮挡 ICBIN UAR +0.06、YCB-V +0.04;逐可见度 UAR 相对 SAM6D,在本文五集合协议下低可见条件更稳 对所有传感器、所有遮挡类型都泛化 更快 4.37→1.53 s / image;相对 FRTPose 45.37 s 当前实现表中报告的每图推理延迟更低 硬件无关、能耗更低或所有 batch 设置都更快 动态采样有效 LMO UAR 0.49→0.50 可见性引导 sampling 有小幅增益 它是总体 +0.02 的唯一来源或主导来源 多假设有效 K = 1 K=1 K = 1 K = 8 K=8 K = 8 适中的候选数能提高 LMO UAR 候选越多越好;K = 32 K=32 K = 32 迭代细化有效 N = 1 N=1 N = 1 N = 32 N=32 N = 32 足够深的 refinement 最终超过单步 每一轮都改善;N = 2 , 4 N=2,4 N = 2 , 4 普通 AR 乐观 WALDO BOP-Core* AR 0.73、UAR 0.56 高可见样本主导普通平均,分层结果更保守 UAR 是唯一合理的实际风险权重
3. 任务边界与符号
3.1 输入
对于一个测试实例,系统需要:
观测 RGB 图 I o I_o I o
观测 depth D o D_o D o
对象 CAD / mesh;
从 V V V I m v v = 1 V {I_m^v}_{v=1}^{V} I m v v = 1 V
相应模板 depth D m v v = 1 V {D_m^v}_{v=1}^{V} D m v v = 1 V
相机内参;
前端检测 / 分割模型与训练好的特征、匹配网络。
观测 mask 只覆盖当前可见部分,形成 partial point cloud P o P_o P o P m P_m P m
3.2 输出
最终输出刚体变换:
( R f , t f ) , R f ∈ S O ( 3 ) , t f ∈ R 3 , (R_f,t_f),\qquad R_f\in SO(3),\quad t_f\in\mathbb{R}^3, ( R f , t f ) , R f ∈ S O ( 3 ) , t f ∈ R 3 , 把对象模型坐标系对齐到相机 / 观测坐标系。论文属于实例级、测试对象未参与训练、但测试时提供模型的 model-based novel-object setting。
3.3 “Unseen”不等于“无对象先验”
WALDO 没有为每个测试对象重新训练 pose network,但它拥有完整 CAD,并可在推理前渲染多视角 RGB-D。其泛化难点是模型需从训练资产迁移到新几何,而不是在没有对象形状信息时猜测 pose。
这与三类任务应区分:
model-free:只提供少量 reference images / video;
category-level:测试实例属于训练类别,使用类别形状先验;
open-vocabulary detection:只根据文本 / 类别定位对象,不保证完整 6D pose。
4. 遮挡如何在 pipeline 中传播
将系统写成:
( I o , D o , M ) → detect/segment ( B o , S o ) → feature+lifting ( F o , P o ; F m , P m ) → coarse { R k , t k } → dense refine ( R f , t f ) . (I_o,D_o,M)\xrightarrow{\text{detect/segment}}
(B_o,S_o)\xrightarrow{\text{feature+lifting}}
(F_o,P_o;F_m,P_m)\xrightarrow{\text{coarse}}
\{R_k,t_k\}\xrightarrow{\text{dense refine}}(R_f,t_f). ( I o , D o , M ) detect/segment ( B o , S o ) feature+lifting ( F o , P o ; F m , P m ) coarse { R k , t k } dense refine ( R f , t f ) . 遮挡会在每个箭头处产生不同错误:
检测 / 分割 :漏掉可见碎片、把遮挡物包含进 mask;特征 lifting :背景 pixel 被绑定到错误 3D 点,模型不可见区域没有对应证据;coarse matching :局部几何 / 纹理造成多个合理对齐,只选一个会过早塌缩;dense matching :均匀在完整模型取点,把预算浪费在不可见表面;评价 :高可见样本多时,低可见失败在总平均中被稀释。
WALDO 的设计与五个问题近似一一对应,这比把“robustness”只归因于某个 backbone 更容易审计。
5. 总体架构
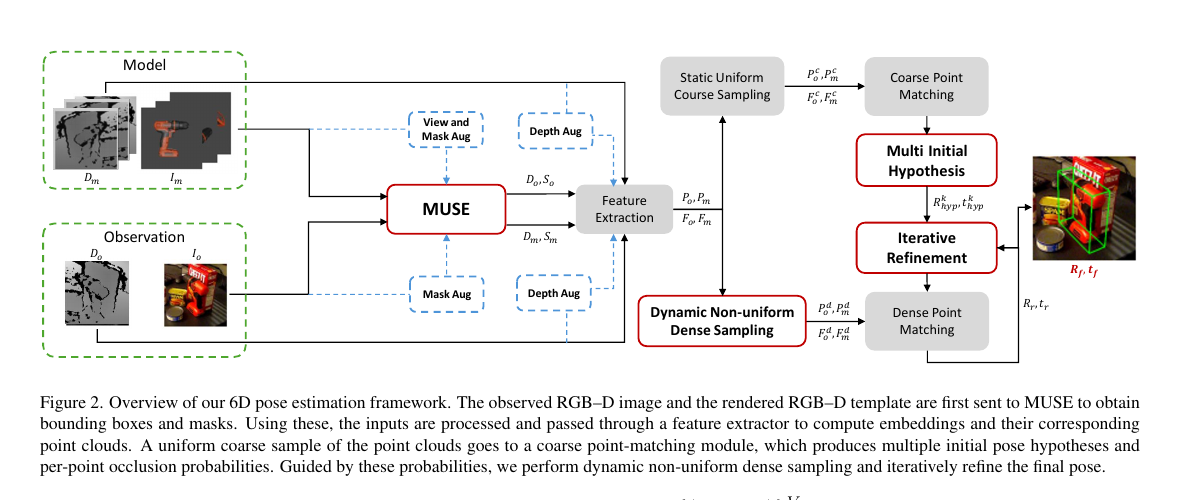
原论文 Figure 2:黑色实线是推理主路径,蓝色虚线表示训练期 view / mask / depth augmentations。coarse matching 不只给 pose,还产生 occlusion / background probabilities;这组概率连接 coarse 和 dense 两阶段。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
整体可分为:
MUSE 负责 3D-aware detection / segmentation;
ViT 抽取多层 features,depth 将 pixel features 提升到点云;
coarse point matching 产生 soft assignments、遮挡概率和多个初值;
遮挡概率决定 dense point sampling distribution;
dense transformer + weighted SVD 细化每个候选;
结果回灌并迭代 N N N
训练期用 depth / mask / view augmentation 模拟现实遮挡链路。
6. MUSE:3D-aware detection 与 segmentation
6.1 前端组合
对观测图:
Grounding DINO 提出 boxes;
SAM2 接受 box prompts,产生 masks;
DINOv2-L 对前景提取 class-level 与 patch-level multi-embeddings。
对象模型 templates 也经过同一 DINOv2 encoder。作者用 Integrated von Mises–Fisher(I-vMF)权重强调方向上更合理的 templates,再计算 3D-aware multi-embedding similarity,从候选中选出目标。
6.2 为什么检测和 pose 不是独立模块
Table 3 将 detection choice 直接接到最终 UAR:
Detector BOP-Core* UAR Time(s / image) NIDS 0.54 1.26 Fast-SAM 0.55 4.37 MUSE 0.56 1.53 Ground Truth 0.70 —
MUSE 相对 NIDS 只多 0.02 UAR,但 GT detection 比 MUSE 高 0.14。这说明后端即使更懂遮挡,也无法完全修复前端未提供的目标区域;论文的“error recovery”是有限恢复,不是端到端消除 detector dependency。
7. 特征抽取与 3D lifting
7.1 Crop 与多层 ViT feature
根据 ( B o , S o ) (B_o,S_o) ( B o , S o ) 224 × 224 224\times224 224 × 224
F o ∈ R N o × C . F_o\in\mathbb{R}^{N_o\times C}. F o ∈ R N o × C . 每个模板同样得到 F m v F_m^v F m v
F m ∈ R N m × C , N m = ∑ v = 1 V N m v . F_m\in\mathbb{R}^{N_m\times C},\qquad N_m=\sum_{v=1}^{V}N_m^v. F m ∈ R N m × C , N m = v = 1 ∑ V N m v . 多层特征同时保留较局部与较语义信息,但也显著增加 feature memory;论文没有单独给出这些中间张量的显存占用。
7.2 背景与遮挡 token
作者在观测端增加 learnable background embedding f o b g f_o^{bg} f o b g f m o c f_m^{oc} f m oc
观测 mask 中的污染点可匹配到 background;
模型当前不可见的点可匹配到 occlusion。
如果没有这些出口,双向 softmax 会迫使每个点在错误实体点之间分配概率,使 SVD 更容易被污染。
7.3 点云
观测 depth 与 mask 产生 partial cloud P o P_o P o P m P_m P m
这也是 WALDO 依赖 RGB-D 的关键:若观测没有可靠 depth,P o P_o P o
8. 双向 soft correspondence
8.1 Assignment matrix
特征矩阵含额外 token 后,attention / assignment 为:
A = [ f o b g , F o ] [ f m o c , F m ] T ∈ R ( N o + 1 ) × ( N m + 1 ) . A=[f_o^{bg},F_o]\,[f_m^{oc},F_m]^T
\in\mathbb{R}^{(N_o+1)\times(N_m+1)}. A = [ f o b g , F o ] [ f m oc , F m ] T ∈ R ( N o + 1 ) × ( N m + 1 ) . 随后分别沿行和列做 temperature-scaled softmax,并逐元素相乘:
A ~ = Softmax r o w ( A τ ) ⊙ Softmax c o l ( A τ ) . \tilde A=
\operatorname{Softmax}_{row}\left(\frac{A}{\tau}\right)
\odot
\operatorname{Softmax}_{col}\left(\frac{A}{\tau}\right). A ~ = Softmax r o w ( τ A ) ⊙ Softmax co l ( τ A ) . 双向归一化强调互相一致的对应,弱化“一对多但反向不支持”的匹配。
8.2 Coarse stage
作者对 P o , P m P_o,P_m P o , P m
P o c ∈ R 196 × 3 , P m c ∈ R 196 × 3 , P_o^c\in\mathbb{R}^{196\times3},\qquad
P_m^c\in\mathbb{R}^{196\times3}, P o c ∈ R 196 × 3 , P m c ∈ R 196 × 3 , 再经过 T c = 3 T^c=3 T c = 3 i l d e A c ilde A^c i l d e A c
从对应中采样并生成 pose hypotheses;
从首行 / 首列读取 background 和 occlusion probabilities。
这使可见性估计不是独立 segmentation head,而是 correspondence problem 的副产品。
9. 多初始位姿假设
9.1 生成方式
从 i l d e A c ilde A^c i l d e A c ( R h y p k , t h y p k ) (R_{hyp}^k,t_{hyp}^k) ( R h y p k , t h y p k )
s h y p k = N o c ∑ p o c ∈ P o c min p m c ∈ P m c ∥ R h y p k ( p m c − t h y p k ) − p o c ∥ 2 . s_{hyp}^k=\frac{N_o^c}{
\sum_{p_o^c\in P_o^c}
\min_{p_m^c\in P_m^c}
\left\|R_{hyp}^k(p_m^c-t_{hyp}^k)-p_o^c\right\|_2}. s h y p k = ∑ p o c ∈ P o c min p m c ∈ P m c R h y p k ( p m c − t h y p k ) − p o c 2 N o c . 保留 top-K K K
9.2 为什么遮挡需要多假设
部分可见几何可能支持多个相近方向;对称物体还存在真实等价旋转。单 hypothesis pipeline 在 coarse stage 选错后,dense refinement 的 basin 可能覆盖不到正确姿态。保留多个初值提高至少一个候选落入正确 basin 的概率。
但评分仍基于最近邻几何距离,可能偏爱错误却局部重叠的解;最终也只输出一个 pose,不是显式 pose distribution。
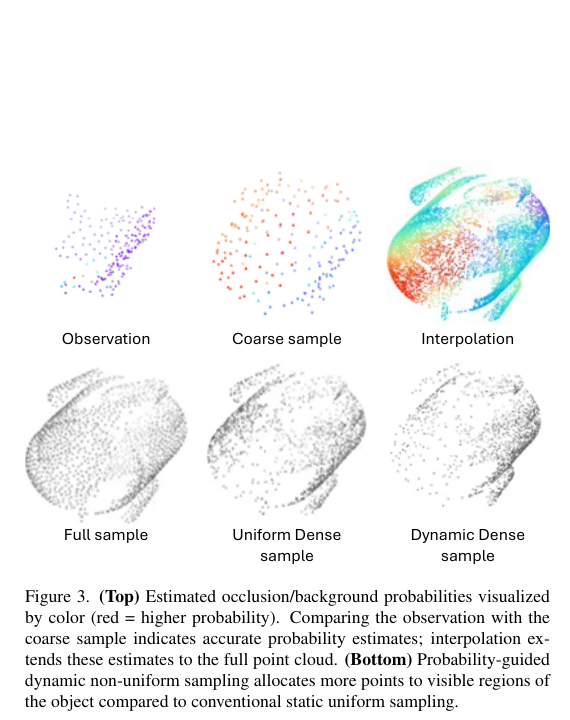
原论文 Figure 3:上排显示 coarse points 的背景 / 遮挡概率及其向全点云的插值;下排对比完整点云、静态均匀 dense sample 与 probability-guided dynamic dense sample。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
10.1 概率来源
A ~ c \tilde A^c A ~ c
10.2 采样
在概率分布上建立 Walker–Vose alias table,再通过 Gumbel-Top-k k k
P o d ∈ R 2048 × 3 , P m d ∈ R 2048 × 3 . P_o^d\in\mathbb{R}^{2048\times3},\qquad
P_m^d\in\mathbb{R}^{2048\times3}. P o d ∈ R 2048 × 3 , P m d ∈ R 2048 × 3 . 目标不是几何覆盖最均匀,而是匹配证据最有效:减少高遮挡 / 高背景概率点,增加当前观测可支持的区域。
10.3 一个需要谨慎的地方
如果 coarse matching 已经错误,插值后的 visibility probabilities 也会错误,dynamic sampling 可能进一步放大早期偏差。多 hypothesis 与 iterative refinement 是论文用来缓解这种自增强错误的机制,但并未从理论上保证恢复。
11. Dense matching 与迭代
11.1 每个 hypothesis 的 dense refinement
对每个 ( R h y p , t h y p ) (R_{hyp},t_{hyp}) ( R h y p , t h y p )
先将 model dense cloud 变换到 hypothesis 附近;
Set Abstraction 提取多尺度位置编码;
将位置编码加到 dense features;
经过 T d = 3 T^d=3 T d = 3
从 dense assignment 取 weighted correspondences;
用 weighted SVD 求 ( R r , t r ) (R_r,t_r) ( R r , t r )
11.2 循环 refinement
新的 ( R r , t r ) (R_r,t_r) ( R r , t r ) N N N ( R f , t f ) (R_f,t_f) ( R f , t f ) N N N
循环允许早期错误逐步调整,但也带来:
推理成本随 N N N
错误对应可能重复强化;
需要在训练 / 推理配置间保持 refinement depth 一致或足够稳健。
12. 训练监督与增强
12.1 Correspondence labels
利用合成数据中的 GT pose ( R ^ , t ^ ) (\hat R,\hat t) ( R ^ , t ^ ) δ d i s = 0.15 \delta_{dis}=0.15 δ d i s = 0.15
损失对 assignment matrix 做双向 cross-entropy:
L = C E ( A [ 1 : , : ] , Y ^ o ) + C E ( ( A [ : , 1 : ] ) T , Y ^ m ) . L=CE(A[1:,:],\hat Y_o)+CE((A[:,1:])^T,\hat Y_m). L = C E ( A [ 1 : , : ] , Y ^ o ) + C E (( A [ : , 1 : ] ) T , Y ^ m ) . coarse 与 dense transformer 的多个 blocks 都施加监督并求和。
12.2 Augmentation
作者在常规颜色、噪声、模糊、缩放、旋转和透视增强之外,加入三类 occlusion-focused augmentations:
Depth
blur;
Gaussian noise;
随机 depth dropout;
椭圆区域缺失。
Mask
dilation;
用 bounding box 替换 mask;
用直线切割 mask;
随机删除内部区域。
View
从多视角模板中只取部分 views;
构造不完整 model point cloud,模拟模型证据缺失。
增强的边际 UAR 是 0.54→0.55。它有价值,但表明 backbone / correspondence framework 才是主要性能来源。
13. UAR:按可见度重新平均
13.1 普通 BOP AR
BOP AR 通常聚合三类误差阈值 recall:
VSD:可见表面差异;
MSSD:对称感知最大表面距离;
MSPD:对称感知最大投影距离。
这些误差本身处理了可见表面或对象对称,但普通 dataset average 仍受样本 visibility distribution 支配。
13.2 UAR 的计算逻辑
WALDO 将实例按 visibility fraction 分成 10 个 deciles。对每个 decile:
分别计算 VSD / MSSD / MSPD recall;
在各自 thresholds 上聚合;
对三个 metrics 和 10 个 deciles 等权平均。
因此 UAR 近似回答:随机先选一个可见度层级,再选其中样本时,模型平均能否成功。
13.3 Detection / segmentation 的对应指标
作者类似地将 COCO AP / AR 按 visibility deciles 计算后平均,得到 mAPD / mARD。WALDO 前端结果:
AP 0.508 vs mAPD 0.218;
AR 0.594 vs mARD 0.444。
AP 与 mAPD 差 0.290,说明高度可见实例对普通 AP 的贡献很大。
13.4 UAR 的统计取舍
优点:
不让数量最多的高可见样本垄断总分;
可以比较方法是否在所有遮挡层级稳定;
适合发现“平均很好、重遮挡崩溃”的模型。
限制:
10 个 bins 是经验选择;
空 / 小样本 bin 的方差可能更大;
等权不一定对应真实部署频率;
不同任务对低可见失败的成本可能不是线性的;
与传统 leaderboard 的数值不可直接横比。
14. 主结果逐项核验
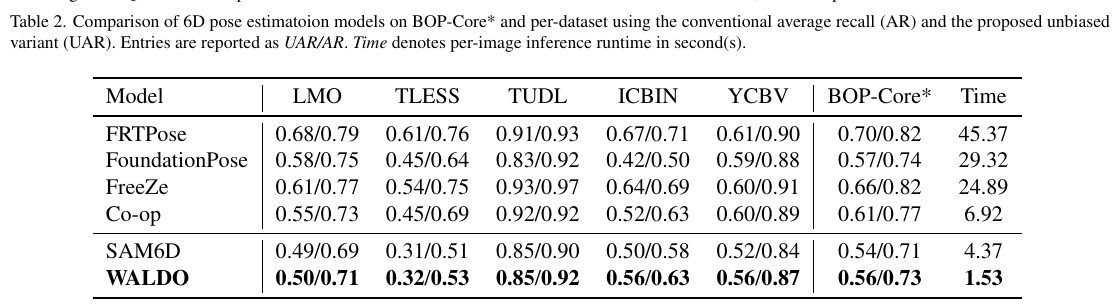
原论文 Table 2:所有数据集单元格均为 UAR / AR。WALDO 的 BOP-Core* UAR 0.56 低于 FRTPose、FreeZe、Co-op,却以 1.53 s 成为表中最快方法;相对 SAM6D 则同时更准和更快。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
14.1 相对 SAM6D
Dataset SAM6D UAR / AR WALDO UAR / AR UAR 绝对变化 LMO 0.49 / 0.69 0.50 / 0.71 +0.01 T-LESS 0.31 / 0.51 0.32 / 0.53 +0.01 TUD-L 0.85 / 0.90 0.85 / 0.92 0.00 ICBIN 0.50 / 0.58 0.56 / 0.63 +0.06 YCB-V 0.52 / 0.84 0.56 / 0.87 +0.04 Mean 0.54 / 0.71 0.56 / 0.73 +0.02
改善与遮挡困难大体一致,但并非每个集合都改善;TUD-L UAR 不变,表明 WALDO 不是统一提高所有场景。
14.2 与更强但更慢的方法
方法 UAR 时间 相对 WALDO FRTPose 0.70 45.37 s +0.14 UAR,约 29.7 倍耗时 FreeZe 0.66 24.89 s +0.10 UAR,约 16.3 倍耗时 Co-op 0.61 6.92 s +0.05 UAR,约 4.5 倍耗时 WALDO 0.56 1.53 s 最快但精度最低于前三者
因此 Figure 1 的 Pareto 叙事成立,但“performs better on both metrics”应理解为相对部分 baselines 或效率前沿,不是同时支配所有方法:FRTPose 明显更准,WALDO 明显更快。
14.3 AR 与 UAR gap
WALDO mean AR 0.73、UAR 0.56,差值:
0.73 − 0.56 = 0.17 , 0.73-0.56=0.17, 0.73 − 0.56 = 0.17 , 相对 UAR 约:
0.17 0.56 ≈ 30.4 % . \frac{0.17}{0.56}\approx30.4\%. 0.56 0.17 ≈ 30.4%. 论文写约 30.5%。YCB-V、T-LESS 的 gap 更大,说明其测试实例大部分可见度较高;ICBIN gap 较小,意味着其整体更偏重遮挡。
15. 消融:哪些模块真正贡献性能
15.1 从简单匹配到完整训练
配置 BOP-Core* UAR ViT features + RANSAC 0.33 + Point Matching & SVD 0.54 + Occlusion-focused Augmentation 0.55
最大的 +0.21 来自学习后的 point matching + SVD;增强再加 +0.01。若只看论文名称容易把收益全归因于遮挡 augmentation,这是不准确的。
15.2 DNDS
LMO 上 static uniform 0.49、DNDS 0.50。单项增益很小,且只报告一个数据集;需要更多 seeds、不同 visibility bins 与其他数据集才能判断稳定性。
15.3 K K K N N N
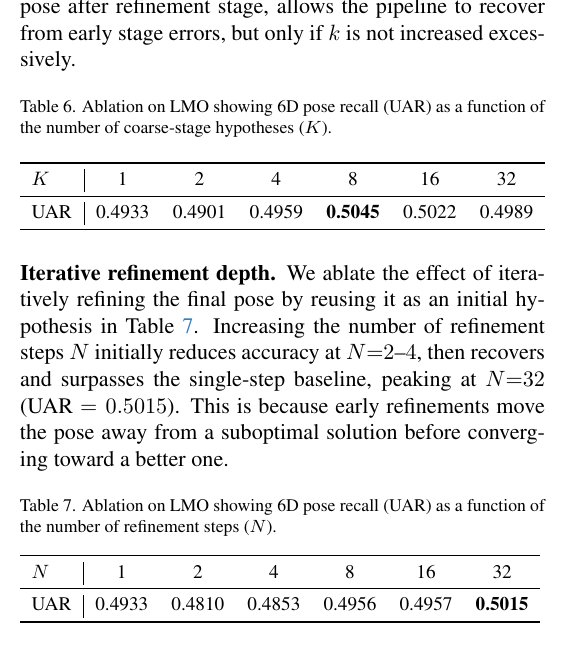
原论文 Tables 6–7:$K=8$ 的 0.5045 最好,继续增加 hypotheses 会下降;refinement 在 $N=2,4$ 时先低于 $N=1$,到 $N=32$ 才达到 0.5015。两个关键超参数都呈非单调关系。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
K K K
K K K 1 2 4 8 16 32 UAR 0.4933 0.4901 0.4959 0.5045 0.5022 0.4989
N N N
N N N 1 2 4 8 16 32 UAR 0.4933 0.4810 0.4853 0.4956 0.4957 0.5015
这些结果暴露两个工程风险:
多候选会增加 dense refinement 总成本,过多还稀释 / 误选;
refinement 需要很多轮才能形成净增益,部署时降低 N N N
论文 Table 2 的 1.53 s 使用哪组完整 K , N K,N K , N
16. 失败模式与隐含假设
16.1 前端不可恢复错误
如果检测框完全漏掉对象,后端没有观测点云;若 mask 把遮挡物大面积纳入,background token 可能不足以清除所有污染。GT detector 0.70 vs MUSE 0.56 是最直接证据。
16.2 Depth sensor
透明、反光和远距离对象常产生空洞或错误深度。Depth augmentation 模拟 noise / dropout,但真实传感器误差可能是结构化、多径或与材质强相关,不一定由 Gaussian noise 覆盖。
16.3 CAD 与真实对象一致
模型点云来自 CAD templates。制造误差、柔性、可动部件、磨损或错误尺度都会使 3D–3D correspondence 与 SVD 产生系统偏差。WALDO 没有解决 model mismatch。
16.4 Visibility probability 的自举风险
概率来自 coarse correspondence。如果 coarse alignment 错,模型可能把本应可见的点判成遮挡,再在 dense stage 少采这些点,形成确认偏差。
16.5 对称与最终单解
多 hypothesis 能覆盖若干候选,但最终评分仍选择单 pose。对于图像条件下真正多解的对象,单解 evaluation 即使 symmetry-aware,也不能表达预测分布的覆盖与冗余;这正是 BOP-Distrib 后续评测关注的方向。
17. 复现清单
17.1 必要组件
Grounding DINO;
SAM2;
DINOv2-L;
MUSE 的 I-vMF template weighting 与 multi-embedding similarity;
RGB-D template renderer;
Geometric Transformer;
Sparse-to-Dense Point Transformer;
Walker–Vose alias sampling 与 Gumbel-Top-k k k
weighted SVD;
BOP datasets、visibility masks、CAD models 和 evaluator;
UAR / mAPD / mARD 的 visibility-decile implementation。
17.2 容易错的实现细节
对象—相机坐标变换方向以及 R , t R,t R , t
depth 单位、CAD 尺度和 BOP mm / m 转换;
template views 的方向、数量与 opposing-view pairing;
mask crop 后图像 / depth / intrinsics 的同步变换;
background / occlusion token 在 assignment matrix 的首行首列位置;
双向 softmax 是逐元素相乘,不是 Sinkhorn 的完全等价实现;
coarse 概率向 full cloud 插值时的距离权重方向与归一化;
SVD reflection correction,避免得到 det ( R ) = − 1 \det(R)=-1 det ( R ) = − 1
UAR bins 的边界、空 bin 处理与 recall threshold 聚合;
latency 是否包含检测、模板处理、数据搬运和 refinement 全部阶段。
17.3 缺失信息
公开论文没有完整报告:
官方代码与 checkpoint;
完整硬件 / batch / warm-up 统一设置;
每模块显存和 FLOPs;
多 random seeds 或置信区间;
不同 depth sensor 的实测泛化;
K , N K,N K , N 每个 visibility decile 的完整数值表。
这些缺口意味着“1.53 s + 0.56 UAR”复现需要作者实现或较多工程判断。
18. 与相关路线的关系
18.1 对 SAM6D
WALDO 可看成 SAM6D-style model-based zero-shot pipeline 的遮挡 / 效率扩展:更换并加强 detection、增加 point matching 的背景 / 遮挡 token、多候选与动态采样,再迭代细化。
18.2 对 FoundationPose / FreeZe / Co-op
FoundationPose:render-and-compare / refinement 能力强,但表中耗时高;
FreeZe:foundation features 与几何匹配带来更高 UAR,仍比 WALDO 慢很多;
Co-op:对应 + flow refinement 的精度更高,速度介于 WALDO 与重方法之间。
WALDO 的定位更像轻量 Pareto 点,而不是彻底替代这些方法。
18.3 对 BOP-Distrib
WALDO 的 UAR 处理的是不同 visibility levels 的样本权重 ;BOP-Distrib 处理的是单张图中哪些 poses 都能解释可见证据 。两者互补:
UAR:每个可见度层级是否公平参与总分;
pose distribution GT:当前图像本身是否多解。
未来可以用逐图 pose distribution 评价 WALDO 的多个 hypotheses,而不是只在 refinement 后保留一个结果。
19. 本站分析:最值得延伸的方向
19.1 联合前端与位姿
GT detection 提供 0.14 UAR 上限差,远大于 DNDS 的 0.01。与其继续堆更深 refinement,更高收益的路线可能是让 pose consistency 反向筛选 detection / segmentation,或共同训练 visibility head。
19.2 保留分布而不是最后塌缩
当前 multi-hypothesis 只是优化策略。可以为候选赋权并输出 mixture over S E ( 3 ) SE(3) S E ( 3 )
19.3 风险加权 UAR
十个 deciles 等权是公平性选择,但机器人抓取可能对 10% 可见对象失败成本更高。可以研究:
R r i s k = ∑ b = 1 10 w b R b , R_{risk}=\sum_{b=1}^{10}w_bR_b, R r i s k = b = 1 ∑ 10 w b R b , 其中 w b w_b w b
19.4 先验成本计入 Pareto
Figure 1 只画 accuracy 与 time。更完整的部署比较还应包括:
是否需要 CAD;
是否需要 depth;
onboarding 时间;
GPU memory / power;
renderer 与模板存储;
失败后是否可校准 / 重试。
加入这些轴后,“最快”可能仍不是最低系统成本。
20. 最终评价
20.1 论文做得好的地方
研究问题具体:不是泛泛谈 occlusion,而是逐阶段定位误差传播;
方法闭环:coarse assignments 同时支持 hypothesis 与 visibility sampling;
评价有反思:主动展示 AR 比 UAR 乐观;
实验诚实:主表保留更准但更慢的方法,也报告 TUD-L 无 UAR 改善;
消融充分暴露非单调性,没有暗示更多 hypotheses / refinements 永远更好。
20.2 不应被宣传语掩盖的地方
0.56 UAR 不是主表最高;
+0.02 是相对 SAM6D 的绝对 point 改善;
动态采样单项仅 +0.01;
32 次 refinement 才得到消融最好值;
系统需要 RGB-D + CAD + 多基础模型;
没有官方代码让复现难度显著上升。
20.3 适合谁读
做 BOP / novel-object pose 的研究者;
研究 occlusion-aware correspondence 与 refinement 的读者;
设计 benchmark aggregation / robustness metrics 的读者;
需要理解准确率—延迟—先验三方取舍的机器人视觉工程师。
21. 可带走的五条结论
遮挡鲁棒性不能只靠训练 augmentation,还要改变候选管理和计算分配。
background / occlusion token 是 soft correspondence 中处理“不应匹配”证据的关键出口。
多假设与迭代都可能非单调,必须报告完整 sweep 和计算代价。
普通 AR 与 visibility-balanced UAR 可以讲出不同故事,指标聚合方式本身就是研究假设。
WALDO 的强项是较低延迟下的可用精度,不是主表绝对最高精度;评价应始终把数字放回 baseline、时间和先验条件中。