论文精读笔记:XYZ-IBD: Benchmarking Robust 6D Object Pose Estimation under Real-World Industrial Complexity
1. 基本信息
标题:XYZ-IBD: Benchmarking Robust 6D Object Pose Estimation under Real-World Industrial Complexity
作者:Junwen Huang、Jiaqi Hu、Peter KT Yu、Slobodan Ilic、Martin Sundermeyer、Benjamin Busam
机构:Technical University of Munich、Munich Center for Machine Learning、XYZ Robotics、ROBOX、Google
年份 / 会议:ECCV 2026
论文链接:arXiv:2506.00599 v3
项目与数据:XYZ-IBD 项目页
阅读模式:精读
阅读重点:工业场景难度是否来自可复核的因素、消反光双遍采集如何建立标签、误差量化能证明到什么程度,以及基线下降究竟发生在检测还是 pose 阶段。
2. 一句话定位
XYZ-IBD 是一个面向真实工业料箱抓取的 model-based 2D / 6D object detection benchmark:15 种反光、无纹理且多具对称性的金属零件被密集随机堆叠,ECCV 接收版汇总 75 个场景、约 2.25 万帧与 27.3 万个 pose instances;数据集用三传感器、机械臂多视图复现、临时消反光喷涂、CAD 粗配准与多尺度 ICP 建立标签,并显示现有 seen / unseen 方法在工业复杂度下均明显退化。
我的核心判断
这篇论文的价值不在于提出一个新的位姿网络,而在于把工业 6D pose 的三个长期被分开处理的问题放到同一 benchmark 中:密集重复实例、反光导致的观测退化,以及装配级精度要求 。普通 benchmark 可以在低遮挡、外观可区分或标签精度有限的条件下得到很高分数,XYZ-IBD 则要求方法同时回答“实例在哪里”“这是不是目标 CAD”“对称等价下 pose 是否足够准”。
不过,论文中最容易被过度传播的结论也需要收紧:0.999 mm / 0.432° 是在仿真环境中复刻传感器噪声、标定、融合、人工调整与 ICP 后,相对已知仿真 GT 得到的误差统计。它支持“这套标注流程有望达到约 1 mm / 1°”,但并不是对 27.3 万个真实标签逐实例进行独立物理计量;而且 0.999 mm 与 1 mm 的裕度极小,不宜改写成“远低于毫米”。
2.1 论文图表导读
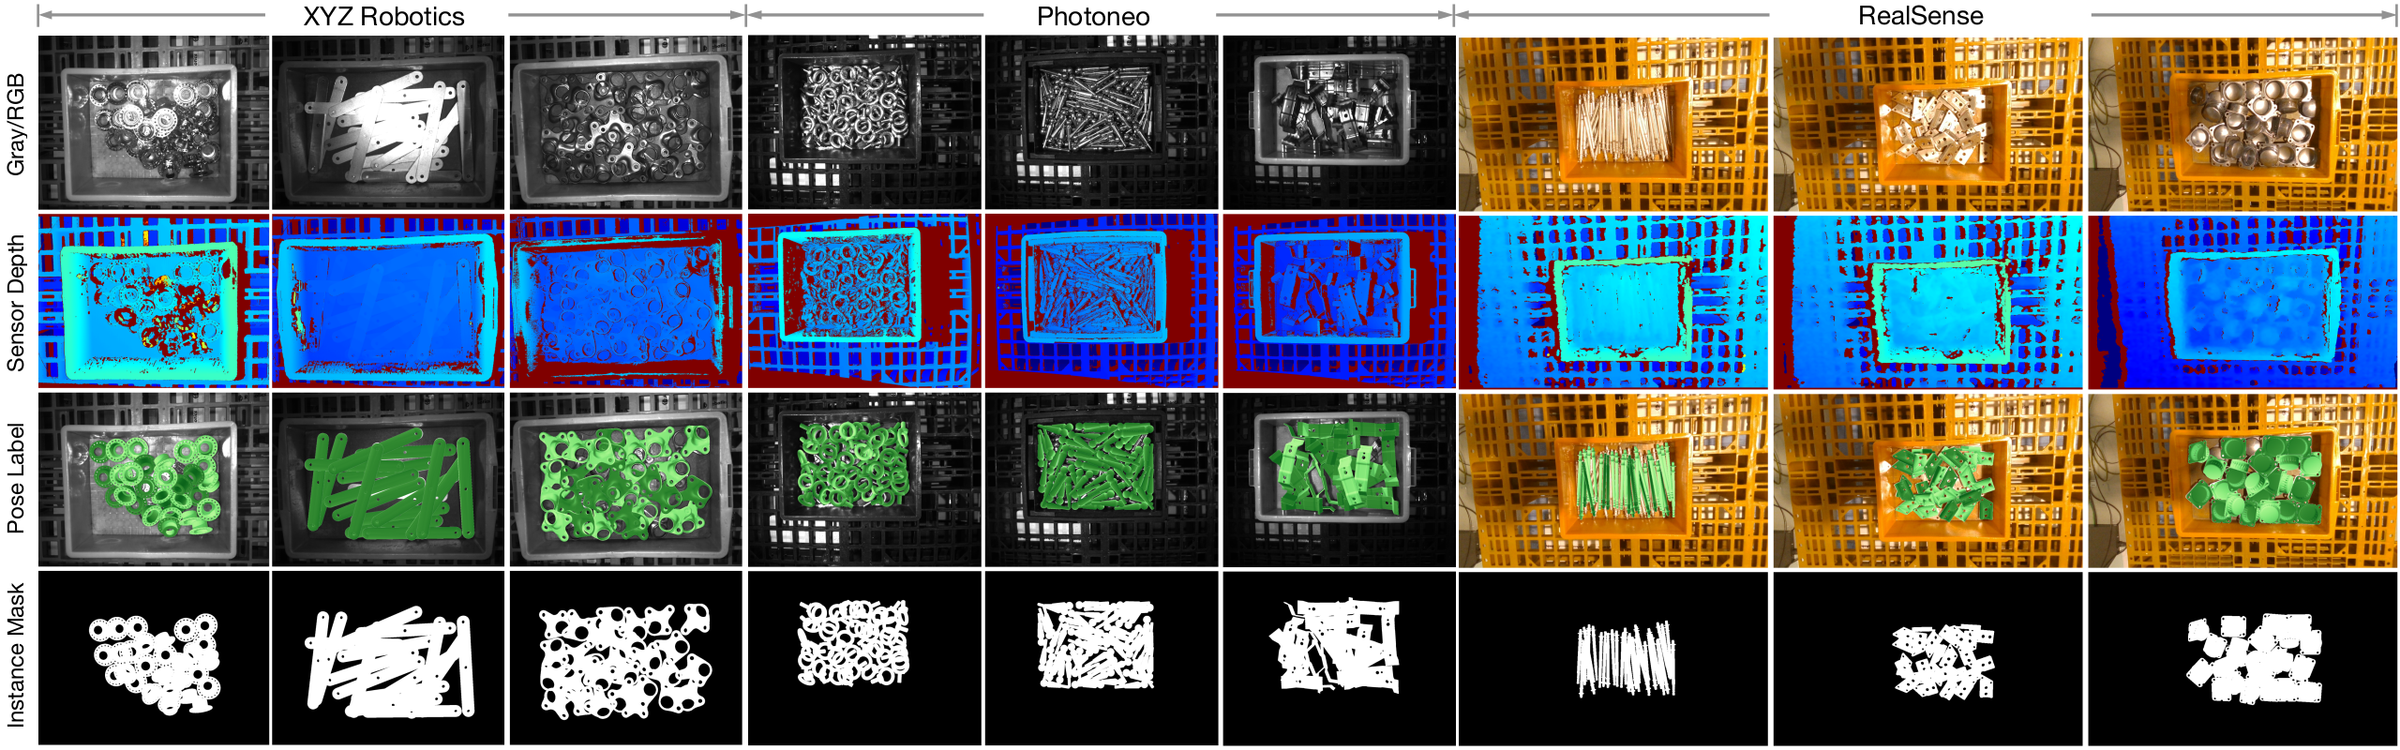
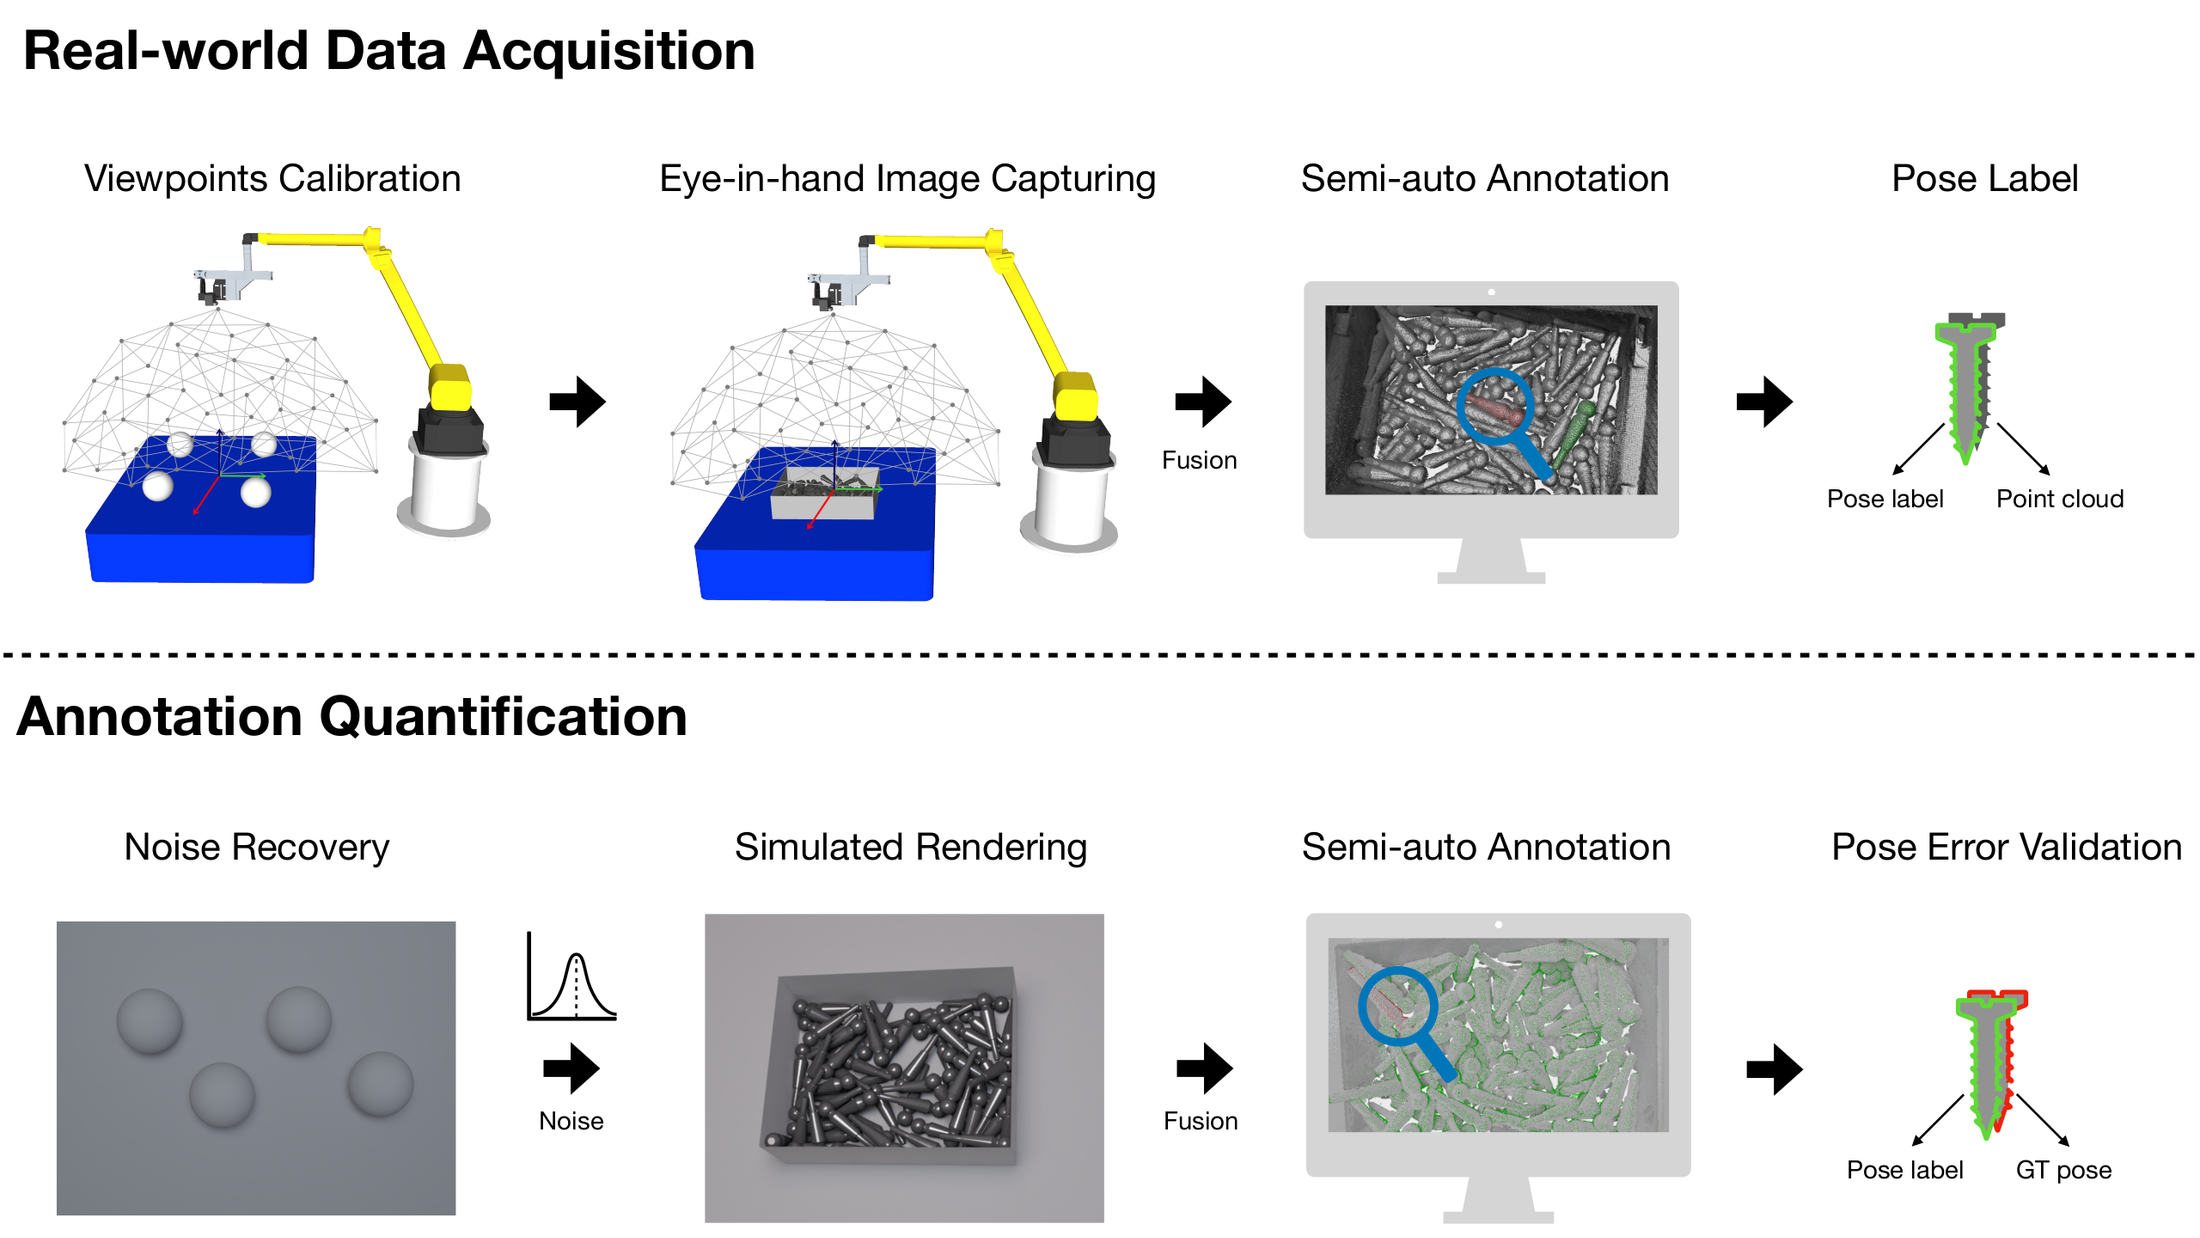
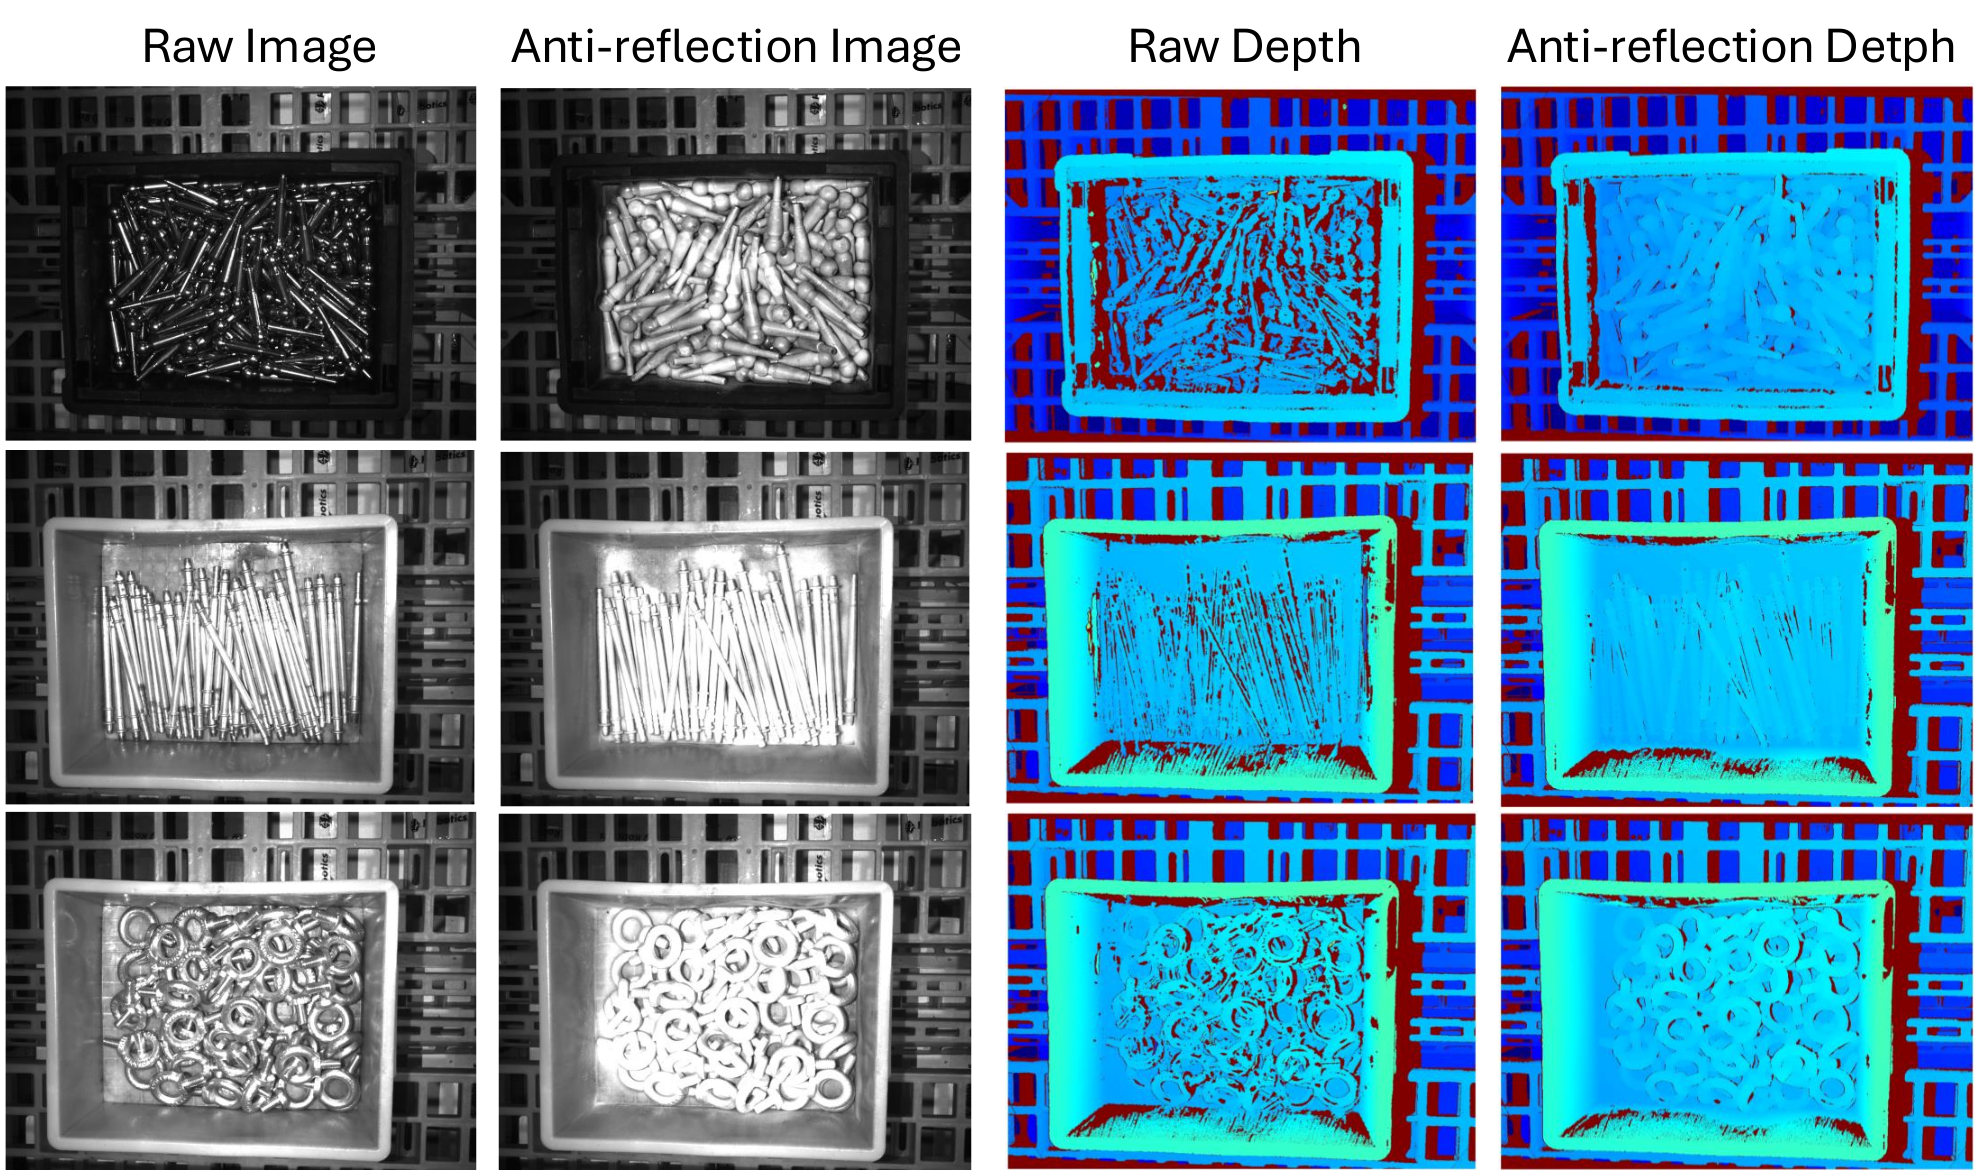
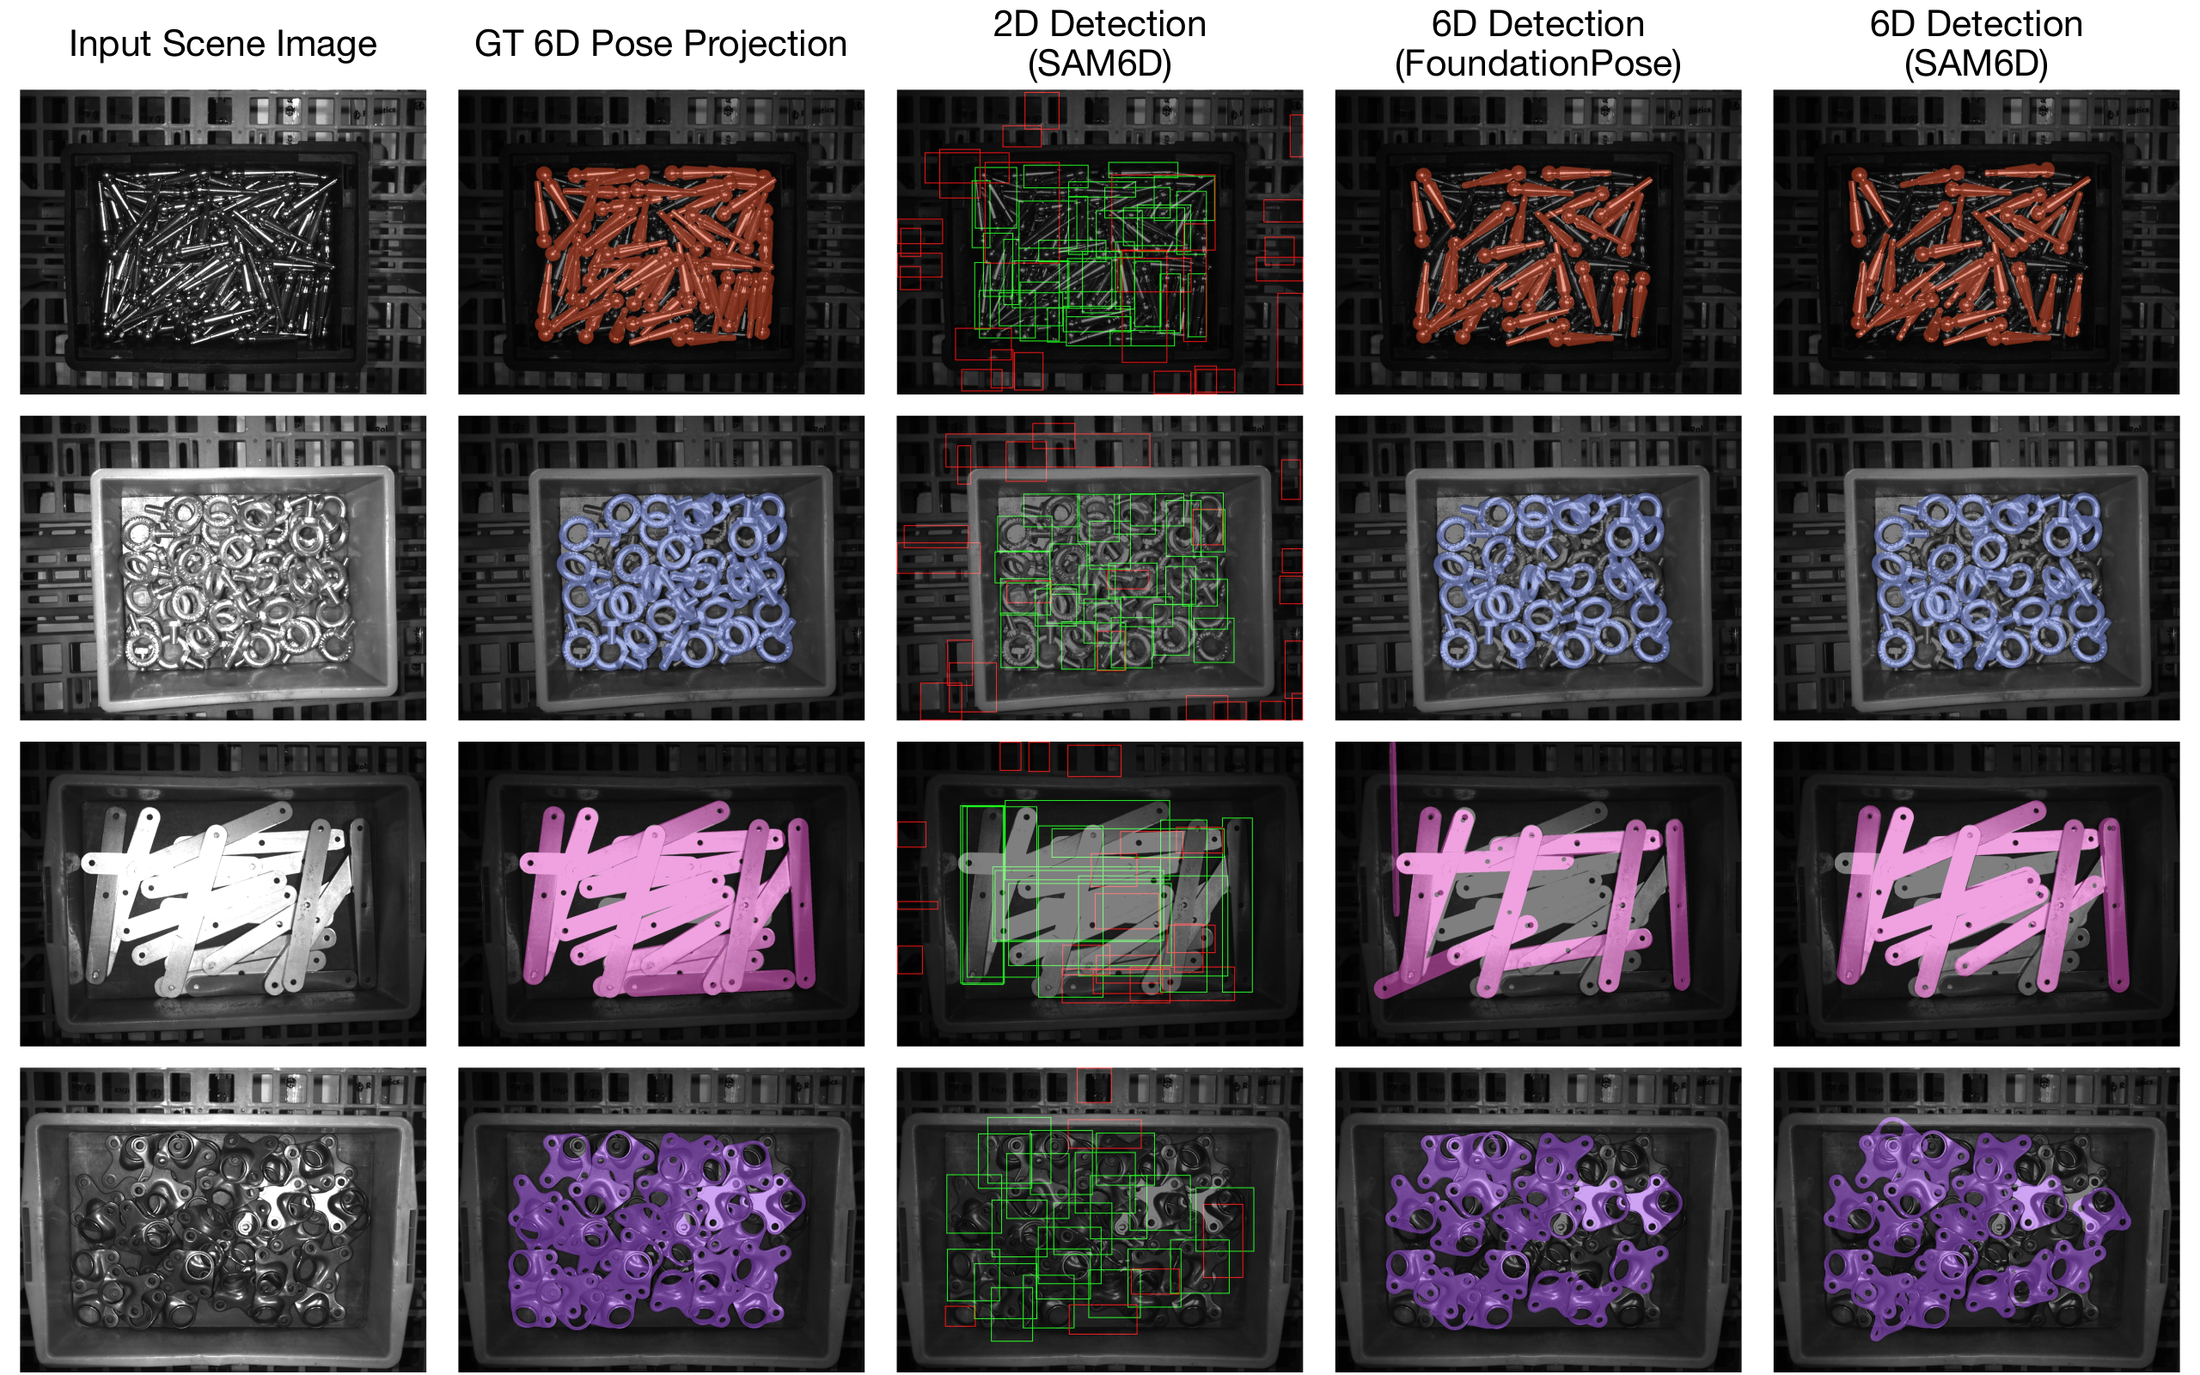
图 内容 证据作用 不应过度解读为 Figure 2 XYZ DLP、Photoneo、RealSense 的图像、原始 depth、pose 与 mask 证明数据具有三传感器、多模态与密集实例标注 推理必须同时输入三台相机,或多传感器天然保证 pose 准确 Figure 6 真实采集链路与仿真误差量化链路 区分“标签怎样产生”和“误差怎样估计” 仿真验证等价于真实标签逐项 metrology Figure 7 原始与喷涂后的图像 / depth 直接显示反光金属导致深度缺失,喷涂可改善融合 测试方法可以使用喷涂后的增强 depth Figure 10 GT、SAM-6D detection、FoundationPose 与 SAM6D pose 展示重复实例中的漏检、错 ID 与 pose 误差 几张定性图足以判断方法总体优劣
原论文 Figure 2:三列传感器组分别来自 XYZ Robotics DLP、Photoneo 与 RealSense,行展示灰度 / RGB、传感器原始深度、pose 投影和 instance mask。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
3.1 四个评测任务
论文沿用 BOP 2024–2025 的 model-based 设定,把 benchmark 拆成四个象限:
任务 对象设定 测试时可用信息 代表基线 2D detection seen object 已针对 15 个目标 CAD 的 synthetic 数据训练 YOLOX 2D detection unseen object 目标 CAD / 渲染模板,但不在 XYZ-IBD 上微调 CNOS、SAM-6D detector、NIDS-Net 6D detection seen object 目标对象 synthetic 训练;使用 YOLOX 前端 GDRN、SurfEmb 6D detection unseen object 预训练泛化模型 + 目标 CAD;使用 SAM-6D masks MatchU、FoundationPose、SAM6D
这里的 unseen object 不是“没有 CAD 的开放世界 pose”。方法在测试时仍然知道待匹配的目标 3D 模型,只是没有为 XYZ-IBD 的 15 个实例重新训练。因而更准确的中文表述是“未见实例 / 新物体、已知 CAD 的 model-based pose”。
3.2 6D pose 输出
每个对象实例的目标变换可写为:
T c o = [ R c o t c o 0 1 ] ∈ S E ( 3 ) , T_{co}=\begin{bmatrix}R_{co}&t_{co}\\0&1\end{bmatrix}\in SE(3), T co = [ R co 0 t co 1 ] ∈ S E ( 3 ) , 其中 R c o R_{co} R co t c o t_{co} t co
3.3 输入、输出与关键先验
环节 输入 输出 关键先验 / 依赖 2D detector 公开测试 RGB-D(具体方法可只用 RGB)+ 目标 CAD / 模板 实例 mask、object ID、置信度 多实例提议、CAD-template 匹配、领域泛化 seen 6D pose YOLOX detection / crop + 训练过的对象模型 每实例 R , t R,t R , t 45K synthetic 数据足以跨到真实反光域 unseen 6D pose SAM-6D mask + RGB-D + CAD 每实例 R , t R,t R , t mask 完整、深度可用、CAD 与观测可注册 评测 预测、GT pose、CAD、相机内参、对称定义 symmetry-aware AP CAD 尺度、坐标系和 symmetry annotations 正确
3.4 喷涂数据的边界
临时消反光喷涂属于标签生产基础设施 :它帮助传感器获得较完整的深度,以便多视图融合和 CAD 对齐。论文保留并公开原始反光条件下的观测用于 benchmark。任何方法若在测试时读取喷涂后的理想 depth,都会把 GT 生产信息泄漏到推理流程中,不能与表中基线公平比较。
3.5 多传感器不等于多传感器推理
三台相机的主要作用是:
覆盖 RGB、灰度、stereo、structured light 与 laser triangulation 等互补观测;
通过刚性共装和相对外参,把主相机标签投影到其他传感器;
让研究者可以研究传感器域差异。
它们并不强制一个 benchmark submission 同时融合三路数据。评测时必须以具体 task 与发布协议规定的输入为准,不能仅凭 Figure 2 把它描述成“多相机联合 pose 方法”。
4. 研究脉络
4.1 家庭物体 benchmark 已解决了什么
LineMOD、LM-O、YCB-V、HomebrewedDB 与 TUD-L 奠定了 model-based pose 的标准任务;HOPE 加入机器人操作语境,IC-BIN 早期探索 bin-picking,StereoOBJ-1M 用 SfM 和标定板提高 RGB 标签规模。NOCS 及后续 HouseCat6D 等工作则扩展到类别级、新实例或更复杂材质。
这些数据推动了无纹理、遮挡、对称性与 synthetic training,但它们常见的对象语义、实例密度和工业装配要求并不完全一致。一个方法在家庭对象上达到高分,不代表它能在大量同类金属件互相遮挡、depth 大面积缺失时稳定完成抓取级位姿估计。
4.2 已有工业数据的缺口
论文把相关工业数据放在几个维度上比较:对象数量与形状多样性、物体尺度、帧数、实例数、每图实例密度、准确 depth GT、遮挡、反光以及标签误差。
T-LESS 有 30 个无纹理、含对称性的工业物体,但反光和高密度随机料箱不是其最强场景。
ITODD 具有工业形状与挑战光照,却没有以填满料箱的重复实例为核心。
DIMO 与 ROBI 更接近金属 bin-picking,但对象数量或形状覆盖较有限。
IPD 使用 RGB-D 与偏振并覆盖工业零件,但整体 clutter、stacking 与 occlusion 更弱。
StereOBJ-1M 图像和标注规模大,却没有 depth,且对象多样性有限。
XYZ-IBD 的真正增量不是单独一个维度最高,而是把“15 个工业 CAD、平均 22 个实例、最高 60 个、强反光、三传感器和约 1 mm 标注链路”组合在一起。
4.3 与 BOP 生态的关系
XYZ-IBD 使用 BOP-compatible 的数据组织和 2D / 6D detection 协议,使它能直接承接模板匹配、2D segmentation、RGB correspondence、RGB-D registration 与 novel-object pose 等方法。其意义在于增加一个更工业化的 evaluation domain,而不是替代 BOP Core 中各数据集。
需要注意,Table 4 的 BOP-Core 5 是 LM-O、T-LESS、YCB-V、IC-BIN 和 TUD-L 的平均;它不是所有 BOP 数据集,也不是同一种对象材质的受控对照实验。跨数据集差值适合说明总体 domain difficulty,不宜解释成某个单一因素的严格因果效应。
5. 研究动机:为什么工业料箱仍是难题
5.1 重复实例破坏“语义检测 = 实例检测”的捷径
一箱相同零件具有相同类别和相似外观。检测器不仅要知道“这是哪个 CAD”,还要正确拆开彼此接触、重叠的实例边界。如果一个前景区域混入相邻实例,后续 2D–3D correspondence 或 point-cloud registration 会被结构化离群点污染。
5.2 反光同时影响 RGB 与 depth
高光会造成局部饱和和外观随视角剧变;stereo 或主动深度还可能出现孔洞、飞点和偏置。对于 RGB-only 方法,这破坏 synthetic texture 与真实外观的一致性;对 RGB-D registration 方法,则减少可用于几何对齐的可见表面。
5.3 对称性让唯一姿态假设失效
螺栓、销、盖板与回转零件可能具有离散或连续对称性。若评测直接比较旋转矩阵,会把几何等价解错判为失败。XYZ-IBD 因而采用 MSSD / MSPD 的 symmetry-aware 定义,但对称性处理只解决评价歧义 ,不会替方法补回被遮挡的表面或实例边界。
5.4 synthetic-to-real 的主要瓶颈不只是纹理
45K synthetic frames 可以模拟随机自由落体、材质和光照,却很难精确复制真实金属的 BRDF、传感器主动照明、深度失效模式、零件微小磨损以及物理接触。seen 方法在目标 CAD 上训练后仍大幅下降,说明“知道对象几何”不等于“已经解决真实观测域差异”。
5.5 工业误差要求会放大标签问题
若 benchmark 标签本身有数毫米偏差,方法差异可能被 GT 噪声掩盖。对于装配、插接或抓取接近点,毫米级误差会改变接触结果,因此作者不只追求更多图片,也把标定、融合和标签误差量化作为数据集主体。
6. 数据集构建详解
6.1 对象与场景组成
15 种真实工业部件,直径约 54–300 mm;涵盖钣金件、螺栓、销、盖板和其他机加工零件。
CAD 由工业合作方提供,作者称原始几何具有 micron-level accuracy;这描述 CAD 来源精度,不等于整条图像标注链路也达到微米级。
每种对象制作 5 个真实料箱重排,共 75 个场景。
每个场景包含 11–60 个实例,论文汇总均值约 22,实例大量互相遮挡。
传感器到对象的工作距离约 600–1000 mm,接近工厂工作布局。
Table 1 报告 22.5K frames 与 273K instances。若把不同相机、不同采集阶段或视图层级混在一起,“每场景”“每图像”很容易产生不同平均值,因此复用数据时必须以下载 manifest 的实际文件层级为准。
6.2 硬件系统
设备 输出与规格 在数据链路中的作用 FANUC M10iD/8L 重复定位精度 ±0.06 mm 复现 50 个预标定视点,并完成喷涂 / 原始双遍采集 Intel RealSense D415 1920×1080 RGB 与 stereo depth,30 FPS 提供常见 RGB-D 模态,代表消费级 / 通用传感器观测 XYZ Robotics AL-M DLP 1440×1080 grayscale 与 structured-light depth,论文列 0.08 mm depth resolution 主标注相机;在喷涂表面上提供高密度深度 Photoneo PhoXi M grayscale 与 laser-triangulation depth,最高 2064×1544,0.1 mm voxel precision 提供另一种工业 3D sensing 域
三台相机刚性共装在机械臂末端。resolution、voxel precision、机械臂 repeatability 与最终 pose-label accuracy 是不同概念,不能直接相加或选择最小值作为 GT 精度。
6.3 多视图采样与标定
作者以料箱中心为原点,在仰角 45°–90° 的半球面随机采样 50 个视点,以兼顾可见性和机械臂可达性。标定流程为:
在工作平面放置 4 个精密加工球体;
对相机去畸变,并通过 hand-eye calibration 获得初始 camera poses;
从各视点采集球体点云;
用 ICP 细化 49 个次视点到主参考视点的 6DoF 关系;
保存视点间变换,供后续多视图融合与 pose label 投影。
正文报告平均 viewpoint calibration RMSE 约 0.248 mm,Table 2 则列总量 0.245 mm。两者可视为约 0.25 mm 的取整差异,不应在本站强行选一个更“精确”的数字来掩盖原文口径。
6.4 双遍采集:把标签观测与测试观测分开
金属表面对 active depth 极不友好。作者先给全部对象喷涂临时消反光材料 Acksys SP-102,在涂层状态下采集高质量 depth;随后在 25°C±1°C 环境等待约 15 分钟,使涂层挥发,再让机械臂返回相同视点,记录对象原始光学外观。
理想情况下,两遍数据在机器人重复定位误差范围内保持空间对应。这个设计有两个好处:
标签可依赖喷涂后的完整几何,而 benchmark 仍保留真实反光难度;
同一场景可形成 raw / anti-reflection 对照,用于研究 depth restoration 或跨传感器一致性。
但也有一个隐含假设:等待和二次访问期间,零件与料箱必须完全静止,挥发过程不能造成表面几何或场景位移。机械臂 ±0.06 mm repeatability 只约束相机重访,不直接证明全部物体在两遍之间没有微动。
原论文 Figure 7:从左到右为原始图像、消反光图像、原始深度与消反光深度;喷涂显著补全反光金属表面的深度,增强深度仅用于融合与标签,不替代原始测试观测。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6.5 半自动 6D pose 标注
每个场景的标签不是逐帧手工拖动,而是先在统一 3D 场景中对齐,再传播到所有视点:
将喷涂增强的多视图 depth 融合为统一场景点云;
标注员在受约束 GUI 中调整 CAD,平移步长 ±1 mm、旋转步长 ±1°;
在粗位置附近运行 multi-scale ICP:先用降采样点云做较大范围调整,再用全分辨率细化;
在 XYZ DLP 主相机 / 主参考系确定最终 pose;
通过预标定视点变换把标签传播到全部 50 个视角;
再通过相机间刚性外参投影到 RealSense 与 Photoneo。
这种层级化标注把人工工作量从“每实例 × 每视图 × 每相机”降到“每场景实例一次”。它也使跨视图标签具有同一几何来源,但会让同一个标定偏差相关地影响大量帧;样本数量很多并不会平均掉系统性外参误差。
原论文 Figure 6:上半部分是 50 视点标定、眼在手上采集、多视图融合、半自动 CAD 对齐和标签传播;下半部分在仿真中恢复噪声、重复采集与标注,再和可知 GT 比较。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6.6 标注误差量化:论文真正做了什么
真实场景中没有一个明显更准确、又能逐个测量被遮挡零件的外部 GT。作者因而在 BlenderProc 中建立可知真值的对应环境,分三步估计累计误差。
第一步:恢复等效噪声
在仿真里使用相同标定球和相机参数,采样 50 个视点,并向 rendered depth 加不同标准差的 Gaussian noise。随后运行同类 ICP 标定,比较噪声大小与视点标定 RMSE:
Gaussian depth noise σ σ σ calibration RMSE(mm) 0.00 0.199 0.10 0.209 0.20 0.233 0.26 0.248 0.30 0.259
因为 σ = 0.26 σ=0.26 σ = 0.26
第二步:复刻场景与标注链路
用相同 CAD 在 bin 中做物理自由落体,渲染带上述噪声的多视图数据,然后重新运行多视图融合、人工调整和 multi-scale ICP。仿真保留每个零件的真实 pose,因此可把“标注输出”与“仿真 GT”直接比较。
第三步:匹配实例并统计 pose error
作者以 3D centroid distance 构造代价,通过 Hungarian assignment 匹配预测标签与 GT;每个对象最多使用每场景 60 个样本、3 个场景进行分析。论文报告:
平移误差均值 0.999 mm,标准差 0.12 mm;
旋转误差均值 0.432°,标准差 0.08°。
这项验证能支持什么
它能支持:在作者建立的等效 Gaussian 噪声、仿真几何和标注复刻条件下,整条流程的平均误差接近 1 mm / 0.43°;这比只列传感器规格或 ICP residual 更有说服力。
它不能直接支持:
每个真实标签都小于 1 mm;均值小于阈值不代表尾部样本也小于阈值;
仿真 Gaussian noise 完整覆盖真实反光 depth 的非高斯孔洞、飞点与空间相关偏差;
CAD 制造公差、对象磨损和喷涂 / 挥发期间的微小位移已经被独立测量;
0.999 mm 与 0.432° 可以简单合成为一个单一“精度分数”。
论文用 sub-millimeter 概括 0.999 mm 在数值上成立,但几乎没有裕度。更稳妥的中文结论是“仿真复刻估计的平均平移误差约 1 mm”。
6.7 Synthetic training set
作者为每个对象运行 120 次自由落体仿真,每个场景渲染 25 帧,并随机改变材质、光照、实例数量和 pose。由此得到每对象约 3,000 帧、总计约 45K RGB-D 样本,包含 instance masks、depth 与 6D poses。
这些数据的作用是给 seen-object baseline 提供目标 CAD 的监督,而不是给真实场景增加训练标签。它使 benchmark 可以直接观察 sim-to-real:模型已经看过目标几何,但没有看过同分布真实训练图像。
6.8 Real split、发布内容与计数问题
正文 split 段落写为:
validation:15 个场景、2,250 frames;
test:60 个场景、9,000 frames;
synthetic training:约 45K frames;
体积约为 80 GB synthetic、8 GB validation、3 GB test;
test images 公开,GT 托管于 evaluation server;训练 / 验证标注与 CAD 对外发布。
然而,Table 1 的真实数据总量为 22.5K frames,项目页旧文案则写 22K images、91K annotations、平均 24 instances。2,250 + 9,000 = 11,250,与 22.5K 正好相差一倍;91K × 3 = 273K,又与三传感器数量形成可疑但未被正文统一解释的关系。
因此,本站采用最新 ECCV / arXiv v3 的 22.5K / 273K 作为论文主口径 ,同时明确保留以下未决项:
frame 是否按 raw / anti-reflection 双遍计数;annotation 是否按三传感器投影后计数;项目页 91K 是否来自较早数据版本;
下载 manifest 中真实可用的 image、scene 与 camera 维度如何组织。
在数据真正用于训练或发表统计前,应对下载目录逐项计数并记录 release version,而不是混用论文与项目页数字。
6.9 许可边界
项目页给出的数据许可为 CC BY-NC-SA 4.0,并提示商业使用需申请定制许可。对学术研究而言仍应保留 attribution 与相同方式共享要求;对工业部署、商业产品或内部生产数据混合训练,不能因为数据主题是“工业”就默认允许商业使用。
7. 评测协议详解
7.1 2D detection AP
2D 任务要求输出不重叠的二值 instance masks 与置信度。评价采用 COCO 风格 AP:在 mask IoU 阈值 0.50、0.55、……、0.95 上计算 precision,再跨阈值与对象聚合。
这比单独使用 IoU 0.5 更严格,因为密集接触实例即便粗略区域正确,也可能在高 IoU 阈值下失败。对于 pose pipeline,mask 质量还会影响后续 RGB crop、可见点云和 correspondence。
7.2 6D detection AP
论文采用 BOP 2024–2025 的 symmetry-aware MSSD 与 MSPD。
对 CAD 表面点集 M M M S S S P ^ \hat P P ^ P P P
e M S S D = min S ∈ S max x ∈ M ∥ P ^ x − P S x ∥ 2 . e_{\mathrm{MSSD}}=\min_{S\in\mathcal S}\max_{x\in M}
\left\|\hat P x-P Sx\right\|_2. e MSSD = S ∈ S min x ∈ M max P ^ x − P S x 2 . 它关心对称等价下最坏表面点的 3D 偏差。MSPD 则把变换后的点投影到图像平面:
e M S P D = min S ∈ S max x ∈ M ∥ π ( P ^ x ) − π ( P S x ) ∥ 2 , e_{\mathrm{MSPD}}=\min_{S\in\mathcal S}\max_{x\in M}
\left\|\pi(\hat P x)-\pi(P Sx)\right\|_2, e MSPD = S ∈ S min x ∈ M max π ( P ^ x ) − π ( P S x ) 2 , 其中 π \pi π
两者互补:MSSD 更接近 3D 对齐和物理操作,MSPD 更关注图像投影。对称集合只允许预先定义的等价变换;若 symmetry metadata 错误或近似对称未被建模,分数仍会偏离实际可抓取性。
7.3 比较设置并非完全同源
seen 2D / pose 方法使用目标 CAD synthetic data 训练;
unseen 方法使用外部大规模预训练权重,不做 XYZ-IBD fine-tuning;
seen pose 的前端来自 YOLOX;
unseen pose 统一使用 SAM-6D 生成的 masks。
因此 Table 4 可以比较“完整系统在各自标准设置下的可用性”,但不能把 seen 与 unseen 的差异纯粹归因于 pose backbone。前端 mask、训练数据规模、RGB / RGB-D 模态和 refinement 计算量都不同。
8. 实验结果与逐项解读
8.1 完整 Table 4
方法 任务 未见对象 YCB-V T-LESS LM-O BOP-Core 5 XYZ-IBD 绝对下降 YOLOX 2D detection 否 0.877 0.707 0.894 0.798 0.774 -0.024 CNOS (SAM) 2D detection 是 0.490 0.395 0.330 0.361 0.275 -0.086 SAM-6D detector (SAM) 2D detection 是 0.518 0.465 0.437 0.449 0.296 -0.153 NIDS-Net 2D detection 是 0.650 0.496 0.439 0.494 0.258 -0.236 GDRN 6D detection 否 0.906 0.852 0.775 0.827 0.266 -0.561 SurfEmb 6D detection 否 0.799 0.828 0.760 0.758 0.247 -0.511 MatchU 6D detection 是 0.756 0.668 0.680 0.705 0.529 -0.176 FoundationPose 6D detection 是 0.889 0.646 0.756 0.734 0.564 -0.170 SAM6D 6D detection 是 0.845 0.515 0.699 0.704 0.578 -0.126
绝对下降由本站用 XYZ-IBD - BOP-Core 5 计算,原始 AP 来自论文 Table 4。它描述 benchmark 间分数差,不是相对百分比变化。
8.2 2D detection:seen 与 unseen 的分化
YOLOX 从 0.798 降到 0.774,仅下降 0.024,说明针对 15 个目标对象做 synthetic supervised training 后,类别 / 实例前端仍可保持较高 AP。这个结果并不等于密集实例“容易”:
YOLOX 是 seen-object,评测对象固定;
其 synthetic train 与真实 test 使用相同 CAD;
2D mask / detection 正确不要求恢复毫米级 3D pose。
相反,三个 unseen detector 均退化,NIDS-Net 下降最大、到 0.258。它们依赖 SAM proposals、模板渲染与视觉特征匹配;在大量同外观实例、强高光和遮挡下,候选区域与 CAD identity 排序都会受影响。
8.3 seen 6D pose:目标 CAD 训练仍不足
GDRN 从 0.827 降到 0.266,SurfEmb 从 0.758 降到 0.247,是全表最显著的下降。这是本文最强的 benchmark 证据之一:即使 detector 仍能达到 0.774 AP,后续 pose correspondence / regression 也可能因反光、遮挡和 sim-to-real 出现严重误差。
GDRN 依赖 RGB RoI 内的密集 2D–3D correspondence、surface region 与 visible mask,再通过 Patch-PnP 求 pose;SurfEmb 学习对象表面 embedding。二者都需要观测外观与 synthetic supervision 之间存在稳定映射。金属高光随视角变化、实例互相遮挡和可见面积变小,会直接破坏这种映射。
8.4 unseen RGB-D registration 相对更稳
MatchU、FoundationPose 与 SAM6D 在 XYZ-IBD 上分别达到 0.529、0.564、0.578,明显高于两个 seen pose baseline。共同点是它们以 CAD、RGB-D 和泛化特征 / registration 为核心,较少把 pose 完全编码为目标实例的 RGB 回归。
但不应从这一张表得出“unseen 一定优于 seen”:
三个 unseen 方法共享 SAM-6D masks,前端与 seen 方法不同;
它们通常具有更重的 rendering、matching、coarse-to-fine 或 refinement 过程;
没有报告统一 mask、统一 runtime 和统一 compute 下的控制实验;
最优 0.578 仍离可靠工业操作有明显距离。
8.5 定性结果告诉我们失败发生在哪里
原论文 Figure 10:从左到右为输入、GT pose 投影、SAM-6D 2D detection、FoundationPose 与 SAM6D 的 6D detection;检测框绿色 / 红色分别表示 object ID 正确 / 错误。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Figure 10 可用于建立失败分类,而不是代替定量表:
漏检 :被严重遮挡的实例没有 mask,后续 pose 无从求解;错 ID :相似金属件或不完整轮廓与错误 CAD 匹配;mask 混合 :一个区域含两个相邻实例,点云注册出现结构化外点;旋转歧义 :对称或近对称零件产生视觉合理但非 GT 等价的姿态;平移漂移 :depth 缺口和遮挡让 CAD 沿表面法向或轴向错位;局部正确、整体漏召回 :图中少数高质量 overlay 不能抵消大量未输出实例,AP 会同时惩罚 precision 与 recall。
8.6 论文主张—证据对照
作者主张 直接证据 我的判断 数据体现真实工业复杂度 工业机械臂 / 传感器、15 类金属件、75 次真实重排、平均 22 / 最高 60 实例 证据充分,但 15 个对象仍不足以覆盖全部工业材料和工艺 标签达到 sub-mm / sub-degree 仿真复刻流程均值 0.999 mm / 0.432° 支持“约 1 mm / 1°的流程级均值估计”,不支持逐真实实例严格上界 比现有 benchmark 更难 9 个基线在 BOP-Core 5 与 XYZ-IBD 的 AP 对比 支持总体难度显著增加,但不是材质、遮挡、密度的逐因素因果消融 unseen pose 相对更鲁棒 MatchU / FoundationPose / SAM6D 高于 GDRN / SurfEmb 在当前完整系统设置下成立;mask prior、训练与计算配置不同,不能归因于单一架构 适合开放 benchmark BOP-compatible task、数据 / CAD / leaderboard 计划 工程方向合理;复现仍需核验 release manifest、版本计数和测试服务器状态
9. 深度批判
9.1 主要优点
数据难点是组合式而非单因素展示
许多数据只突出透明、反光、遮挡或大规模中的一个因素。XYZ-IBD 把它们放入重复实例料箱,让 detector 与 pose estimator 不能依靠背景、语义类别或单一完整轮廓走捷径。
标签生产与测试条件分离得较干净
喷涂增强 depth 用于 GT,原始反光图像用于 benchmark。这个设计比直接拿受反光污染的 depth 做 ICP 标签更可信,也比测试时提供特殊表面处理更贴近部署。
误差主张至少有流程级闭环
作者没有仅以传感器分辨率声称标签精度,而是复刻标定、融合、人工和 ICP,再与可知仿真 GT 比较。尽管外推有限,这仍是比“ICP residual 很小所以 GT 很准”更完整的验证。
统一接入 BOP seen / unseen 协议
2D detection 与 6D detection 同时报告,使研究者能定位前端和后端瓶颈。已知 CAD 的 novel-object 方法也可以无需为 15 个对象重训就进入测试。
9.2 主要局限
真实标签缺少独立物理计量
仿真噪声用单一 Gaussian 标准差拟合标定 RMSE,可能没有覆盖真实传感器误差的空间相关性、材质相关孔洞、温漂与多路径反射。若想把“sub-mm”作为工业计量结论,最好随机抽取一批可见实例,用 CMM、光学 tracker 或治具已知位姿做独立验证,并报告中位数、95 分位与最大误差。
对象数量与材质覆盖仍有限
15 个对象足以形成密集实例,但不足以代表透明塑料、黑色吸光件、柔性件、线缆、混合材质、旧件划痕和制造公差。论文中的 object diversity +++ 是作者表格的定性等级,不应视为标准化统计指标。
场景似乎以单 CAD 重复实例为主
每种对象 5 个重排有利于研究 same-object bin-picking,但混合 SKU 料箱中的跨类别相似性、错误 CAD 检索与 long-tail inventory 仍需另测。若一箱同时出现尺寸接近、局部几何相似的不同零件,object ID 与 pose 的耦合会更强。
seen / unseen 的前端和计算链路不同
YOLOX 与 SAM-6D mask prior 不同,RGB 回归与 RGB-D registration 的输入也不同。缺少 GT-mask upper bound、统一 proposal 对比和 runtime / memory 表,使我们无法精确分解:多少误差来自 detection,多少来自 pose,本体又有多少来自 depth corruption。
数据统计存在版本不一致
22.5K、11.25K、273K、91K 与平均 22 / 24 实例同时出现。它不一定代表数据错误,可能只是相机、双遍和版本的计数层级不同;但 benchmark 论文应提供一张明确的维度分解表,例如 scene × arrangement × viewpoint × sensor × pass × modality。
缺少难度因子的受控分桶
Table 4 证明整体很难,却没有按 visibility、instance density、symmetry、material reflectance、sensor、depth completeness 或 object size 给 AP 曲线。没有这些分桶,算法研究者只能知道“失败了”,难以判断下一步应优先改 mask、特征、几何注册还是 uncertainty calibration。
9.3 可能的隐含偏差
50 个机器人视点在半球上采样,但训练 / 验证 / 测试是否存在强相关视角或同一背景纹理,需要 manifest 才能确认。
同一场景 pose 被传播到许多视图,frame 数很大但独立物理配置只有 75 个;统计有效样本量不等于图像数量。
synthetic training 与真实对象共享精确 CAD,属于 model-based 闭集几何泛化,不测试 CAD 缺失、扫描误差或制造差异。
以 centroid Hungarian matching 量化标签误差时,密集同类实例若中心很近,assignment 的稳定性可能影响统计;论文未给匹配阈值敏感性。
10. 复现与使用清单
10.1 最低复现输入
官方 release 对应的 15 个 CAD、尺度与对象坐标系;
每传感器相机内参、畸变参数和跨相机外参;
BOP scene / image / GT / mask / symmetry metadata;
synthetic train、real validation 与 test image manifests;
官方 BOP 2024–2025 2D / 6D detection evaluator;
与 Table 4 对应的 baseline 权重、模板渲染参数和 score threshold。
10.2 首先要做的数据完整性检查
按 scene、view、camera、pass 和 modality 统计文件数,解释 22.5K 与 11.25K;
按 object、camera、split 统计 pose instances,解释 273K 与 91K;
随机投影 CAD 到 RGB / depth,确认内外参与单位为 mm;
检查 raw 与 anti-reflection capture 的像素 / 3D 对应误差;
检查 symmetry transformations 是否与 CAD canonical frame 一致;
确认 test GT 未被本地训练或调参读取;
记录下载日期、release tag 与许可文本。
10.3 公平 baseline 建议
建议至少报告三层结果:
GT mask + pose backend:估计 pose 本体上限;
同一 detector / mask + 不同 pose backend:隔离后端能力;
各方法官方完整 pipeline:衡量实际部署可用性。
同时补充每图 latency、显存、模板预处理成本与 refinement 迭代次数。工业 bin-picking 往往需要 throughput,仅有 AP 无法判断系统是否能上线。
10.4 建议增加的诊断分桶
分桶变量 为什么重要 推荐图表 visible surface ratio 直接量化遮挡 AP–visibility 曲线 每图实例数 区分普通 clutter 与高密度堆叠 AP–density 曲线 raw depth valid ratio 隔离反光对几何注册的影响 AP–depth completeness 曲线 对称类型 区分连续、离散与无对称 分组 MSSD / MSPD AP 传感器 评估消费级与工业 depth domain 三传感器并列表 object diameter / visible pixels 识别小物体与远距离问题 尺度分桶 AP GT mask / predicted mask 分解 detection 与 pose oracle-mask gap
11. 可继续发展的研究方向
11.1 用多传感器一致性替代喷涂依赖
三类 depth sensor 对材质失效模式不同。可以把跨传感器一致性、机器人已知运动和 CAD render 组成自监督目标,在原始反光表面上恢复可信 depth / normals,减少标签阶段的表面处理成本。
11.2 显式建模 depth invalidity 与不确定性
与其把缺失 depth 直接填平,可让网络预测每像素的有效性与各向异性噪声,再把 uncertainty 传入 correspondence weighting、PnP / registration 和最终 pose covariance。工业机器人可以据此决定抓取、换视角或放弃。
11.3 把实例分割与 pose 作为联合数据关联
密集同类实例中,先分割再 pose 的级联容易把一个错误 mask 固化。可维护多个 segmentation–pose 联合假设,让 CAD 渲染一致性、可见表面和物理不穿透约束反向修正实例边界。
11.4 利用料箱物理约束
零件必须位于 bin 内、不能大面积相互穿透,并遵循重力稳定性。单帧视觉不确定时,可把这些约束加入多实例 pose optimization,尤其适合回转对称或严重遮挡对象。
11.5 主动视角规划
XYZ-IBD 的 50 个视点天然适合研究 next-best-view。系统可根据 pose hypothesis、对称歧义与 depth 缺失选择下一相机位姿,而不是被动接受一个最困难视图。
11.6 真实标签的不确定性传播
benchmark 不应只给单一 GT pose。若能依据标定 covariance、ICP Hessian、可见表面和对称性为每个标签估计 S E ( 3 ) SE(3) S E ( 3 )
11.7 从单 SKU 扩展到 mixed-SKU 与 CAD retrieval
真实仓储常把多个相似零件混在一起。下一步可加入 CAD library retrieval、unknown rejection 与 pose 联合评测,让 object ID 错误不再被预先给定候选集合掩盖。
12. 对做研究的具体启发
如果研究 synthetic-to-real
不要只随机纹理和光照;应显式模拟 active depth 的孔洞、飞点、视角相关高光与传感器类型,并用真实 raw / anti-reflection 对照来校准噪声模型。
如果研究 novel-object pose
XYZ-IBD 是比家庭数据更有区分度的压力测试。报告时需写清 CAD 已知、是否使用 depth、mask 来源、refinement 次数和 template 数量,避免把不同计算预算混成一个“zero-shot”标签。
如果研究检测或分割
平均 22、最高 60 个同类实例使它适合研究 proposal recall、实例边界和 object-ID calibration。除了 AP,还应报告每图 GT 数与预测数、拥挤区域 recall 及错 ID confusion。
如果研究机器人抓取
BOP AP 是必要但不充分的代理指标。建议把 pose 输入 grasp planner,进一步报告碰撞率、抓取成功率、放置误差和每次决策耗时;对对称对象,抓取等价性可能与视觉 symmetry set 不完全相同。
如果建设自己的数据集
最值得复用的不是某一台传感器,而是四层分工:高质量标签观测、真实测试观测、共享机器人位姿和独立误差复刻。最需要补强的是对真实标签做小规模外部计量,并公开清晰的维度计数表。
13. 最终评价
贡献强度
XYZ-IBD 对 6D pose 社区的贡献是一个工业域压力测试与标签工程方案 。15 个对象不算大规模类别覆盖,但 75 个真实重排、密集重复实例、反光原始观测、三传感器和 BOP-compatible seen / unseen 评测组合起来,足以暴露家庭 benchmark 上不明显的系统性失败。
证据可信度
数据难度:强。硬件、场景、Figure 2 / 7 与跨 benchmark AP 下降相互支持。
标签流程:强。标定、喷涂、多视图融合、人工和 ICP 步骤描述完整。
“真实标签 sub-mm”结论:中等。仿真闭环比规格推断可靠,但仍缺真实物理 GT 的直接抽检;0.999 mm 也没有明显裕度。
方法比较:中等偏强。Table 4 覆盖代表性 seen / unseen 方法,但前端与计算条件没有完全统一。
可复现性:取决于数据 release、evaluation server、版本 manifest 与 baseline 配置是否完整公开。
推荐使用方式
如果研究对象是工业 bin-picking、反光 / 无纹理零件、dense multi-instance pose、novel-object RGB-D registration 或 pose uncertainty,应把 XYZ-IBD 列为重点 benchmark。最有信息量的实验不是只报一个总 AP,而是同时报告 oracle-mask、统一前端、可见率 / depth 有效率分桶和真实机器人成功率。
最简结论
这篇论文证明的是:在已知 CAD、目标对象 synthetic training 和强泛化基础模型都可用的条件下,真实反光金属料箱仍会让 6D detection AP 大幅下降;它提供了一套有工程说服力的高精度标签方案,但“约 1 mm”应被理解为仿真复刻的流程级均值估计,而非全部真实标签的逐项物理认证。