论文精读笔记:ZeroPose: CAD-Prompted Zero-Shot Object 6D Pose Estimation in Cluttered Scenes
1. 基本信息
- 作者:Jianqiu Chen, Zikun Zhou, Mingshan Sun, Rui Zhao, Liwei Wu, Tianpeng Bao, Zhenyu He
- 机构:Harbin Institute of Technology, Shenzhen;Pengcheng Laboratory;SenseTime Research
- 发表:IEEE Transactions on Circuits and Systems for Video Technology(TCSVT)35(2), 1251—1264, 2025;arXiv v1 于 2023 年提交,本文按 2024 年修订的 v3 阅读
- 论文:arXiv / PDF / DOI
- 代码 / 项目页:论文与 arXiv 页面未给出作者公开代码或项目页
- 阅读模式:精读
2. 一句话定位
ZeroPose 是一个面向训练未见刚性实例的 CAD-based RGB-D 完整 pipeline:以 CAD 离线生成的视觉和几何 embeddings 作为 prompt,用 FastSAM + DINOv2 发现杂乱场景中的所有目标实例,用 patch matching 估计 observation viewpoint 并裁出 CAD 可见面,再用 coarse-to-fine 3D correspondence、weighted SVD 和 Chamfer ranking 得到每个实例的 6D pose。
方法输入与输出
| 项目 | 内容(本站整理) |
|---|
| 推理输入 | 场景 RGB-D、内参 K,以及每个目标 CAD 对应的 cached image / patch / geometric prompts。模板由已知尺度 CAD 离线渲染,不是待估计的场景几何。 |
| 最终输出 | Discovery 的 mask / object ID 与 Registration 的 R,t;最终 xcam=RxCAD+t。 |
| 训练输入 | GSO 等训练对象 CAD、带 GT pose 的合成 RGB-D,以及由几何生成的点对应监督;预训练视觉模型另有其原始预训练数据。 |
| 训练目标 | 训练 Geo model 与 hierarchical matching network 学习可泛化的点云特征和对应;测试 CAD onboarding 仅渲染、提取并缓存特征,不为新对象更新权重。 |
| 输出细节 | 输出一个被选中的刚体 pose,不是完整姿态分布。Orientation 的 top-k 可见视角只是中间假设;点云按 CAD 半径归一化后配准,导出 t 需恢复 CAD / depth 的实际长度尺度。 |
| 必要条件 | 完整 DOR 不要求外部目标 mask;只测后端或 partial zero-shot 时要另列 mask 来源。RGB、depth、相机标定和正确尺度 CAD 缺一不可。 |
2.1 论文图表导读
| 图表 | 回答的问题 | 关键结论 |
|---|
| Figure 2 | ZeroPose 的输入、三步输出和 CAD prompt 在哪里进入? | DOR 将 detection / segmentation 与 pose 串成一条链 |
| Figure 3 | 三类 embedding 如何贯穿完整 pipeline? | image / patch / geometry 分别负责 identity、visibility、rigid alignment |
| Figures 4—6 | onboarding、Discovery、Registration 如何实现? | 新物体不重训,但必须渲染模板并缓存特征 |
| Tables I—II | 主结果是否真是 fully zero-shot? | 必须按 discovery、pose、refiner 三个条件分组阅读 |
| Figure 8;Tables III—VIII | 性能来自哪些设计?代价是什么? | 42 views、top-5 visibility hypotheses、几何层级匹配和尺度归一化共同生效 |
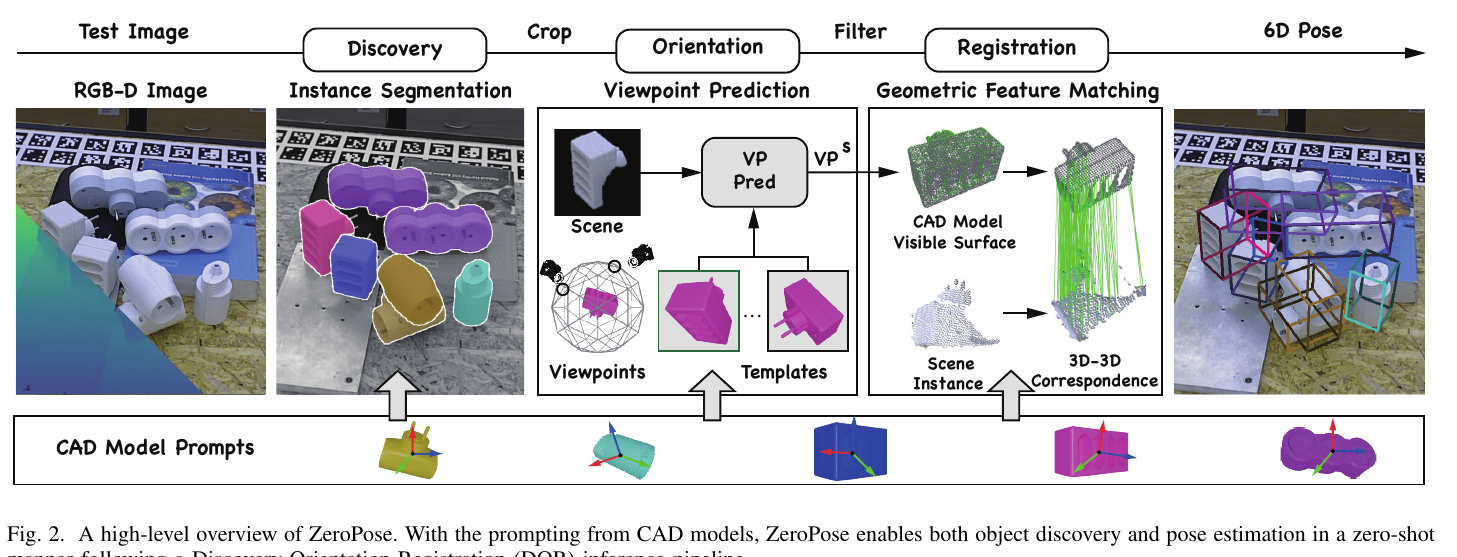 原论文 Figure 2:DOR 不是三个同质的 pose stage。Discovery 输出实例 masks,Orientation 输出可见面候选,Registration 才建立 3D--3D 对应并求最终 pose;底部 CAD prompts 为三步提供统一目标身份。来源:arXiv。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
3.1 几何任务
给定 CAD 坐标系中的表面点 xo,目标是恢复相机坐标系中的刚体变换
xs=Rxo+t,R∈SO(3), t∈R3.
ZeroPose 还要求输出场景中每个目标实例的 mask 与 object ID,因此它评测的不只是已知 crop 上的 pose regression。
3.2 训练与推理输入
| 阶段 | 输入 | 输出 |
|---|
| 通用训练 | GSO CAD、100 万张带 pose 的 MegaPose 合成 RGB-D、对应点监督 | 可泛化的 KPConv Geo model 与 hierarchical matching network |
| 每物体 onboarding | 带尺度 CAD、renderer、预定义 viewpoints | RGB-D templates;image / patch / geometric embeddings |
| 场景推理 | RGB-D、camera intrinsics、一个或多个目标 CAD prompts | 所有目标实例的 mask、ID、R,t |
- 任务层级:instance-level。CAD 指定的是某个具体物体,不是“杯子”类别的共享 canonical space。
- 对象设定:unseen object。测试物体不参与目标专用训练,但其 CAD 在推理前已知。
- 模态:RGB 用于 proposal association 与 viewpoint selection;depth 用于 scene / CAD point cloud;内参用于 2D depth 回投影。
- 无需的输入:完整 DOR 不要求人工给 query box / mask,也不假定每种物体只有一个实例。
- 仍然需要的先验:metric CAD、正确坐标系和尺度、RGB-depth calibration、可用深度、离线模板渲染。
3.3 “zero-shot”有两层协议
论文将条件拆得较清楚:
- partial zero-shot:pose model 对目标物体 zero-shot,但 object discovery 使用该数据集的 object-specific Mask R-CNN。此协议适合隔离 pose 后端能力。
- fully zero-shot:Discovery 和 pose 都不针对目标物体重训,由 ZeroPose 自己从 FastSAM proposals 中识别目标并估计 pose。
因此“ZeroPose 不需要 mask”只适用于完整 DOR;Tables II 的 rows 7 / 11 仍使用 object-specific discovery,不能与 rows 17 / 18 混为一个系统数字。
3.4 对称性与多解
- 评测采用 VSD、MSSD、MSPD,BOP 协议在度量层面对对象对称性更公平。
- 方法本身通过 correspondence + SVD 输出单个 R,t,没有显式 symmetry-aware correspondence loss、pose distribution 或等价解集合。
- top-k 是 observation viewpoints 的多假设,不等同于对称旋转的概率建模。
4. 研究脉络
- object-specific pose:PoseCNN、CosyPose、SurfEmb 等通常为目标对象训练 detector / pose model,换物体需要重新 onboarding。
- unseen-object pose:OVE6D、OSOP、MegaPose 等尝试让 pose network 对新 CAD 泛化,但常以外部 detection / segmentation 为入口,或依赖 render-and-compare。
- CAD-based novel-object segmentation:ZeroPose 的 v3 将 SAM / FastSAM proposals 与 DINOv2 CAD template matching 结合;后续 CNOS 与 SAM-6D 将这一前端方向进一步系统化。
- 本文位置:它较早把 CAD prompting、foundation segmentation、foundation visual features 和 learned 3D registration 串为完整 DOR,重点是减少 target-specific training 与在线多假设渲染。
- 与类别级方法不同:NOCS、SGPA、AG-Pose 等从类别共享形状空间处理同类未见实例,通常没有该实例自己的 CAD;ZeroPose 的 instance identity 与 metric geometry 都由 CAD 明确给定。
5. 研究动机
- 新物体 onboarding 不应再等同于训练模型。 CAD 已包含几何、尺度和 object frame,理想系统只需将其转换为可复用 prompt。
- “pose 可泛化”不等于“系统可部署”。 如果仍需用户给每个实例 mask,杂乱、多实例场景的前端成本没有解决。
- 不同子问题应使用不同特征。 全局 DINOv2 embedding 适合判断“这是哪个物体”,局部 patch embedding 适合判断“看到哪一面”,最终 metric pose 更适合由深度几何对应约束。
- 完整 CAD 对 partial scene 是不对称匹配。 当前不可见的 CAD 背面会成为系统性 outlier;先预测视角再做 surface filtering,可把 registration 变成更接近 partial-to-partial 的问题。
- 在线 renderer 是可避免的。 论文把模板和 embeddings 在 onboarding 阶段缓存,场景推理主要变为 feature lookup / matching。
6. 方法详解
6.1 总体 Pipeline
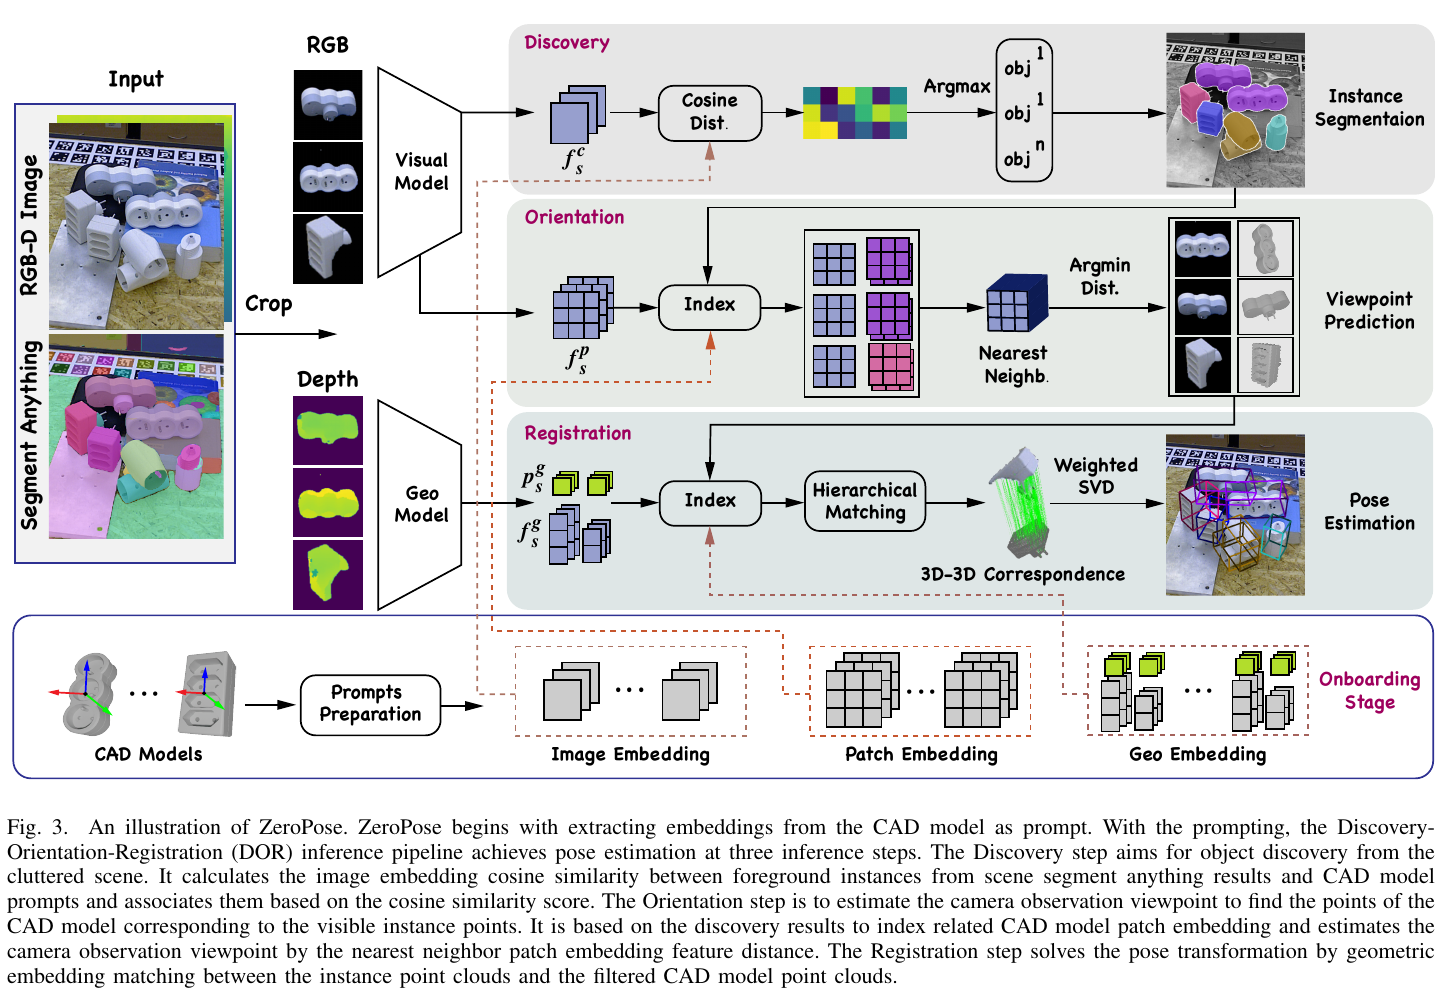 原论文 Figure 3:CAD onboarding 缓存 image、patch 和 geometric embeddings;DOR 依次把它们索引到 scene proposals、viewpoint candidates 和可见 CAD point cloud,最终以 weighted SVD 输出 pose。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 模块 | 输入 | 输出 | 作用 | 与下一模块如何衔接 |
|---|
| CAD onboarding | metric CAD、viewpoints、renderer | 三类 cached prompts | 把目标专用信息从“训练权重”移到“检索库” | Discovery 按 object ID 检索 visual prompts |
| Discovery | RGB、FastSAM masks、image embeddings | mask、object ID、score | 找到同一 CAD 对应的所有 scene instances | mask crop 与 CAD ID 进入 Orientation |
| Orientation | scene / template patch embeddings | top-k viewpoints、visible CAD surfaces | 排除当前不可见 CAD 区域 | 每个可见面形成一个 registration hypothesis |
| Registration | RGB-D scene crop、visible CAD points、Geo model | 3D correspondences、candidate R,t | 用 metric geometry 求刚体变换 | Chamfer distance 选择最终 pose |
6.2 CAD Onboarding:三种 prompt、一次缓存
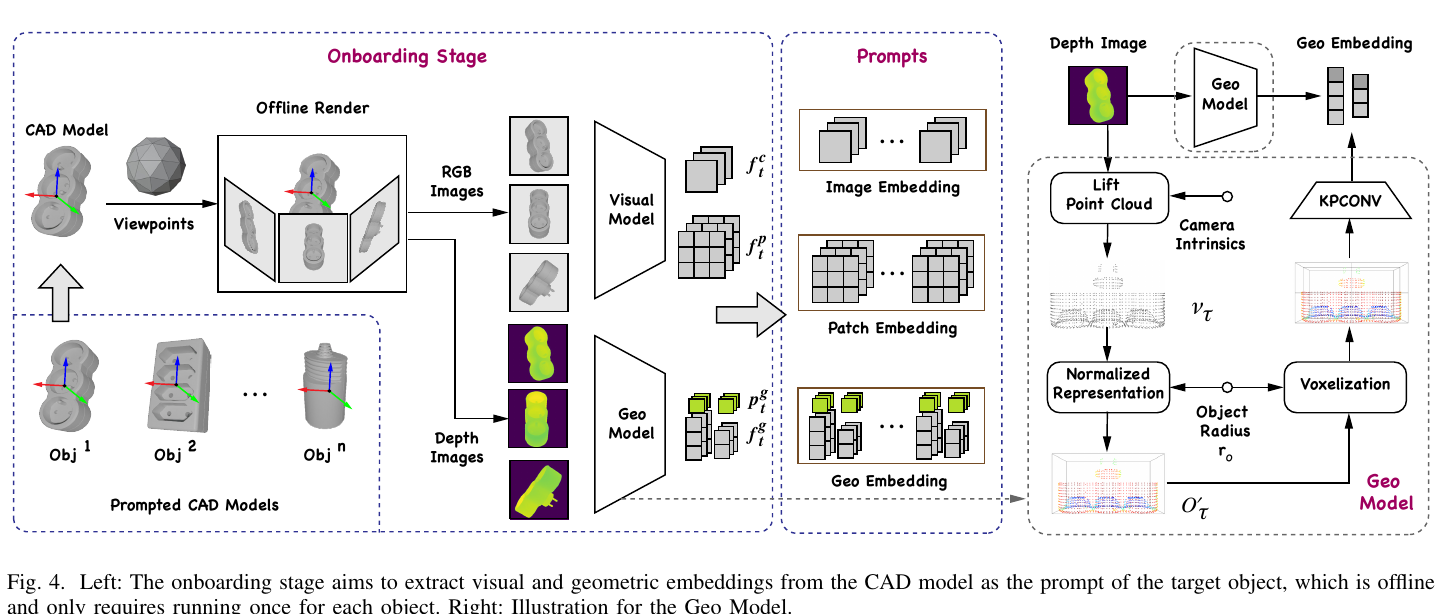 原论文 Figure 4:默认对 CAD 渲染 42 个 RGB-D viewpoints。RGB templates 产生 DINOv2 image / patch embeddings;depth templates 经相机内参回投影、CAD 半径归一化与 KPConv voxel hierarchy 后产生 geometric embeddings。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
设每个 CAD 有 R 张模板、视觉特征维度为 C:
- image embeddings:ftc∈RR×C,用于跨 proposal 的全局 object association;
- patch embeddings:ftp∈RR×Pl×C,用于局部 viewpoint matching;
- geometric embeddings:{ptg,ftg},同时保留 coarse / fine point coordinates 与 KPConv features。
每个模板 depth 先按已知 template pose 逆变换回 CAD base frame。为处理未见对象的尺寸变化,令 rO 为 CAD 外接球半径,scene 与 template point clouds 同时缩放到 1/rO 的 normalized space。这样 KPConv 的 voxel size 与 receptive field 在不同物体上具有一致的相对尺度。
工程含义:这是 target-specific preprocessing,不是 target-specific learning。论文默认 42-view Blender onboarding 为 27.0 s / object,其中渲染 26.5 s、特征提取 0.5 s,模板特征缓存约 0.16 MB。该成本可摊销到后续多帧推理,但不能在大物体库中忽略。
6.3 Discovery:FastSAM proposal + CAD image retrieval
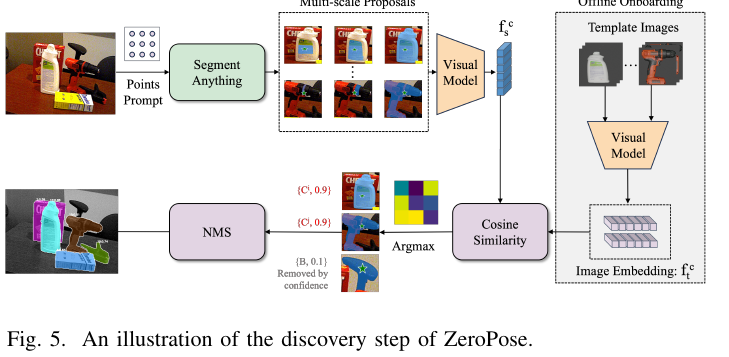 原论文 Figure 5:point prompts 驱动 SAM / FastSAM 产生 multi-scale proposals;scene crops 与离线 CAD templates 的 image embeddings 做 cosine matching,再以置信度阈值和 NMS 清理重复及过 / 欠分割 masks。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
对第 m 个 scene proposal feature fs,mc,在所有 CAD n 与模板视角 T 中寻找最大 cosine similarity:
n^m=argnmaxTmax∥fs,mc∥2∥ft,n,Tc∥2fs,mc⋅ft,n,Tc.
最高分决定 object ID 与 proposal score。实现采用 FastSAM 默认 CNN backbone,过滤小于 128 pixels 的区域,并以 mask IoU 0.25 做 NMS。
为什么不用 text prompt? BOP 中不少工业零件没有稳定、可区分的自然语言名称。论文的 ImageBind text-prompt 版本只有 15.0 mAP,CAD-image prompt 为 30.4,DINOv2 CAD-image prompt 达到 37.8,说明“具体实例外观”比类别词更适合这一设定。
风险:这仍是 proposal-first pipeline。若 FastSAM 没有生成覆盖目标的 mask,后续 CAD matching 无法恢复该实例;如果相似 CAD 的 templates 在 DINOv2 空间混淆,错误 object ID 会把错误 geometry 送入 pose 后端。
6.4 Orientation:将 3-DoF 旋转先压成 2-DoF 可见方向
相机 observation rotation 被分解为
RO=RγRθ,
其中 Rγ 表示 image plane optical axis direction,Rθ 是绕 optical axis 的 in-plane rotation。物体表面的“可见 / 不可见”主要由 Rγ 决定,因此 Orientation 不直接回归完整 rotation,而只在球面离散 viewpoints 中寻找接近的可见方向。
对 scene crop 的每个 patch,找到某 template 中最相似的 patch,再平均这些局部最大相似度:
STp=Ns1j=1∑Nsimax∥fs,jp∥2∥ft,ip∥2fs,jp⋅ft,ip.
按 STp 排序取 top-k,同时用 patch similarity 和 estimated visibility 修正 Discovery score。论文默认 k=5。每个候选模板的 depth 定义一份 visible CAD surface,供下一步独立注册。
关键澄清:Orientation 的模板 rotation 不是最终 pose。由于它只覆盖 2-DoF viewpoint、没有解决 in-plane rotation 与精确 translation,直接把模板位姿当答案在 Table V 只有 24.4 AR。
6.5 Registration:归一化几何、层级对应、加权 SVD
mask 内像素 (ui,vi) 与 depth di 由相机内参回投影:
xi=difxui−cx,yi=difyvi−cy,zi=di.
scene points 还拼接 RGB 作为 texture feature。每个 visible CAD surface 与 scene cloud 经 CAD 半径归一化、centroid clustering 去噪和 KPConv 层级特征提取。
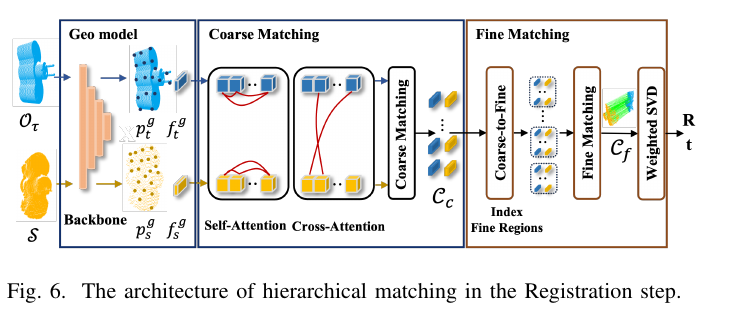 原论文 Figure 6:KPConv backbone 提供 coarse / fine points 与 features;self-attention、cross-attention 先建立 coarse correspondences,再索引局部 fine regions 做稠密匹配,最后由 weighted SVD 求 $R,t$。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Hierarchical Geometric Matching(HGM)先用 coarse features 交互并筛出 Cc,再利用 coarse receptive fields 索引 fine-level points,得到 Cf。最终求解
R,tmin(oi,si)∈Cf∑wi∥Roi+t−si∥22,
由 weighted SVD 给出闭式解。对 top-k visible surfaces 各得一个候选 pose,再将 CAD 变换到 scene frame,按 Chamfer distance 选择最终结果。
这条链路的优点是最终 pose 仍由显式 metric correspondence 决定,便于查看哪一层出了错;缺点是早期 mask / ID / viewpoint error 会层层传播。
6.6 训练方式与监督
- 不是整体 training-free:DINOv2 与 FastSAM 使用预训练权重;Geo model 与 HGM 还在 GSO 合成数据上训练。
- 训练数据:1,000 个 GSO objects、100 万张 MegaPose synthetic images。
- 高层匹配监督:依据 GT pose 计算 point-cloud overlap,overlap 超过 10% 的 region pairs 作为 positive,使用 overlap-aware circle loss。
- 低层匹配监督:按空间 matching radius 定义 fine correspondences,以 negative log-likelihood 训练。
- 增强:color jitter 与 position jitter,缓解合成 / 真实的光照、颜色和位置差异。
- 算力:论文报告用 8 张 NVIDIA V100 训练,场景推理在 RTX 3090 上测量。
训练目标是 correspondence quality,而最终评价是 symmetry-aware pose AR;二者通过 SVD 间接连接,并非直接优化 BOP AR。论文没有把 DOR 三步联合端到端训练,这也是作者明确列出的限制。
7. 实验分析
7.1 数据集与指标
| 用途 | 数据 | 说明 |
|---|
| Geo / HGM 训练 | GSO + MegaPose synthetic | 1,000 objects、1M images |
| 主测试 BOP7 | LM-O、T-LESS、TUD-L、IC-BIN、ITODD、HB、YCB-V | 真实 RGB-D,形状、纹理、遮挡和 clutter 差异大 |
| 消融 BOP5 | LM-O、T-LESS、TUD-L、IC-BIN、YCB-V | 可离线访问的五个数据集 |
- segmentation 使用 BOP instance segmentation mAP。
- pose 使用 VSD、MSSD、MSPD 三类 symmetry-aware errors 的平均 recall,即 BOP AR。
- YCB-V 另报告 ADD-S 2 cm;在相同 masks 下 ZeroPose 为 96.6,接近 object-specific DenseFusion 的 96.8。
- 时间必须结合硬件、mask 来源和是否 refiner 阅读。
7.2 主结果与协议公平性
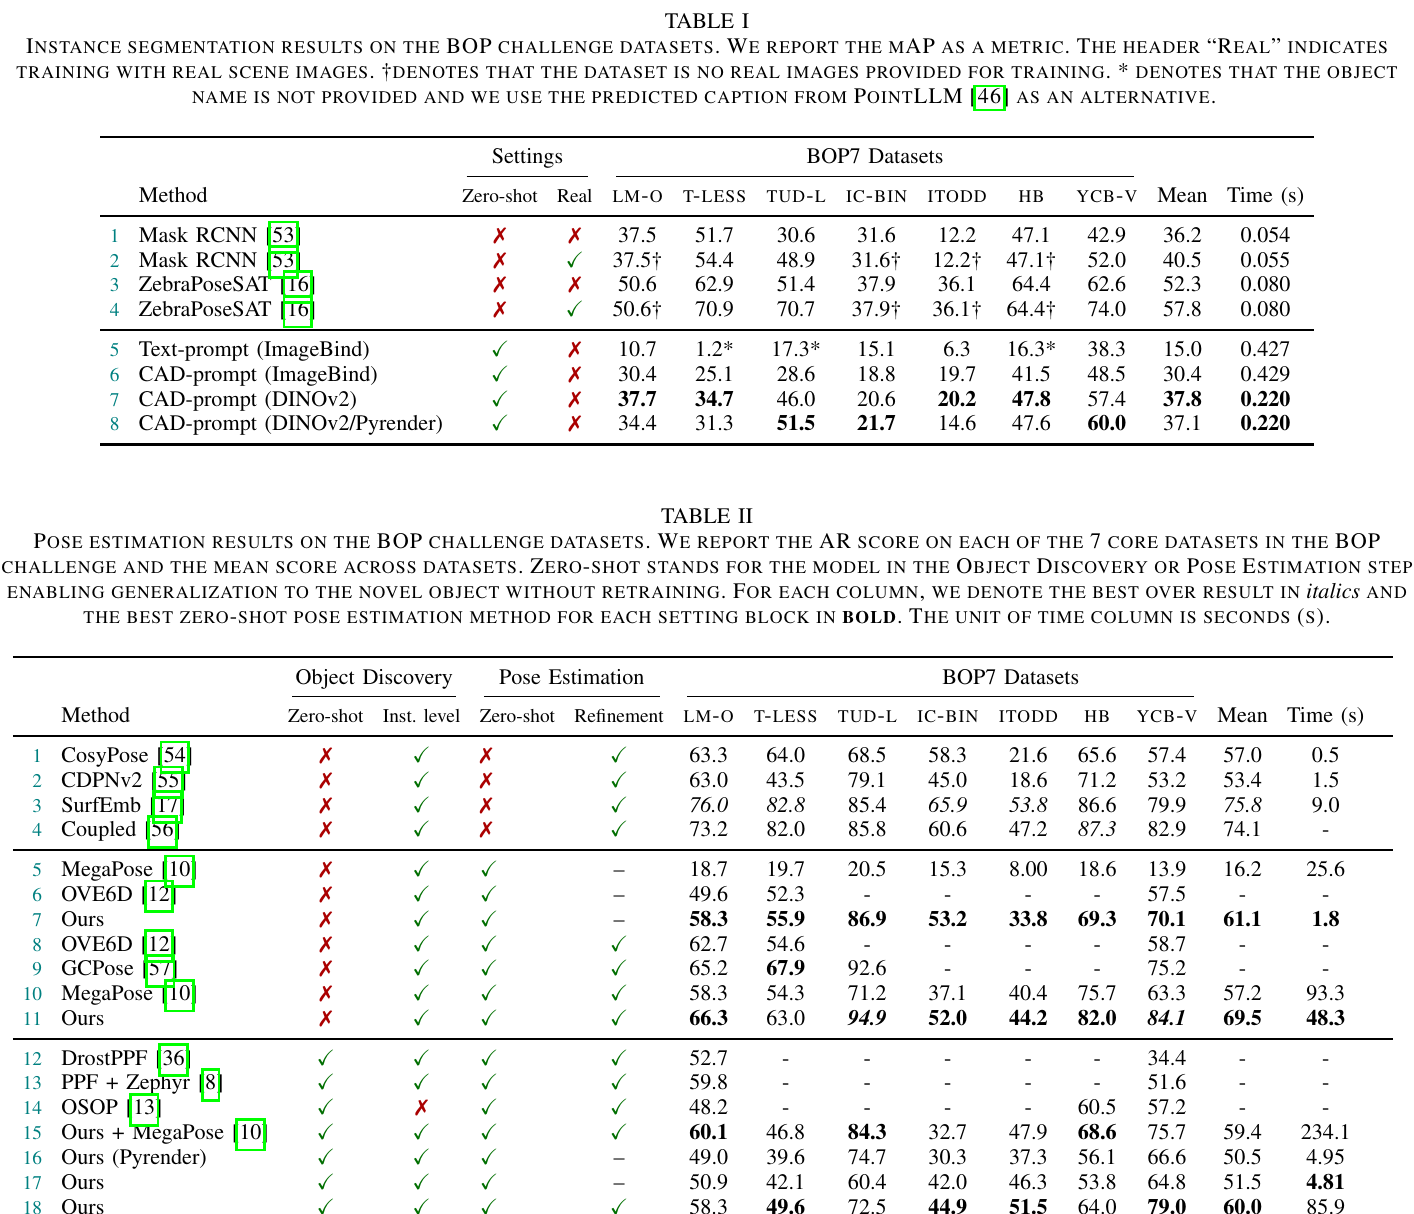 原论文 Tables I--II:Table I 比较 object-specific、text-prompt 与 CAD-prompt segmentation;Table II 明确列出 Discovery 是否 zero-shot、是否 instance-level、pose 是否 zero-shot、是否 refinement。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Object discovery
| 方法 | 是否目标专用训练 | BOP7 mAP | 时间 |
|---|
| Mask R-CNN,无 real images | 是 | 36.2 | 0.054 s |
| ZebraPoseSAT,无 real images | 是 | 52.3 | 0.080 s |
| text-prompt ImageBind | 否 | 15.0 | 0.427 s |
| CAD-prompt ImageBind | 否 | 30.4 | 0.429 s |
| CAD-prompt DINOv2 | 否 | 37.8 | 0.220 s |
CAD-prompt DINOv2 达到不使用 real images 的 Mask R-CNN 水平,但仍明显落后 ZebraPoseSAT 52.3。因此作者“无需目标专用训练且可用”的主张得到支持,“zero-shot segmentation 已追平最强监督前端”则不成立。
Pose
| 协议 | 方法 | BOP7 mean AR | 时间 | 结论边界 |
|---|
| object-specific discovery;zero-shot pose;无 refiner | MegaPose | 16.2 | 25.6 s | 论文中的 initialization 配置 |
| 同上 | ZeroPose | 61.1 | 1.8 s | 支持几何 feature matching 的效率与初始化质量 |
| object-specific discovery;带 refiner | MegaPose | 57.2 | 93.3 s | 额外 refinement |
| 同上 | ZeroPose | 69.5 | 48.3 s | 更高精度但非轻量实时 |
| fully zero-shot;无 refiner | ZeroPose | 51.5 | 4.81 s | 最代表完整 DOR |
| fully zero-shot;带 MegaPose refiner | ZeroPose | 60.0 | 85.9 s | 精度增加 8.5 AR,时间增加约 18 倍 |
对“50x faster”的判断:Table II 的 rows 5 / 7 为 25.6 s 与 1.8 s,按原始数字约 14.2 倍;作者文字还称 98% runtime reduction / 50x improvement,可能使用了不同计时口径。网页不应把摘要口号替代具体表格数字。完整 fully zero-shot 行为 4.81 s,也不是实时视频速度。
7.3 模板密度、视角与匹配消融
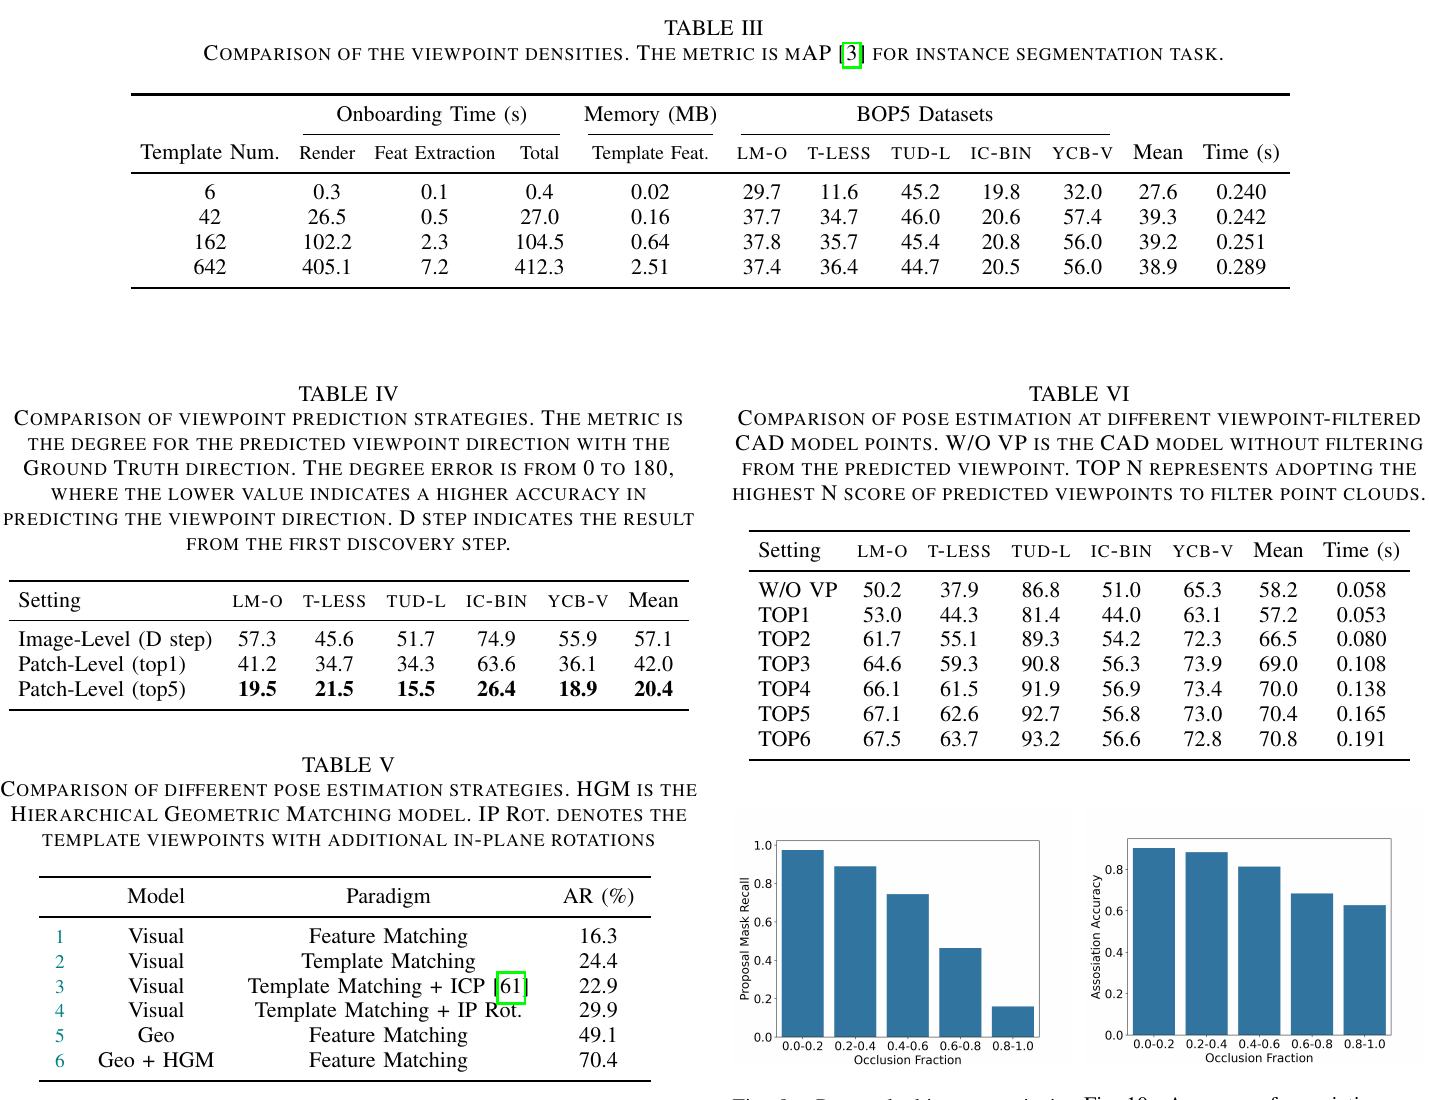 原论文 Tables III--VI 与 Figures 9--10:上表给出每物体模板数量对 onboarding、缓存、mAP 和推理时间的影响;下方比较 viewpoint prediction、pose strategy、top-$k$ visible surfaces,以及遮挡对 proposal recall / association accuracy 的影响。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 消融 | 结果 | 支持的主张 | 我的判断 |
|---|
| 6 → 42 templates | mAP 27.6 → 39.3;onboarding 0.4 → 27.0 s | 稀疏六视图覆盖不足 | 支持,但暴露 preprocessing 成本 |
| 42 → 162 / 642 | mAP 39.3 → 39.2 / 38.9 | 过密 views 无额外收益 | 支持默认 42 views |
| image-level viewpoint → patch top-5 | 57.1° → 20.4° error | 局部 patch 更适合 observation direction | 证据直接 |
| visual feature matching → Geo | 16.3 → 49.1 AR | 几何特征更抗 sim-to-real 外观差 | 支持 |
| Geo → Geo + HGM | 49.1 → 70.4 AR | coarse-to-fine interaction 是关键 | 增益很大,但缺少跨更多训练域消融 |
| no VP filtering → top-5 | 58.2 → 70.4 AR;0.058 → 0.165 s | 可见面过滤减少错误对应 | 支持速度 / 鲁棒性权衡 |
| top-5 → top-6 | 70.4 → 70.8 AR;0.165 → 0.191 s | 更多 hypothesis 收益趋于饱和 | 支持选择 k=5 |
7.4 可见面与尺度归一化
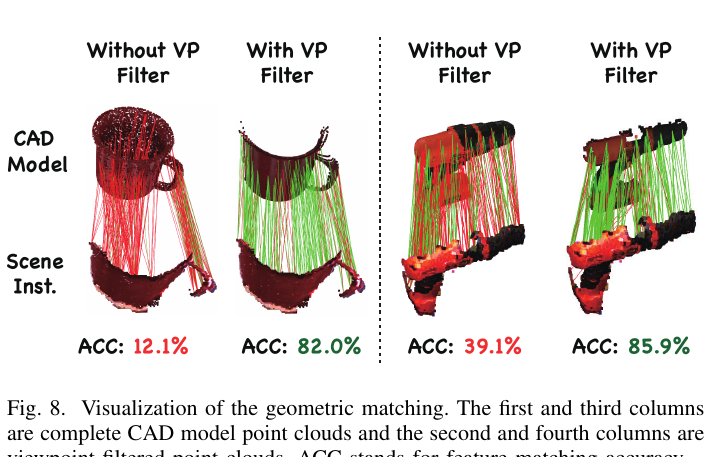 原论文 Figure 8:将完整 CAD 与单视角 scene cloud 匹配时,不可见表面制造大量错误对应;viewpoint-filtered CAD 将两个示例的 feature matching accuracy 从 12.1% / 39.1% 提升到 82.0% / 85.9%。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
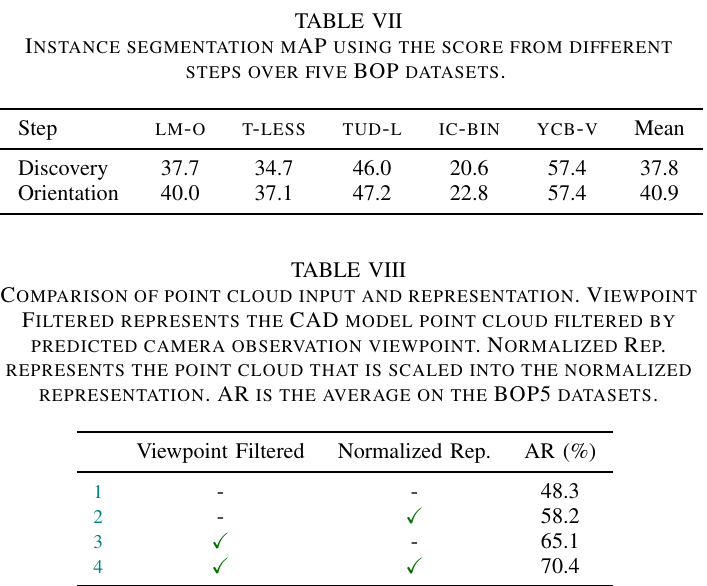 原论文 Tables VII--VIII:Orientation score revision 将 BOP5 segmentation mAP 从 37.8 提高到 40.9;normalized representation 与 viewpoint filtering 分别有效,二者结合使 AR 从 48.3 提高到 70.4。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Table VIII 是整篇最清楚的组件证据之一:
| Viewpoint filtering | Normalization | AR |
|---|
| 否 | 否 | 48.3 |
| 否 | 是 | 58.2 |
| 是 | 否 | 65.1 |
| 是 | 是 | 70.4 |
两者不是重复技巧:visibility 处理 partial overlap,normalization 处理跨对象尺度与 KPConv receptive field。组合仍比任一单项高,说明设计具有互补性。
7.5 定性结果与场景覆盖
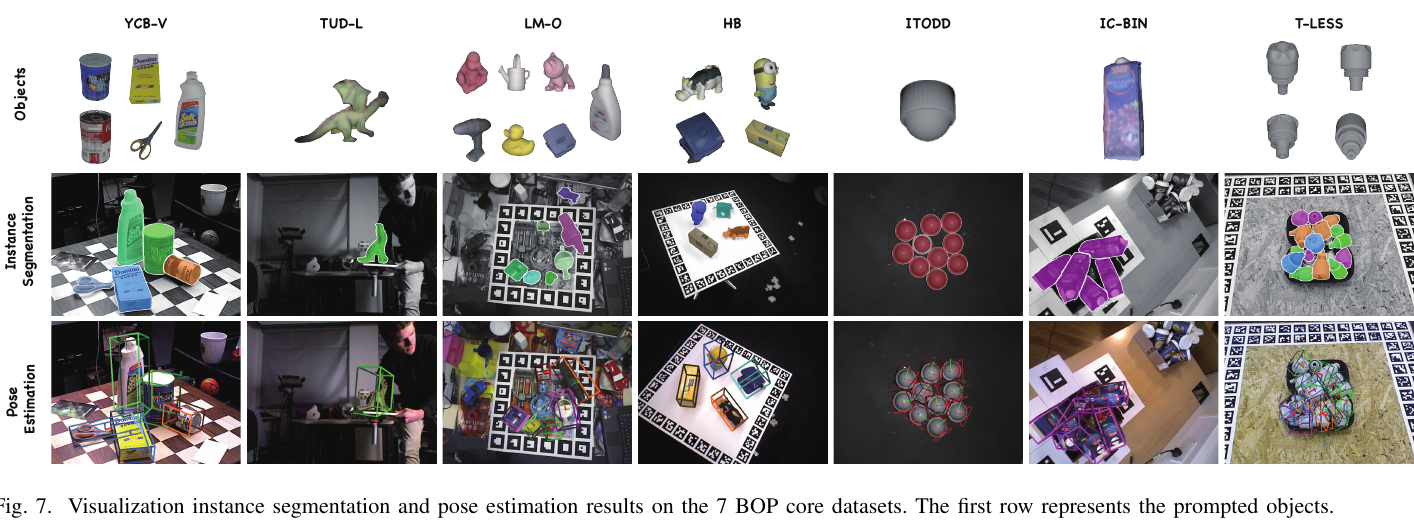 原论文 Figure 7:第一行是 prompts,中间是 instance segmentation,最后是 pose。七个 BOP core datasets 覆盖纹理丰富家居物、弱纹理工业件、多个同类实例和重 clutter。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
定性图证明 pipeline 可在多种 BOP 场景运行,但没有系统展示失败样例,也不能替代 per-object recall、误检类型和 depth quality 分层统计。
7.6 鲁棒性与失败边界
- 遮挡:在 40%—60% occlusion fraction 下,proposal recall 超过 70%、association accuracy 超过 80%;到 80%—100% 时两者显著下滑。Orientation / visibility filtering 只能修正已发现实例,无法补回漏检。
- 过 / 欠分割:论文称 score + NMS 能过滤 88% under-segmentation 与 74% over-segmentation masks;仍有残余 mask contamination 进入点云。
- 弱纹理:最终 pose 依赖 geometric embedding,比纯视觉匹配稳;但 Discovery / Orientation 仍依赖 RGB DINOv2,对外观极相似 CAD 可能混淆。
- 深度噪声:centroid clustering 与 coarse-to-fine matching 提供一定容错,却没有显式 depth uncertainty、RGB-depth misalignment 或 missing-depth model。
- 透明 / 反光:论文未提供专门实验;此类材质会同时破坏 RGB template consistency 和 depth point cloud,是部署高风险对象。
- 对称物体:评价指标 symmetry-aware,但网络输出单 pose,未显式建模多解或 temporal consistency。
- CAD domain gap:Blender 比 Pyrender 略强,说明 render appearance 仍影响 Discovery;几何分支也默认 CAD surface 与实物几何一致。
7.7 贡献是否被实验支撑
| 作者声称 | 证据 | 判断 |
|---|
| 新物体无需重训即可完整 discovery + pose | Tables I—II 的 fully zero-shot block | 基本支持 |
| CAD prompt 比 text prompt 更适合 BOP 实例 | Table I:30.4 / 37.8 对 15.0 mAP | 支持 |
| DOR feature matching 比 render-and-compare 高效 | partial protocol 的时间与 Table V | 支持特定实现对比,不宜泛化为所有 render-and-compare |
| Orientation filtering 改善 partial registration | Figure 8;Tables VI、VIII | 证据充分 |
| 对 clutter / multiple instances 具有适用性 | BOP7 定量与 Figure 7 | 基本支持,但缺少真实机器人闭环 |
| 约 50 倍速度提升 | 摘要与正文口径不完全一致 | 应引用具体表格时间,不直接复述倍率 |
8. 批判性分析
优点
- 问题定义完整:把 CAD-based novel-object segmentation 与 pose 放在同一评测表中,避免“模型可泛化、系统却还要人工 mask”的空缺。
- 三类 feature 的职责合理:global vision、local vision、metric geometry 沿任务难度逐层收紧,不让单一 representation 包办一切。
- Orientation 是有效中间变量:它不必精确到完整 pose,只需为下一步提供 visibility support,减少了离散模板密度。
- 几何可解释性强:point correspondence、weighted SVD、Chamfer ranking 都能被单独检查和替换。
- 消融覆盖成本:不仅报告 AR,还报告 onboarding、缓存、top-k runtime 与 refiner time。
缺点
- 无官方代码:renderer convention、CAD unit、feature layer、voxel sizes、score thresholds、训练采样等复现细节难以确认。
- 三步独立:作者也明确承认 DOR 不能端到端联合训练;上游 confidence 没有被后端 pose error 直接校准。
- 完整系统仍较慢:无 refiner 4.81 s / image,带 refiner 85.9 s;适合离线 / 低频重定位,不适合高频控制环。
- 硬件与数据依赖:推理需要 RGB-D、metric CAD、内参和离线 renderer / cached prompts;8 张 V100 是论文报告的 synthetic pretraining 配置,不应当作部署最低硬件要求。
- 失败分析不足:缺少透明 / 反光、错误 CAD 尺度、深度空洞、RGB-depth misalignment、相似 CAD 库规模等压力测试。
- 速度表述需谨慎:摘要倍率与 Table II 可直接计算的倍率不一致,应保留具体 protocol 和秒数。
隐含假设
- CAD 与实物的尺度、几何和 object coordinate frame 一致,模板材质足以让 DINOv2 跨 sim-to-real 识别。
- 当前单帧有足够可见像素让 FastSAM 分割,也有足够非退化 3D 表面支持刚体配准。
- 目标库规模不会让所有 proposal 与所有 CAD templates 的匹配成本和 false-positive rate 失控。
- 相机内参、depth scale 和 RGB-depth registration 已可靠标定。
真实应用可行性
ZeroPose 适合仓储、工业 bin-picking、低频重定位等“目标 CAD 已知、RGB-D 可用、允许离线 onboarding”的场景。要进入闭环机器人系统,还需要:
- 以 tracking / temporal fusion 摊销每帧 FastSAM 与全局检索;
- 对 pose confidence、对称多解和遮挡失败做显式建模;
- 加入 CAD scale / depth calibration sanity check;
- 将 object library 检索做层级索引,避免 proposal 数 × 物体数 × 模板数线性增长;
- 在真实抓取 success rate、collision margin 与 latency 上评测,而不只看 BOP AR。
9. 未来工作与可改进方向
- 论文自身方向:构建大规模真实 pose 数据,探索将 Discovery、Orientation、Registration 端到端联合;把 detection、tracking、instance segmentation 与 pose 做 multi-task learning。
- 更稳的前端:同时保留多个 mask / object-ID hypotheses,让 registration geometry 反向验证,而不是在 Discovery 早期做不可逆 argmax。
- 可见性建模:用 differentiable rendering 或 learned visibility confidence 替代单一 discrete viewpoint,显式标注 self-occlusion、external occlusion 与 invalid depth。
- 几何 uncertainty:让 SVD correspondence weights 同时考虑 feature confidence、depth noise、surface normal 与 mask boundary distance。
- 对称感知:在 HGM loss 和 hypothesis ranking 中引入 symmetry-equivalent transforms,输出 pose set 或分布。
- CAD 质量鲁棒性:测试错误 scale、mesh simplification、缺失零件、材质不一致,并将 CAD alignment 误差纳入置信度。
- 速度:用轻量 proposal、scene feature cache、物体库 ANN retrieval 和 tracking,将完整 pipeline 从秒级降到视频可用。
- CAD-free 扩展:用少量 posed reference RGB-D 或 neural object field 替代 mesh,同时保持 metric scale。
10. 对我的研究的启发
- 可直接借鉴:将“object identity”“visibility support”“metric correspondence”分成三种 representation;把粗 orientation 用于缩小对应集合,而不是直接回归最终 pose。
- 必须加入的 baseline:若研究 RGB-D、known CAD、unseen instance 且需要自行找目标,应报告 ZeroPose、SAM-6D、MegaPose / FoundationPose,并统一 mask 来源与 refiner。
- 评测设计:至少拆成 GT / object-specific masks、external zero-shot masks、自有 zero-shot masks 三档;分别报告 discovery recall、ID accuracy、pose AR、onboarding time 和 end-to-end latency。
- 可形成切入点:让 segmentation 与 registration 双向验证;以多 hypothesis uncertainty 处理相似 CAD 与对称对象;将 visible-surface filtering 与 temporal tracking 结合。
- 复现实务:首先固定 BOP CAD units、renderer camera convention、depth scale 和内参;随后分开验证 templates、Discovery mAP、viewpoint error、correspondence accuracy、SVD pose,避免只看最终 AR。
11. 待解决问题
- 概念问题:作者的“fully zero-shot”是否把 DINOv2 / FastSAM 的大规模预训练数据潜在覆盖视为允许?与 training-free 方法应如何命名区分?
- 公式问题:weighted SVD 的 correspondence weights 如何从 fine matching score 标定,论文正文未给出足够实现细节。
- 实验问题:摘要 50 倍速度与 Table II 的直接比值为何不一致;是否含 onboarding、renderer、detector或 batch 设置差异?
- 泛化问题:GSO 训练 objects 与 BOP test objects 的形状近邻程度如何,是否存在近重复 CAD?
- 部署问题:当物体库扩展到数千 CAD、场景有数百 proposals 时,Discovery 的检索复杂度、内存与误检率如何变化?
- 复现问题:FastSAM point prompt 密度、NMS 细节、DINOv2 variant / layer、KPConv voxel scales、HGM architecture 与 checkpoint 均需要进一步核实。
