1. 基本信息
- 作者 / 机构:Philipp Ausserlechner、David Haberger、Stefan Thalhammer、Jean-Baptiste Weibel、Markus Vincze;TU Wien Automation and Control Institute
- 年份 / 会议:2024 / ICRA
- 论文:arXiv / PDF / DOI
- 阅读模式:精读
2. 一句话定位
ZS6D 将 novel-object pose 拆成“foundation descriptor 检索 + 局部几何对应 + PnP”:同一个未经 pose fine-tuning 的 ViT-S/8 在浅层提供视角级全局描述、在深层提供 patch correspondence,CAD template 的 object-coordinate map 再把 2D–2D match 转成可解 metric pose 的 2D–3D match。
2.1 论文图表导读
| 图表 | 回答的问题 | 阅读重点 |
|---|
| Figure 2 | 完整 pipeline 如何从 RGB 到 pose? | segmentation 与 pose 后端解耦;ViT 用两次 |
| Figure 4 | 在三类 BOP 场景中表现如何? | 绿色正确、红色错误,缺框常源于前端漏检 |
| Figures 5–7 | 模板数和 correspondence 数为何这样选? | 200 views 后趋缓,约 24 个 matches 后接近饱和 |
| Tables I–II | zero-shot 提升来自哪里、上限在哪里? | GT mask 带来 54%–119% 相对增益,前端是显著瓶颈 |
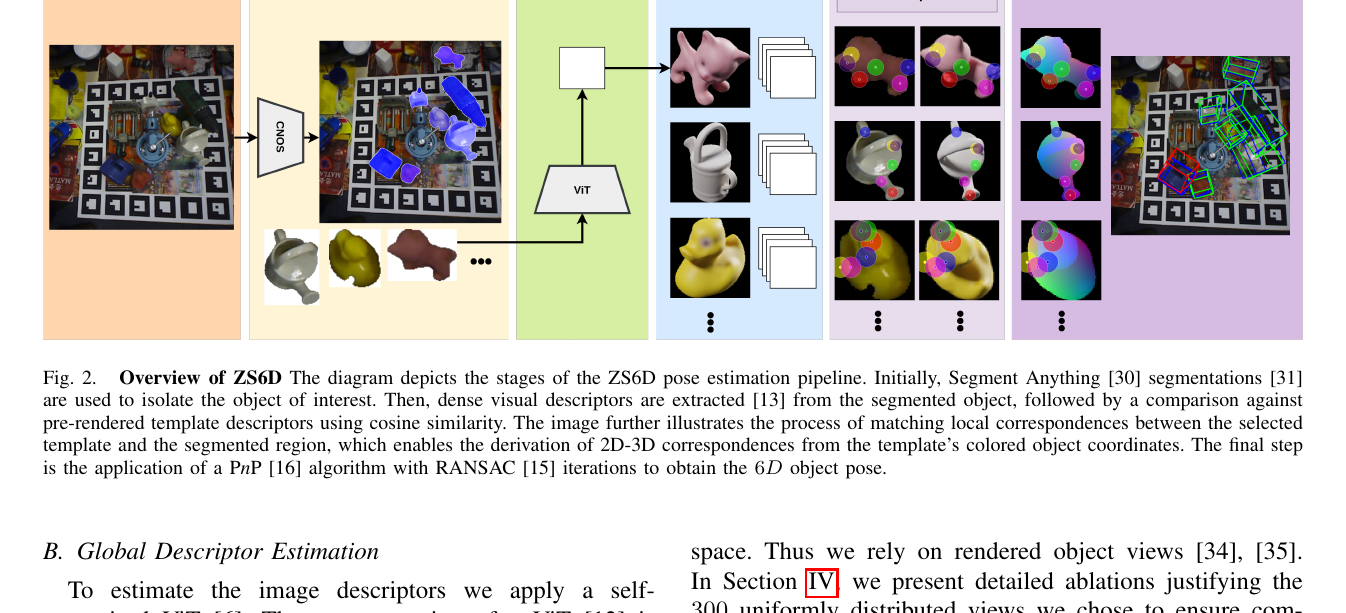 原论文 Figure 2:全局 descriptor 选择 CAD 视角,局部 descriptor 建立 mutual nearest-neighbor matches;模板中预渲染的彩色 object coordinates 把 match 抬升为 2D–3D correspondence。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
目标是估计
xc=Rxo+t,R∈SO(3),t∈R3.
| 项目 | ZS6D 设定 |
|---|
| 对象 | pose network 训练未见的具体 CAD 实例 |
| query | 单张 RGB 与 camera intrinsics |
| 每对象先验 | metric CAD;300 个带已知 pose 的 RGB / object-coordinate templates |
| 前端 | CNOS:SAM proposals + DINOv2 CAD template classification |
| 输出 | 单个 6D pose hypothesis |
| 不需要 | 目标专属 pose training、query depth、test-time gradient optimization |
| 仍需要 | CAD onboarding、mask、对象 ID、PnP 可用的内参与足够 correspondence |
论文的 zero-shot 精确含义是“ViT descriptor 没有为 pose 或目标对象 fine-tune”。它不等于无 CAD、无模板、无 detector 或 open-world discovery。
4. 研究脉络
- 传统实例级方法:为每个对象学习 keypoint、coordinate map 或 direct pose,目标集改变通常要重训。
- novel-object render-and-compare:MegaPose 用大规模 synthetic objects 学习共享 coarse/refiner;泛化强,但预训练成本高。
- 模板式 novel-object pose:OSOP 依赖 task-specific CNN template matching,并可输出多假设。
- foundation descriptor 路线:CNOS 已证明自监督 ViT 可做 CAD-prompted segmentation;ZS6D 将同类 descriptor 进一步用于精确 pose correspondence。
- 本文区别:不训练 pose backbone,也不通过 iterative renderer refinement 修正;最终几何由显式 2D–3D correspondence 与 RANSAC-PnP 求解。
5. 方法详解
5.1 CAD onboarding 与前端
每个对象在正二十面体视角上均匀采样 300 个 views,用 BlenderProc 渲染:
- RGB template;
- 已知 template pose;
- 每像素 object-coordinate image。
query 端由 CNOS 在 SAM proposals 中选择与目标 CAD 最相似的 mask。CNOS 自己使用 42 个 DINOv2 templates 做 object association;ZS6D 的 pose templates 是另一套更密集的 300 views,二者不能混为一个模板库。
5.2 全局模板检索
ViT-S/8 将 224×224 crop 划分为小 patch。作者沿用已有分析,使用 layer 9 的 key token 汇聚成 384 维全局 descriptor。对 query Dp 与模板集合 {Dt} 做 cosine similarity:
t⋆=argtmax⟨Dt,Dp⟩.
这一步只负责把连续 SO(3) 搜索缩到一个邻近视角,不把 template rotation 直接当最终答案。
5.3 局部 mutual correspondence
从 layer 11 读取 patch key tokens。更深层特征比 layer 9 更适合局部语义 / 几何对应。仅保留双向最近邻:
C={(q,p)∣NN(p,Q)=q,NN(q,P)=p}.
双向约束能删除许多单向 accidental match,但没有显式处理对称等价区域。每个 query patch 给出图像 2D 坐标;匹配 template patch 在 object-coordinate image 中给出 CAD 3D 坐标。
5.4 RANSAC-PnP
有了 {(ui,Xi)} 后,系统在 RANSAC 中运行 PnP:
λi[ui1]=K(RXi+t).
因此 metric translation 来自 CAD scale、camera intrinsics 与透视几何,而不是 bbox ratio regression。局部对应也允许最终 rotation 比最近模板更精细。
6. 训练、推理与工程复杂度
- pose 网络训练:无;ViT-S/8 使用 ImageNet-1k self-supervised pretrained weights。
- 每对象 onboarding:300-view RGB 与 coordinate map rendering,仍是不可忽略的离线成本。
- 推理链:CNOS segmentation → 300 template retrieval → patch matching → RANSAC-PnP。
- 无 refinement:速度和结构更简单,但错误 correspondence 没有后续 render-and-compare 修正。
- 复现关键点:ViT layer/token 选择、patch size、模板相机分布、coordinate-map interpolation、PnP threshold 和 mask crop 归一化。
7. 实验分析
7.1 数据与协议
| 数据集 | 主要困难 | ZS6D 的风险点 |
|---|
| LM-O | 严重遮挡 | mask 不完整、可匹配 patches 变少 |
| YCB-V | clutter、光照与多实例 | CNOS 漏检 / 错实例关联 |
| T-LESS | 无纹理、重复几何、对称 | local descriptor 多解最明显 |
指标为 BOP AR,但对比只使用 RGB、无 refinement 的 pose initialization,避免把 MegaPose 完整 refiner 结果混进来。
7.2 主结果
| 方法 | 是否 pose-specific training | LM-O | YCB-V | T-LESS |
|---|
| MegaPose coarse | 是(跨对象 synthetic) | 0.187 | 0.139 | 0.197 |
| OSOP | 是(跨对象) | 0.274 | 0.296 | 0.403 |
| ZS6D | 否 | 0.298 | 0.324 | 0.210 |
作者声称:无需 pose fine-tuning 仍能在两类 baseline 上取得有竞争力的 zero-shot initialization。
我的分析:主张得到支持,但 ZS6D 并非全面领先;T-LESS 显示 textureless / symmetry 仍是 foundation patch feature 的明显短板。
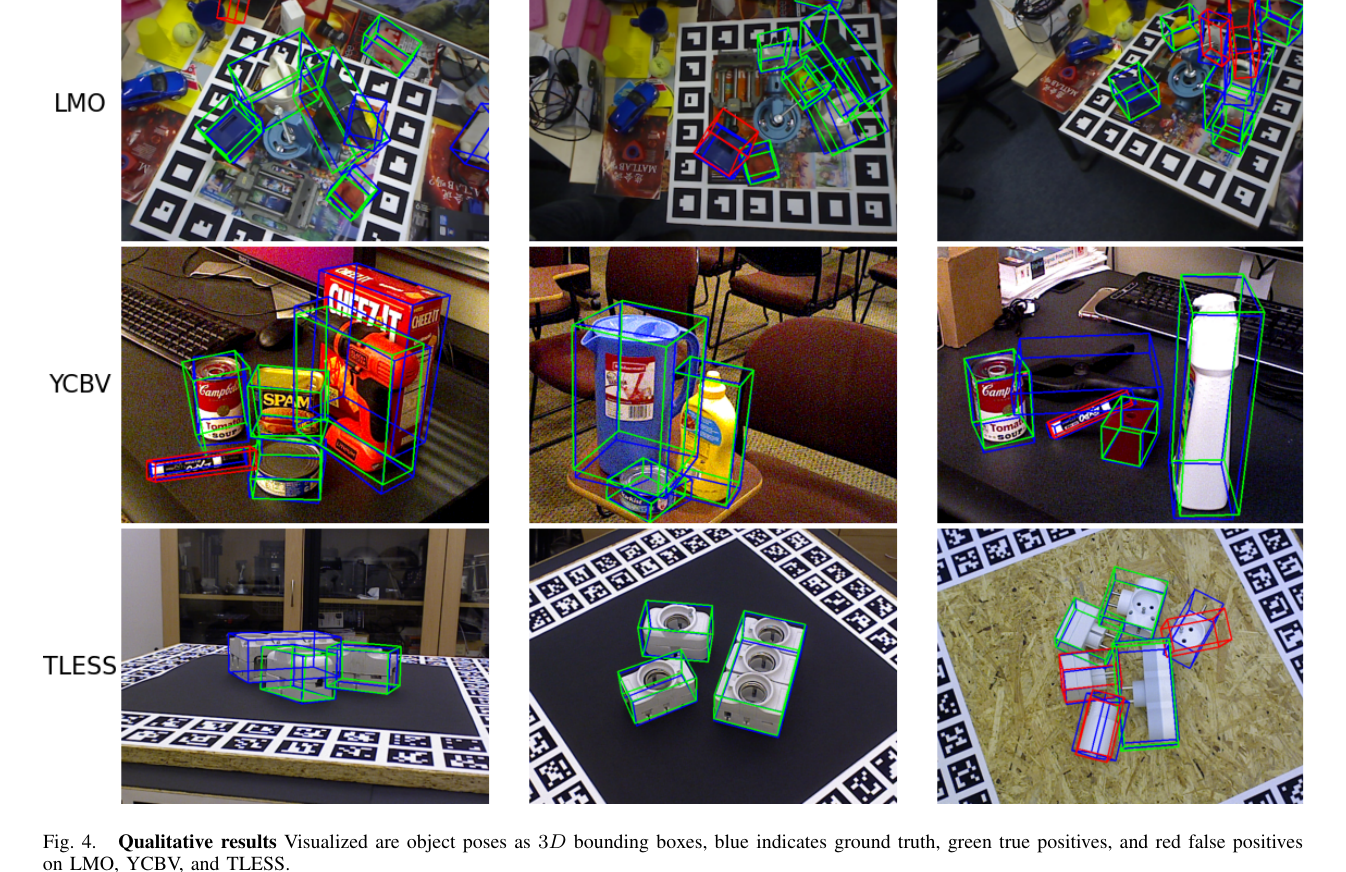 原论文 Figure 4:绿色为正确 pose、红色为错误、蓝色为 GT。部分场景完全没有预测框,对应 segmentation / association 前端没有把实例交给 pose 后端。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
7.3 消融与失败条件
| 消融 | 现象 | 说明 |
|---|
| CNOS mask → GT mask | AR:LM-O 0.298→0.527;YCB-V 0.324→0.499;T-LESS 0.210→0.460 | pose 后端远未触顶,mask 是首要误差源 |
| templates 增加 | 约 200 后收益明显放缓,300 附近饱和 | 模板负责进入局部匹配 basin,不需穷举 21k rotations |
| correspondences 增加 | 4→8 提升最大,约 24 后趋于饱和 | 少量可靠对应比大量噪声对应更重要 |
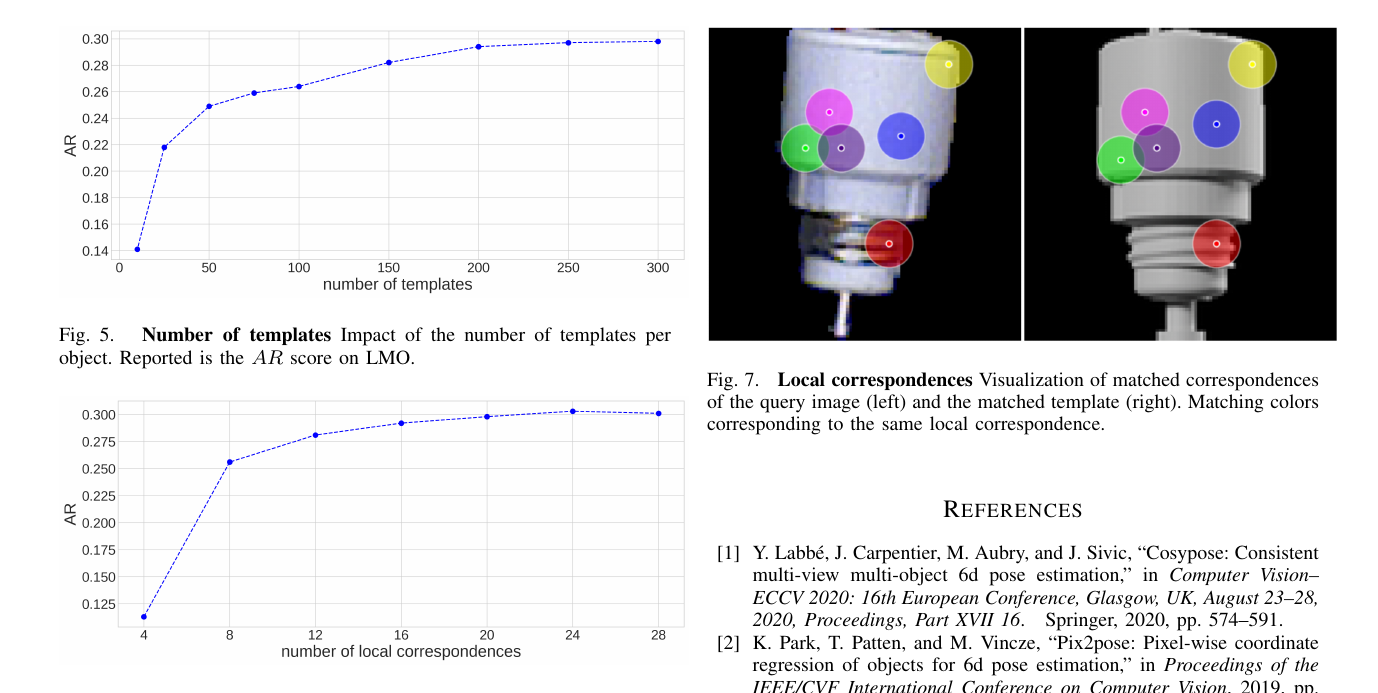 原论文 Figures 5–7:模板密度和 correspondence 数都呈边际收益递减;右图展示 query 与 template 的同色 patch matches。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
8. 批判性分析
优点
- 把 foundation descriptor 的“可视化几何性”变成可运行的 metric pose pipeline。
- 任务边界清楚,最终 pose solver 可解释且便于诊断。
- 不用 query depth,也没有每个对象训练过程。
缺点与隐含假设
- segmentation、object identity 与 CAD 均提前给定,系统级 zero-shot 程度受 CNOS 限制。
- 只取一个 global template,初始 retrieval 错误会直接限制局部匹配。
- 对称性只由 BOP metric 在评价时吸收,方法本身没有等价 pose 集合或 symmetry-aware matching。
- 论文没有报告完整 runtime / onboarding storage,也未和后来的 DINOv2 correspondence 方法做统一协议比较。
9. 可改进方向
- 用 top-k templates + geometry-aware hypothesis scoring,避免单检索错误。
- 用 segmentation uncertainty 或 mask proposals 联合 pose score 反向筛选前端。
- 将 DINOv2 / diffusion features 与 CAD normals、surface visibility 联合编码。
- 在 PnP 后加轻量 render-and-compare refinement,并单独报告 initialization 与 refined 结果。
- 显式构造 symmetry-equivalent correspondences 或多峰 rotation hypotheses。
10. 对研究的启发
ZS6D 的关键不是“ViT 很强”,而是把 learned feature 放在最合适的位置:负责难以手工设计的跨域对应,把刚体几何留给 PnP。它适合作为研究 foundation feature 是否真正编码 3D correspondence 的简洁基线。
11. 待解决问题
- 不同 ViT / DINOv2 层、facet 与 patch size 在同一 BOP protocol 下如何变化?
- CNOS 与 ZS6D 两套模板是否可共享,降低 onboarding?
- top-k template 与 correspondence confidence 能否校准成 pose uncertainty?
- 在强对称 T-LESS 上,错误主要来自 mask、view retrieval 还是 local matching?
