论文精读笔记:6D-Diff
1. 核心判断
6D-Diff 的关键不是“把 diffusion 套到 pose 上”,而是重新选择扩散对象。直接对旋转和平移扩散会遇到 SO(3) 几何、尺度不一致和对称多解;论文选择在 N×2 的 2D keypoint coordinates 上建模,既能从网络 heatmap 读取不确定性,又能把最终结果交给 PnP。
更重要的是,作者没有把 reverse process 从标准 Gaussian 开始。遮挡、背景干扰与自遮挡使 heatmap 往往多峰且有离群尾部,Mixture-of-Cauchy(MoC)比 Gaussian 更适合描述这一分布。实验中标准 diffusion 为 73.1、heatmap-as-condition 为 76.2、完整 MoC 为 79.6,证明增益来自“把数据依赖的 heatmap 分布作为终点”,而不只是网络更深。
2. 任务边界与数据流
给定 ROI 图像 I、CAD 模型和相机内参,先在 CAD 表面用 farthest point sampling 选 N=128 个 3D keypoints:
X={xi∈R3}i=1N.
目标是预测其 2D 投影:
d0={ui∈R2}i=1N,
再求:
(R,t)=PnP(X,d0,Kcam).
因此它属于:
- known CAD、known instance;
- 单 RGB绝对 pose;
- correspondence-based,而非 direct pose regression;
- 不解决检测、类别发现、未知对象泛化或尺度估计。
3. 为什么用 Mixture-of-Cauchy
initializer 为每个 keypoint 输出热图 Hi。从这些热图采样 V 组坐标后,用 U=9 个 Cauchy kernels 拟合:
ηMoC⋆=EM(v=1∏Vu=1∑UπuCauchy(dKv∣μu,γu)).
Cauchy 的尾部比 Gaussian 更重,少量背景峰或错误高响应不会迫使分布方差整体增大;混合形式又能保留多个局部峰。这个设计与任务有直接对应:
- 可见 keypoint:热图集中,某个 kernel 权重大;
- 遮挡 keypoint:多个候选峰并存;
- 背景干扰:少量远离真值的 outliers 进入重尾;
- 对称或近重复纹理:局部多峰由多个 kernels 表达。
但 MoC 并没有显式标注“哪一个峰是对称等价解”,最终仍由 appearance-conditioned decoder 和训练真值把分布推向一个监督解。
4. 数据依赖的 forward process
普通 DDPM 令 dK 接近 N(0,I)。6D-Diff 改为让终点接近拟合的 MoC:
d^k=αˉkd0+(1−αˉk)μMoC+1−αˉkϵMoC.
当 αˉK→0 时,d^K 接近 heatmap 对应的 MoC。forward process 只在训练时生成逐步监督;测试时直接从 initializer 的 DK 采样并执行 reverse process。这一点避免了“训练从白噪声出发、测试却从网络热图出发”的分布错位。
5. 网络与训练
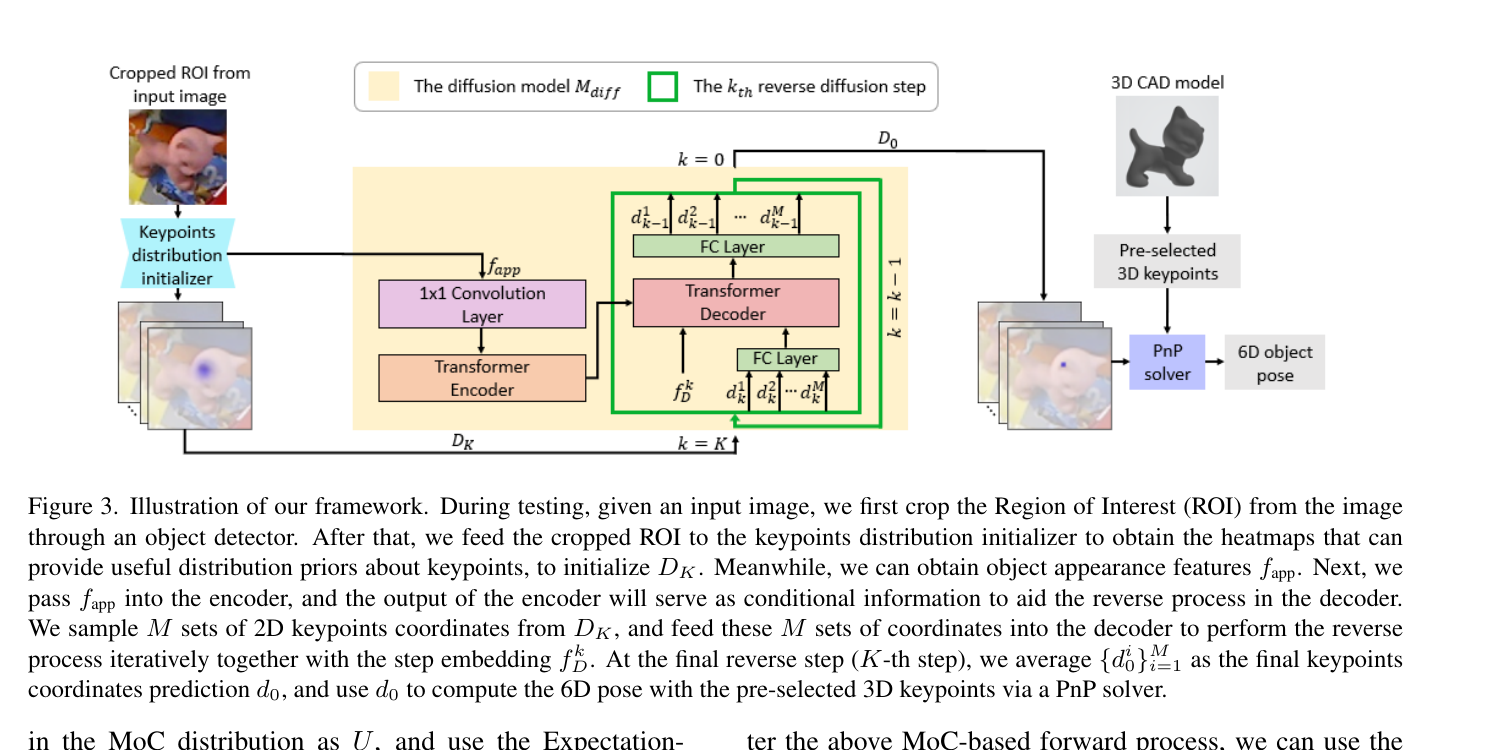 原论文 Figure 3。黄色部分是 diffusion model,绿色箭头表示逐步 reverse step;模型只修复 2D keypoints,最终几何仍由 Progressive-X PnP 完成。来源:CVPR 2024 正式论文;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
训练分两阶段:
- initializer:ResNet-34 后接两层 deconvolution 与 1×1 convolution,以 L2 heatmap loss 学习 128 张热图;
- diffusion model:appearance feature 经三层 Transformer encoder;每一步坐标 embedding 与 sinusoidal step embedding 进入三层 decoder,通过 cross-attention 读取图像上下文,回归上一步坐标。
reverse loss 对 5 组样本和 100 个步骤逐项监督:
Ldiff=i=1∑Mk=1∑KMdiff(d^ki,fapp,fDk)−d^k−1i22.
实现使用 V100、M=5、K=100、9 个 Cauchy kernels,diffusion model 训练 1,500 epochs、Adam、初始学习率 4×10⁻⁵。测试以 DDIM 只走 10 步。
6. 逐步去噪是否真的发生
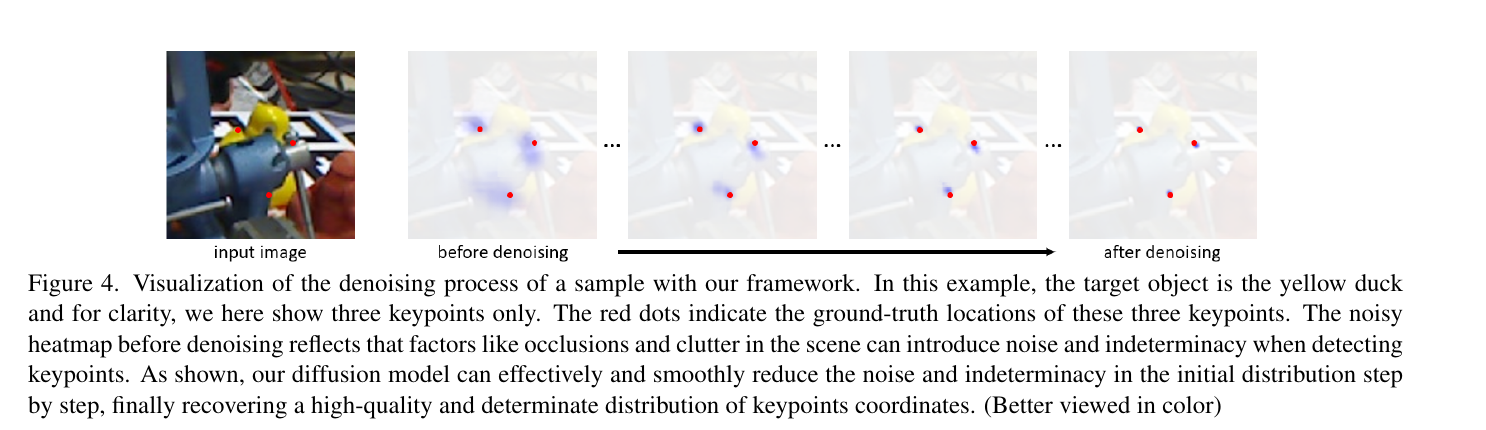 原论文 Figure 4:黄色鸭子样例中展示三个 keypoints;初始热图有明显扩散和错误峰,反向步骤逐渐把概率质量收缩到红色真值点附近。来源:CVPR 2024 正式论文;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
直接回归对照很关键:
| 配置 | LM-O ADD(-S) |
|---|
| Variant A:直接从 heatmap 取坐标 | 49.2 |
| Variant B:相同结构但直接回归坐标 | 57.3 |
| Variant C:堆叠到近似相同计算量 | 61.1 |
| 完整逐步 diffusion | 79.6 |
Variant C 控制了网络深度和计算量,仍落后 18.5 points,支持作者关于“逐步分布变换”本身有效的判断。不过论文没有给每个 reverse step 的误差曲线,也没有报告 1/5/10 步之间的速度—精度折衷。
7. 主结果
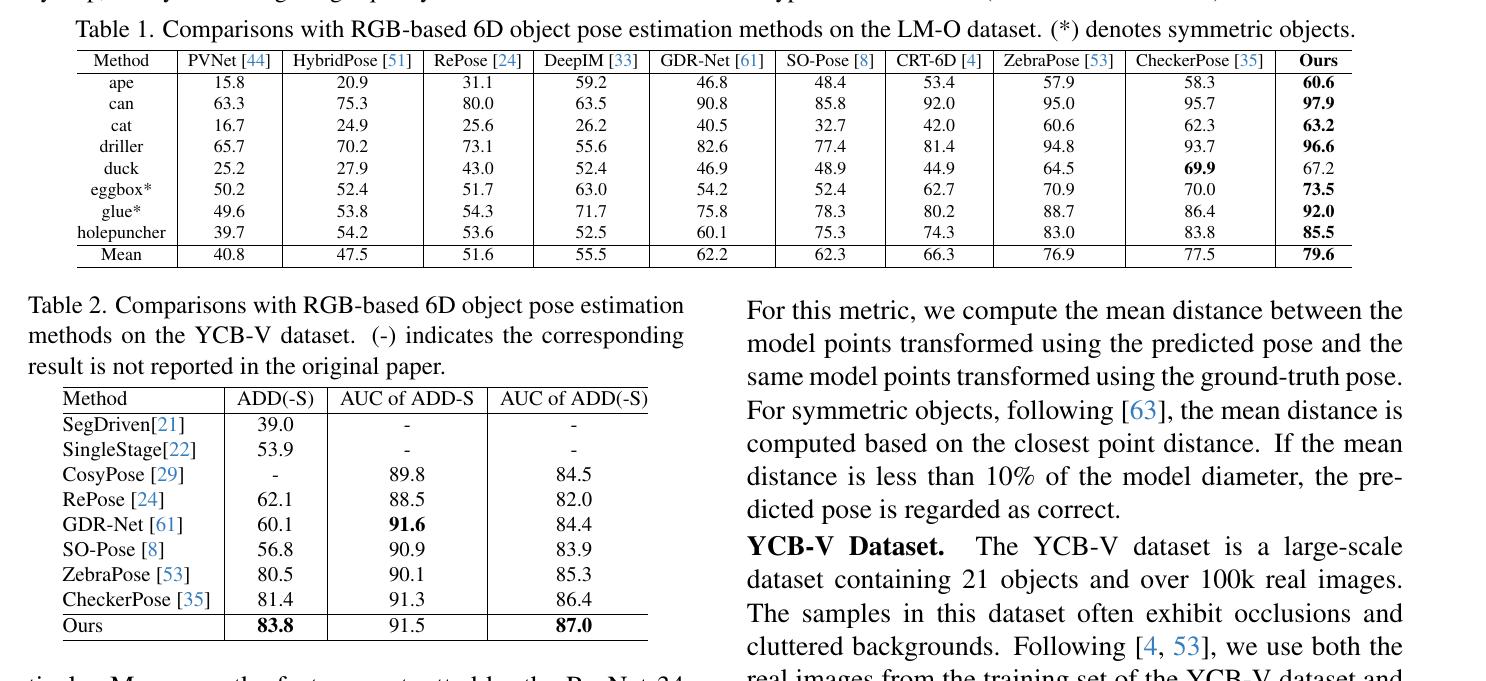 原论文 Table 1–2。LM-O 用 ADD(-S);YCB-V 同时报告阈值正确率与 10 cm 截断的 AUC,三列不能互换解释。来源:CVPR 2024 正式论文;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
LM-O
| 方法 | 平均 ADD(-S) |
|---|
| CRT-6D | 66.3 |
| ZebraPose | 76.9 |
| CheckerPose | 77.5 |
| 6D-Diff | 79.6 |
6D-Diff 在 can、cat、driller、eggbox、glue、holepuncher 上领先或有明显优势;duck 为 67.2,低于 CheckerPose 的 69.9,说明扩散并非每个对象都改善。相比 CheckerPose,平均提升 2.1 points,属于稳定但不是数量级变化。
YCB-Video
| 方法 | ADD(-S) | ADD-S AUC | ADD(-S) AUC |
|---|
| ZebraPose | 80.5 | 90.1 | 85.3 |
| CheckerPose | 81.4 | 91.3 | 86.4 |
| 6D-Diff | 83.8 | 91.5 | 87.0 |
ADD-S AUC 只比 CheckerPose 高 0.2;更明确的增益在 ADD(-S) 阈值正确率(+2.4)和 ADD(-S) AUC(+0.6)。
8. appearance 与 MoC 消融
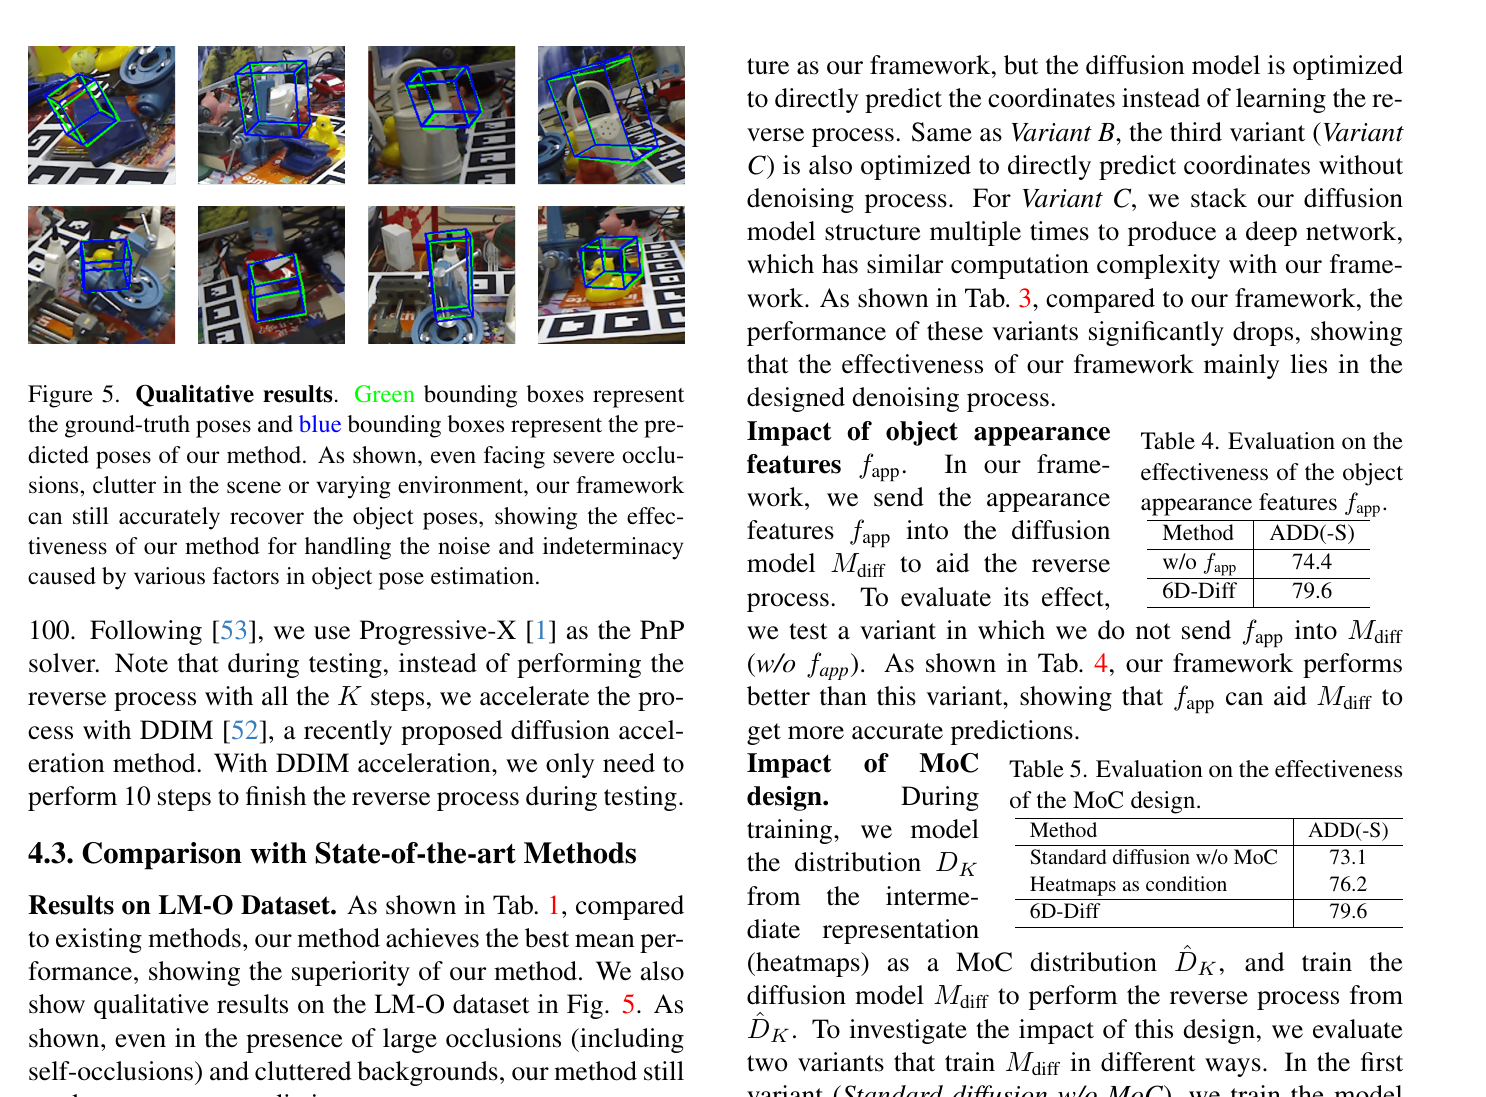 原论文 Figure 5 与 Table 3–5:左侧展示 LM-O 遮挡场景,右侧消融区分逐步去噪、appearance condition 和 MoC 起点的贡献。来源:CVPR 2024 正式论文;图片与表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
| 设计 | LM-O ADD(-S) | 相对完整模型 |
|---|
| 无 appearance feature | 74.4 | -5.2 |
| 标准 Gaussian diffusion、无 MoC | 73.1 | -6.5 |
| Gaussian 起点 + heatmap condition | 76.2 | -3.4 |
| MoC 起点 + appearance condition | 79.6 | — |
MoC 的贡献比 appearance condition 更大,但两者并非互斥:MoC 决定从怎样的坐标分布开始,appearance 决定每一步向哪里去。仅把 heatmap 当 condition 不等于利用它作为起始分布。
9. 不确定性解释的边界
论文反复使用 noise 与 indeterminacy,但输出过程有三次“压成单解”:
- 5 组 reverse samples 最终取坐标均值;
- 每个 keypoint 的均值组成一组确定对应;
- PnP 输出单个 pose。
因此 6D-Diff 的目标更接近“利用分布完成稳健点估计”,而非校准的 pose posterior。对强对称对象,坐标均值甚至可能落在两个合法模式中间;论文沿用 ADD-S 评测,但没有展示多模态 pose samples 或置信度校准。
10. 复现与局限
- Faster R-CNN / FCOS 检测框来自 CDPNv2,检测误差没有和 keypoint diffusion 分离报告。
- LM-O 使用 LM real + PBR,YCB-V 使用 real + PBR;结果不是纯真实训练。
- 每个实例需要 CAD、3D keypoints 与对象训练,不支持 novel object。
- Progressive-X 比普通 PnP 更鲁棒,最终成绩包含 robust solver 的贡献。
- 文中未报告端到端 FPS、参数量和显存;10 次 decoder 推理的部署成本需自行测量。
- MoC fitting 使用 EM,训练流水线比标准 heatmap regression 更复杂。
- 论文未比较 Laplace、Student-t、Gaussian mixture 等替代重尾分布,无法断言 Cauchy 是唯一最优选择。
11. 最终评价
6D-Diff 是一篇问题建模清楚的 diffusion-for-pose 工作:它保留 correspondence + PnP 的几何可解释性,只用 diffusion 解决最不稳定的 2D keypoint localization。MoC 与 direct-regression 消融都能支撑核心设计,LM-O / YCB-V 结果也有一致提升。
它的能力边界同样明确:known CAD、单解输出、无速度报告,也没有真正建模 SE(3) 的对称多模态分布。后续若要扩展,最有价值的方向是保留多组 keypoint samples 到 pose hypothesis 层,并把 symmetry-aware likelihood、PnP uncertainty 与少步采样统一评测。
