论文精读笔记:Instance-Adaptive and Geometric-Aware Keypoint Learning for Category-Level 6D Object Pose Estimation
- 简称:AG-Pose
- 论文:arXiv / PDF
- 代码:GitHub
- 会议:CVPR 2024
- 作者:Xiao Lin, Wenfei Yang, Yuan Gao, Tianzhu Zhang
- 机构:University of Science and Technology of China; Jianghuai Advance Technology Center
- 数据集:CAMERA25, REAL275
AG-Pose 是一个类别级 RGB-D 6D object pose 方法。它把 dense correspondence 路线中的“每个点都预测 NOCS 坐标”改成“学习少量 instance-adaptive keypoints,再对这些 keypoints 建立 NOCS correspondence”,并显式把局部邻域几何和关键点之间的全局几何编码进关键点特征。
方法输入与输出
| 项目 | 内容(本站整理) |
|---|
| 推理输入 | RGB-D、相机内参 K,以及前端给出的实例 mask / 类别。核心网络的输入是 Iobj∈RH×W×3 与相机系点云 Pobj∈RN×3。 |
| 最终输出 | 类别规范物体系到相机系的 R∈SO(3)、t∈R3,以及三轴物体尺寸 s∈R3;测试实例在训练中可以未见,但类别已知。 |
| 训练输入 | 训练类别的 RGB-D 目标观测、mask / 类别、GT pose 与 size、实例模型及 NOCS 对齐信息。实例模型用于 object-aware Chamfer 的离群点过滤,不是测试输入。 |
| 训练目标 | 位姿与尺寸回归、关键点 NOCS 坐标监督,以及关键点分散和贴合物体表面的约束;关键点坐标 / 特征和 NOCS correspondence 是中间结果。 |
| 输出细节 | 网络用连续 6D rotation representation 构造旋转矩阵,平移由相对点云均值的 residual 恢复;t 与 s 随深度使用一致的长度单位,NOCS 坐标则是归一化表示。 |
| 必要条件 | 论文采用 192×192 RGB crop、1024 个观测点和 96 个学习关键点。最终由回归 heads 输出 pose / size,并非把关键点直接交给 PnP。 |
依据:论文 Section 3。类别级“无形状先验”特指推理不输入类别形状模板,不代表训练不使用三维模型监督。
1. 问题定义
类别级 6D pose 的目标不是估计训练时已经见过的某个 CAD 实例,而是在同一类别中对未见实例估计 rotation、translation 和 size。AG-Pose 遵循 NOCS 系列设置:给定 RGB-D 观测、相机内参、类别标签和实例 mask,先得到目标点云和 RGB crop,再预测物体在相机坐标系下的 pose 与尺度。
这篇论文的关键背景是:NOCS / SPD / SGPA / DPDN / Query6DoF 等方法大多依赖 dense coordinate 或 dense correspondence。dense correspondence 在已知类别上很强,但同一类别内部形状变化很大时,很多点的局部外观或局部几何并不能唯一确定其 NOCS 对应;边界点、缺失深度和 outlier 也会进一步放大错误。
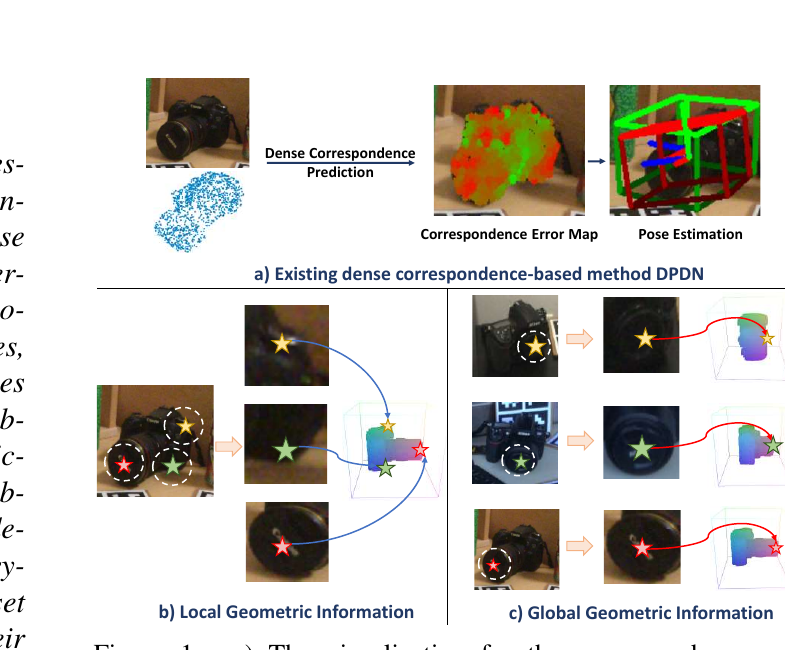 原论文 Figure 1:作者用 DPDN 的 correspondence error map 展示 dense correspondence 在未见实例上的误差,并说明 local / global geometric information 分别对应“同实例不同部位”和“不同实例同类部位”的歧义消解。来源:arXiv。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
2. 方法总览
AG-Pose 的 pipeline 可以拆成四段:
- Feature extractor:输入 RGB crop
Iobj 和点云 Pobj。PointNet++ 提取点特征,PSPNet with ResNet-18 提取 RGB 特征,然后拼接成 object feature Fobj。
- IAKD:用 category-shared learnable queries
Qcat 和 object feature 生成 instance-adaptive queries Qins,再通过 keypoint heatmap 得到关键点坐标 Pkpt 和关键点特征 Fkpt。
- GAFA:对每个 keypoint 做 local KNN aggregation,再做 global keypoint aggregation,把局部和全局几何关系编码进关键点特征。
- Pose & size estimator:预测 keypoint 的 NOCS 坐标,并把
Pkpt、Fkpt、预测 NOCS 和聚合后的 keypoint features 拼接后回归 R, t, s。
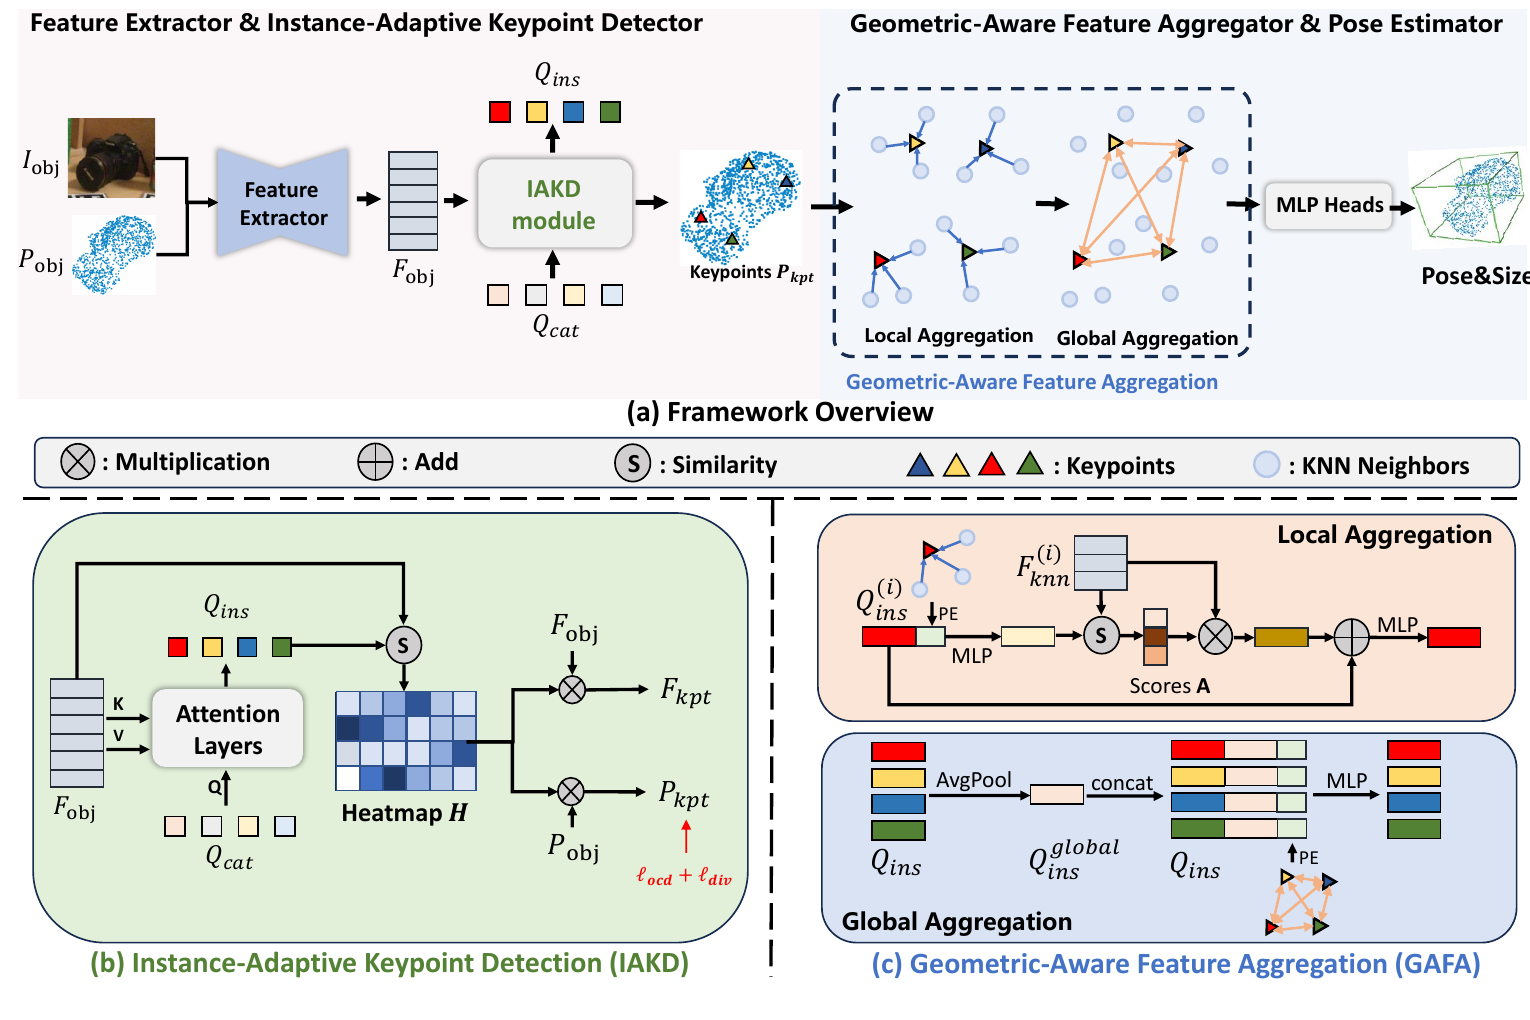 原论文 Figure 2:AG-Pose 的总体架构。IAKD 从类别共享 query 生成当前实例自适应关键点;GAFA 用 local aggregation 和 global aggregation 让关键点带上几何上下文;最终 MLP heads 输出 pose 和 size。来源:arXiv。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. IAKD:为什么不是 FPS
最直接的 sparse keypoint 做法是 FPS。但 FPS 只考虑点云几何覆盖,不知道哪些点对 pose recovery 更有判别力,也不一定避开深度噪声和 outlier。IAKD 的设计更像是“可学习的关键点探测器”:先学习一组类别共享 query,再通过 attention 融入当前物体特征,使 query 变成 instance-adaptive detector。
IAKD 输出 heatmap H,然后用 softmax 加权 object points 和 object features 得到 keypoint coordinates/features。这样关键点不是硬选出来的点,而是可微的 feature-weighted / coordinate-weighted result,能端到端受位姿任务监督影响。
为约束关键点分布,作者设计两个 loss:
Ldiv:鼓励关键点彼此分散,避免所有 keypoints 聚在同一个局部区域。Locd:object-aware Chamfer distance,把关键点拉到物体表面,同时通过实例模型过滤 outlier。
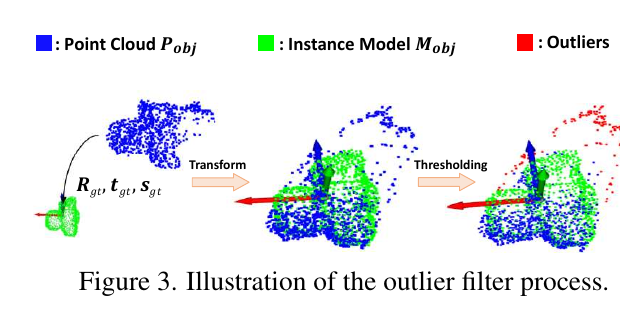 原论文 Figure 3:`Locd` 中的 outlier filter。作者先用 GT pose/size 把观测点云与实例模型对齐,再按距离阈值过滤不可靠点,使关键点学习更接近真实物体表面。来源:arXiv。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
4. GAFA:local 和 global 都要
IAKD 得到的关键点如果只携带 appearance / point feature,仍然可能在形状变化大的类别中建立错误对应。因此 GAFA 把几何上下文注入 keypoint features。
local aggregation 对每个关键点找 K 个邻近 object points,用关键点到邻域点的相对位置和邻域点特征计算注意力式聚合。它解决的是同一实例内部不同部位的细粒度几何区分。
global aggregation 先平均池化所有 keypoint features,构造全局几何摘要,再和每个 keypoint feature 及相对位置编码融合。它解决的是不同实例之间整体形状不同但局部部位相似的问题。论文中的消融显示,去掉 whole GAFA、去掉 local、去掉 global,5° 2cm 都会下降。
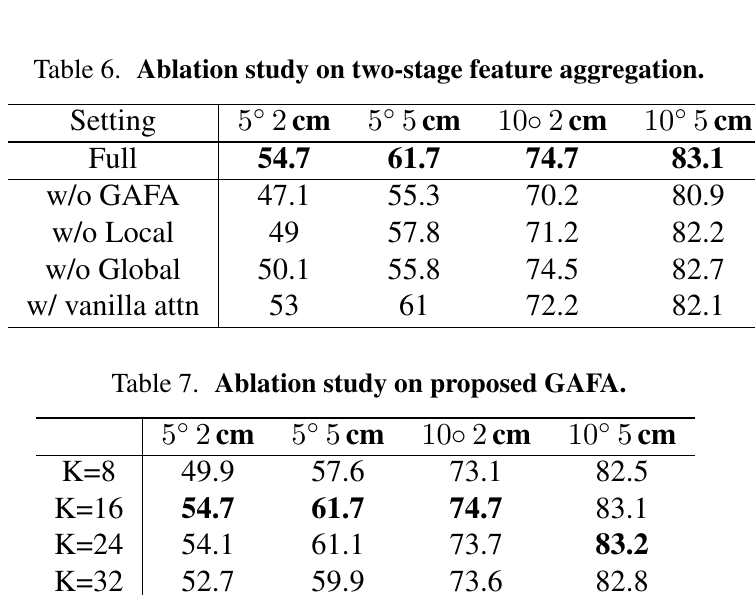 原论文 Tables 6-7:GAFA 消融。完整 GAFA 在 5° 2cm 达到 54.7;去掉 GAFA 降到 47.1,去掉 local 或 global 也都会下降;K=16 是论文选用的局部聚合范围。来源:arXiv。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
5. 训练目标和实现细节
总损失为 Lall = lambda1 Locd + lambda2 Ldiv + lambda3 Lnocs + lambda4 Lpose。其中 Lnocs 监督关键点 NOCS 坐标,Lpose 监督 rotation、translation 和 size。论文使用 6D rotation representation;translation 预测的是相对点云均值的 residual。
实现设置中,输入 crop resize 到 192x192,点云采样 N=1024,关键点数 Nkpt=96,local neighbor K=16,主要特征维度为 128/256。训练使用 Adam 和 triangular2 学习率策略,batch size 24,单卡 RTX 3090Ti。
需要注意的是,虽然推理不需要目标实例 CAD,但训练中用到了类别数据、NOCS 监督和实例模型相关的约束;推理也仍需要 depth、相机内参、object mask 和 category label。
6. 实验设置
CAMERA25 是合成数据集,覆盖 6 个类别,常用于训练和评估类别级 NOCS pose。REAL275 是真实 RGB-D 数据集,验证集中每个类别包含未见实例,是类别级 pose 泛化更关键的测试集。
指标包括:
3D IoU:用 3D bounding box IoU 的 50 / 75 阈值评估 pose 和 size。n° m cm:rotation error 小于 n 度且 translation error 小于 m cm 才算正确。
7. 主结果
REAL275 上,AG-Pose 在 IoU50 / IoU75 / 5°2cm / 5°5cm / 10°2cm / 10°5cm 分别达到 83.7 / 79.5 / 54.7 / 61.7 / 74.7 / 83.1。论文强调 5°2cm 比 shape-prior-based 的 DPDN 高 8.7 个点,比 prior-free 的 Query6DoF 高 5.7 个点。
CAMERA25 上,AG-Pose 的 IoU50 / IoU75 / 5°2cm / 5°5cm / 10°2cm / 10°5cm 为 93.8 / 91.3 / 77.8 / 82.8 / 85.5 / 91.6。在 IoU 和 10° 指标上领先 Query6DoF,但 5° 指标略低。因此读这张表时要区分“多数指标领先”和“所有阈值都领先”。
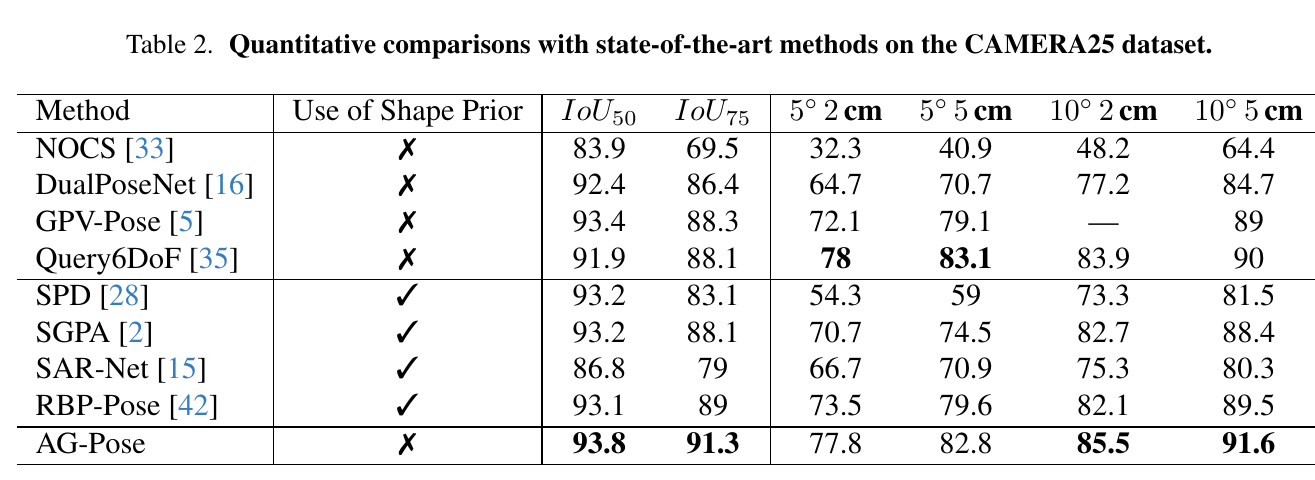 原论文 Table 2:CAMERA25 上的定量比较。AG-Pose 不使用 shape prior,在 IoU 和 10° 指标上表现最好,但与 Query6DoF 在 5° 指标上非常接近。来源:arXiv。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
8. 消融实验
IAKD vs FPS 是最直接的证据:同样数量关键点下,FPS 的 5°2cm 为 46.2,IAKD 为 54.7。说明可学习、实例自适应的关键点比纯几何覆盖采样更适合 pose recovery。
关键点数量实验显示,Nkpt=16 已能达到 47.9 的 5°2cm,说明少量关键点已经能承载很多几何信息;Nkpt=96 达到最佳综合表现,Nkpt=128 不再稳定提升。
loss 消融中,Ldiv + Locd 最好。把 Locd 换成普通 Chamfer distance 会使 5°2cm 从 54.7 降到 49.8;只保留 Locd 或没有这些关键点分布约束会大幅退化,说明关键点是否分散、是否在物体表面上,是这篇方法能工作的关键条件。
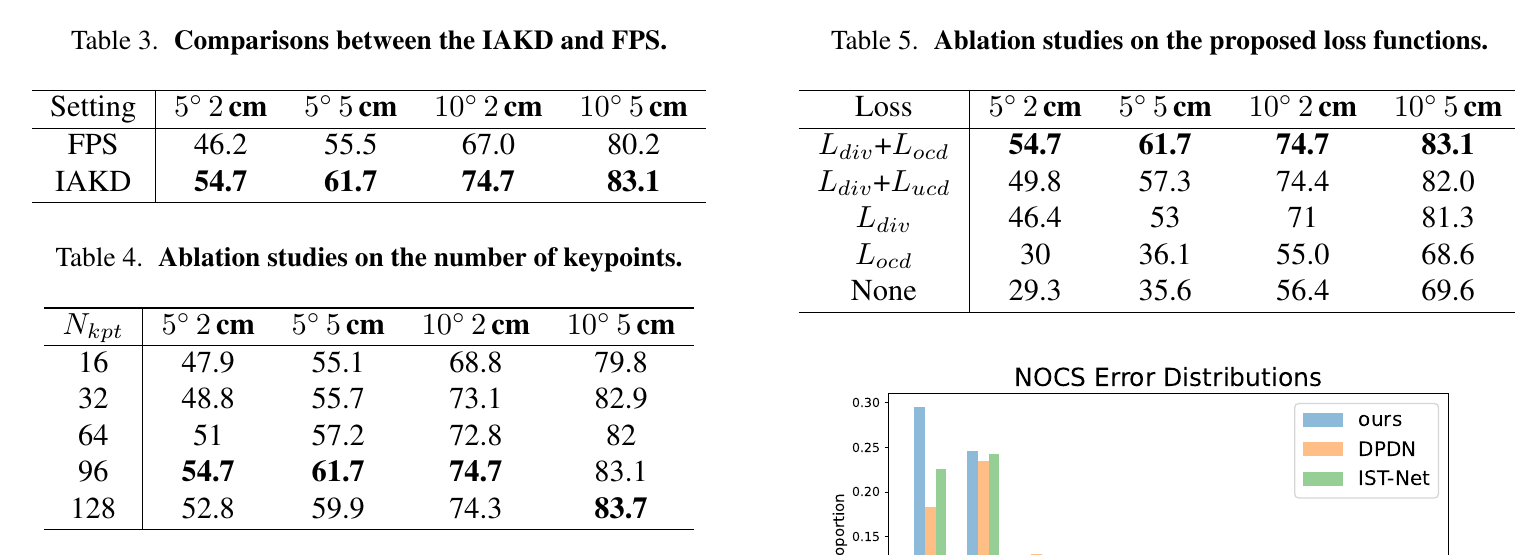 原论文 Tables 3-5 / Figure 4:IAKD、关键点数量、loss 组合和 NOCS error distribution。AG-Pose 的 NOCS error 更集中在 0 到 0.1 区间,作者据此说明 keypoint-level correspondence 比 dense correspondence 更泛化。来源:arXiv。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
9. 定性结果
Figure 5 把 AG-Pose 和 DPDN 的 NOCS error map 与 final pose box 放在一起。DPDN 在相机、杯子等形状变化更明显的实例上有更多错误 correspondence;AG-Pose 的错误区域更少,预测 box 与 GT box 更接近。这张图不能单独证明方法强,但和 REAL275 表格及 Figure 4 的 error distribution 结合起来,能支撑“关键点级几何对应更稳”的论点。
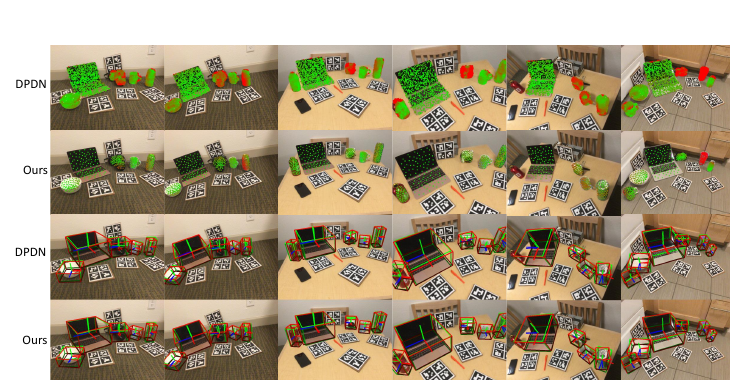 原论文 Figure 5:AG-Pose 与 DPDN 在 REAL275 上的定性对比。绿色/红色分别表示较小/较大误差以及 GT/predicted bounding boxes。来源:arXiv。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
10. 与相关路线的关系
| 方法 | 路线 | AG-Pose 的区别 |
|---|
| NOCS | dense NOCS coordinate | AG-Pose 仍用 NOCS supervision,但在 sparse keypoints 上建立对应 |
| SPD / SGPA | shape prior adaptation | AG-Pose 强调不使用 category-specific shape prior |
| DPDN | dense correspondence + depth | AG-Pose 反驳 dense correspondence 在未见实例形变下的泛化问题 |
| Query6DoF | sparse queries + dense feature update | AG-Pose 用 sparse keypoints 显式建模几何,并做 keypoint-level correspondence |
| PVNet | instance-level keypoint + PnP | AG-Pose 是 category-level RGB-D,关键点不是固定 CAD 关键点 |
11. 适用场景
AG-Pose 适合用作类别级 RGB-D pose 的强 baseline,尤其是在以下研究中:
- NOCS / REAL275 / CAMERA25 体系下的类别级 6D pose。
- 未见实例泛化,尤其同类物体形状差异较大的场景。
- 从 dense correspondence 转向 sparse geometric keypoints 的方法设计。
- 不想引入 explicit category shape prior,但可以使用 RGB-D 和 category supervision 的设置。
不适合直接当成:
- RGB-only pose 方法。
- 无 mask / 开放词汇前端感知方法。
- 完全 CAD-free / model-free 训练方法。
- instance-level BOP CAD pose 方法。
12. 我的判断
作者声称:instance-adaptive keypoints 和 geometric-aware aggregation 能改善类别级 6D pose 中未见实例的 correspondence 泛化。
我的分析:证据比较充分。REAL275 的严格指标提升明显,CAMERA25 的多数指标领先,IAKD / GAFA / loss 的消融也都能对上论文主张。最值得借鉴的是把“关键点分布学习”和“关键点几何上下文聚合”合起来,而不是简单把 dense correspondence 降采样成 sparse points。
主要局限也清楚:AG-Pose 仍然依赖 RGB-D、实例 mask、类别标签和 NOCS 风格训练监督;Locd 的设计还使用实例模型相关信息来过滤 outlier,因此它解决的是 category-level pose 中的 correspondence 泛化问题,而不是开放世界感知或无监督类别发现问题。
13. 后续可做的方向
- 用更强的 open-vocabulary segmenter 替代固定 Mask R-CNN 前端,测试 mask noise 对关键点学习的影响。
- 把 AG-Pose 的 keypoint-level correspondence 接到 refinement 或 render-and-compare 后端,观察对高精度阈值的提升。
- 研究 RGB-only 版本:用 monocular depth 或 learned geometry 替代真实 depth。
- 对 keypoints 做 uncertainty estimation,让 pose regressor 能降低不可靠关键点的权重。
- 将 AG-Pose 的 sparse keypoint representation 与 newer foundation features 或 3D representation 结合,服务更开放的 unseen object pose。
