论文精读笔记:Any6D: Model-free 6D Pose Estimation of Novel Objects
1. 核心判断
- 论文:CVF Open Access
- 关键问题:一张 RGB-D anchor 不足以覆盖对象,却要同时提供姿态、尺度和可用于遮挡 query 的几何依据。
- 核心回答:joint object alignment 把 2D–3D alignment 与 metric scale 放进同一对象表示;render-and-compare 再从候选中筛选与细化。
2. 一句话定位
Any6D 将单 reference unknown-object pose 视作“对齐并定尺度”的问题,而不是仅仅从两张图回归相对变换。
2.1 论文图表导读
| 图表 | 应该看什么 |
|---|
| 方法图 | anchor object representation 如何与 query 的 pose / size hypothesis 相连? |
| Table 1–5 | HO3D、YCBInEOAT、Toyota-Light、REAL275、LM-O 的输入条件与指标并不完全相同。 |
| Figure 3 / 6 | 物体点云对齐和形状质量是否支撑了后续 pose claim? |
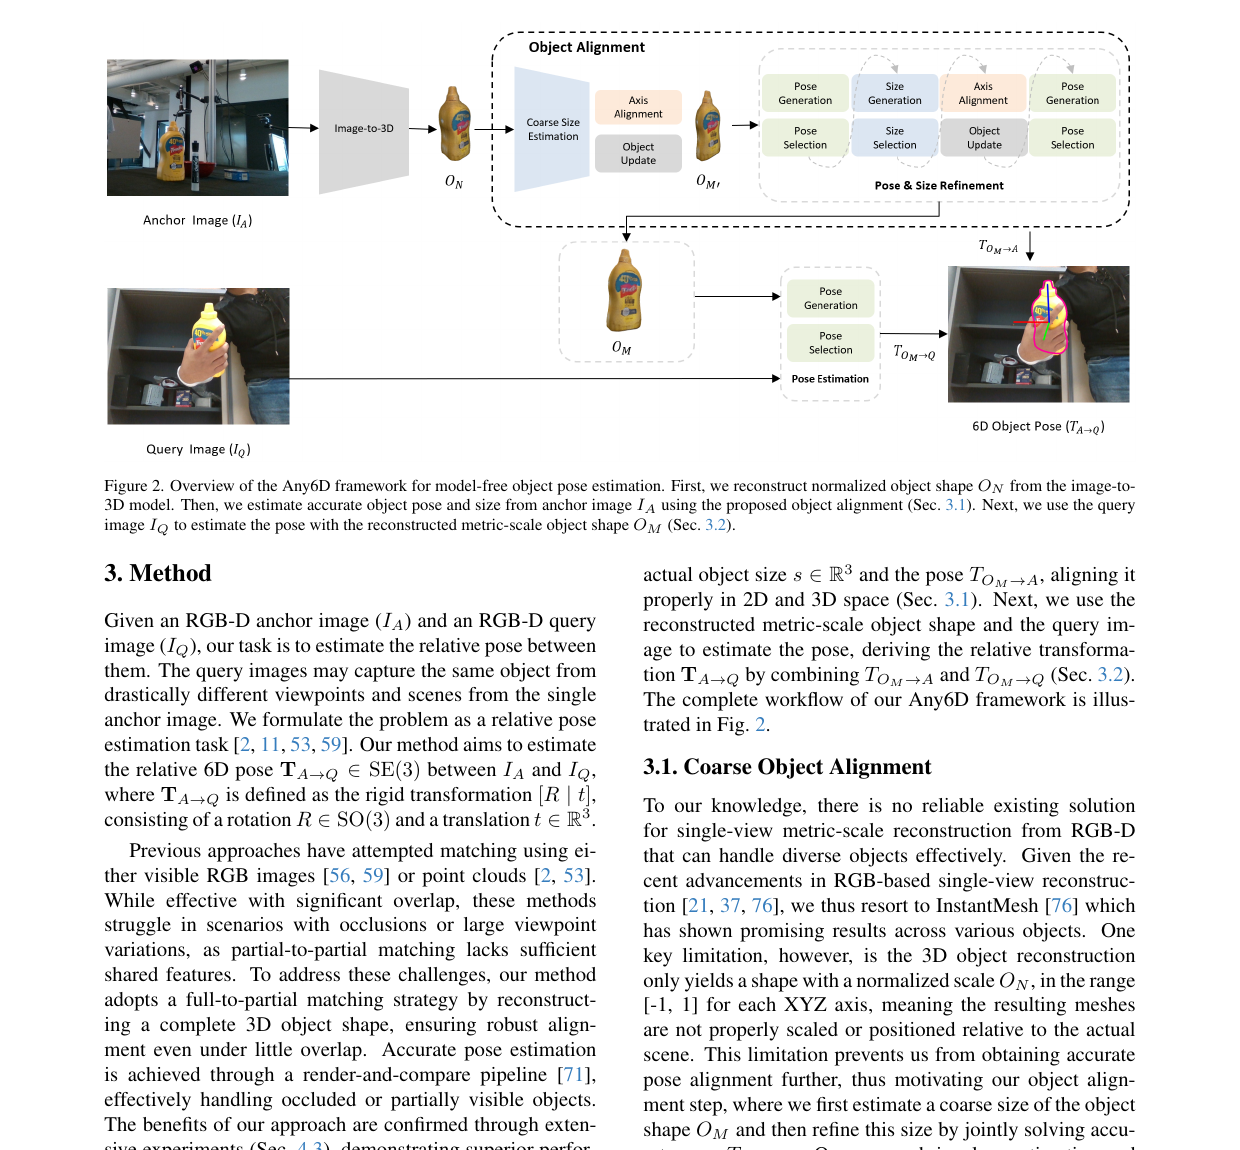 原论文方法图区域:Any6D 从单张 RGB-D anchor 形成对象表示,并通过对齐、渲染比较估计 query pose 和 size。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- 输入是同一新物体的一张 anchor RGB-D 与 query RGB-D;论文使用 object mask 评价多个 benchmark。
- 输出 anchor-to-query 相对 pose 及 object size,必要时可与 anchor 的已知坐标关系转为 object pose。
- model-free 指不需要人工 CAD / textured 3D model,不代表不需要 reference、深度或分割。
4. 方法详解
- Joint object alignment:从 anchor 和 query 的 RGB-D 建立共同对象坐标与几何线索,令 pose、shape scale 不再被分开估计。
- Hypothesis generation:在姿态和平移 / 尺度空间采样候选,避免单一匹配在无重叠时直接失败。
- Render-and-compare:用渲染 / 观测一致性选择并精修候选,处理遮挡、光照与场景变化。
5. 实验分析
5.1 可直接核对的主结果
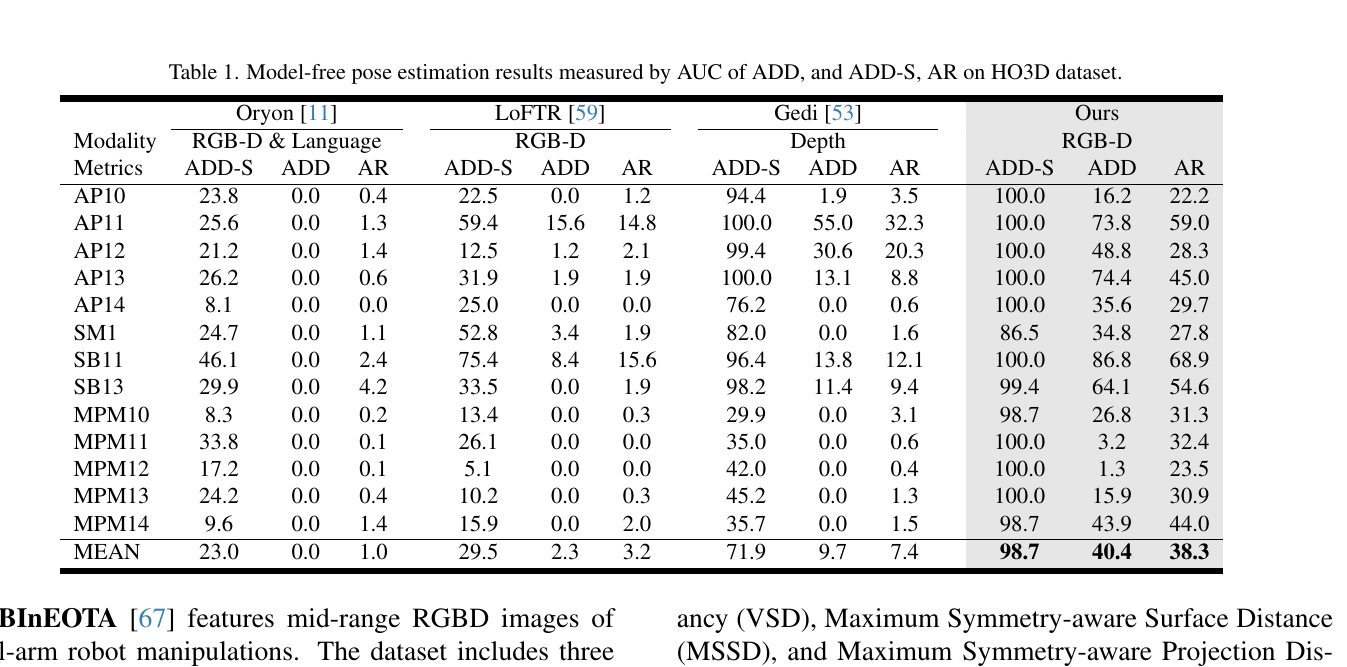
| 数据集与指标 | Oryon | Gedi | Any6D |
|---|
| HO3D mean AUC ADD-S | 23.0 | 71.9 | 98.7 |
| HO3D mean AUC ADD | 0.0 | 9.7 | 40.4 |
| HO3D mean AR | 1.0 | 7.4 | 38.3 |
同一张表中方法的模态不同(Oryon 用 RGB-D+language,Gedi 用 depth,Any6D 用 RGB-D),因此这支持该设定下的效果,不足以证明单独某个 modality 的因果优势。
5.2 跨数据集读法
- REAL275:Any6D 的 AR 为 51.0,高于文中 Oryon 的 46.5;Toyota-Light 的 AR 为 43.3。
- LM-O:在相同 CNOS + Wonder3D 前端条件下,Any6D AR 28.6、GigaPose 17.5;这更接近“使用预测形状时的 pipeline 对比”。
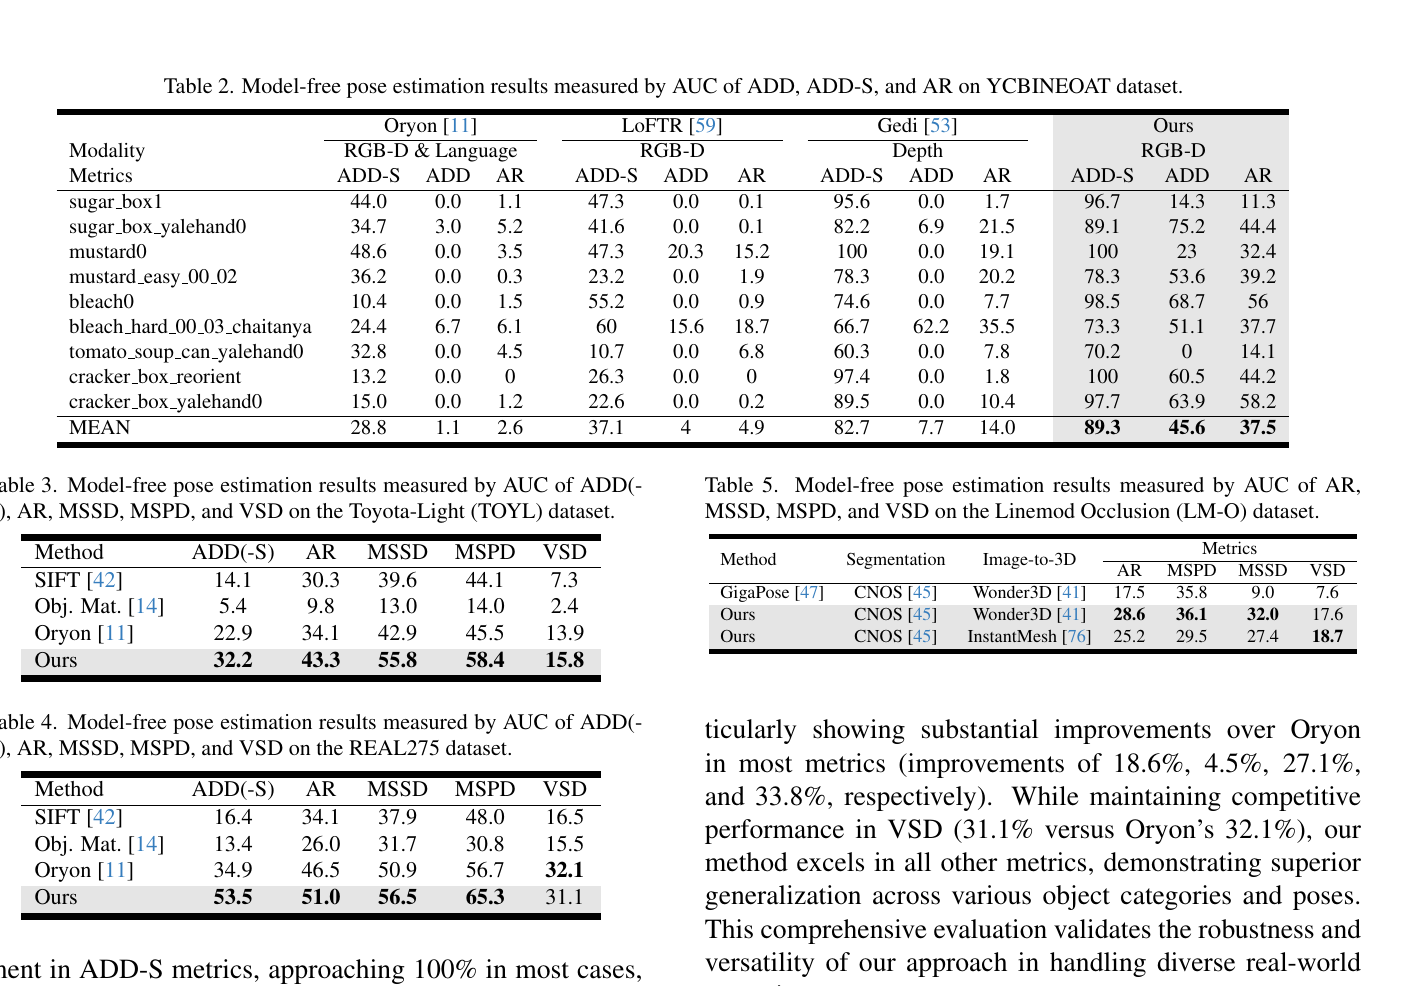 Any6D 原论文跨数据集结果。各子表的输入前端和指标不同,应在同一子表内比较:YCBInEOAT 的 mean ADD-S AUC 为 89.3,Toyota-Light / REAL275 的 AR 为 43.3 / 51.0;LM-O 的 CNOS + Wonder3D 条件下 AR 为 28.6。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
更细地看,YCBInEOAT 上 Any6D 的 mean ADD-S AUC 为 89.3、ADD AUC 为 45.6,分别高于 Gedi 的 82.7 和 7.7;Toyota-Light 上 AR 43.3,REAL275 上 AR 51.0。LM-O 是另一种更接近真实 onboarding 的压力测试:用 CNOS 检测、Wonder3D 生成形状时,Any6D 的 AR 28.6 高于同前端 GigaPose 的 17.5;把 Wonder3D 换成 InstantMesh 后 AR 降至 25.2,说明单图三维生成质量会实质性限制后续 pose 上限。
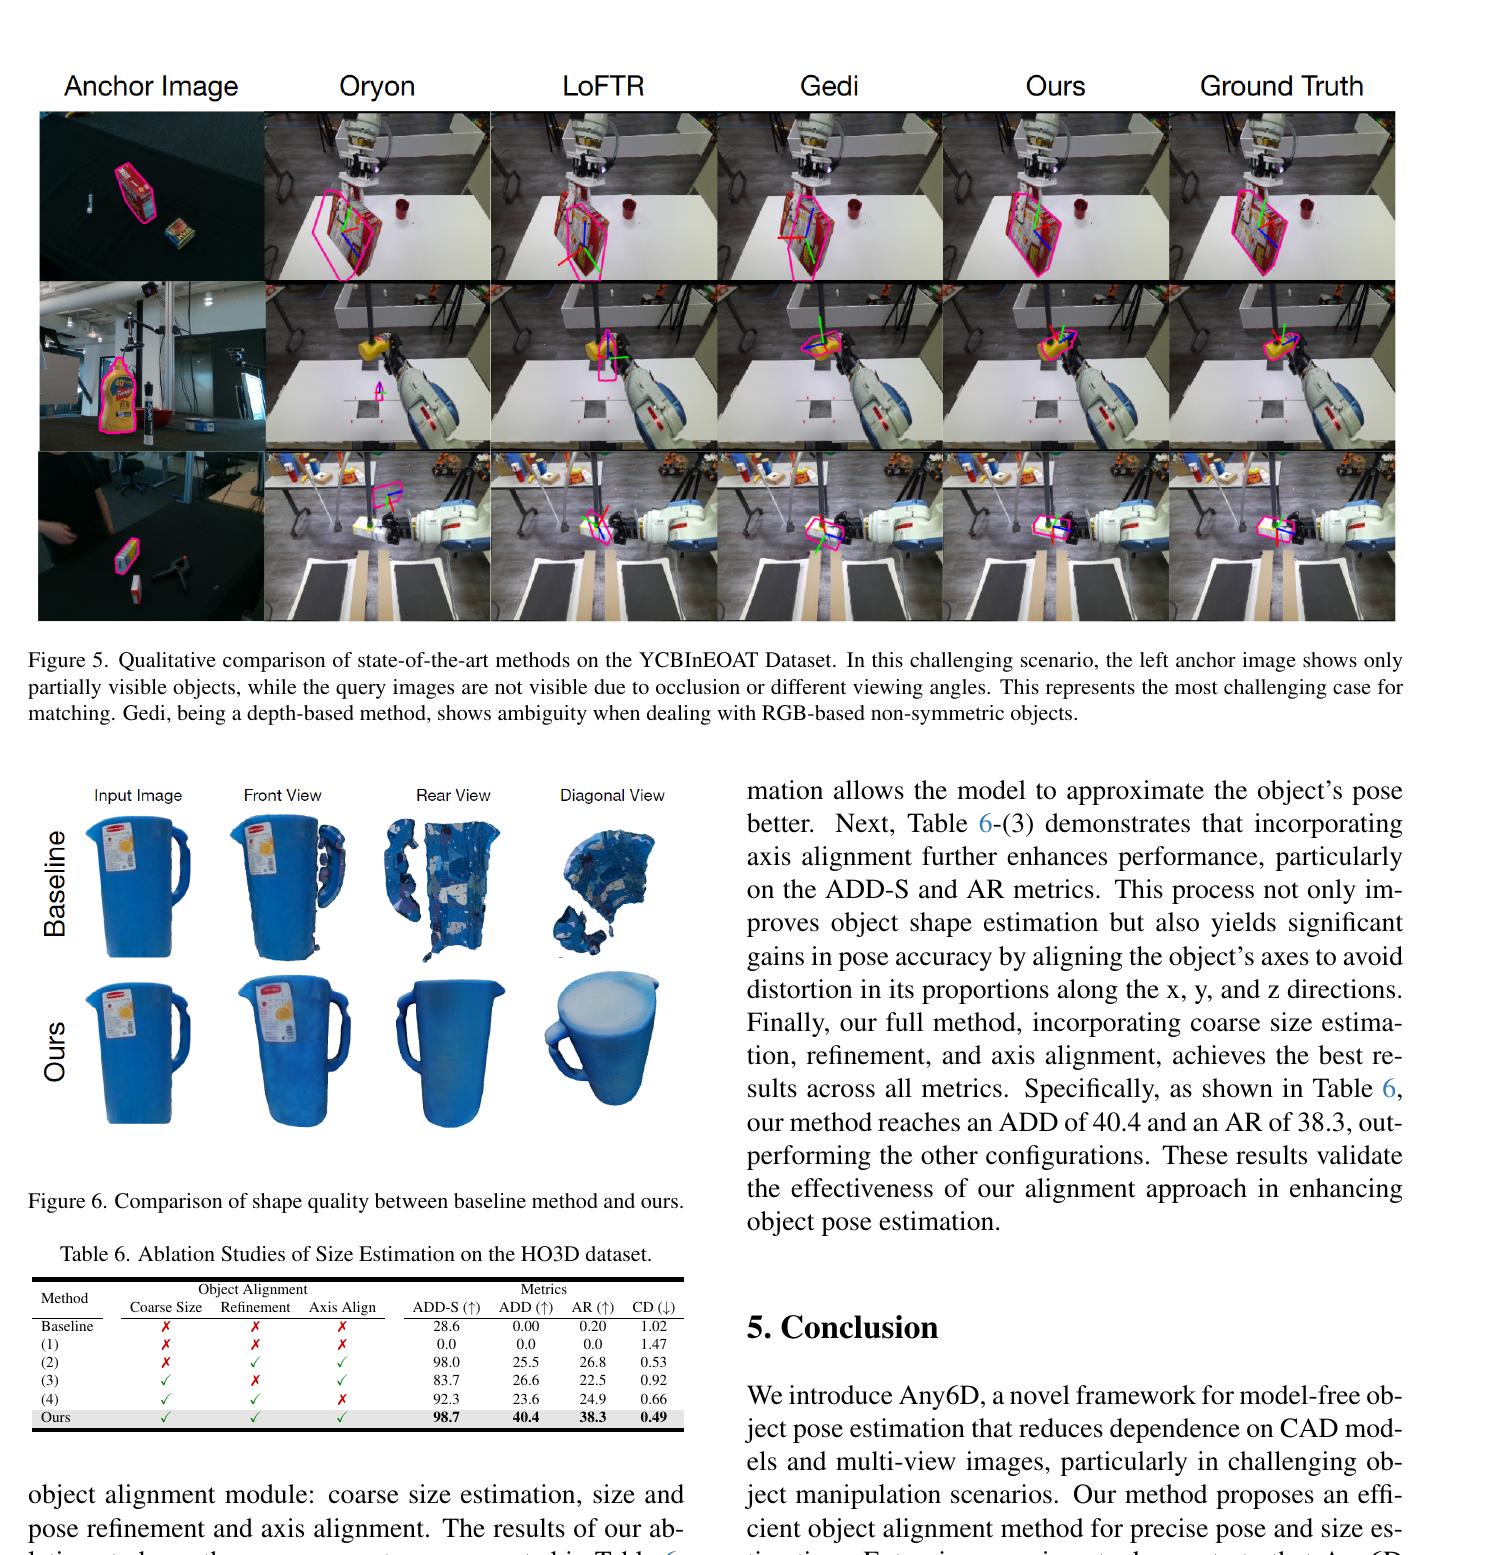 原论文定性结果与消融:上部展示遮挡和跨视角案例,下部对比基线形状 / 对齐,并给出完整系统的 HO3D 指标。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
定性图的正确读法不是只看最终轮廓是否“贴合”,而是分别检查:可见面的深度是否对齐、未见面的补全是否造成错误遮挡、对称物体的旋转是否只是视觉等价,以及 metric size 是否在不同场景保持一致。完整模型在 HO3D 的 ADD-S AUC / ADD AUC / AR 为 98.7 / 40.4 / 38.3;三者差距提示对称感知指标很高时,非对称点误差和 BOP 误差仍可能明显。
6. 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| 单 RGB-D anchor 足以支持未知物体 pose + size | 多个 benchmark 支持,但 anchor/query overlap 和 mask 质量是没有消失的条件。 |
| 可处理大跨环境变化 | HO3D、YCBInEOAT、Toyota-Light 的分域结果有说服力;仍应测试更极端的深度缺失和透明物体。 |
7. 复现要点与限制
- 对齐时必须统一 depth scale、anchor/query 相机内参以及 object mask 边界。
- 需要记录 candidate 数、pose / size sampling 范围、refinement iterations;这些决定精度–时间交换。
- 单 reference 的未观测面仍无真实几何信息,render-and-compare 不应被误读为“恢复完整物体”。
- 跨方法比较时还要记录 reference 是真实 RGB-D、预测 mesh 还是合成视图;“model-free”路线可能把 CAD 成本转移到了采集参考图、分割或单图三维生成,而不是让对象先验彻底消失。