论文精读笔记:Betsu-Betsu: Multi-View Separable 3D Reconstruction of Two Interacting Objects
1. 基本信息
2. 一句话定位
Betsu-Betsu 是一个双对象、静态多视图的可分离 neural implicit reconstruction 系统:共享场景特征以解释遮挡,同时用两个 SDF head 和 alpha-blending regularizer 让一个 3D 点不同时属于两个不透明对象,从源头抑制接触区的几何穿插。
2.1 论文图表导读
| 图表 | 内容 | 阅读重点 |
|---|
| Figure 1 | 多视图输入与 separable outputs | 目标不是只重建联合 mesh,而是输出各对象的独立几何和渲染 |
| Figure 2 | shared hashgrid、two SDFs、alpha blending | 分离约束发生在 opacity / volume rendering 层,不只是 2D semantic label |
| Table 1 | 人–物数据的 overall / object Chamfer | 需分别看整个场景与小物体;整体分数可能被人体主导 |
| Table 2、5 | AffordPose 与 novel-view synthesis | 验证分离是否同时改善几何和外观 |
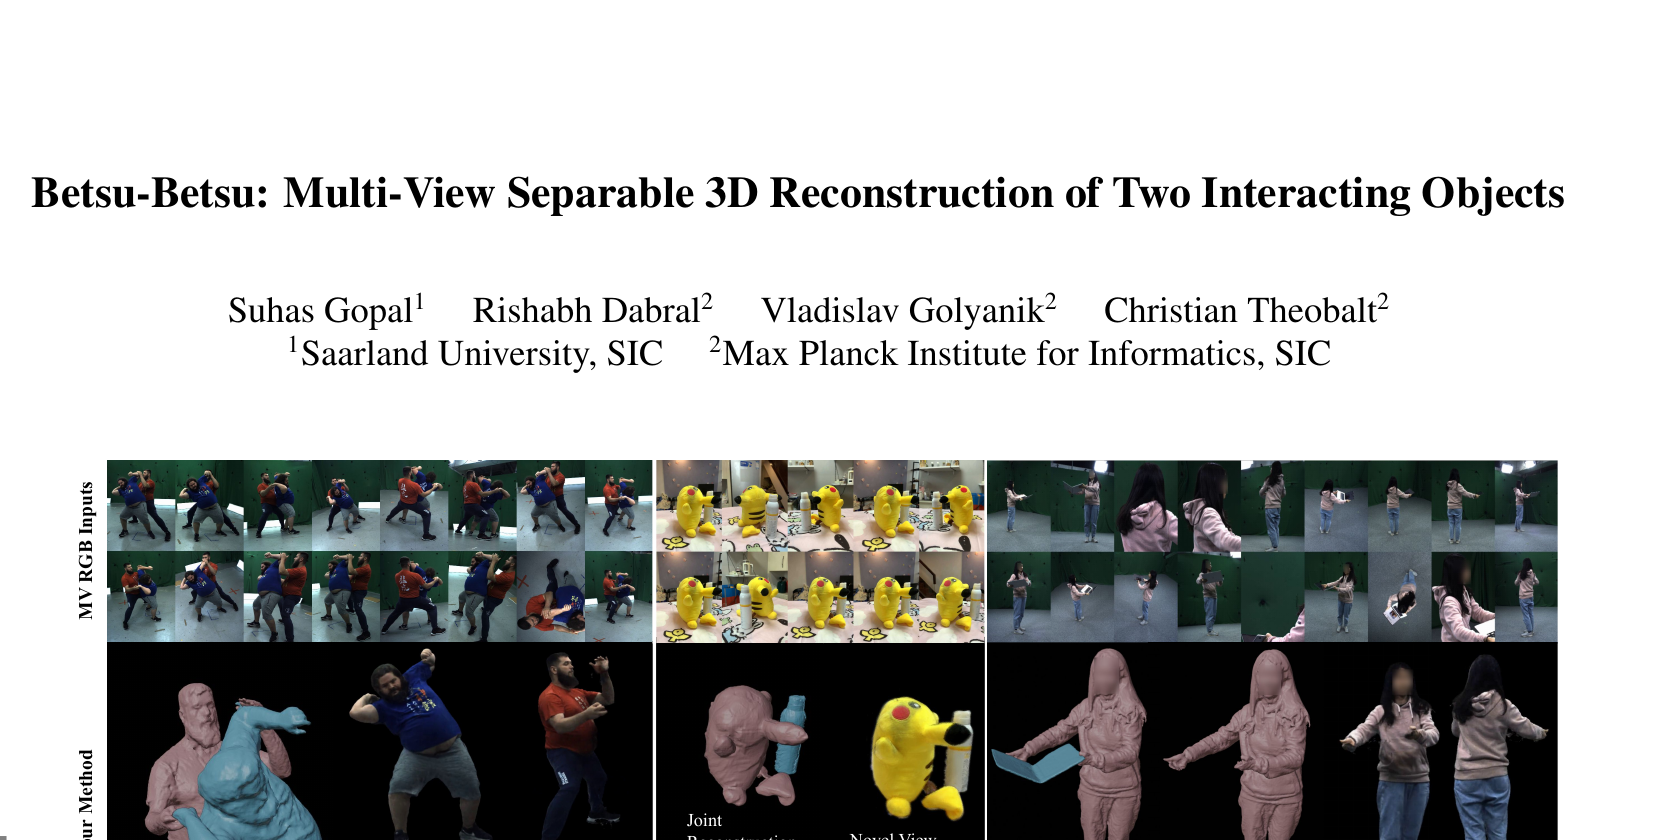 原论文 Figure 1:由分割多视图 RGB 输入重建两个交互对象的独立几何与新视角渲染。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
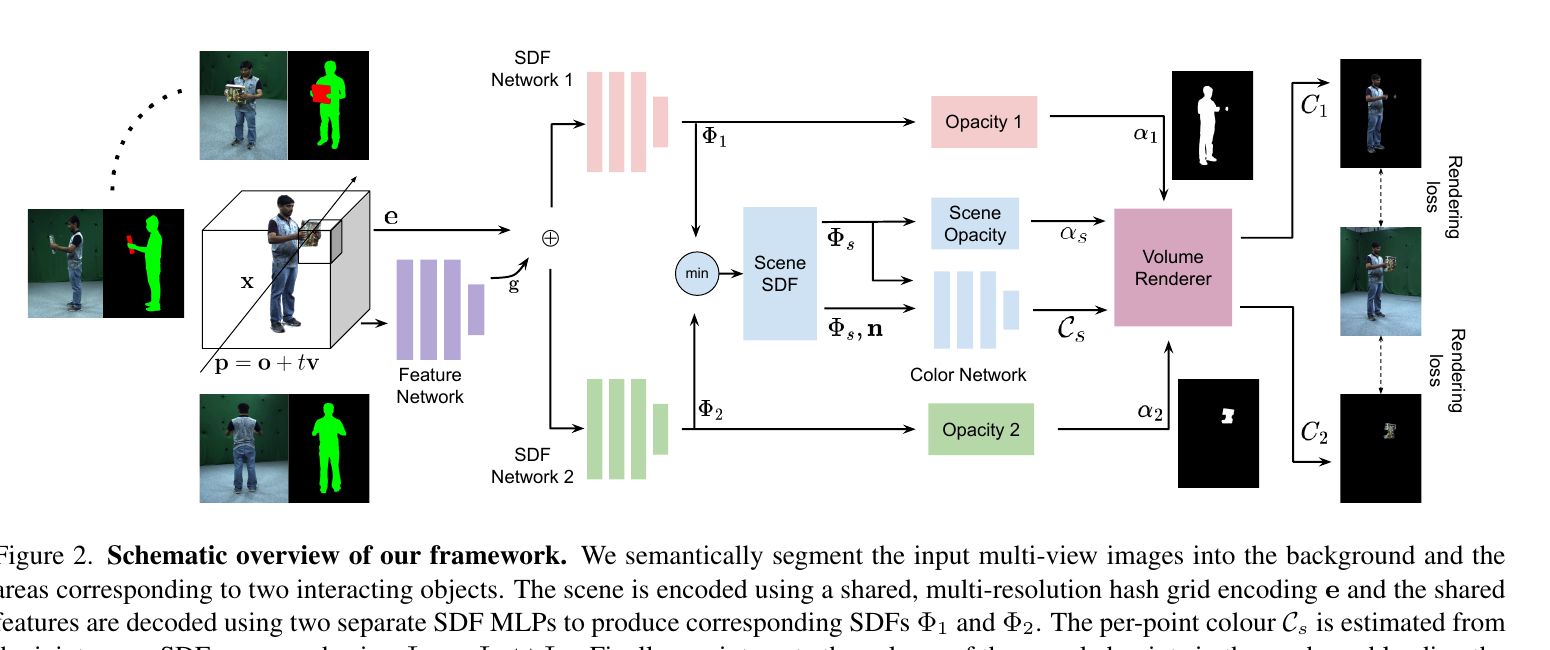 原论文 Figure 2:共享 hash-grid 特征、两支 SDF、联合场景 SDF 与 alpha-blending separation 的框架。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
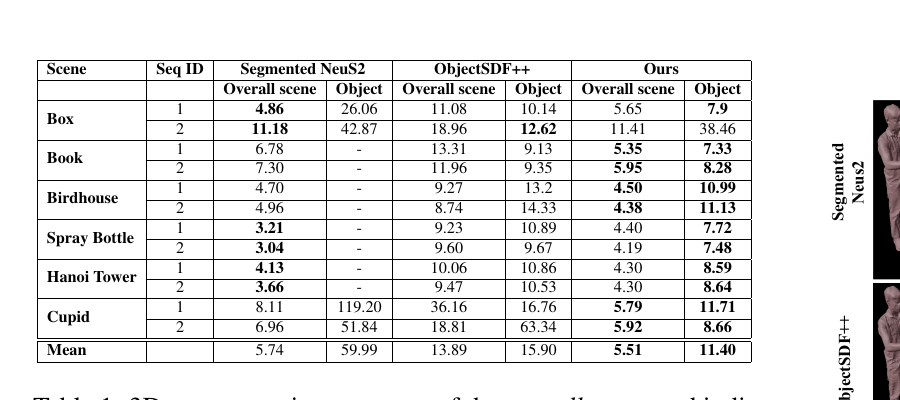 原论文 Table 1:人–物捕获数据上的 overall scene 与单独 object 的 Chamfer Distance(越低越好)。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- 输入为 K 张已标定多视角 RGB 图,以及两件交互对象各自的 segmentation masks M1,M2。
- 输出为对象 1、对象 2 的独立 SDF / mesh、联合场景 appearance 以及各自的新视角渲染。
- 论文的 pose 不是预测变量;相机 pose 已给定。它解决的是 pose / interaction refinement 的前置几何问题:当两个对象接触并遮挡时,表面所有权如何保持不重叠。
- 默认两个对象不透明、场景在多视角 capture 过程中静止;每场景都有长时间 optimization。
4. 研究动机
为每个对象分别训练一个 NeRF / SDF,会在被遮挡区域产生冲突:在某视图被另一个物体挡住的区域,单对象模型可能把“不可见”错误解释为“应被挖掉”。只训练一个联合场景则没有对象归属。已有 ObjectSDF++ 也预测多个 SDF,但论文认为仅依赖 opacity supervision 仍可能在内部产生互相穿插的 phantom geometry。
Betsu-Betsu 的关键洞察是:对不透明双对象,在任意采样点,两个对象的 opacity 不应同时高。这个约束不需知道“到底归谁”,却能惩罚 α1α2 的重叠。
5. 方法详解
5.1 共享编码、独立形状头
给定空间点 x,multi-resolution hash grid 编码 h(x) 与 feature network 产生共享场景特征 g;两个独立 MLP 分别输出 Φ1(x),Φ2(x)。联合场景 SDF 用
Φs(x)=min(Φ1(x),Φ2(x))
组合,再由 color network 结合位置、视线、法线和 Φs 预测场景颜色。共享编码让两对象能利用同一场景上下文,独立 SDF head 则保留实例边界。
5.2 为什么 alpha-blending 能减少穿插
每个 SDF 经 NeuS 型映射得到 α1,α2,联合 opacity 按
αs=α1+α2−α1α2
组合。论文定义的 Lalpha 会惩罚两份 opacity 同时存在的情况,使学习过程偏好“一个点只对一个对象不透明”。总 loss 包含 individual object color、scene color、Lalpha 和 Eikonal regularization。
重要细节:这不是硬的 SDF no-overlap constraint。它是在 rendering sampling locations 上软约束 opacity,因此对未观测 interior 的分离是由 regularization 诱导,而不是由真实几何直接监督。
| 模块 | 输入 / 输出 | 目的 | 相比单对象重建的差异 |
|---|
| shared hash-grid + feature net | 位置 → 共享特征 | 编码共同场景信息 | 不把遮挡关系完全切开 |
| two SDF heads | 共享特征 → Φ1,Φ2 | 给两个对象独立几何 | 输出有实例归属的 surface |
| scene SDF / color | 双 SDF → 联合渲染 | 解释遮挡和整体 RGB | 颜色仍是场景级,不盲目重复建模 |
| alpha regularizer | α1,α2 | 降低接触区穿插 | 约束对象内部 ownership |
6. 实验分析
6.1 数据和指标
论文采集了人–物 close interaction capture-dome 数据,同时在 AffordPose(手–物)、WildRGB-D(物–物)、NeuralDome(人–物)和 ReMoCap(人–人)上评估。几何采用双向 Chamfer Distance(低更好),外观采用 hold-out views 的 PSNR、SSIM、LPIPS;另以 3D IoU 观察两对象交叠。
人–物的 overall scene 分数要谨慎读:人体通常远大于被交互的小物体,overall Chamfer 可被人体质量主导。因此 Table 1 把单独 object CD 也列出,这是评估 separation 是否真的生效的更有用数字。
6.2 关键结果
| 任务 / 结果 | Segmented NeuS2 | ObjectSDF++ | Betsu-Betsu | 阅读结论 |
|---|
| Human–object overall CD mean | 5.74 | 13.89 | 5.51 | 联合场景接近或略优于分开训练的 NeuS2 |
| Human–object object CD mean | 59.99 | 15.90 | 11.40 | 单独对象的几何分离是主要收益 |
| AffordPose hand CD mean | 7.00 | 6.18 | 5.87 | 对手部也有提升 |
| AffordPose object CD mean | 9.26 | 6.79 | 3.80 | 小物体受益更明显 |
| Novel view mean | — | 28.02 / 0.95 / 0.08 | 32.42 / 0.97 / 0.06 | PSNR / SSIM / LPIPS 均改善 |
作者的 Figure 7–9 消融进一步表明,没有 alpha regularization 或使用 shared SDF head 时,渲染有时仍可看起来正常,但透明表面内部会形成 phantom blobs / interpenetration。这是本文最有说服力的点:仅用 rendered RGB 很难惩罚不可见的内部错误,因此需要 ownership-oriented prior。
6.3 证据边界
- “分离几何优于 ObjectSDF++”:object-level Chamfer、novel-view 和 qualitative comparisons 都支持该说法。
- “无 template、适用任意对象”:在多种 interaction type 上有演示,但仍限于二对象、离线多视图、mask supervision 和静态 capture。
- 我的分析:对于 pose downstream,减少穿插能够改善可见性 / contact reasoning,但还需要可微 rigid transform 或明确 pose head;Betsu-Betsu 本身不能产出在线 6D pose。
7. 局限与潜在失败
- 采集条件强:相机内外参、多个视角、每对象 mask 都是硬输入;没有处理在线视频中的连续 pose estimation。
- 对象数固定:两个 SDF head / 两对象 alpha 组合直接限定了主方法;扩展到多对象会遇到组合、身份交换和资源增长问题。
- 材质假设:透明、半透明、镜面物体违反“一个点对一个不透明对象”的假设。
- 遮挡内表面:alpha regularizer 降低重叠,但没有魔法地观测被长期遮挡的几何;结果仍受 neural field prior 影响。
8. 对 object pose 与交互几何的启发
- pose refinement 中可以借鉴 “per-point ownership” 思路:渲染 residual 应按对象可见性 / occupancy 分配,避免两个模型共同解释同一像素。
- 对接触操作,联合对象的物理不交叠先验可与 6D rigid pose、接触距离和 symmetry-aware loss 共同使用。
- 值得进一步测量:separable reconstruction 所带来的 pose/contact 误差是否改善,而不只报告 Chamfer 和 NVS。
