Reading Notes
粗读 / 精读
已生成 src/paper-notes/boxdreamer/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:BoxDreamer: Dreaming Box Corners for Generalizable Object Pose Estimation
1. 基本信息
- 标题:BoxDreamer: Dreaming Box Corners for Generalizable Object Pose Estimation
- 作者 / 机构:Yuanhong Yu, Xingyi He, Chen Zhao, Junhao Yu, Jiaqi Yang, Ruizhen Hu, Yujun Shen, Xing Zhu, Xiaowei Zhou, Sida Peng;Zhejiang University, Xiangjiang Laboratory, Ant Group, EPFL, Chongqing University, Northwestern Polytechnical University, Shenzhen University
- 年份 / 会议或期刊:2025 / ICCV
- 论文链接:arXiv:2504.07955
- 代码 / 项目页:Project / Code
- 阅读模式:粗读
2. 一句话定位
BoxDreamer 把 unseen object 的 6D pose estimation 转化为“从稀疏参考 RGB 图像恢复 3D bounding box,再在 query 图像中预测 8 个 box corners 的 2D 投影,最后用 PnP 求位姿”的问题,用 box corners 这个紧凑语义几何表示替代 dense point cloud / view retrieval,从而提升 sparse-view 和遮挡场景下的泛化能力。
方法输入与输出
| 项目 | 内容(本站整理) |
|---|---|
| 推理输入 | 单张 query RGB;同一目标的少量 reference RGB;目标检测框 / mask;相机内参。参考图先经离线重建得到参考位姿与物体 3D 包围盒,再投影成参考角点热图。 |
| 最终输出 | 目标物体在 query 相机坐标系中的旋转 和平移 。网络直接预测的是 8 个包围盒角点的二维热图,最终位姿由 PnP 求解。 |
| 必要条件 | 不需要目标 CAD 或传感器深度,但需要参考图建库和粗几何。平移尺度随重建包围盒的尺度,不能把纯 RGB 重建自动等同于已知米制尺寸。 |
2.1 论文图表导读
| 图表 | 作用 | 粗读建议 |
|---|---|---|
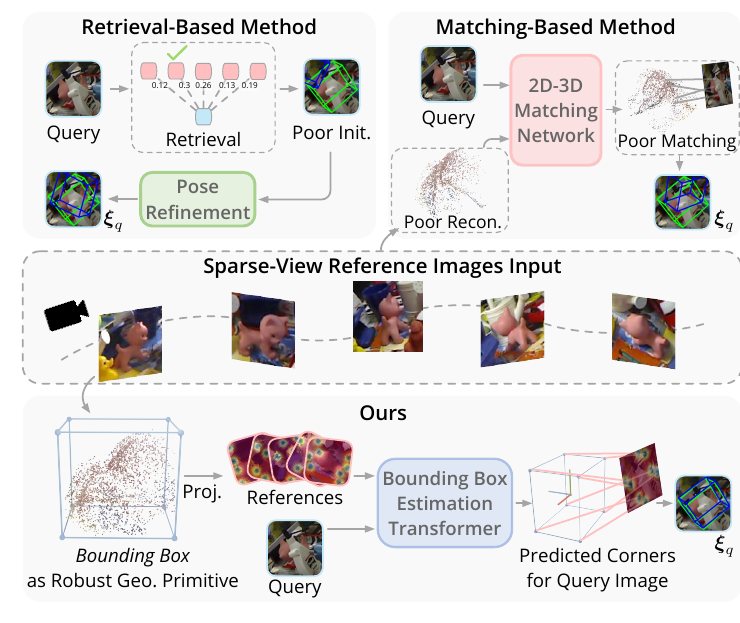
| Figure 1 | 对比 retrieval-based、matching-based 和 BoxDreamer 的 generalizable pose 范式 | 先看它理解为什么作者选择 box corners |
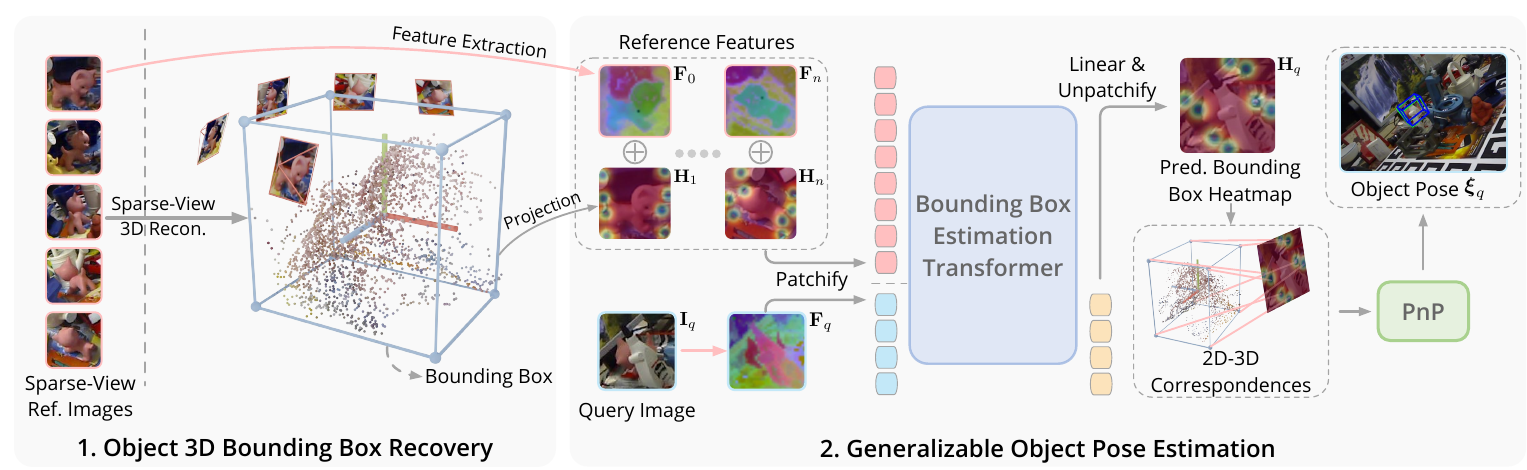
| Figure 2 | 展示完整 pipeline:3D box recovery、heatmap transformer、PnP | 方法部分反复对照这张图 |
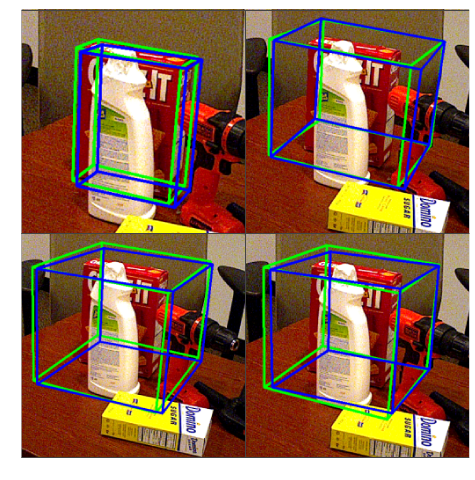
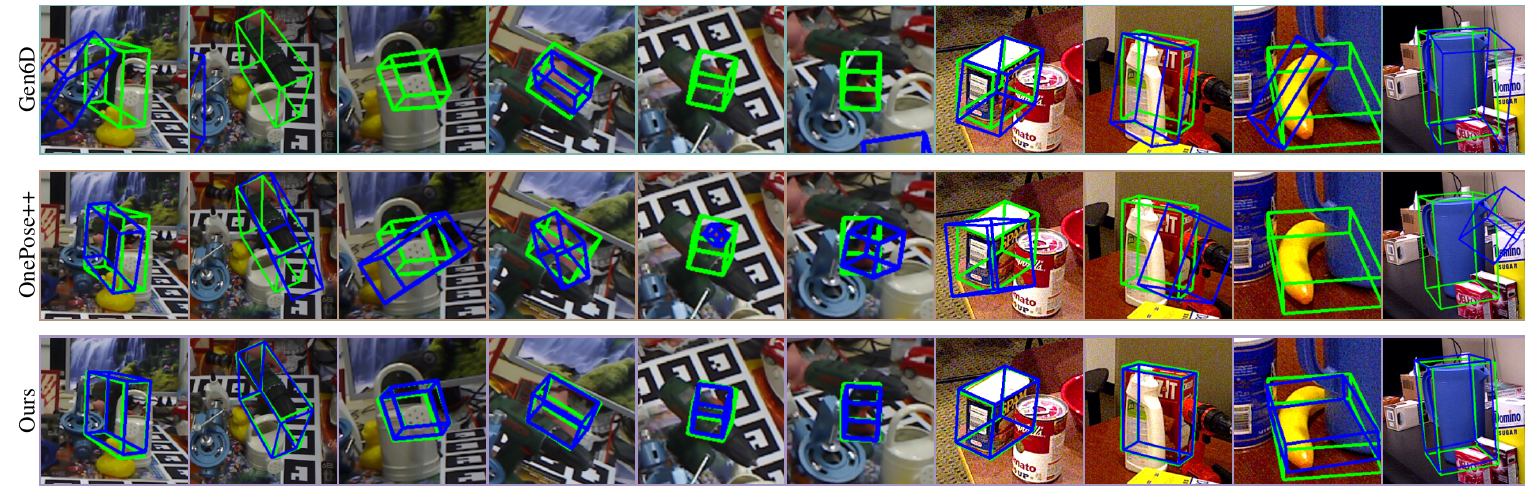
| Figure 3 | 在 Occluded-LINEMOD 和 YCB-Video 上做定性对比 | 和主结果一起看,判断遮挡场景是否真的更稳 |
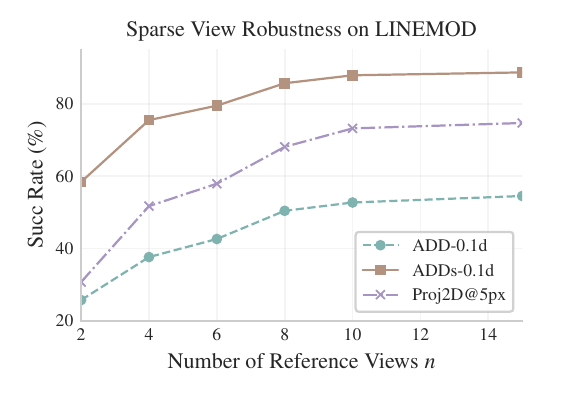
| Figure 4 / Figure 5 | 分析 reference 数量和 noisy box 的影响 | 用来判断 sparse-view claim 和鲁棒性 claim 是否充分 |
3. 问题设定
- 任务:generalizable RGB-based object pose estimation,在目标物体未见过的情况下,用少量参考图像估计 query 图像中的 6D object pose。
- 输入:
- query RGB image;
- 同一目标物体的 sparse-view reference RGB images;
- reference/query 中用于定位物体的 detections 或 masks;
- camera intrinsics;
- 离线阶段用 sparse-view reconstruction 得到的 rough point cloud、reference camera poses 和 3D bounding box。
- 输出:query 视角下目标物体的 6DoF pose。
- 关键假设 / 先验:
- 不依赖 CAD model,也不依赖 depth。
- 需要目标物体的 reference images,并且需要检测/分割给出物体区域。
- 需要能从 sparse reference views 中离线恢复出可用的 3D bounding box;论文实验主要用 DUSt3R。
- pose recovery 最终依赖 2D-3D corners correspondence + PnP。
- 适用场景:机器人抓取、AR、真实物体快速建库等“没有 CAD,但可拍少量参考图”的 unseen object pose 场景。
4. 核心动机
- 想解决什么问题:
- Gen6D 一类 retrieval-based 方法依赖密集 reference views,稀疏视角下容易检索到不合适 viewpoint,导致初始化和后续 refinement 失败。
- OnePose / OnePose++ 一类 matching-based 方法依赖较完整的重建点云和 robust 2D-3D matching,稀疏视角、遮挡和低纹理下点云不完整,匹配也会变弱。
- 为什么这个问题重要:
- 真实应用里为每个物体采集密集视角很费时,也未必有 CAD / depth。
- 遮挡是 6D pose 的常态,仅依赖局部可见像素和 dense matching 往往不够稳。
- 相比已有方法主要不满在哪里:
- retrieval-based:需要足够相似的参考图。
- matching-based:需要高质量点云和可见区域匹配。
- sparse-view NVS / Gaussian 方法:构建表示可能慢,或者对生成质量敏感。
5. 方法概览
- 总体 pipeline:
- 对 sparse reference images 做离线重建,得到 rough point cloud 和 reference camera poses。
- 用 detections / masks 过滤非物体点,并把点云转到 object-centric coordinate system,得到目标物体 3D bounding box。
- 把 3D box corners 投影到 reference images,生成每个 corner 的 2D heatmap。
- 用 DINOv2 提取 reference/query image features,把 reference heatmap tokens 和 image features 融合。
- 用 transformer decoder 预测 query view 的 8-channel bounding box heatmap。
- 从 heatmap 取 2D corners,与 3D box corners 形成 2D-3D correspondences,用 PnP 输出 query pose。
- 关键模块:
- 3D bounding box as object representation:用粗 3D box 替代 dense point cloud。
- 2D heatmap as box representation:不用直接回归稀疏 corner 坐标,而是用平滑 heatmap 给 transformer 更密的监督信号。
- reference-based point synthesizer / bounding box estimation transformer:根据 reference demonstrations 在 query 中“合成”corner heatmaps。
- PnP pose recovery:把 8 个语义角点直接转成可解释几何求解。
- 使用的基础模型 / 技术:DUSt3R、DINOv2-base、Transformer decoder、Smooth L1 loss、PnP。
- training-free 还是需要训练:不是 training-free;网络用 Objaverse synthetic data 和 OnePose real data 训练。每个新物体推理时不需要重新训练,但需要离线 reference reconstruction。
6. 实验概览
- 数据集:
- 训练:Objaverse synthetic objects + OnePose real objects,共 45k+ synthetic objects、50 real objects、2.9M+ images。
- 测试:LINEMOD、Occluded LINEMOD、YCB-Video、OnePose-LowTexture;OnePose 结果主要放在补充材料。
- 评估指标:
- LINEMOD / Occluded LINEMOD / OnePose-LowTexture:ADD(s)-0.1d、Proj2D@5px。
- YCB-Video:ADD-AUC、ADD-S AUC。
- 主要 baseline:Gen6D、OnePose++、GS-Pose、Cas6D,以及 PoseCNN / PVNet 等 instance-level 方法。
- 主要结果:
- LINEMOD subset:5 references 下 ADD(s)-0.1d 为 53.1,明显高于 GS-Pose 25.6、Gen6D 18.0、OnePose++ 1.1;参考图增加后,BoxDreamer 与 GS-Pose 进入同一量级,但速度更快。
- Occluded LINEMOD:5 references 下平均 ADD(s)-0.1d 为 26.5,25 references 下为 43.6;同设置下 OnePose++ 分别几乎失败或很低,Gen6D 即使给 GT detection 也明显低于 BoxDreamer。
- YCB-Video Sparse Database:16 references 下 BoxDreamer ADD-S / ADD 为 66.6 / 40.0,高于 Gen6D+GT detection 的 55.2 / 28.6;5 references 下也达到 59.8 / 31.8。
- OnePose-LowTexture:10 references 下平均 ADD-0.1d 为 86.6,高于 OnePose++ 58.0 和 Gen6D+GT detection 21.2,接近/超过 PVNet 的 62.7。
| 设置 | 代表结果 | 粗读结论 |
|---|---|---|
| LINEMOD, 5 refs, ADD(s)-0.1d | BoxDreamer 53.1 vs GS-Pose 25.6 | sparse-view 低参考数优势明显 |
| Occluded LINEMOD, 25 refs, ADD(s)-0.1d | BoxDreamer 43.6 vs Gen6D+GT 25.5 | 遮挡场景下 box corners 比 retrieval/matching 更稳 |
| YCB-Video Sparse, 16 refs, ADD-S / ADD | 66.6 / 40.0 | 相比 Gen6D+GT detection 提升明显 |
| OnePose-LowTexture, 10 refs, ADD-0.1d | 86.6 | 对低纹理物体有较强泛化结果 |
| Runtime, 5 refs | online inference 约 17 ms;offline reconstruction 约 5.3 s | 推理快,但新物体建库仍有离线成本 |
- 作者声称的结论是否基本被实验支持:
- 作者声称:bounding box corners 是 sparse-view generalizable pose 的有效中间表示,能提高遮挡和稀疏参考下的鲁棒性。
- 我的分析:论文内的主结果、定性图、reference 数量曲线和 noisy box 分析基本支撑这个结论;但方法仍依赖 detection/mask、camera intrinsics 和离线重建,不能理解为“只给任意单张图就能开放世界 pose”。
7. 优缺点
优点
- 表示选择清晰:用 8 个 box corners 连接 sparse 3D prior 和 PnP,避免 dense point cloud matching 的脆弱性。
- 对 sparse reference 特别友好,5 个 reference images 下已有强结果。
- RGB-only、CAD-free、depth-free,对真实物体建库更有吸引力。
- 运行速度快:论文报告 5 references 下 online pose inference 约 17 ms。
- 代码已经公开,并提供 CLI / Gradio demo / 模型准备说明。
缺点 / 风险
- 不是完全无先验:仍需要 reference images、camera intrinsics、detections/masks 和离线 reconstruction。
- symmetric objects 仍是论文明确承认的弱点,因为 box corners 对对称等价姿态不天然友好。
- 2D detection 与 pose estimation 分离,检测错了后续 corner prediction 很难补救。
- dense reference inputs 能提高潜力,但会带来更高 memory usage。
- 3D bounding box 是粗几何表示,对非盒状、强对称、细长或可变形物体的约束可能不够。
8. 对我的启发
- 可以借鉴的点:
- 用全局语义几何点替代 dense correspondence,降低稀疏/遮挡下的匹配难度。
- 把 3D prior 做成 reference heatmap demonstration,再由 transformer 迁移到 query view。
- 训练时随机旋转 3D box,削弱 corner channel 和物体语义的死绑定,有助于泛化。
- 可以作为 baseline 吗:
- 对 CAD-free、RGB-only、sparse-reference、unseen object pose,非常值得作为 baseline。
- 对传统 BOP seen-object CAD setting,不是直接同设定 baseline。
- 是否值得精读:
- 值得。尤其是 3D box recovery、heatmap representation、reference/query token 融合、reference 数量和 box 噪声分析。
- 后续需要查的问题:
- 官方代码在本地环境的实际运行成本,尤其是 DUSt3R、DINOv2、PnP 和 demo pipeline 的输入格式。
- 对强对称物体是否可以加入 symmetry-aware pose head 或多解假设。
- 如果检测/mask 来自 SAM2 或开放词汇 detector,整体稳定性是否足够真实部署。