论文精读笔记:CanoVerse: 3D Object Scalable Canonicalization and Dataset for Generation and Pose
1. 基本信息
标题:CanoVerse: 3D Object Scalable Canonicalization and Dataset for Generation and Pose
作者:Li Jin、Yuchen Yang、Weikai Chen、Yujie Wang、Dehao Hao、Tanghui Jia、Yingda Yin、Zeyu Hu、Runze Zhang、Keyang Luo、Li Yuan、Long Quan、Xin Wang、Xueying Qin
机构:Shandong University、LIGHTSPEED STUDIOS、UNC Chapel Hill、HKUST、Peking University
年份 / 会议:ECCV 2026
论文链接:arXiv:2603.07144
数据与代码:Canoverse GitHub
阅读模式:精读
阅读重点:数据构建是否真正可扩展、canonical orientation 与 6D pose 的边界、实验是否能拆分“标签质量”和“数据规模”的作用。
2. 一句话定位
CanoVerse 的核心不是发明一个新的场景 6D pose 网络,而是建立“几何/语义候选生成 + 人类轻量判别”的大规模 3D canonicalization 工厂;它从 75 万个 Objaverse / Objaverse-XL 资产中筛出 32 万个、覆盖 1,156 类的规范化对象,并用完整点云朝向恢复、3D 生成和跨模态检索三条下游证据说明统一坐标系本身是一种可学习的数据先验。
我的核心判断
CanoVerse 对位姿估计最有价值的部分是坐标系治理 。许多 category-level pose、NOCS、生成式 CAD 扩增和 synthetic-to-real 管线默认所有 3D 资产共享一致的“正面 / 朝上 / 尺度 / 中心”定义;现实中这个默认往往不成立。本文把这项看似琐碎、实际会污染全部标签的工作变成了可量化的数据管线。
但必须守住任务边界:论文的 orientation estimation 以完整、已经分离的对象点云 为输入,中心和平移在预处理时已归一化,输出只是对齐 canonical frame 的旋转。因此它与“从场景 RGB/RGB-D 估计相机坐标系中的 R , t R,t R , t
2.1 论文图表导读
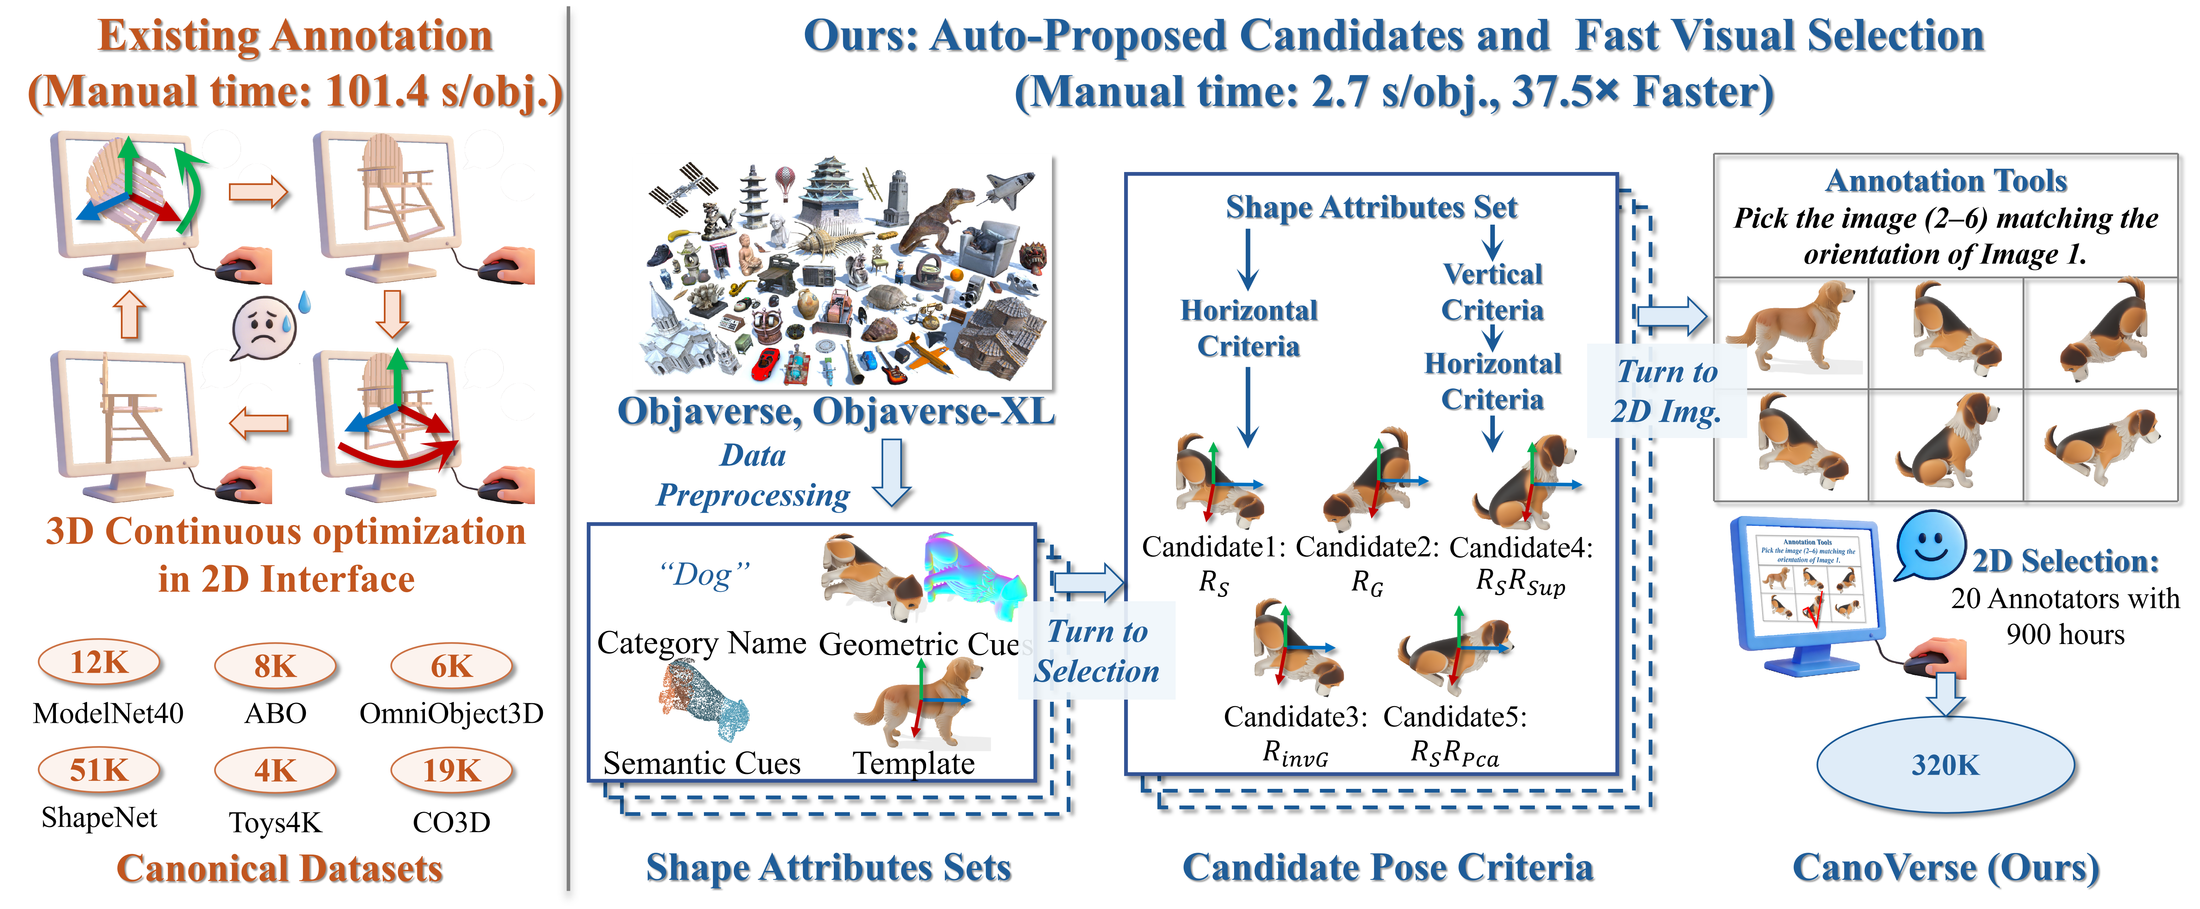
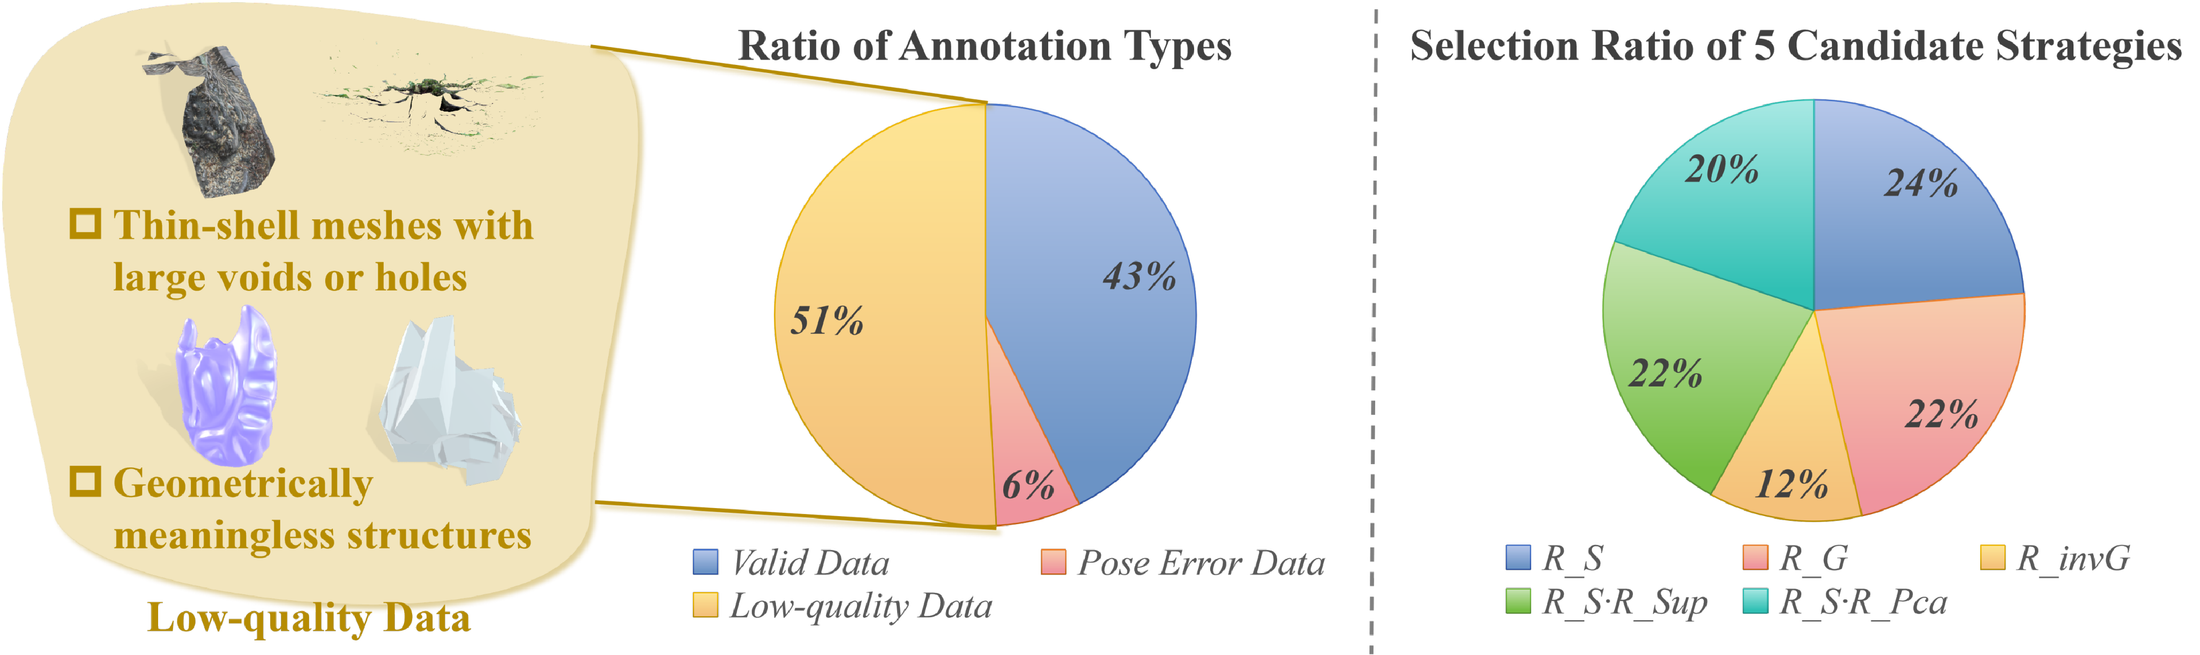
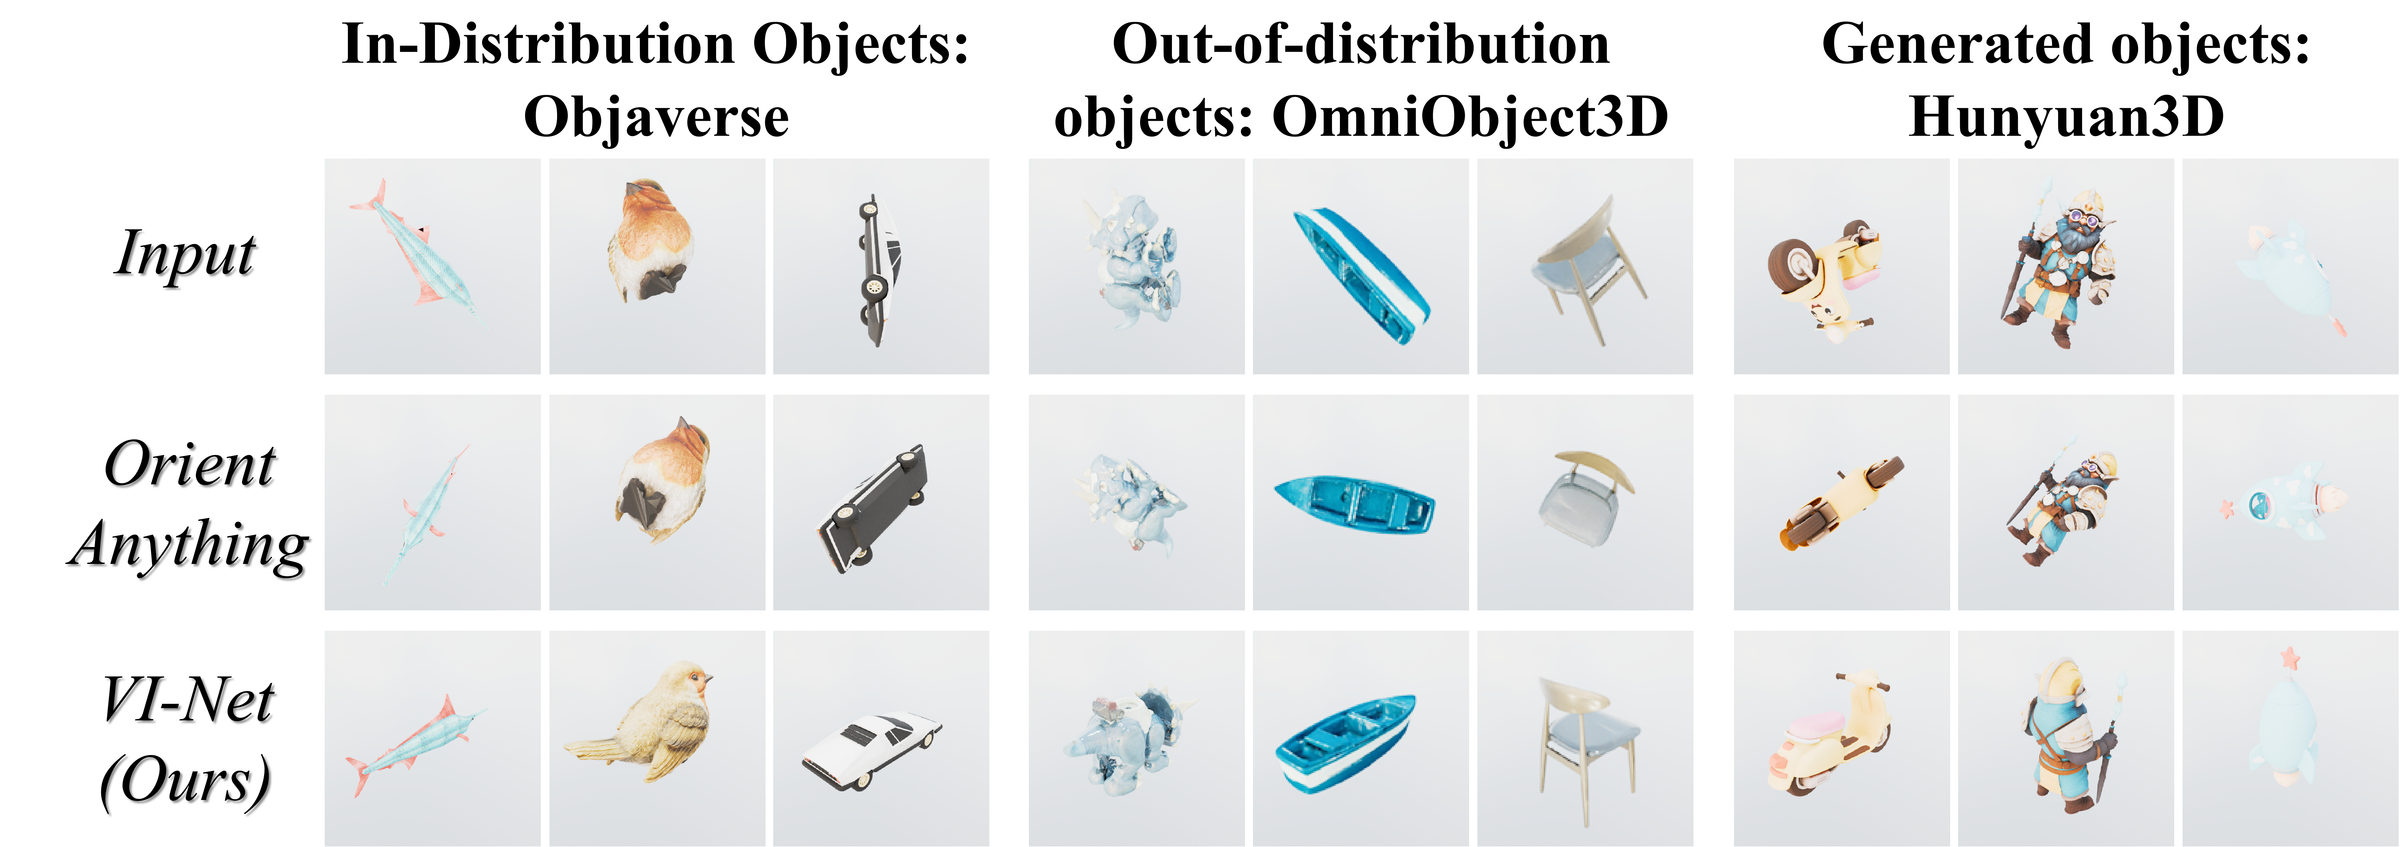
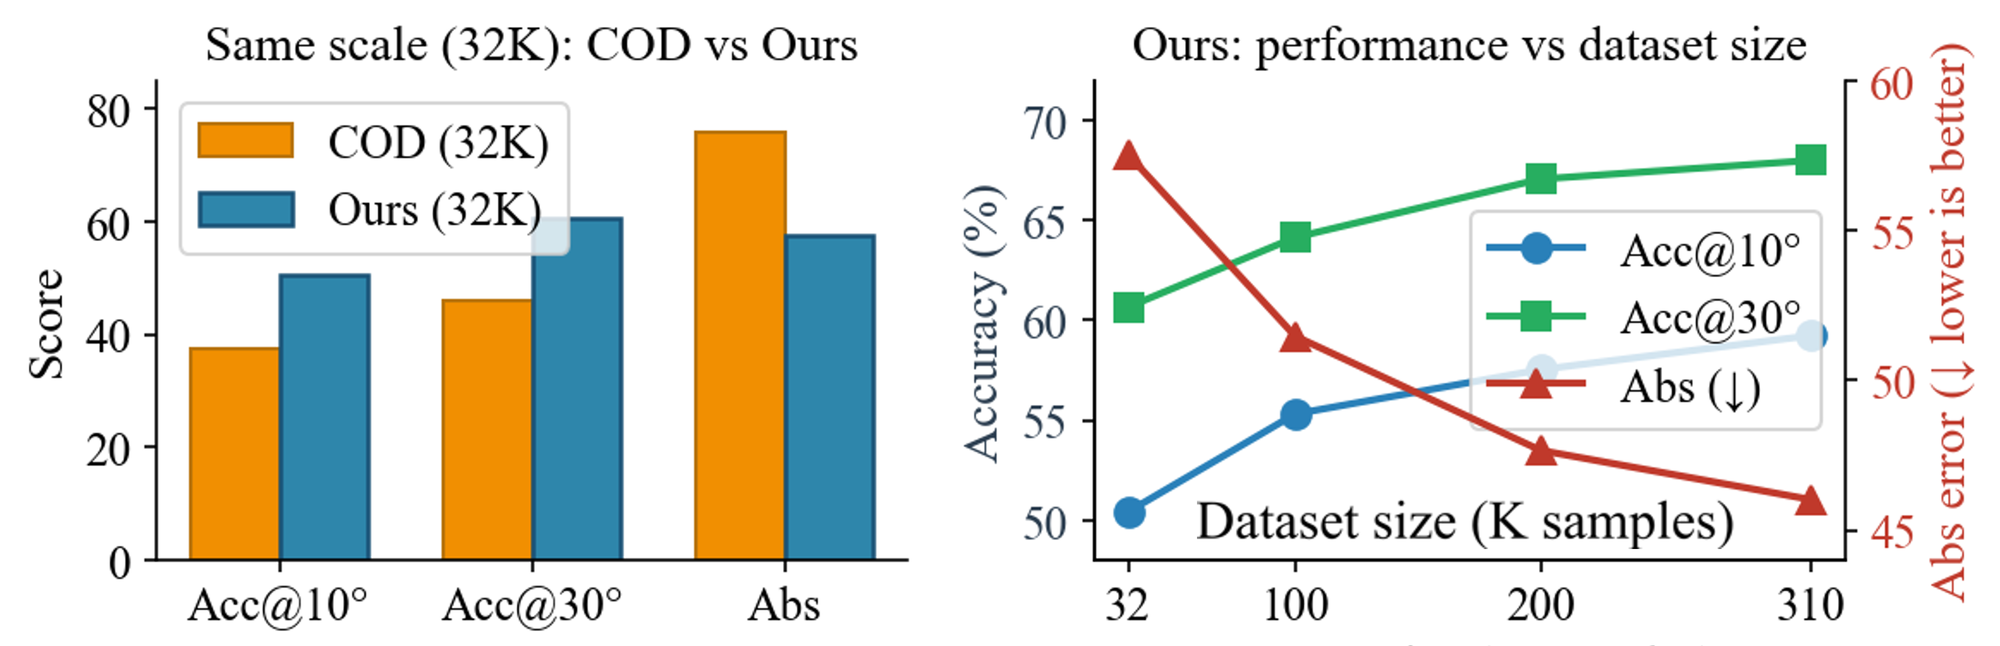
图 内容 精读时的证据作用 需要警惕的解读 Figure 3 从连续 3D 手工旋转到 5 候选 + 2D 选择 解释 37.5× 效率增益来自哪里 系统仍依赖模板、语义模型、VLM 和人工;不是无监督自动标签器 Figure 5 保留 / 淘汰比例与五种候选分布 展示质量控制和候选集合的覆盖结构 饼图描述过程,不直接等于标签准确率 Figure 7 ID、真实扫描 OOD、生成对象上的定性方向 表明方向先验可跨数据域迁移 输入仍是完整物体,无法代表遮挡和 clutter 场景 Figure 8 同规模数据质量比较与 scaling 同时验证质量与规模效应 只使用 VI-Net 和一个 ID split,尚不能称为普适 3D scaling law
原论文 Figure 3:类别模板、几何与语义线索生成五类候选旋转,标注员再从 2D 渲染中选择;图中对比约 101.4 秒/物体的既有手工流程和约 2.7 秒/物体的本文人工选择阶段。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
3.1 任务定义
给定一个带有任意全局旋转的完整 3D 对象 P o P^o P o R R R R P o RP^o R P o
物体被中心化并做统一尺度归一;
竖直轴符合“支撑 / 悬挂 / 主轴”等类别习惯;
水平朝向符合“正面”语义;
对称类别使用预定义的对称轴和角度约定;
相关类别尽量共享同一轴语义,例如车辆正面指向同一轴。
3.2 输入、输出与先验
阶段 输入 输出 隐含或显式先验 数据预处理 Objaverse / Objaverse-XL 网格 单位球归一化彩色点云、类别、语义部件 网格基本可用;Uni3D 类别与 Find3D 部件足够可靠 类别建模 每类对象集合 canonical template、轴约定、对称属性 人类能够为类别给出相对一致的方向定义 候选生成 目标点云、模板、语义部件 最多 5 个候选旋转 正确方向在几何/语义/PCA/支撑面的组合中可覆盖 人工选择 模板和候选的 2D 渲染 最终旋转或丢弃标记 2D 视图足以判断大多数细粒度方向 下游朝向估计 完整对象点云 canonical rotation 对象已完成分割、中心化和尺度归一化
3.3 训练与推理边界
数据构建不是 training-free:Uni3D、Find3D、VLM 都是预训练模型,且最终标签需要人类选择。
下游 VI-Net / CleanPose / AG-Pose / SecondPose 需要在 CanoVerse 子集上重新训练。
数据集构建阶段需要一个类别模板;下游 orientation network 推理时不一定显式输入该模板,而是把规范方向学入参数。
对 OOD 类别或真实扫描,模型能否工作取决于训练中形成的跨类别方向语义,而不是实例 CAD 匹配。
3.4 与标准 6D object pose 的关系
标准 6D pose 通常要求估计:
T c o = [ R c o t c o 0 1 ] , T_{co}=\begin{bmatrix}R_{co}&t_{co}\\0&1\end{bmatrix}, T co = [ R co 0 t co 1 ] , 其中 R c o R_{co} R co t c o t_{co} t co t c o t_{co} t co
它可为 category-level pose、NOCS 或生成式 CAD 数据提供更干净的对象坐标系;
它不能替代 detector、segmentor、depth / shape completion、PnP、registration 或 pose refinement;
它的 OmniObject3D orientation accuracy 不能与 BOP Average Recall 直接比较。
4. 研究脉络
4.1 论文试图填补的空缺
3D canonicalization 大致有三条路线:
人工连续对齐 :ShapeNet、OmniObject3D 等数据可以得到高质量方向,但 Blender 操作慢、学习成本高。自动 / 自监督 canonicalization :CaCa、ConDor、ShapeMatcher 等尝试从几何等变性学习规范方向,规模易扩展,但语义正面和类别约定不一定稳定。候选 + 人工判别 :COD 已展示用候选缩小操作空间的可行性;CanoVerse 在候选准则、类别覆盖、质量筛选和下游验证上进一步放大。
4.2 与 COD 的主要区别
CanoVerse 同时使用几何、语义部件、支撑面、PCA 和 180° 翻转,构成五类候选;不是只依赖单一几何规则。
规模从 COD 的约 32K 扩展到 320K,类别达到 1,156。
论文不只用 IC / GEC 评价 canonicalization,还训练朝向模型、3D 生成模型和检索模型验证下游效益。
同为 32K 时 CanoVerse 训练出的 VI-Net 优于 COD,作者据此主张标签质量也有贡献,而不是纯粹靠数量。
4.3 与类别级位姿估计的联系
NOCS、VI-Net、AG-Pose、SecondPose 等类别级方法都需要把同类别不同实例映射到共享坐标系。若训练资产的前后、上下不一致,同一 NOCS 坐标会对应不同语义部位,网络会遭遇标签冲突。CanoVerse 可以被视为在训练数据层面降低这种冲突。
5. 研究动机
5.1 为什么只做随机旋转增强不够
随机旋转增强解决的是输入姿态覆盖,而不是标签坐标系一致性。如果两个同类模型本身就采用不同 canonical frame,即使都做增强,它们的目标旋转仍互相矛盾。模型会把“哪个资产采用哪个坐标系”当成不可解释噪声。
5.2 为什么纯几何不够
对称形状往往有多个几何等价方向;杯把、相机镜头、床头等语义部件才决定正面。
PCA 的主轴存在符号歧义,且近似等长轴会导致不稳定。
稳定支撑面可决定朝上,却通常不能决定朝前。
不同类别需要不同规则:杯子适合支撑面,剑或吊灯更像悬挂 / 主轴问题,相机则依赖镜头语义。
5.3 为什么保留人工选择
作者没有声称 VLM 能完全替代人。它让机器负责高成本的候选搜索,让人只负责最擅长的语义判断。这个设计把操作从连续 S O ( 3 ) SO(3) S O ( 3 )
6. 方法详解
6.1 总体 Pipeline
从网格采样彩色点云,中心化并缩放到单位球。
Uni3D 给出类别,Find3D 根据类别文本产生语义部件点集。
为每类选 canonical template,并记录对称轴与旋转角。
分别计算竖直和水平候选。
组合为五种候选姿态,渲染到统一视图。
标注员参照模板选择最合适候选;错误类别、严重缺损、薄壳空洞或无意义结构直接丢弃。
保存对象 UID、类别与旋转矩阵,形成 CanoVerse。
6.2 模块级输入输出
模块 输入 输出 作用 主要风险 几何归一化 mesh / point cloud 单位球内点云 去掉平移和尺度干扰 非均匀尺度或残缺网格会改变主轴与支撑面 Uni3D 分类 彩色点云 类别 选择模板和类别准则 错分会把对象送入错误 canonical convention Find3D 部件 点云 + 类别文本 语义部件点集 解除纯几何前后歧义 部件缺失、类别描述不充分会污染能量 支撑面准则 几何 R S u p R_{Sup} R S u p 确定竖直方向 多支撑面 / 悬挂物体存在歧义 PCA + 语义 对象与模板 R P c a R_{Pca} R P c a 处理长条、主轴显著物体 近重复特征值导致主轴不稳定 水平几何 对象与模板 R G , R i n v G R_G,R_{invG} R G , R in v G 找到几何最接近的朝前角 几何对称时无法决定语义正面 水平语义 完整与部件点集 R S R_S R S 用部件关系确定正面 分割误差或部件缺失 2D 人工选择 模板与 5 候选渲染 旋转 / 丢弃 最终语义裁决与质量控制 视角投影可能掩盖小角度差异
6.3 竖直方向:支撑面与 PCA
支撑面候选
对可能稳定放置的物体,作者枚举满足静态平衡的支撑面:刚体质心投影需落在支撑多边形内。把支撑面旋到水平后渲染多个候选,再由 VLM 选择最符合人类“朝上”预期的方向,记为 R S u p R_{Sup} R S u p
这里 VLM 只在候选间判别,不直接回归旋转;因此即使 VLM 方向理解不够精确,也不会在连续空间产生任意姿态。
PCA 候选
对目标对象与模板的中心化点云分别求前两个主轴 v 1 , v 2 v_1,v_2 v 1 , v 2
R i = [ v 1 t v 2 t v 1 t × v 2 t ] [ σ i 1 v 1 o σ i 2 v 2 o σ i 1 v 1 o × σ i 2 v 2 o ] ⊤ , R_i=
\begin{bmatrix}v_1^t&v_2^t&v_1^t\times v_2^t\end{bmatrix}
\begin{bmatrix}\sigma_{i1}v_1^o&\sigma_{i2}v_2^o&
\sigma_{i1}v_1^o\times\sigma_{i2}v_2^o\end{bmatrix}^{\top}, R i = [ v 1 t v 2 t v 1 t × v 2 t ] [ σ i 1 v 1 o σ i 2 v 2 o σ i 1 v 1 o × σ i 2 v 2 o ] ⊤ , 其中 σ i 1 , σ i 2 ∈ { − 1 , + 1 } \sigma_{i1},\sigma_{i2}\in\{-1,+1\} σ i 1 , σ i 2 ∈ { − 1 , + 1 }
R P c a = arg min R i 1 m ∑ k = 1 m C D ( S k t , R i S k o ) . R_{Pca}=\arg\min_{R_i}\frac{1}{m}\sum_{k=1}^{m}
CD\left(S_k^t,R_iS_k^o\right). R P c a = arg R i min m 1 k = 1 ∑ m C D ( S k t , R i S k o ) . 这个设计很关键:PCA 负责提出稳定轴,语义部件负责决定轴的正负和人类语义方向。
6.4 水平方向:几何与语义
几何准则
围绕竖直轴 z z z
θ ∗ = arg min θ ∈ [ 0 , 2 π ) C D ( P t , R z ( θ ) P o ) . \theta^*=\arg\min_{\theta\in[0,2\pi)}CD\left(P^t,R_z(\theta)P^o\right). θ ∗ = arg θ ∈ [ 0 , 2 π ) min C D ( P t , R z ( θ ) P o ) . 由此得到 R G = R z ( θ ∗ ) R_G=R_z(\theta^*) R G = R z ( θ ∗ ) R i n v G = R z ( θ ∗ + π ) R_{invG}=R_z(\theta^*+\pi) R in v G = R z ( θ ∗ + π )
语义准则
作者同时计算完整几何误差 E g ( θ ) E_g(\theta) E g ( θ ) E s ( θ ) E_s(\theta) E s ( θ )
6.5 五候选集合
最终不是把所有规则取平均,而是保留多种假设:
R S R_S R S R G R_G R G R i n v G R_{invG} R in v G R S R S u p R_SR_{Sup} R S R S u p R S R P c a R_SR_{Pca} R S R P c a
原论文 Figure 5:75 万标注资产中 51% 因低质量剔除、6% 因姿态候选错误剔除、43% 留存;五类候选最终入选比例为 24%、22%、12%、22%、20%,说明候选规则不是冗余复制。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
右侧分布是一个很有价值的诊断:没有某一种准则支配全部类别,支持“多规则候选集”这一设计。但它不能告诉我们未被五候选覆盖的 6% 是否集中在特定类别,也没有给出类别级 failure distribution。
6.6 人工标注与质量控制
标注员先做短时校准,再按类别监控一致性。
低置信类别会被轻量复核。
错分类、严重 mesh loss、薄壳大洞和无意义几何直接淘汰。
最终 75 万中约 32 万保留,平均每实例选择时间低于 5 秒。
Figure 3 标出 20 名标注员、约 900 人时;这说明系统降低了单位成本,但并没有把人工成本变成零。
6.7 数据发布形式
公开仓库当前提供两种使用方式:
下载已经统一处理的 GLB;
根据 Objaverse UID 自行下载原始网格,再应用仓库 JSON 中的 rotation_matrix 与类别标签。
第二种方式更利于审计和重建,但使用者仍需自行处理 Objaverse 资产版本、下载可用性和许可边界。
7. 实验分析
7.1 数据集与实验角色
数据集 在本文中的作用 关键规模 / 特征 注意事项 Objaverse / Objaverse-XL CanoVerse 原始资产池 Web 3D 资产、类别长尾、质量差异大 不是直接可用的干净 pose 数据 CanoVerse ID 训练 / 测试、生成和检索训练 320K、1,156 类 从 750K 中筛选而来;依赖人工规范 OmniObject3D 真实扫描 OOD 朝向与检索 与 Web 合成资产存在 domain gap 仍提供完整对象扫描,不是遮挡场景 crop Toys4K / GSO 3D 生成评估 公共 3D 对象集合 评价先归一化并做六视图渲染 DREDS 标注速度、角度精度、IC / GEC 七类、随机旋转对象 类别数量远小于最终 1,156 类
7.2 指标
朝向恢复
Acc@10°:角误差不超过 10° 的比例,严格反映是否可用于精细 pose。Acc@30°:较宽松方向准确率,更多反映粗朝向是否正确。Abs:绝对角误差,越低越好;论文表格中的数量级很高,说明长尾失败显著。
对对称对象,单一角误差是否按类别对称群取最小值非常关键。正文说明构建阶段有对称轴 / 角标注,但当前公开正文没有把所有评估实现细节展开到足以独立复核的程度,复现时必须核查代码与补充材料。
生成
CD:归一化后 10 万采样点的 Chamfer Distance。
LPIPS / CLIP:六个正交视图与 GT 对应视图的平均感知 / 语义相似度。
IQR:100 个对象相对 canonical pose 的角误差四分位距,用于描述生成姿态稳定性。
IQR 低说明输出朝向更集中,但它不是平均角误差;如果所有对象稳定地偏向一个错误方向,IQR 也可能较小,所以必须与 CD、视图相似度和定性结果联合看。
检索
Recall@10 / Recall@30:正确实例是否出现在前 10 / 30 个检索结果,按精确实例匹配而不是同类匹配。
标注质量
速度:秒 / 物体。
Precision:相对 DREDS 人工 GT 的平均角误差。
IC / GEC:遵循 COD 的 instance consistency 与 ground-truth equivariance consistency,越低越好。
7.3 对比方法与公平性
对比 输入 / 改动 能回答的问题 公平性风险 PCA 完整点云 纯几何主轴是否足够 非学习 baseline,能力下界明显 CleanPose / AG-Pose / SecondPose / VI-Net 去掉与当前任务无关的分支,只训练旋转 哪类网络能从 CanoVerse 学方向 改过原模型输入 / 目标,不等同原论文性能 VI-Net(NOCS / Objaverse-OA / CanoVerse) 同类网络、不同训练数据 数据本身对迁移的影响 需要确认训练样本量和超参完全一致 GenPose++ 输入完整对象点云 通用 pose 模型能否适配 orientation 与其原始 RGB/点云设定并非完全等价 Orient Anything 六正交渲染、取最高置信 图像方向模型在 3D 物体上的表现 使用渲染与 best-of-six,和单点云方法管线不同 canonical vs non-canonical 生成 / 检索 同资产、同训练,只改数据朝向 canonicalization 的单变量作用 这是本文最干净的因果证据之一
7.4 朝向估计主结果
ID:CanoVerse 100K / 10K split
方法 Acc@10° ↑Acc@30° ↑Abs ↓ PCA 22.98 34.83 91.49 CleanPose (CanoVerse) 35.02 57.36 60.72 AG-Pose (CanoVerse) 23.80 48.88 70.39 SecondPose (CanoVerse) 49.15 58.39 60.11 VI-Net (Objaverse-OA) 21.77 25.86 97.69 VI-Net (CanoVerse) 55.31 64.14 51.47
作者声称:几何信息不足,规模化 canonical 数据使方向语义可学习。结果基本支持这一主张:所有 CanoVerse 学习方法在多数指标上明显优于 PCA,VI-Net 的同架构数据对比也显著优于 Objaverse-OA。
我的分析:Acc@10°=55.31 在 ID 上仍只有约一半,说明 1,156 类混合的精细统一方向很难。Acc@30°=64.14 与 10° 结果差距不算极大,但 Abs 仍为 51.47°,暗示失败样本可能出现大角度翻转而非小范围抖动。
OOD:OmniObject3D 真实扫描
方法 Acc@10° ↑Acc@30° ↑Abs ↓ GenPose++ 4.33 6.95 105.17 Orient Anything 4.77 7.32 103.11 VI-Net (NOCS) 3.92 6.64 108.51 VI-Net (Objaverse-OA) 6.56 9.60 105.90 VI-Net (CanoVerse) 20.18 24.83 94.60
同一 VI-Net 从 Objaverse-OA 换成 CanoVerse 后,10° 准确率从 6.56 增到 20.18,数据效果明确。但绝对水平仍低,约五分之四样本无法进入 10°;因此“unlock zero-shot orientation estimation”更合理的中文理解是“让该任务出现可测的跨域能力”,不是“真实扫描朝向已达到可部署精度”。
原论文 Figure 7:从任意方向输入完整对象,对比 Orient Anything 与 CanoVerse 训练的 VI-Net;中间组是 OmniObject3D 真实扫描 OOD,对判断 synthetic-to-real 朝向先验最有参考价值。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
7.5 Scaling 与同规模质量控制
作者用 VI-Net 分别训练 32K、100K、200K、310K,保持评估协议不变。Figure 8 显示:
Acc@10° 随数据量增加,从约 50% 提升到接近 60%;Acc@30° 从约 60% 提升到约 68%;Abs 从约 58° 下降到约 46°;
同为 32K 时 CanoVerse 比 COD 的 10° / 30° 准确率更高且 Abs 更低。
原论文 Figure 8:左图控制样本量比较 COD 和 CanoVerse,右图固定 VI-Net 展示 32K→310K 的规模效应。该图同时提供“标签质量”与“数据数量”的证据,但尚未覆盖多架构、多随机种子和 OOD scaling。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
我的分析:这不是严格意义的 scaling law 拟合,没有给出幂律、置信区间或跨算力预算控制;更准确的表述是“在该模型与数据范围内观察到单调数据规模收益”。
7.6 3D 生成
设定
Hunyuan3D 2.1 与 Trellis 各自在 100K 个 CanoVerse 资产上微调。
canonical 与 non-canonical 分支使用完全相同资产、训练步数与配置,唯一变量是是否采用规范朝向。
Toys4K 与 GSO 作为公开测试集。
mesh 归一化到 [ − 1 , 1 ] [-1,1] [ − 1 , 1 ]
关键结果
模型 数据 Toys4K CD ↓ Toys4K LPIPS ↓ Toys4K CLIP ↑ Toys4K IQR ↓ GSO CD ↓ GSO IQR ↓ Trellis non-canonical 0.227 0.436 89.7 48.5° 0.272 74.0° Trellis canonical 0.095 0.254 93.9 7.7° 0.072 8.1° Hunyuan3D 2.1 non-canonical 0.258 0.413 90.8 75.59° 0.244 74.02° Hunyuan3D 2.1 canonical 0.085 0.260 93.7 8.1° 0.090 18.6°
这组实验很有说服力,因为比较不是“更大的 CanoVerse 对更小的外部数据”,而是同资产单变量控制。canonicalization 不只改善姿态 IQR,也改善 CD / LPIPS / CLIP,支持“随机方向会干扰结构与语义学习”的主张。
不过,GT canonical pose 与生成姿态评估也来自本文标注管线,因此 orientation metric 并非完全独立的第三方标签;Toys4K / GSO 上的对象类别覆盖与训练重叠也需要进一步检查。
7.7 跨模态 3D 检索
设定
310K 训练、10K 测试;每条数据包含点云、渲染图和 Qwen2.5-VL 生成文本。
non-canonical baseline 使用同一 Objaverse 资产,仅保留尺度归一,不做方向对齐。
分别微调 ULIP 与 Uni3D;测试 CanoVerse ID 与 OmniObject3D OOD。
以 exact instance matching 的 Recall@10 / 30 评价。
结果摘要
模型 / 模态 数据 CanoVerse R@10 / R@30 OmniObject3D R@10 / R@30 ULIP / Text non-canonical 21.33 / 35.17 8.19 / 15.98 ULIP / Text canonical 25.05 / 39.43 9.95 / 19.89 Uni3D / Text non-canonical 51.29 / 62.18 34.21 / 48.38 Uni3D / Text canonical 53.88 / 64.31 35.88 / 49.02 Uni3D / Image non-canonical 79.07 / 92.29 61.34 / 77.42 Uni3D / Image canonical 81.82 / 92.98 64.86 / 81.50
增益普遍存在但幅度比生成实验小,说明强大的跨模态编码器已经对一部分旋转差异具有鲁棒性;canonicalization 更像稳定的附加收益,而不是检索性能的唯一决定因素。
7.8 标注效率与精度
方法 Low:秒 / 角误差 Medium:秒 / 角误差 High:秒 / 角误差 Blender 手工 125.3 / 8.2° 101.4 / 4.5° 94.5 / 3.7° COD 4.6 / 9.4° 3.4 / 8.5° 3.0 / 8.1° CanoVerse 4.0 / 6.7° 2.7 / 6.3° 2.6 / 5.9°
作者声称高技能组相对 Blender 约 36× 加速,同时误差仍在 10° 的可接受波动内。数据支持速度主张,也显示质量—效率折中:本文精度不及熟练 Blender,但显著优于 COD 候选选择。
在 DREDS 七类的自动 canonicalization 指标上,CanoVerse 平均 IC / GEC 为 0.032 / 0.123,优于 COD 的 0.194 / 0.208。不过类别级并非全面胜出:Aeroplane、Bowl、Mug 等个别列 COD 更低。作者承认 2D 渲染难以辨别细微角度。
7.9 鲁棒性与失败案例
遮挡 / clutter :未直接评估。输入是完整对象资产或完整扫描,不能证明对部分观测鲁棒。无纹理 / 弱纹理 :点云朝向主要依赖几何,颜色与语义部件可辅助;但完整几何与真实深度残缺差距仍大。对称物体 :构建阶段显式标注对称轴和角,并加入 180° 候选;但不同类别的连续 / 离散对称评估实现需要代码核验。反光 / 透明物体 :论文不是直接从传感器深度构建这些对象,未验证真实透明 / 反光深度噪声。domain gap :OmniObject3D OOD 有提升,但严格准确率仍低,说明真实扫描噪声与类别分布差异没有被完全消除。错误类别 :作者会在人工阶段剔除;若未来希望全自动部署,类别错分会把对象映射到错误模板和轴约定。坏网格 :51% 候选因低质量被淘汰,数据管线的高质量很大程度来自强清洗,而不仅是旋转算法。细微角度 :2D 选择会丢失深度线索,某些类别上不及 COD 或 Blender。
7.10 贡献是否被实验支撑
作者声称 对应证据 是否充分 我的判断 标注从分钟降到秒 DREDS 十名新手、多轮熟练度、速度表 较充分 单位选择成本证据强;仍应把前处理、模板和复核成本计入总成本 数据规模达到 320K / 1,156 类 公开统计与仓库 充分 规模可核验,但可用资产许可与长期下载完整性属于额外问题 数据质量优于现有方案 32K 对 COD、DREDS IC/GEC、人工角误差 基本充分 平均值领先,但不是每一类都领先 可学习零样本 OOD 朝向 OmniObject3D 数量与定性结果 部分充分 相对提升大,绝对 Acc@10° 仍只有 20.18 改善 3D 生成 两个 backbone、同资产单变量对照、两测试集 较充分 这是全文最强的一组因果证据 改善跨模态检索 两个模型、文本 / 图像、ID / OOD 较充分 一致增益,但幅度中等,未拆分文本生成噪声
8. 批判性分析
8.1 优点
问题选得准 :它处理的是长期被默认、却会系统性污染 pose / generation / retrieval 的坐标系一致性。人机分工合理 :机器做连续空间搜索,人做离散语义判断;没有为了“全自动”牺牲标签可信度。质量控制透明 :明确报告 51% 低质量和 6% pose error 淘汰,不把原始下载量包装成有效规模。实验维度完整 :ID、OOD、同规模、scaling、生成、检索、速度、精度和自动指标形成证据链。单变量实验好 :生成与检索使用相同资产、只改变 canonicalization,比常见跨数据集对比更能说明原因。公开形式实用 :旋转矩阵 + Objaverse UID 便于把 canonical frame 接入已有资产管线。
8.2 缺点
规范方向不是客观真值 :模板选择、轴约定和正面定义包含文化、任务与标注团队偏好。完整对象假设很强 :真实机器人看到的是遮挡、缺深度、混杂背景的局部观测,本文 orientation network 的输入已经跳过最困难的前端。人工成本只是降低而非消失 :20 人、约 900 人时仍是显著投入;新增类别还需模板、文本、对称约定和校准。OOD 绝对精度有限 :20.18% 的 10° 准确率更适合证明“数据有用”,不足以证明可直接部署。某些对比改变原设定 :把一般 6D pose 方法改成完整点云 rotation-only 后,结果更多是任务适配实验,不宜作为原方法强弱排名。复现细节分散 :正文把许多超参数交给补充材料;当前源码包没有让全部训练细节一眼可复核。长尾与类别级结果不足 :1,156 类的平均值可能掩盖小类、近对称类和语义正面模糊类的失败。
8.3 隐含假设
每个对象可被可靠分到单一类别。
每类可以选出一个具有代表性的模板。
同类对象共享相同 canonical convention;跨类别轴也能合理统一。
五个候选的召回率足够高,且未覆盖样本可以被标注员识别并丢弃。
统一渲染视角能让标注员判断 3D 方向。
对象是刚体;可动关节、形变与多部件状态不会改变“正面 / 朝上”定义。
完整点云中的方向先验能够迁移到真实场景的部分点云,这一点尚未被本文直接验证。
8.4 真实应用可行性
现在就能用的部分
清洗和统一已有 CAD / Objaverse 资产坐标系。
为 category-level pose、NOCS 或生成式数据增强提供 canonical 训练资产。
作为完整扫描 / 重建对象的粗朝向初始化器。
训练 view-consistent 3D generation / retrieval 模型。
离真实场景 6D pose 还缺什么
从 RGB/RGB-D 场景检测和分割对象;
对遮挡和缺深度做 shape completion;
恢复平移与尺度,并与相机内外参衔接;
正确处理离散 / 连续对称的多解评分;
输出不确定性,在 canonical convention 本身含糊时保留多个假设;
对透明、反光、形变和 articulated object 做专门建模。
9. 未来工作与可改进方向
9.1 不确定性感知的 canonical label
当前每个对象最终保存一个旋转矩阵。对前后难分或连续对称对象,更合理的标注可能是:
对称群 G G G
多个等价 canonical rotations;
候选概率分布;
标注员一致性与置信度。
这样可避免训练网络时把合理多解强压成单一错误。
9.2 从完整资产迁移到部分观测
可把 CanoVerse 当作 teacher space:
对每个 canonical 资产生成遮挡、截断、深度噪声和传感器缺失;
用完整点云 teacher 产生方向分布;
训练 partial point cloud / RGB-D student;
在 BOP、HouseCat6D、Omni6DPose 等场景数据上评估 rotation、translation 与 symmetry-aware 指标。
这会把本文的数据价值真正连接到网站主线的场景 6D pose。
9.3 自动候选召回率审计
除了最终保留率,应按类别报告:
GT 是否落在 top-1 / top-3 / top-5;
哪一种规则覆盖了正确方向;
候选失败集中在哪些几何 / 语义属性;
VLM、Find3D、Uni3D 每个模块造成的独立误差。
9.4 主动学习式人工分配
对于高置信候选可自动接受,低 margin、类别不确定或多标注员分歧样本才送人工。用少量重复标注估计校准曲线,可以进一步降低 900 人时并保留质量。
9.5 类别和任务条件化坐标系
“正面”可能依任务变化:机器人抓取关心把手和支撑面,展示生成关心视觉正面,装配关心接口轴。未来可同时维护多个 task-conditioned canonical frames,而不是假设一个全局 frame 适用于所有下游。
9.6 更严格的 scaling 实验
多个 backbone 与随机种子;
区分类别数量 scaling 与每类实例数量 scaling;
固定算力预算,避免大数据同时获得更多优化步;
同时报告 ID、OOD、长尾类和对称类;
拟合置信区间,而不只展示单条趋势曲线。
10. 对我的研究的启发
可直接借鉴
在合成训练数据进入 pose network 前,先做 canonical-frame audit,而不是默认 CAD 坐标正确。
对开放集对象用多假设 rotation prior,而不是一次回归单姿态。
几何提出候选、语义消歧、人工 / VLM 裁决的结构可迁移到无纹理工业件与类别级姿态初始化。
把标签生产效率和误差一起报告;只报“自动生成了多少数据”不足以证明数据价值。
可复用的数据 / 工具
GitHub 中的对象 UID、类别与旋转矩阵。
已处理 GLB 资产入口。
规范化 / 旋转应用脚本可作为现有 Objaverse 管线的前处理。
作为 baseline 的位置
必须比较 :若研究问题是 3D canonicalization、完整点云 orientation、canonical 3D generation 或跨模态 3D retrieval。作为数据源 / 前处理 :若研究 category-level 6D pose、NOCS、开放类别合成数据。不宜直接比较 :若任务是单张场景 RGB 的实例级 BOP pose 或遮挡 RGB-D 的完整 R , t R,t R , t
可形成新工作的切入点
CanoVerse 预训练 + partial point cloud / RGB-D distillation。
symmetry-aware probabilistic canonicalization。
VLM 语义朝向与几何 equivariance 的可校准融合。
面向工业装配的 task-conditioned canonical frame。
从生成资产到真实场景 6D pose 的坐标系一致性研究。
11. 复现清单与待解决问题
11.1 最小复现路径
从公开仓库读取对象 UID、类别和 rotation_matrix。
按 Objaverse 官方方式下载原网格,记录确切版本与失效资产。
用仓库脚本做中心、尺度归一,并应用旋转矩阵。
随机采样点云,检查轴定义、矩阵左乘 / 右乘和坐标系手性。
复现 100K train / 10K test 的 VI-Net ID 实验。
明确对称类别角误差的计算方式。
在 OmniObject3D 上对齐 canonical conventions 后复现 OOD 表。
对 32K / 100K / 200K / 310K 使用相同训练预算或明确优化步变化。
11.2 容易踩坑的工程点
GLB / OBJ / Blender / trimesh 的坐标轴和矩阵约定可能不同。
先归一化还是先旋转通常对旋转无影响,但非均匀尺度与坐标手性会改变结果。
Objaverse UID 对应的资产可能更新或下载失败,需保存 manifest 与哈希。
部分对象本身包含多个不一致子网格坐标系。
对称对象不能只用普通 geodesic error;必须读取类别对称元数据。
训练 / 测试划分应避免同源近重复资产泄漏。
11.3 尚未明确或需要进一步核实
1,156 类每类模板、轴定义与对称标注是否全部公开到可机器读取形式。
Uni3D 分类置信度阈值、Find3D 提示词与 VLM 候选选择配置的完整参数。
五候选 top-5 recall 的类别级统计,以及 6% pose-error 淘汰的详细分布。
ID split 是否按资产来源和近重复簇去重。
orientation 指标对连续 / 离散对称的精确定义。
生成实验的完整优化步、学习率、随机种子和显著性区间。
公开 GLB 与 JSON 标注的版本冻结和长期维护策略。
12. 最终评价
作者声称 CanoVerse 让大规模方向语义变得可学习,并能提升生成、检索与 OOD 朝向恢复。论文的多组受控实验基本支持“canonical data 有价值”,尤其是生成实验和同架构训练数据对比。
我的分析 是:本文最重要的贡献不是把真实 6D pose 解决了,而是把 3D 数据中的坐标系噪声从一个隐性问题变成了可构建、可筛选、可评估的基础设施。它适合作为 category-level pose 和生成式资产管线的上游数据层;若要进入机器人真实场景,还必须补齐 partial observation、分割、平移、尺度、对称多解与不确定性。OOD Acc@10°=20.18 同时给出一个清醒信号:大数据确实把能力从几乎不可用推向可研究,但离稳定部署仍有明显距离。