论文精读笔记:CAP-Net: A Unified Network for 6D Pose and Size Estimation of Categorical Articulated Parts from a Single RGB-D Image
1. 核心判断
- 论文:CVF Open Access
- 关键问题:类别级 articulated object 中,多个小部件的 semantic segmentation、instance grouping、pose 和 size 会彼此耦合,串行 pipeline 会放大误差。
- 核心回答:以统一 RGB-D network 的 point-wise 多头预测作为共同前端,后接 cluster 与 NPCS fitting 得到各 part pose / size。
2. 一句话定位
CAP-Net 以“先共享表征,再按 part instance 拟合”的单阶段思路,把类别级可动部件 pose 接到可真实部署的 RGB-D 传感输入上。
2.1 论文图表导读
| 图表 | 应该看什么 |
|---|
| Figure 2 | complete-object 与 part-based pose 的区别,为什么 part 的 canonicalization 更难。 |
| Figure 4 | RGB、depth、SAM2 / FeatUp feature 如何进入统一网络及三种输出。 |
| Table 2–3 | part segmentation 与 part pose 要分别比较 seen / unseen categories。 |
| Figure 5 | RGBD-Art 与 RealSense 定性结果,检查小件和遮挡下的失效。 |
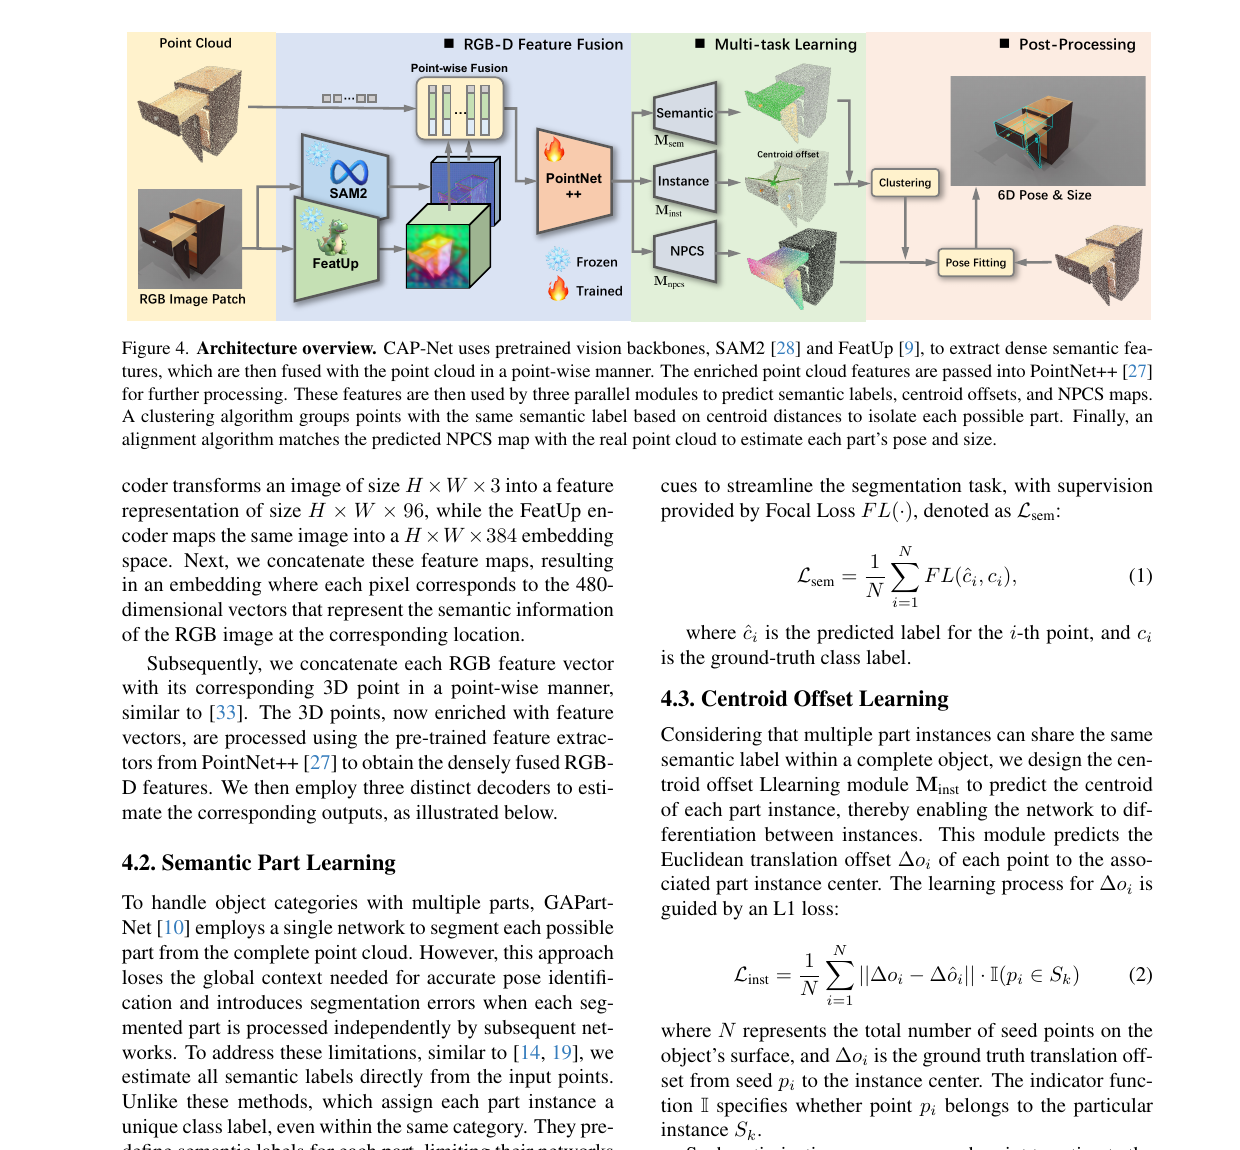 原论文方法图区域:CAP-Net 以 RGB-D 语义和几何特征预测 part class、centroid offset 与 NPCS,并通过拟合恢复 pose / size。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- 输入为单张 RGB-D 和 object-level mask;输出一个 object 内多个 articulated parts 的类别、实例、6D pose 和 size。
- 这是 predefined part category 内的 category-level 泛化,不是未知拓扑或任意关节模型的解析。
- NPCS fitting 依赖深度、点云质量和每个 part 有足够可见表面。
4. 方法详解
- 统一特征:RGB 分支提供 dense semantic cues,depth / point branch 提供几何;作者使用预训练视觉 feature 强化小部件辨识。
- 三头输出:每个点输出 class label、到 part centroid 的 offset、以及 Normalized Part Coordinate Space (NPCS)。
- instance-to-pose:同类点依 centroid distance 聚类,再将该 part 的 NPCS 对齐到实际 point cloud,恢复 similarity transform 中的 rotation、translation、size。
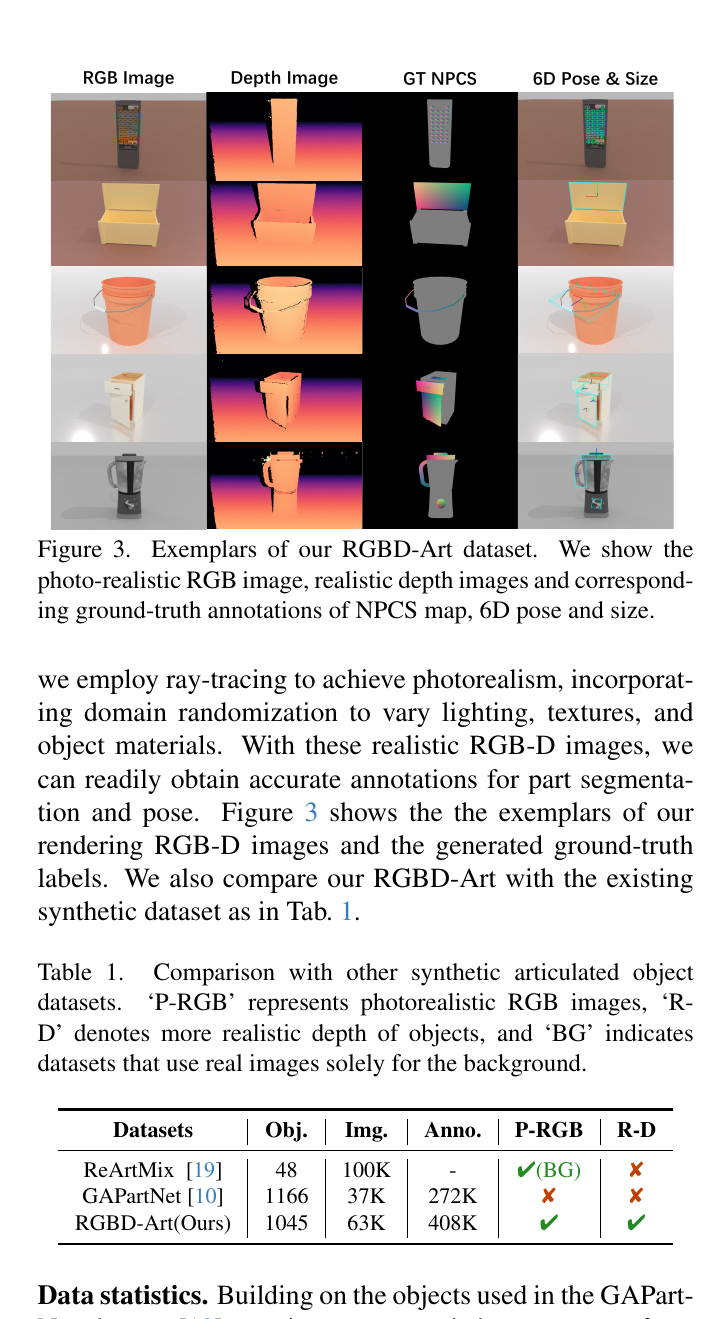
- 数据设计:RGBD-Art 合成了 photorealistic RGB 与真实传感器风格 depth noise,服务 sim-to-real。
5. 实验分析
- 论文对 segmentation、pose、size 分别报告,并区分 seen / unseen object categories;这是正确评估“类别级”与“部件级”的必要维度。
- RGBD-Art 的作用不仅是更多数据,而是测试 sensor-depth 噪声条件下的训练迁移;真实 RealSense 操作实验是补充证据而非替代定量 benchmark。
- 读表时应特别关注小部件:总体平均分数可能被大、可见 part 主导。
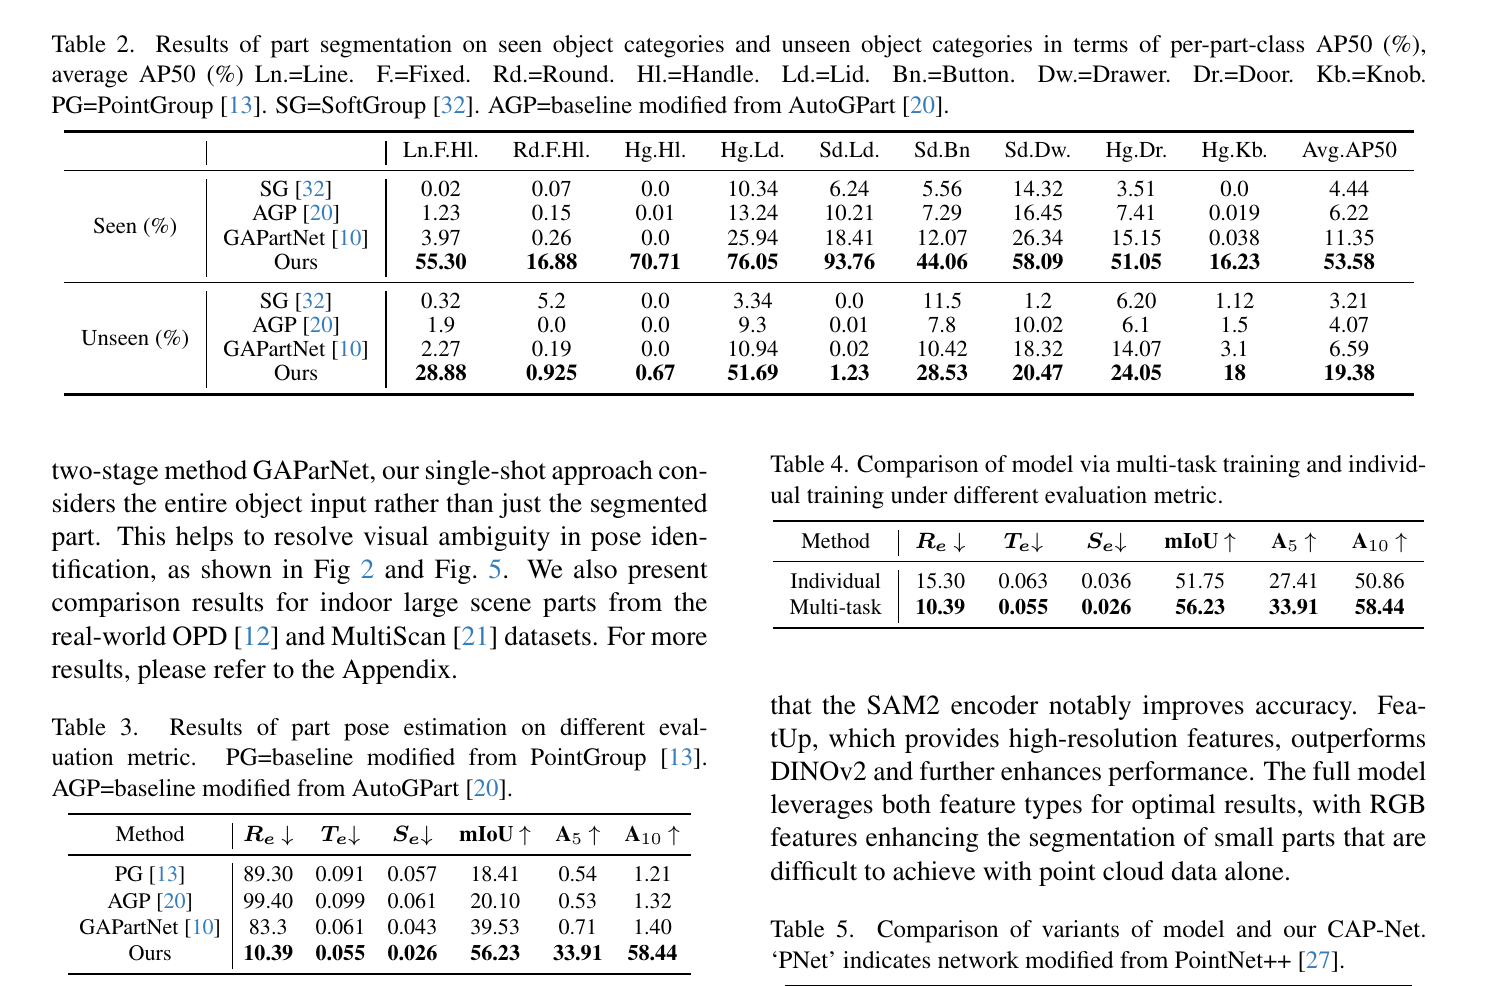 CAP-Net 原论文主结果与消融:表格从 part segmentation、pose / size、多任务训练和特征模块四个层面解释最终精度。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
在 RGBD-Art 上,CAP-Net 的 part segmentation AP50 为:seen 类别 53.58、unseen 类别 19.38,后者明显下降,说明“类别级泛化”仍是主要瓶颈。完整 pose / size 系统报告平均旋转误差 10.39°、相对平移误差 0.055、相对尺度误差 0.026、3D IoU 56.23;5° / 10° 阈值准确率为 33.91 / 58.44。多任务联合训练相较各任务独立训练,将旋转误差从 15.30° 降到 10.39°,同时 3D IoU 从 51.75 提至 56.23,支持共享语义—几何表征的设计。
消融还显示不能把收益简单归因于“大 backbone”:基础 PNet 的旋转误差为 21.30°、10° 准确率为 38.67;加入 SAM 特征后分别为 12.20° / 47.90,完整组合达到 10.39° / 58.44。FeatUp 或 DINOv2 单独加入并未稳定优于 SAM 版本,说明预训练特征是否有效取决于它怎样与点云几何及多任务头融合。
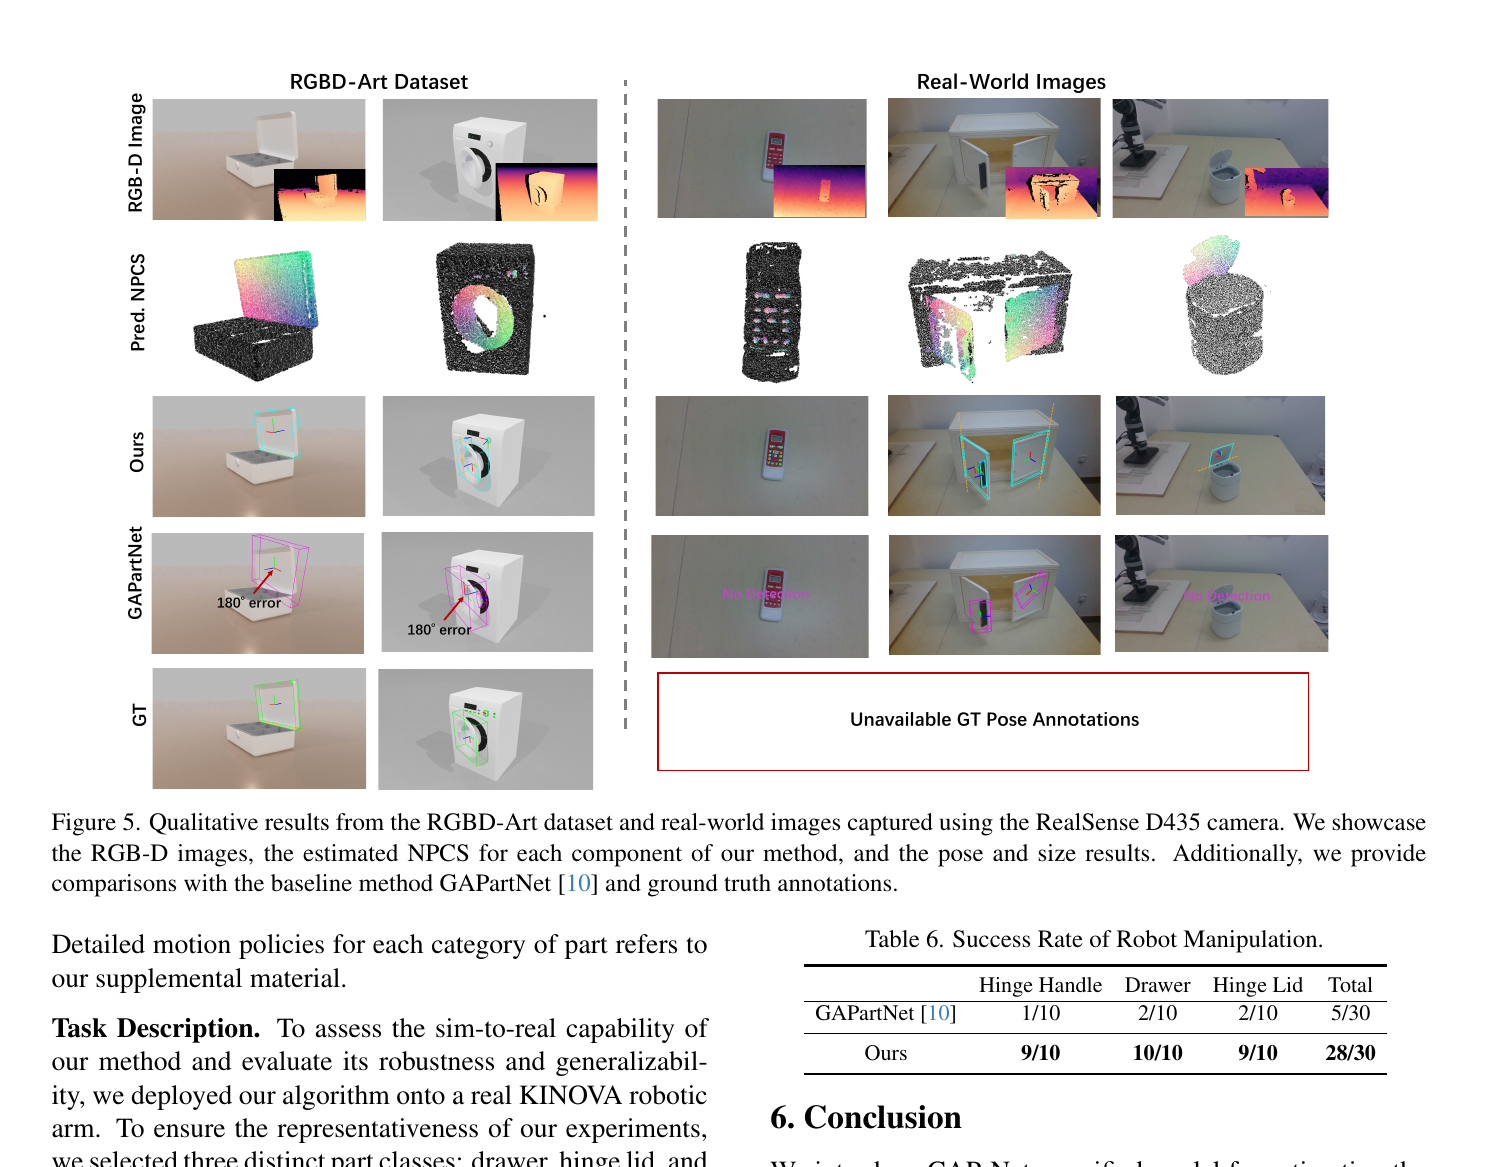 CAP-Net 原论文定性与机器人实验:除了观察部件坐标轴是否贴合,还应核对操作成功率;CAP-Net 在三类部件上的总成功数为 28/30,对比 GAPartNet 的 5/30。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
真实机器人实验把感知指标落到了可执行任务:GAPartNet 在 hinge handle、drawer、hinge lid 上分别成功 1/10、2/10、2/10,总计 5/30;CAP-Net 分别为 9/10、10/10、9/10,总计 28/30。这个结果有较强应用意义,但样本量仍小,也没有将失败拆解为 mask、part classification、pose、grasp planning 或控制误差,所以它证明的是完整 demo pipeline 在该测试集上更稳,而不是每个视觉模块都已解决。
6. 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| 单阶段统一网络优于多阶段 part pipeline | 任务接口更简洁;仍应报告 mask / cluster 错误如何分别影响 pose。 |
| RGB 语义改善小部件 | 合理,但与 backbone、分辨率及 RGBD-Art 渲染质量有耦合,需要交叉消融。 |
7. 复现要点与限制
- 对齐 NPCS 时必须确认 part canonical frame、scale convention、depth unit 与 camera intrinsics。
- cluster 半径和最小点数会显著影响小 part 的 instance recall。
- 物体级 mask 被假定可得;若应用中前端漏掉可动部件,统一后端无法补回缺失观测。
- 最好同时复现实例级 AP、部件 pose / size 与机器人成功率,并保存每次失败的阶段标签;否则很难判断改进网络后是否真的改善了操作,还是只改善了离线平均指标。