Reading Notes
粗读 / 精读
已生成 src/paper-notes/cleanpose-iccv2025/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:CleanPose: Category-Level Object Pose Estimation via Causal Learning and Knowledge Distillation
1. 基本信息
- 年份 / 会议:2025 / ICCV;阅读模式:粗读。
- 任务:RGB-D 类别级 9DoF object pose 与 metric size estimation。
- 原文:ICCV Open Access;代码:GitHub。
2. 一句话定位
CleanPose 将类别级 pose 的跨实例失效解释为数据偏置:用 front-door causal adjustment 抑制混杂因素,再把 ULIP-2 的 3D 语义以 residual distillation 注入 RGB-D pose 网络。
2.1 论文图表导读
| 图表 | 看点 |
|---|---|
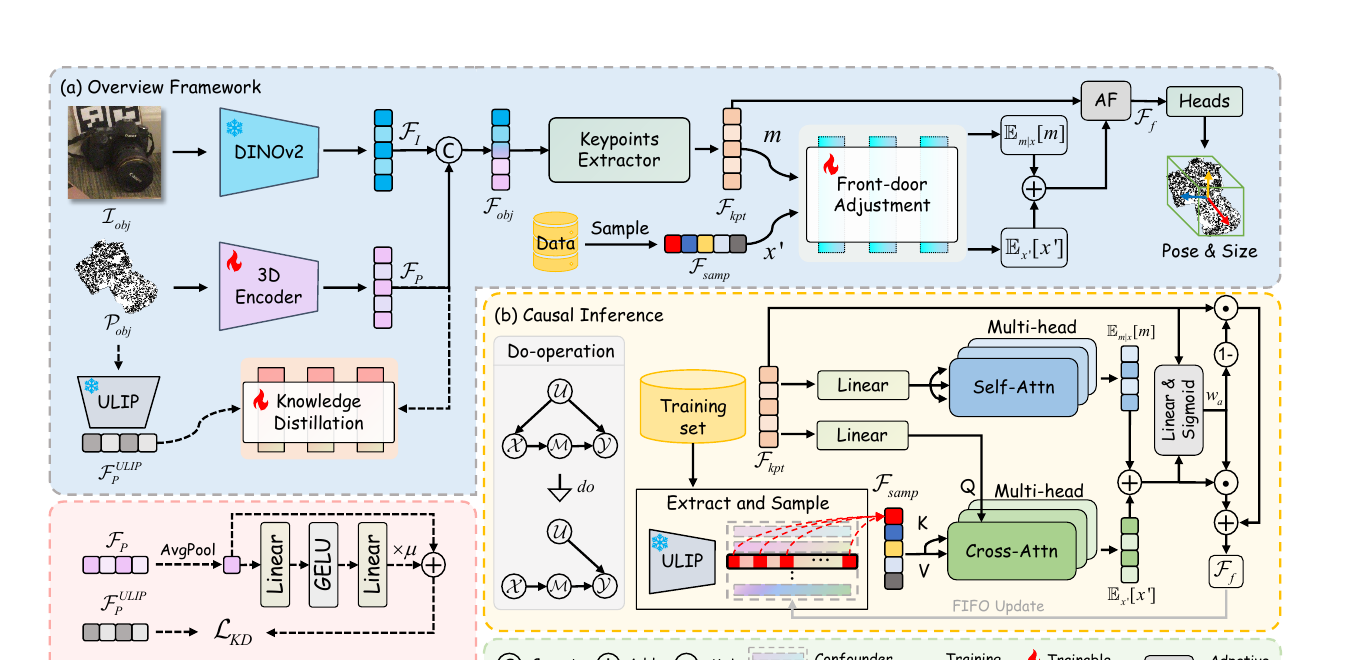
| Figure 3 | 输入 RGB / point cloud、keypoint mediator、因果推理和知识蒸馏如何连接到 pose & size 输出。 |
3. 方法概览
- RGB 由 DINOv2 提取特征,depth 回投为 point cloud;keypoint extractor 充当 visual input 与 pose 的结构 mediator。
- causal module 以训练集采样特征实现 front-door adjustment,试图切断背景、重复样本和姿态分布等隐藏混杂导致的 shortcut。
- ULIP-2 teacher 提供 3D feature,residual knowledge distillation 只蒸馏 student 缺失的部分;最终 head 预测 rotation、translation 与 size。
4. 实验概览
- 数据集:REAL275、CAMERA25、HouseCat6D;指标包括 3D IoU 和不同旋转/平移阈值成功率。
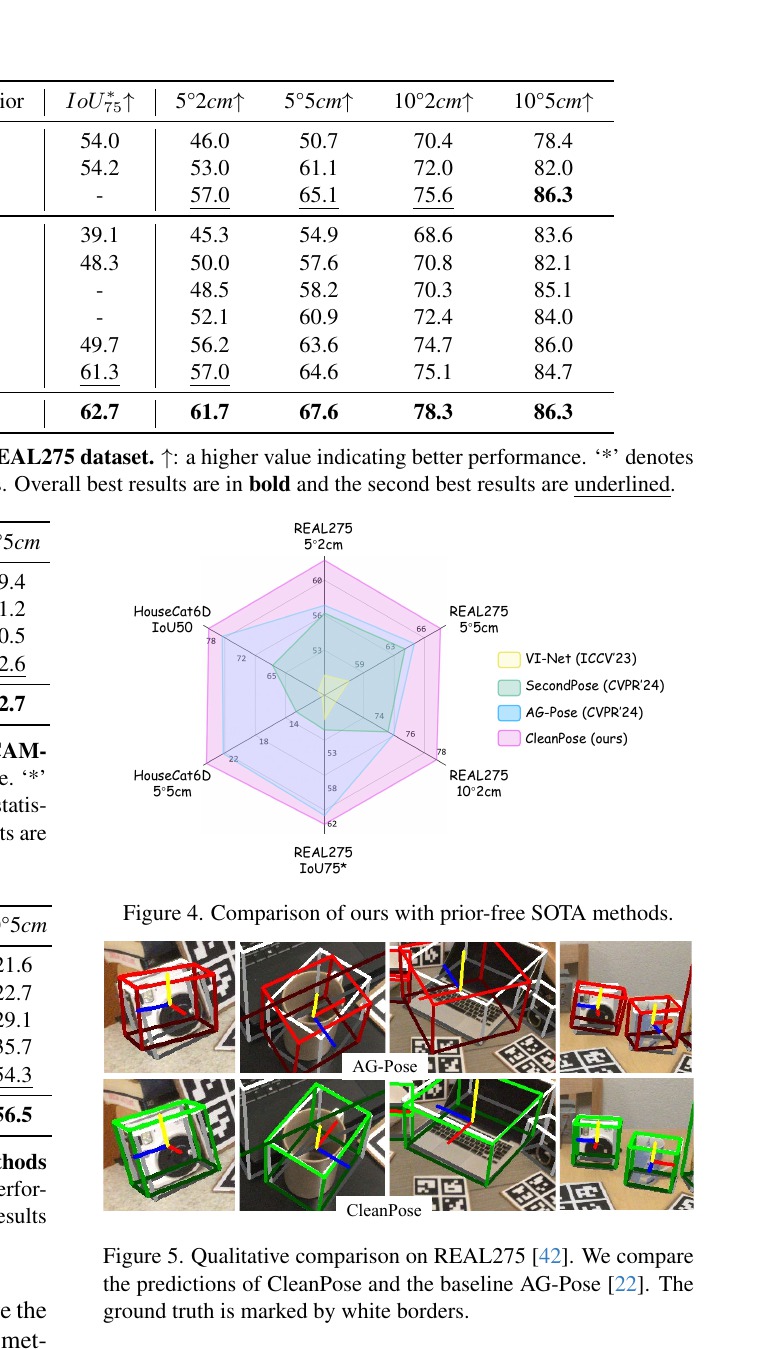
- 作者声称:三套 benchmark 上优于现有类别级 SOTA。
- 我的分析:它提出了“不仅加 feature,也要消 bias”的合理问题;但 causal 图中的混杂变量不可直接观测,front-door 假设在真实噪声和分割失败条件下是否成立,需要更多 cross-domain 验证。
5. 优缺点与启发
- 优点:将 causal adjustment 与 foundation-model distillation 分别作用于偏置来源和语义不足,分工明确。
- 风险:依赖 RGB-D、实例 mask/类别、ULIP-2 teacher 与训练集 memory queue;工程链路较长。
- 启发:对类别级 pose,可把 keypoints 看作结构中介变量,而不是只把它们当作最终 PnP 对应点。