论文精读笔记:COG: Confidence-aware Optimal Geometric Correspondence for Unsupervised Single-reference Novel Object Pose Estimation
1. 基本信息与核心判断
- 论文:CVF Open Access
- 代码:GitHub
- 核心判断:COG 的真正贡献不是单独换了一个 matching loss,而是把“哪些点值得匹配”显式放进 OT 的 marginal 中,使重叠判断、对应关系和 pose 求解共享一个概率结构。
2. 一句话定位
对同一未知物体的单参考 RGB-D 观测,COG 先学习点级 confidence,再以 confidence 作为 OT 质量分布生成软对应,并通过加权刚体求解恢复相对 pose。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | confidence 是否只标记前景,还是还能识别跨视角真正重叠的区域? |
| Table 1 | COG 的优势来自整体对应质量,还是只来自某个 benchmark? |
| Table 2 | 预测 overlap IoU 是否与最终 pose 指标同向变化? |
| Table 3 | 几何、语义、cycle 三类监督是否互补? |
| Table 4 | OT 迭代次数、熵和语义 kernel 的精度—速度折中是什么? |
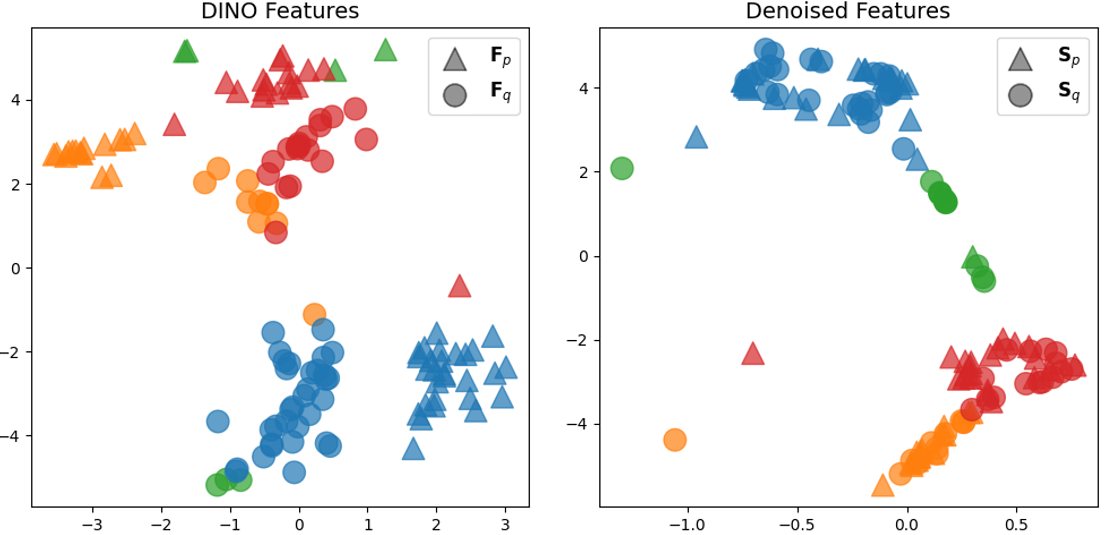 原论文图表中的相关区域:图示将 query/reference 点云、置信度、soft correspondence 与最终 pose 串成一条流程。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 设 query 点集为 Pq,reference 点集为 Pr,目标是估计从 reference 到 query 的刚体变换。
- RGB 提供视觉语义,depth 提供点的三维位置;mask 用于去除背景,内参用于把深度点转入相机坐标。
- 论文关注未知物体的 relative pose,而非固定 CAD 物体的绝对 pose regression。
- 关键困难是视角变化会造成遮挡和非重叠区域;强制一一匹配会把错误点吸收到 pose 中。
- 边界:方法不是完全不需要前端感知,mask、深度质量和点云采样仍会影响 transport 的输入质量。
4. 研究脉络
- 传统 correspondence + SVD / PnP 路线的瓶颈在于局部描述子不稳定、遮挡区域不可见以及错误匹配会污染全局求解。
- 近期无监督方法尝试用视觉基础模型、soft matching 或 OT,但如果 transport 的质量分布没有表达可见性,仍可能把质量分配到错误区域。
- COG 的位置是:保留几何求解器的可解释性,用 confidence-aware OT 取代硬的一一匹配,并引入语义先验来缓解低纹理问题。
5. 研究动机
- 对应关系本身不应被视为均匀可靠;非重叠区域在两个视图中没有合法匹配。
- 仅用 feature similarity 会偏向外观相似但几何错误的点。
- 直接学习 pose 需要目标与数据集级监督,难以泛化到开放世界。
- 因此作者将点 confidence 作为 transport marginal,将匹配分布和最终几何恢复连接起来。
6. 方法详解
6.1 Confidence-aware optimal transport
- 先从 RGB-D 点和视觉特征计算 affinity kernel。
- confidence 网络输出 query/reference 两侧的点级权重;这些权重不只是后处理分数,而是参与 OT 的供给与需求分布。
- Sinkhorn 迭代得到 soft transport plan。相比硬最近邻,soft plan 能保留不确定性,也允许后续用权重做鲁棒刚体拟合。
- 语义 prior 由视觉基础模型提供,用于提升不同外观、局部纹理和遮挡条件下的 affinity。
6.2 无监督约束
- 几何一致性:匹配后变换的点应符合一个近似刚体变换。
- 语义一致性:具有相同物体语义或局部概念的点更容易形成高质量 correspondence。
- cycle consistency:query 到 reference 再回 query 后,应回到原始可见区域。
- 论文还用伪 confidence 标签训练 confidence 分支,使网络学习“重叠且稳定”的区域,而不只是前景。
6.3 Pose recovery
- 从 transport plan 提取软对应或高置信对应。
- 用 confidence 与 correspondence probability 共同构造加权点对。
- 使用加权 SVD / Umeyama 求解旋转和平移。
- 通过对齐结果和重叠区域进行评估;对称物体使用 BOP 的 symmetry-aware 指标。
7. 实验分析
7.1 数据与指标
- 训练规模约为 200 万张 RGB-D 图像、超过 5 万个物体;数据来自 Google Scanned Objects 与 ShapeNet。
- TUD-L 包含 3 个几何复杂物体、600 张图像;LM-O 是 8 个杂乱桌面物体、200 张图像;YCB-V 包含 21 个日常物体、约 900 张评测图像。
- BOP AR 将 VSD、MSSD、MSPD 三类误差的 recall 汇总,更适合遮挡和对称物体;overlap IoU 则提供对 confidence 的直接诊断。
7.2 主结果与消融
- 论文报告 COG 在 TUD-L、LM-O、YCB-V 上取得最好的总体表现,并且无监督版本超过其他无监督 baseline;监督 COG 进一步逼近或超过多数监督方法。
- TUD-L 的提升说明细粒度几何 correspondence 受益于 confidence 与语义 prior;LM-O、YCB-V 的提升则体现遮挡场景下过滤非重叠点的价值。
- 模块消融显示,仅有 softmax / 单一相似度不足;加入 confidence、semantic prior 和 cycle consistency 后平均性能更稳定。
- OT 参数分析显示,少量 Sinkhorn 迭代已经可以获得较好的运输计划,继续增加迭代会带来有限收益和额外开销。
8. 批判性分析
- 方法优点:confidence 的位置很合理;它既解释了 correspondence 的可见性,也给 pose solver 提供了连续权重。
- 公平性问题:RGB-D、mask 和点云质量是较强前提,与 RGB-only 的方法不能直接横向比较。
- 潜在失败:深度空洞、几何重复、极小重叠和前景 mask 错误可能让 confidence 学到错误的可见性。
- 可扩展性:OT 对点数敏感;大规模点集、多个物体或视频跟踪需要稀疏化、分层匹配或缓存机制。
9. 对物体位姿研究的启发
- 可将 confidence 从 correspondence 的附属分数提升为“可观测性建模”模块。
- 对多视角系统,可以把每个 view 的 visibility / overlap 作为 OT marginal,联合优化多帧 pose。
- 对 RGB-only 方法,可探索从 VLM / VFM 生成语义 confidence,再通过几何自一致性进行校正。
- 对机器人应用,overlap IoU 可以作为 pose uncertainty 的可解释信号,用于决定是否需要主动补拍参考视角。
10. 待解决问题
- 如何在无深度或深度噪声很大的场景保持 confidence calibration?
- 如何把单参考 OT 扩展为多物体、多帧、可动部件的结构化 transport?
- 如何输出协方差或置信区间,而不是只输出一个加权 SVD 的点估计?
11. 精读补充:把 confidence 放到 OT 边缘的含义
11.1 训练数据与评测协议
| 项目 | 论文中明确的信息 | 解读 |
|---|
| 训练资产 | Google Scanned Objects + ShapeNet;约 200 万张 RGB-D 图像、超过 5 万个物体 | 训练重点是跨物体 correspondence,而不是记住某个 benchmark 的 CAD |
| TUD-L | 600 张图像、3 个几何复杂物体 | 更适合看细粒度几何与低纹理问题 |
| LM-O | 200 张图像、8 个杂乱桌面物体 | 更适合看遮挡、非重叠和前景过滤 |
| YCB-V | 约 900 张评测图像、21 个日常物体 | 检查对称性、材质和真实噪声下的稳定性 |
| 指标 | BOP VSD / MSSD / MSPD、Average Recall、overlap IoU | BOP 指标衡量 pose,IoU 单独诊断 confidence 是否找到了可匹配区域 |
这里有一个重要的公平性细节:COG 的输入不是裸 RGB,而是 RGB-D 点、mask 和相机内参。把它与 RGB-only 方法直接排成一张“谁更强”的榜单会掩盖传感器条件差异;更合理的比较是分别在相同 RGB-D 和 mask 协议下观察 correspondence quality 与 AR。
11.2 从 affinity 到 pose 的数据流
- RGB backbone / DINO 特征给出跨视角的语义相似性,深度反投影给出 Pq,Pr。
- 几何距离、语义距离和 cycle distance 共同构造匹配代价;论文的可视化显示去噪特征比原始 DINO 特征更容易形成跨视图簇。
- confidence 分支生成 aq,ar,它们作为 OT 的 marginal,而不是最后才乘上的置信度 mask。
- Sinkhorn 得到 transport plan T;计划的每一行 / 每一列代表一个点的质量如何被分配。
- 以 T 和点 confidence 共同加权的对应点进入 Umeyama / weighted SVD,得到相对 R,t。
因此,COG 解决的是三个容易被分开的判断:点是否可见、点应该匹配谁、匹配后刚体变换是否合理。它们共享一个 transport 变量,正是论文比“feature matching + RANSAC”更有研究价值的地方。
11.3 结果应该怎样读
- 作者报告 COG 在 TUD-L、LM-O 和 YCB-V 的总体 BOP 表现最好;无监督 COG 在无监督方法中领先,监督 COG 也超过多数监督基线。
- LM-O 的意义不是平均分高低本身,而是观察非重叠区域被赋予低 marginal 后,错误的远处物体点是否还会参与 SVD。
- overlap IoU 与 pose AR 不一定完全同向:confidence 找到的区域可能几何上可匹配,但存在重复结构;反过来,IoU 不高时,少数高质量 correspondence 仍可能求出正确 pose。
- 论文还报告 inference time 的对比:COG 的监督 / 无监督版本约 3.3–4.8 秒,较早 baseline UnoPose 约 3.7 秒,SAM-6D 约 4.2 秒;这个结果提示 OT 与 confidence 的收益不是以明显的离线速度劣化换来的,但仍不等于实时系统。
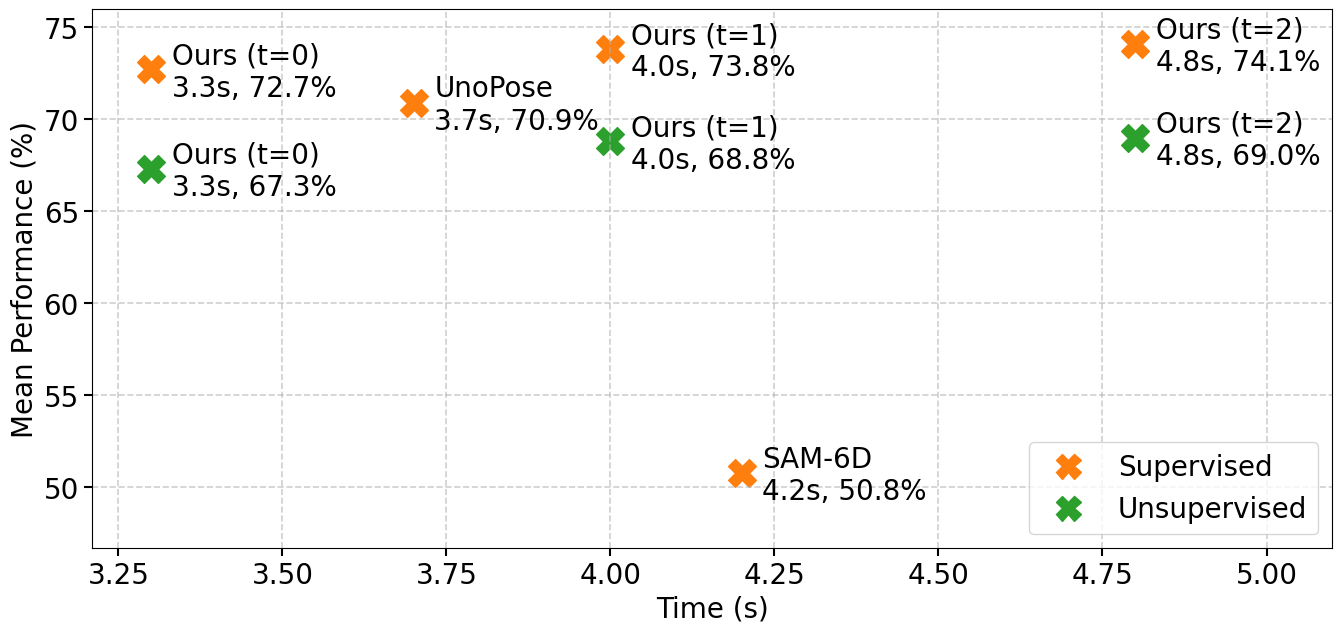 原论文的运行时间—平均性能图:COG 在约 3.3–4.8 秒的测量范围内给出监督与无监督两种模式的结果。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
11.4 作者声称与我的判断
| 层次 | 结论 |
|---|
| 作者声称 | confidence-aware OT 同时改善 overlap prediction、correspondence 和 pose;无监督版本也能超过已有无监督基线。 |
| 我的分析 | 证据最强的地方是模块位置与遮挡任务匹配,尤其是 LM-O;但如果只看最终 AR,仍难排除更好的 DINO / denoising 特征本身带来的收益。 |
| 需要补充的实验 | 应报告 calibration curve、confidence 与真实 overlap 的相关系数、错误 mask / 深度噪声下的 AR,以及点数变化对 OT 时间和显存的影响。 |
12. 可复现清单与失败模式
- 固定 RGB-D 深度单位、相机内参和 object mask;否则几何距离会改变 confidence 的伪标签。
- 记录点采样数、Sinkhorn 迭代数、温度 / 熵正则和 correspondence threshold;这些设置决定 OT 是否过平滑。
- 分别保存 confidence map、transport matrix、weighted SVD residual 和最终 BOP 指标,避免只保存最终 pose。
- 最值得做的 failure taxonomy 是:极小重叠、重复纹理、深度空洞、对称物体、mask 泄漏、query/reference 视角差过大。
- 若要迁移到视频,建议把 at 设计成随时间平滑的 visibility posterior,并让 transport residual 触发关键帧,而不是每帧完整求解。
