论文精读笔记:Cov2Pose: Leveraging Spatial Covariance for Direct Manifold-aware 6-DoF Object Pose Estimation
1. 核心判断
- 论文:CVF Open Access
- 核心判断:Cov2Pose 将 direct pose regression 的两个常见问题同时处理:global pooling 丢掉空间二阶统计,以及欧氏回归无法自然表达 SPD / SO(3) 的几何结构。
2. 一句话定位
spatial covariance 作为图像到 pose 的中间表示,SPD-aware layers 保持矩阵结构,Cholesky code 则提供从 SPD 到连续 6D pose 的可微映射。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | covariance distance 与 pose geodesic distance 的相关性是否跨物体成立? |
| Figure 2 | covariance pooling、BiMap、Cholesky 和 SO(3) loss 的接口是什么? |
| Table 1 | LINEMOD 上与 direct / PnP 方法的比较是否公平? |
| Table 2 | Occluded LINEMOD 中 covariance 是否更能处理遮挡? |
| Table 3 | YCB-V 的 ADD(-S) 与 AUC 是否同时提升? |
| Table 5 / 6 | Euclidean head、SPD head 和 runtime 的收益与代价是什么? |
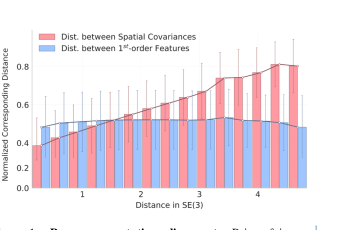 原论文图表中的相关区域:空间 covariance 距离与真实 SE(3) pose 距离呈相关关系,flattened feature 则相对不敏感。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 对 object crop 的 RGB 图像 I,网络学习映射 I→P∈SE(3)。
- 直接回归省略中间 2D keypoint / dense coordinate / PnP,速度通常更高,但对表示和 loss 更敏感。
- 训练数据中的 object instance 是已知的;因此“CAD-free”描述的是推理时不需要 CAD,不代表 unseen-object generalization。
- YCB-V 使用训练图像与 publicly available PBR images,LINEMOD / LM-O 按标准训练验证切分。
4. 研究脉络
- PnP-based 方法精度高但要先建立 2D-3D correspondence;direct regression 更快但常用 flattened feature 和不连续 rotation representation。
- covariance descriptors 能表达 feature activation 的 pairwise co-activation、纹理和形状分布,并自然位于 SPD manifold。
- Cov2Pose 将这一表示与 Riemannian deep learning、continuous 6D rotation representation 结合。
5. 研究动机
- global average / max pooling 丢失空间位置之间的二阶关系。
- pose 变化会影响 feature map 的 spatial covariance,可能比一阶均值更有判别力。
- 直接回归四元数、欧拉角或离散 bins 会遇到 discontinuity / normalization 问题。
- SPD matrix 与 Cholesky pose code 可在保持正定结构的同时表达连续 rotation / translation。
6. 方法详解
6.1 Spatial covariance pooling
- backbone 输出 C×H×W feature map,将每个空间位置看作一个 feature sample。
- 计算 channels 或 spatial descriptors 的 covariance,得到对称正定矩阵。
- Figure 1 的实验显示,图像对之间的 covariance Log-Euclidean distance 随 ground-truth SE(3) distance 增长,而 flattened feature cosine distance 变化很小。
6.2 SPD manifold layers
- BiMap 对 SPD matrix 做几何保持的降维,避免直接用欧氏线性层破坏正定性。
- ReEig 将过小特征值提升到数值稳定区间。
- 多层 SPD processing 后得到紧凑的 latent SPD code。
6.3 Pose encoding 与 loss
- Cholesky layer 将 latent SPD matrix 解码为下三角矩阵,再得到连续 6D rotation representation 与 translation。
- rotation 使用 6D continuous representation 映射到 SO(3),避免直接在不连续参数空间优化。
- loss 在 SO(3) × R³ 上衡量 pose,保证 rotation 的几何意义。
7. 实验分析
7.1 数据与指标
- LM / LINEMOD、LM-O / Occluded LINEMOD、YCB-V。
- 指标包括 ADD(-S) recall、ADD-S AUC、ADD(-S) AUC 和 inference time;对称物体使用 ADD-S。
7.2 主结果
- LINEMOD 上,Cov2Pose 在 end-to-end direct methods 中取得最佳 ADD(-S) 或接近最佳,并只以很小差距落后于最强 PnP 方法。
- Occluded LINEMOD 上,平均 ADD(-S) 约 76.8,优于对比 direct regression;YCB-V 上 ADD(-S) 约 72.3,AUC ADD-S / ADD(-S) 约 91.5 / 87.0 量级。
- Table 6 显示它在速度和精度之间达到较好的折中,说明 covariance head 没有让 direct method 失去实时性优势。
7.3 消融
- 去掉 covariance pooling 或换成普通 flattened representation 会下降,验证二阶空间统计的作用。
- 去掉 SPD manifold head、使用 Euclidean regression 会损失精度,说明矩阵几何不是装饰性模块。
- 将连续 6D rotation 替换成其他 rotation parameterization 会出现明显下降。
- 训练时保留完整 covariance structure 与 pose encoding,避免把 SPD 信息在 decoding 前破坏。
8. 批判性分析
- 优点:表示假设明确,SPD 与 SO(3) 的几何处理完整,direct regression 具有工程吸引力。
- 局限:训练 / 测试仍依赖已知 object categories;对 unseen object 和开放世界泛化没有直接保证。
- 输入敏感性:covariance 会整合 crop 内所有 feature,背景、mask、遮挡和物体尺度变化可能造成统计污染。
- 解释性:covariance 与 pose 的相关性在 Figure 1 中有诊断,但最终 network 仍难以解释具体空间结构。
9. 对我的研究的启发
- covariance / SPD code 可以与 correspondence confidence、pose uncertainty 或 feature-metric refinement 结合。
- direct head 仍可保留 PnP / render refinement 作为 fallback,形成速度优先的 coarse-to-fine pipeline。
- 对称物体可以在 SPD pose posterior 上建模等价解,而不是只用 ADD-S 做事后评测。
10. 待解决问题
- 如何让 covariance representation 泛化到 unseen object 和跨类别场景?
- 如何把 spatial covariance 与局部可见性、mask uncertainty 结合?
- 如何在 video 中递归更新 SPD pose code,并保持流形上的 temporal consistency?
11. 精读补充:Cov2Pose 的流形回归证据
11.1 关键配置
Cov2Pose 使用 EfficientNet-B6 backbone,约 41.4M 参数;YCB-V 训练 / 验证按 90 / 10 划分,训练 20 epochs,使用 4 张 NVIDIA A100。输入是单个 RGB object image / crop,输出连续 6D rotation representation + translation,不依赖 CAD、PnP 或 iterative rendering。
空间 feature map 的 covariance pooling 得到 SPD 矩阵,BiMap / ReEig 进行流形上的降维与正则,最后以 differentiable Cholesky decomposition 得到 4×4 SPD pose code,再解码到旋转和平移。Cholesky 不是后处理,而是可微 pipeline 的一部分。
11.2 主结果与速度
LM-O 的平均 ADD(-S) 为 76.8;YCB-V 的平均 ADD(-S) 为 72.3,Table 3 同时报告 ADD(-S) / AUC 等指标。LM-O Table 2 的 Ours 行为 64.0、96.4、74.1、96.3、55.8、57.9、93.6、76.7,平均 76.8,优于表中的 direct regression 方法。
推理时间拆分为 backbone 22.6 ms、covariance pooling 0.5 ms、SPD head + pose regression 23.8 ms,总计 46.9 ms。它不是极致实时,但在不依赖 PnP / render refinement 的 direct pose 里提供了较平衡的速度—精度点。
11.3 消融的结构解释
- rotation representation 的 6D + Gram-Schmidt 版本取得平均 76.8;说明连续 6D rotation 对 direct regression 更稳定。
- Euclidean regression、去掉 SPD head / BiMap / ReEig 或破坏 covariance structure 后性能下降,支持二阶空间统计与流形约束的必要性。
- Figure 1 的 correlation 结果显示 spatial covariance distance 随 ground-truth SE(3) distance 增长,而 flattened first-order feature distance 更平坦;这是表示假设的诊断实验,不等同于最终模型的因果证明。
11.4 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| covariance 能编码 pose-relevant spatial variation | Figure 1 与 LM-O / YCB-V 结果支持,但应按 background / mask noise 分组。 |
| SPD manifold 让 direct pose 更准确 | 消融支持;仍需与同 backbone 的 Euclidean head 做严格参数量、训练时长匹配。 |
| CAD-free direct method 具有部署价值 | 46.9 ms 和 end-to-end 结构有吸引力,但实验是 seen-object benchmarks,不能外推到 unseen-object。 |
12. 局限与迁移
covariance 会聚合 crop 内所有 feature,背景污染、遮挡和尺度变化会改变统计结构;对称物体还需要 symmetry-aware training / posterior。一个实际可行的 hybrid 是用 Cov2Pose 生成 coarse pose,再以 COG / AlignPose 的 correspondence 或 feature refinement 做 fallback,同时把 SPD residual 作为 uncertainty signal。
