论文精读笔记:CRISP: Object Pose and Shape Estimation with Test-Time Adaptation
1. 核心判断
- 论文:CVF Open Access
- 关键问题:面对大 domain gap,能否只用测试域无标签图像同时修正对象 shape 和 pose,而不把错误伪标签滚雪球?
- 核心回答:用 active shape model 将 decoder 的局部行为近似为可高效求解的 constrained least squares,并以 correct-and-certify 筛选自训练样本。
2. 一句话定位
CRISP 将 pose+shape 前端、显式几何 corrector 与 test-time self-training 组成闭环,重点不是一次预测而是可否可信地修正预测。
2.1 论文图表导读
| 图表 | 应该看什么 |
|---|
| Figure 2 | implicit shape、PNC pose、corrector 和 self-training 的数据流。 |
| Table 1–2 | shape error 与 ADD-S 要分开读,不能以一种替代另一种。 |
| Table 3–5 | 未见卫星 SPE3R 与类别级 NOCS 是否都从 self-training 受益。 |
| Figure 5 | object-consistency check 是否真正筛走了高 shape error 的伪标签。 |
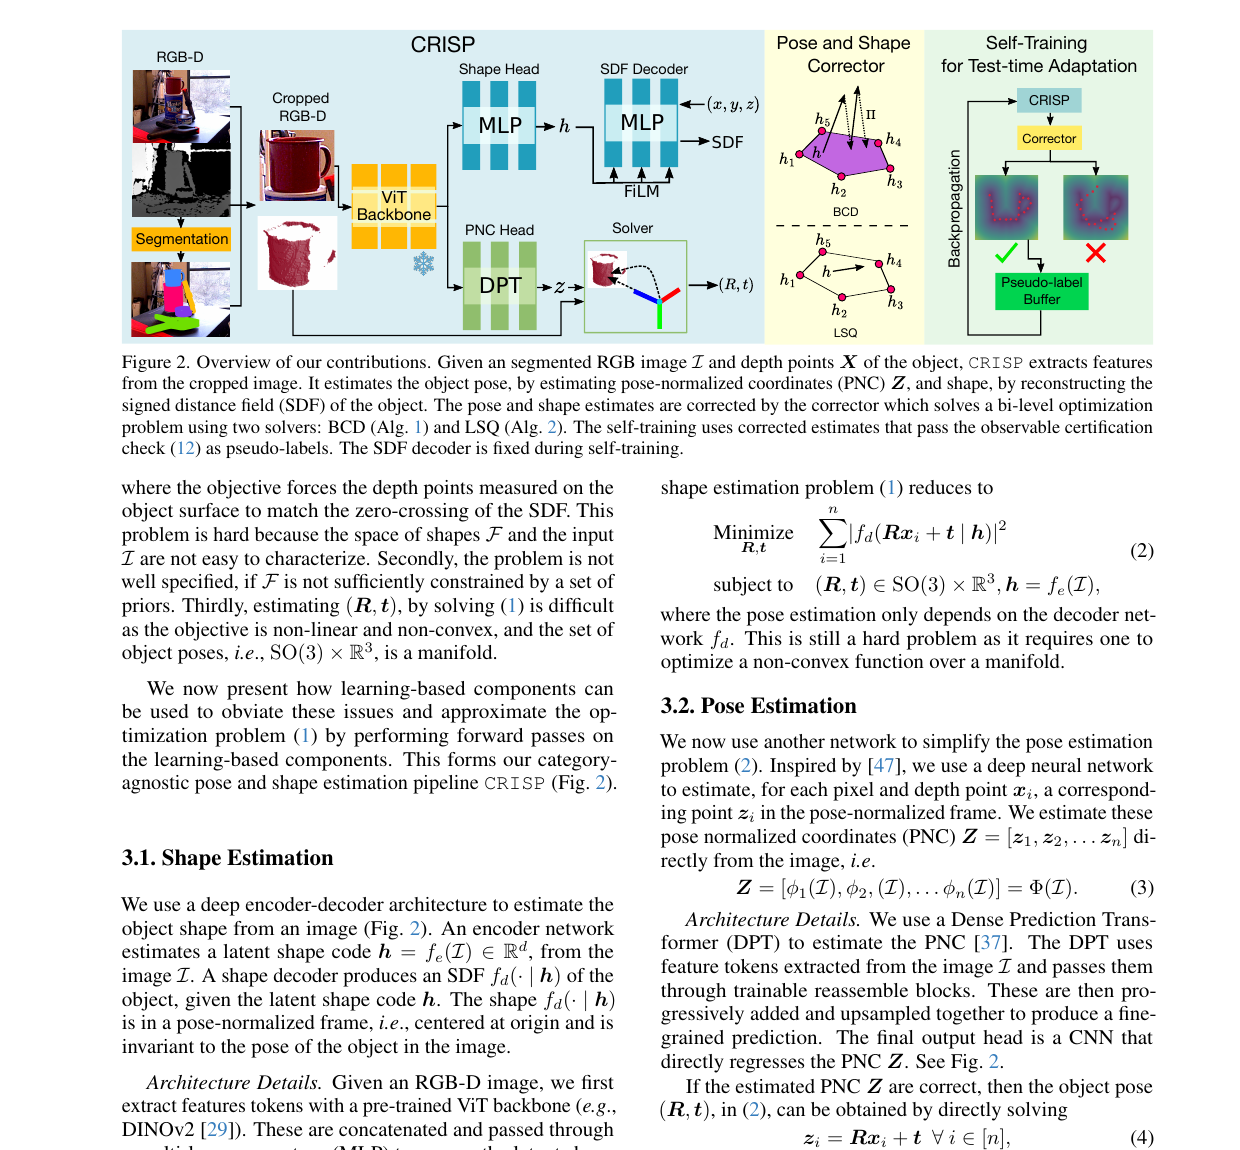 原论文方法图区域:CRISP 从 RGB-D 预测形状和 pose-normalized points,再通过 correct-and-certify 生成测试时伪标签。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- 输入为分割出的 RGB 与 depth points;输出 6D pose 和 shape,不依赖目标 CAD 的 instance onboarding。
- YCB-V 是 seen-object;SPE3R 和 NOCS 更接近形状 / 类别泛化。不同数据集的难点不可合成一个单一排名。
- 测试时自训练需要一段目标域图像 buffer,而不是单帧零成本推理。
4. 方法详解
- Front end:FiLM conditioning 的 decoder 从 latent code 解码隐式形状;DPT backbone 输出 pose-normalized coordinate / points。
- Corrector:在已知 shape latent 凸包附近以 active shape model 近似 decoder,将 pose、shape 校正化为有约束线性最小二乘;文中比较 interior-point 与 block coordinate descent。
- Certify and self-train:只使用通过 object consistency check 的 corrected estimate 作为 pseudo-label,decoder 冻结,更新预测网络。
5. 实验分析
| 设定 | 论文报告的关键结果 |
|---|
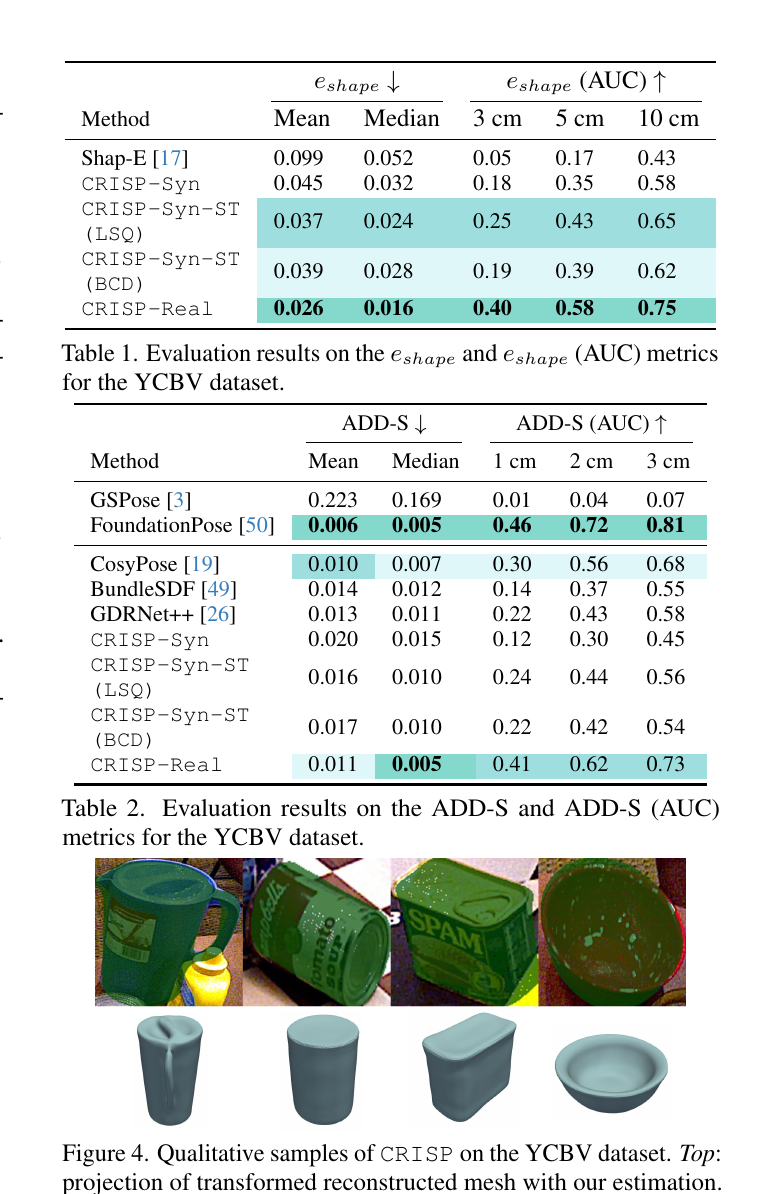
| YCB-V shape | CRISP-Real mean eshape = 0.026;文中 Shap-E = 0.099。 |
| SPE3R 未见卫星 | CRISP 的 mean eposeL1 为 0.292,CRISP-ST 为 0.224。 |
| 伪标签认证 | CRISP-Syn 无 corrector 时通过 check 的比例 6.1%;LSQ / BCD 后为 10.7% / 16.6%。 |
这说明论文的关键证据不是“自训练一定提升”,而是 corrector 让更多样本能够以内部一致性标准被安全纳入训练。
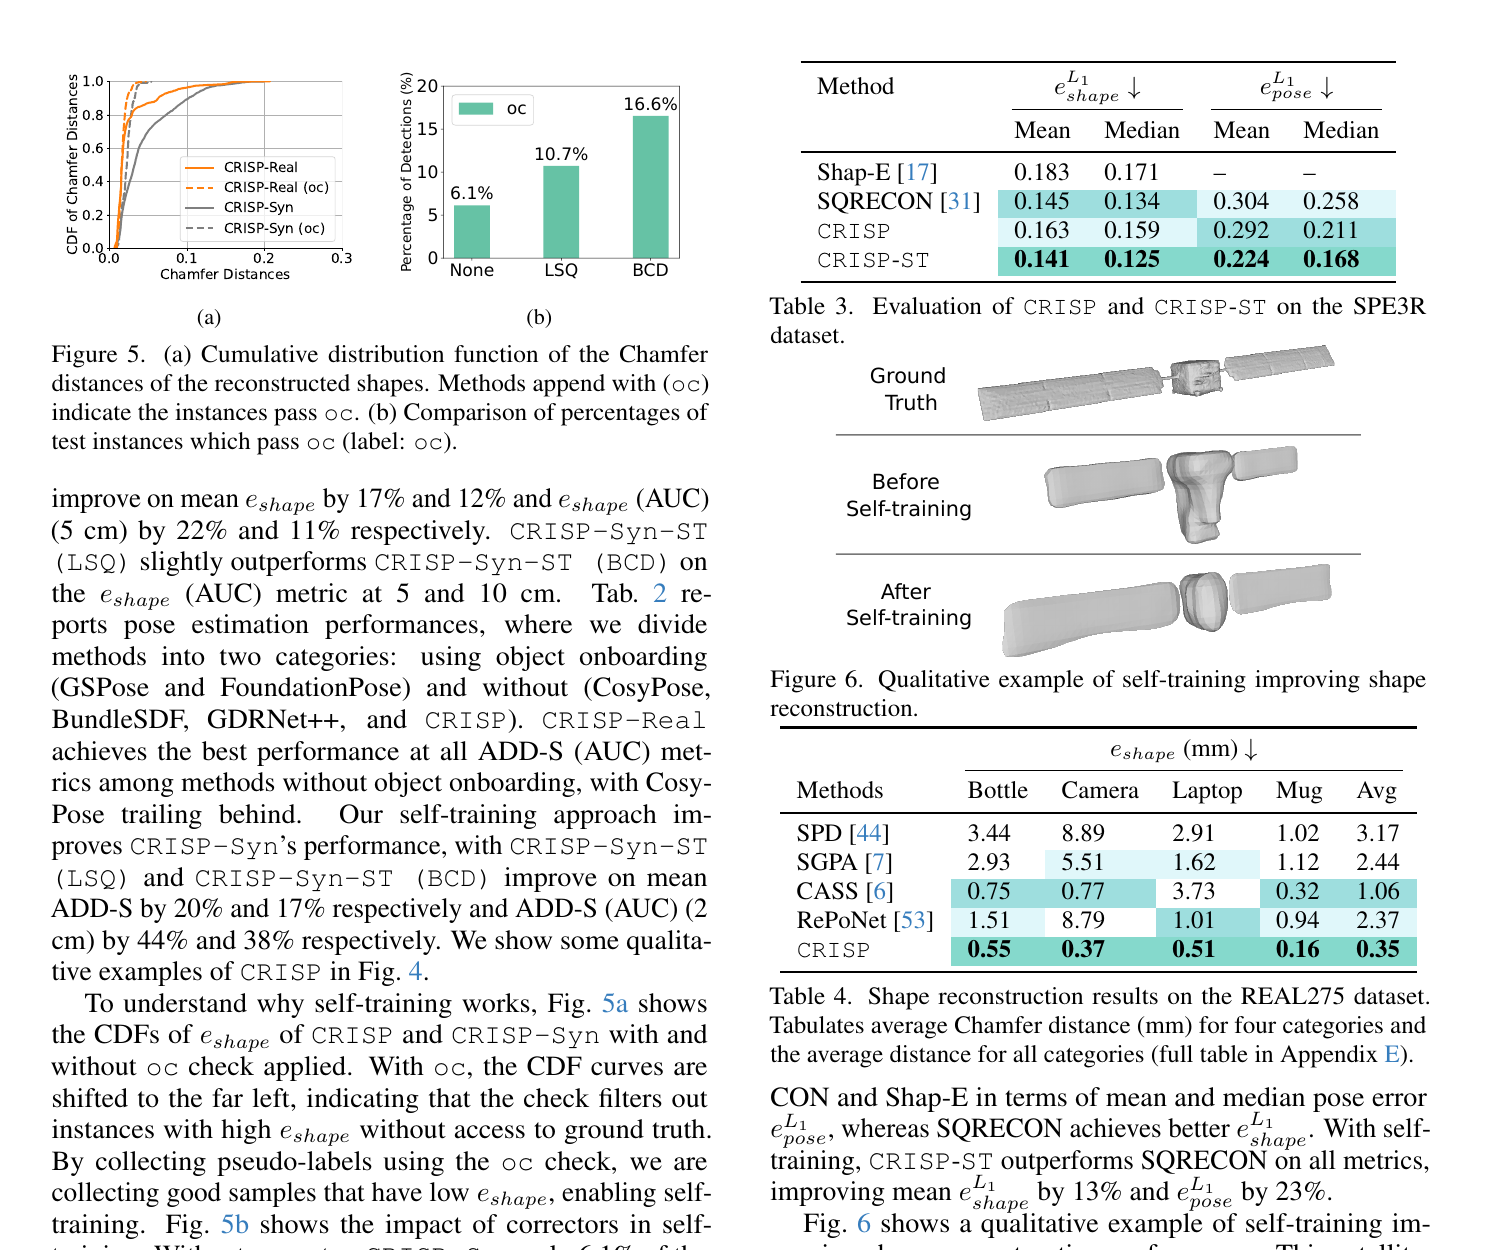 CRISP 原论文的测试时适应证据:曲线展示伪标签筛选过程,表格分别报告 SPE3R 的 pose / shape 误差和 REAL275 的类别级形状结果。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
SPE3R 上,CRISP-ST 将 mean shape error 从 0.163 降到 0.141、median 从 0.159 降到 0.125;mean pose error 从 0.292 降到 0.224、median 从 0.211 降到 0.168。形状和姿态同步改善,说明自训练不是只“修外观”而未改善几何对齐。不过,这些结果依赖进入 buffer 的目标域序列与 certification 阈值;它们不等价于单帧、无历史状态的即插即用推理。
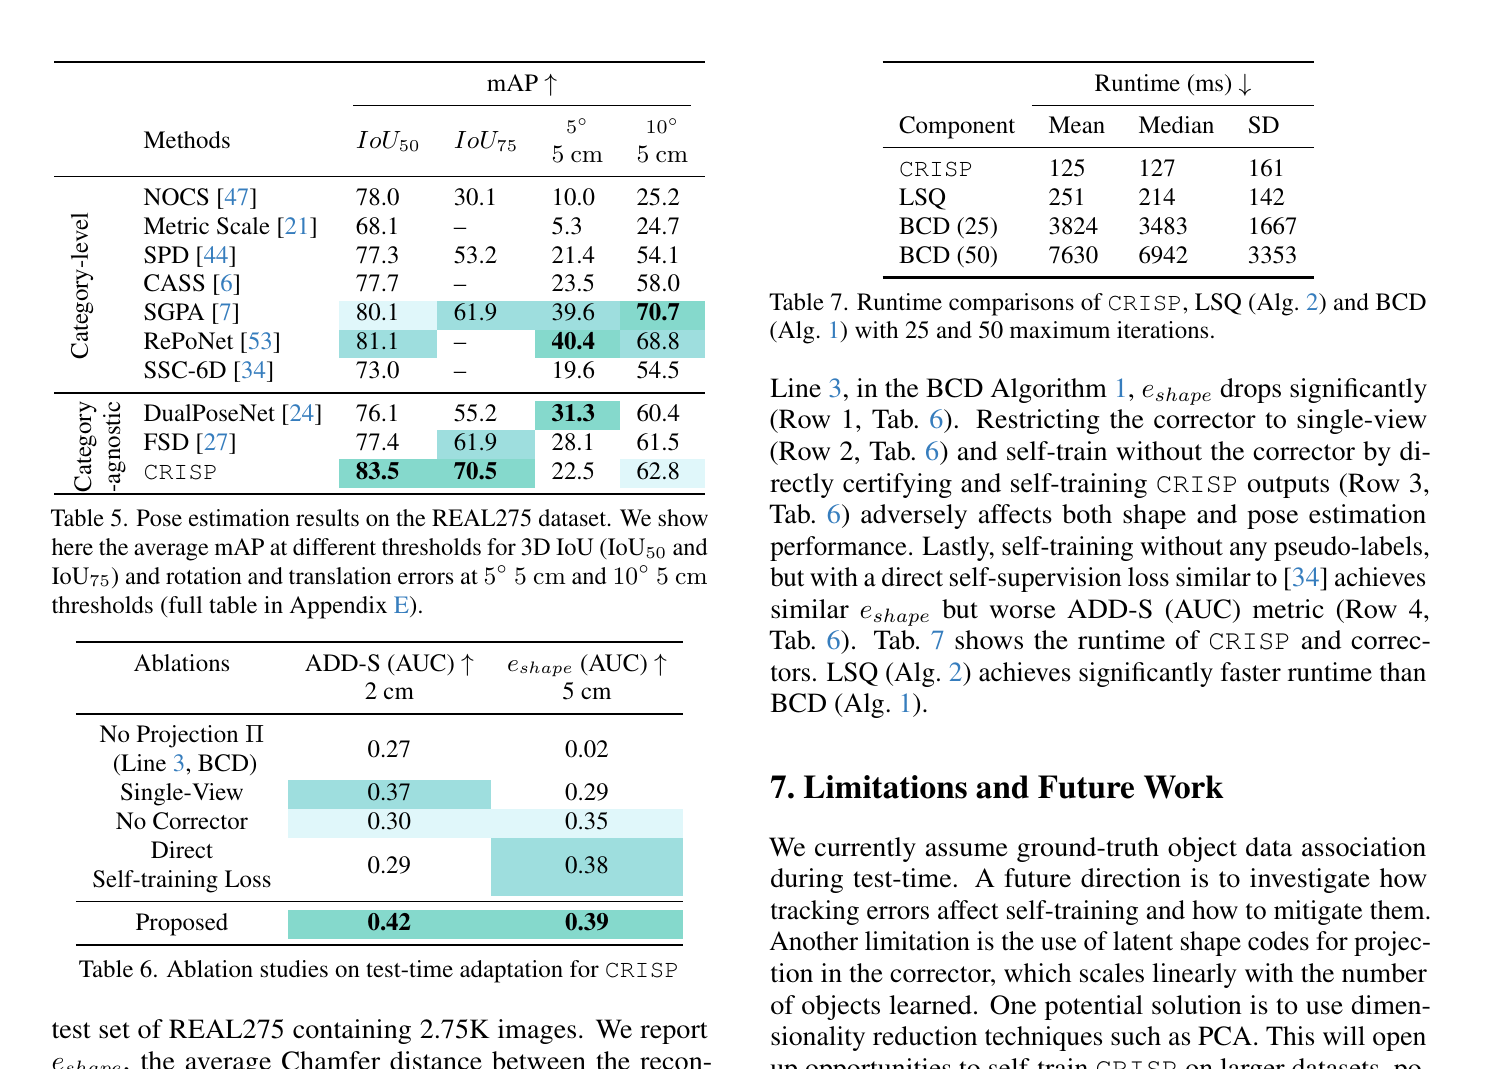 CRISP 原论文的 NOCS / REAL275 评估、corrector 消融与运行时间。BCD 能让更多样本通过一致性检查,但计算代价显著高于一次前向和 LSQ。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
效率表给出了一个很重要的工程约束:CRISP 前端约 125 ms,LSQ corrector 约 251 ms,而 25 / 50 次 BCD 分别约 3.8 s / 7.6 s。虽然 BCD 的伪标签通过率达到 16.6%,高于无 corrector 的 6.1% 和 LSQ 的 10.7%,但它更适合作为低频适应模块,而不是每帧运行的实时后端。若产品场景要求 10–30 FPS,应考虑异步 buffer 更新、低频校正或只在置信度下降时触发。
6. 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| 认证式伪标签可桥接大域差距 | 有 SPE3R / YCB-V 结果和通过率支撑;认证阈值的跨域敏感性还应公开。 |
| 同时估计 shape 与 pose 比仅 pose 更稳 | shape 和 pose 指标都改善,但仍需要 analysis 说明两者的误差传递关系。 |
7. 复现要点与限制
- 正确复现需固定 segmentation mask、latent shape 的训练分布、consistency threshold、test buffer 长度和 corrector iteration cap。
- BCD 比 LSQ 可能取得更多通过样本,却明显更慢;将它当每帧实时模块并不合适。
- 对透明、强反光或深度严重缺失对象,前端 RGB-D 观测不满足 corrector 的几何假设时会失败。
- “certify”在这里是相对于论文定义的对象一致性检查,而不是对真实姿态误差给出形式化的全局正确性保证;网站阅读时应避免把“通过内部检查”表述成“必然是真值”。