论文精读笔记:dGeDi
1. 核心判断
dGeDi 的出发点非常具体:FreeZe 的 GeDi geometric encoder 在 zero-shot pose 上有效,但它需要为每个 query point 建局部参考坐标系并逐邻域编码,单图平均耗时数秒。作者没有重做整个 pose estimator,而是把 GeDi 当作冻结教师,将局部描述子蒸馏到可并行处理完整点云的 PointTransformerV3 学生。
真正困难的不是普通 feature regression,而是教师 descriptor 本身并非处处可靠:MegaPose-GSO 上只有约 21.4% target points 能在 teacher feature space 中匹配,BOP 平均 ratio-of-nearest points 仅约 3%。若用 MSE 平等逼近所有点,低辨识度 teacher points 会占据梯度。论文用“几何 correspondence 构造 target 监督 + 低误差优先的 loss”解决这个问题。
2. FreeZe 中 dGeDi 替代哪一段
FreeZe 输入 RGB-D image I 与对象 CAD O:
- SAM-6D 分割目标 crop;
- depth + intrinsics 将 crop lifting 为 partial target point cloud PT;
- CAD 表面采样 query point cloud PQ;
- geometric encoder 与 vision encoder 分别提特征并拼接;
- feature nearest-neighbor 建立 PQ↔PT 对应;
- RANSAC / SVD 估计 rigid transform,ICP refinement;
- SAR 处理 symmetry-aware refinement。
dGeDi 只替换第 4 步的 GeDi geometric encoder。vision foundation features、SAM-6D、RANSAC、ICP、SAR 均保留,所以“173×”不能解释成完整 FreeZe pipeline 加速 173 倍。
3. Object-oriented distillation
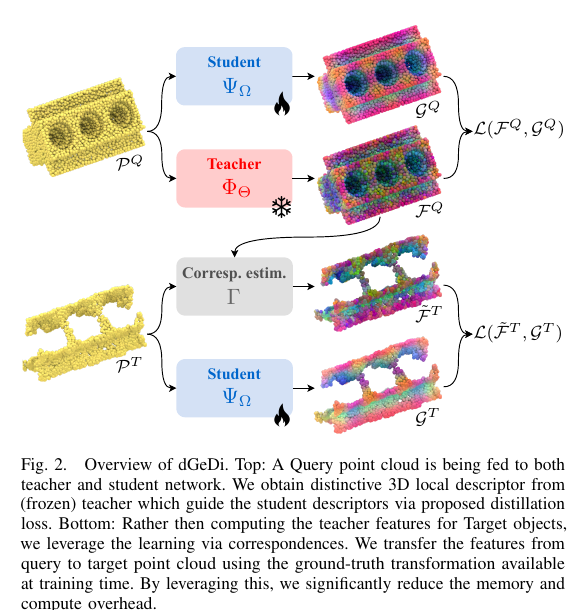 原论文 Figure 2。上半部蒸馏完整 CAD query;下半部通过真值 pose 建立几何映射 \(\Gamma\),用 query teacher feature 监督 partial target student feature。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
3.1 Teacher 与 student
- Teacher ΦΘ:GeDi,点式局部 encoder,显式 local reference frame 保证 rotation invariance;
- Student ΨΩ:PTV3,voxel / serialized point processing,decoder channel 从 64 改为 32;
- 输出:每点 32D descriptor;
- teacher frozen,student 用 AdamW 与 cosine scheduler 训练。
输入点云均随机采样 4,000 点,target 先做 statistical outlier removal,并按 query object diameter 做 scale normalization。评测 5K points 时 dGeDi peak memory 为 717 MB。
3.2 Learning via correspondences
直接计算 FQ=Φ(PQ)、FT=Φ(PT) 有两个问题:
- PQ 来自干净 CAD,PT 来自 partial noisy depth,教师特征存在 domain gap;
- MegaPose 约 850 query objects 对应约 16M target observations,全部预计算 / 缓存 teacher targets 约需 14 TB。
训练样本已有真值 TQ→T。作者先把 query points 变换到 target frame,再按欧氏距离找最近 query point:
Γ(p)=argq∈PQmin∥TQ→Tq−p∥.
随后用 F~T=Γ(FQ) 监督 GT=Ψ(PT)。这样 target student 学到的是对应 CAD surface point 的干净 teacher descriptor,而不是 teacher 在 noisy target 上的易错输出。只需缓存 query teacher features,估算存储 14 TB→34 GB,约 411× 缩减。
这种监督也有假设:真值 pose、CAD、depth 和 mask 要对齐;target point 如果来自遮挡物或背景,最近 CAD point 仍会被强制赋标签。因此作者训练使用 GT masks,部署 SAM-6D masks 时出现 domain gap。
3.3 低误差优先损失
作者统计教师 descriptor 大部分并不 distinctive,提出:
L(F,G)={α∥F−G∥2,β∥F−G∥+γ,∥F−G∥<δotherwise
其中 α=8,β=1/5,δ=0.3,γ=8δ2−δ/5。低误差区是较陡二次曲线,鼓励精确拟合 student 已能学习的可靠特征;高误差区接近平台,避免 ambiguous / noisy teacher points 获得过大权重。
论文另测 Focal-like 变体 L~=∥F−G∥ϵL、ϵ=15,即反过来强调大误差点,结果显著更差。这个对照支持作者“不是所有 teacher knowledge 都值得复制”的判断。
4. 数据、指标和运行环境
- 训练:MegaPose-ShapeNetCore,1M synthetic images,8×NVIDIA A100;
- 评测:LM-O、T-LESS、TUD-L、IC-BIN、YCB-V,单 NVIDIA A40;
- segmentation:GT masks 与 SAM-6D zero-shot masks 两套;
- RANSAC:100K iterations;ICP:1K iterations;
- descriptors:32D;GeDi neighborhood radius 为 query diameter 的 30%。
指标:
- RON:query point 的 feature nearest neighbor 在真实几何距离阈值内的比例,阈值为 object diameter 的 3%;
- FMR:RON 超过 5% 的匹配成功率;
- BOP AR:registration 后 pose accuracy;
- runtime:每图 geometric feature extraction 或完整 pipeline 时间,需看具体表格列。
RON / FMR 直接评估 descriptor;AR 还受 RANSAC、ICP、mask 和 symmetry refinement 影响。因此特征提升不一定逐数据集转换为 AR 提升。
5. Teacher–student 直接比较
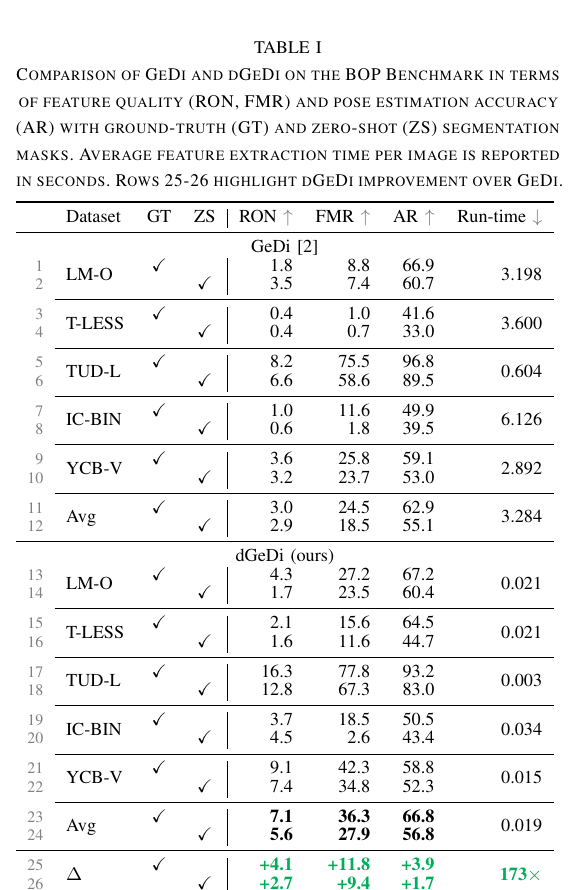 原论文 Table I 与 Figure 3。Table I 同时报告 GT / zero-shot masks,最右列为 geometric feature extraction;Figure 3 显示 student descriptors 比 teacher 更平滑。来源:作者公开稿;图表版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
平均结果:
| Mask | Encoder | RON | FMR | BOP AR | Feature time |
|---|
| GT | GeDi | 3.0 | 24.5 | 62.9 | 3.284 s |
| GT | dGeDi | 7.1 | 36.3 | 66.8 | 0.019 s |
| SAM-6D | GeDi | 2.9 | 18.5 | 55.1 | 3.284 s |
| SAM-6D | dGeDi | 5.6 | 27.9 | 56.8 | 0.019 s |
0.019 s 对 3.284 s 是表中 173×。正文还换算为每图超过 50 FPS;因为一图平均约 5 个 target objects,约 260 point clouds/s。不同数据集 target 数不同,dGeDi 时间从 TUD-L 3 ms 到 IC-BIN 34 ms。
值得注意:
- T-LESS GT-mask AR 从 41.6 提升到 64.5,+22.9;作者归因于锐利工业几何适合 student 学到平滑且有辨识度的特征;
- TUD-L / YCB-V 的 GT-mask AR 反而从 96.8 / 59.1 降到 93.2 / 58.8;
- 所以“student 全面优于 teacher”只对平均特征指标成立,不是每数据集 pose AR 都更高。
6. 消融与完整系统
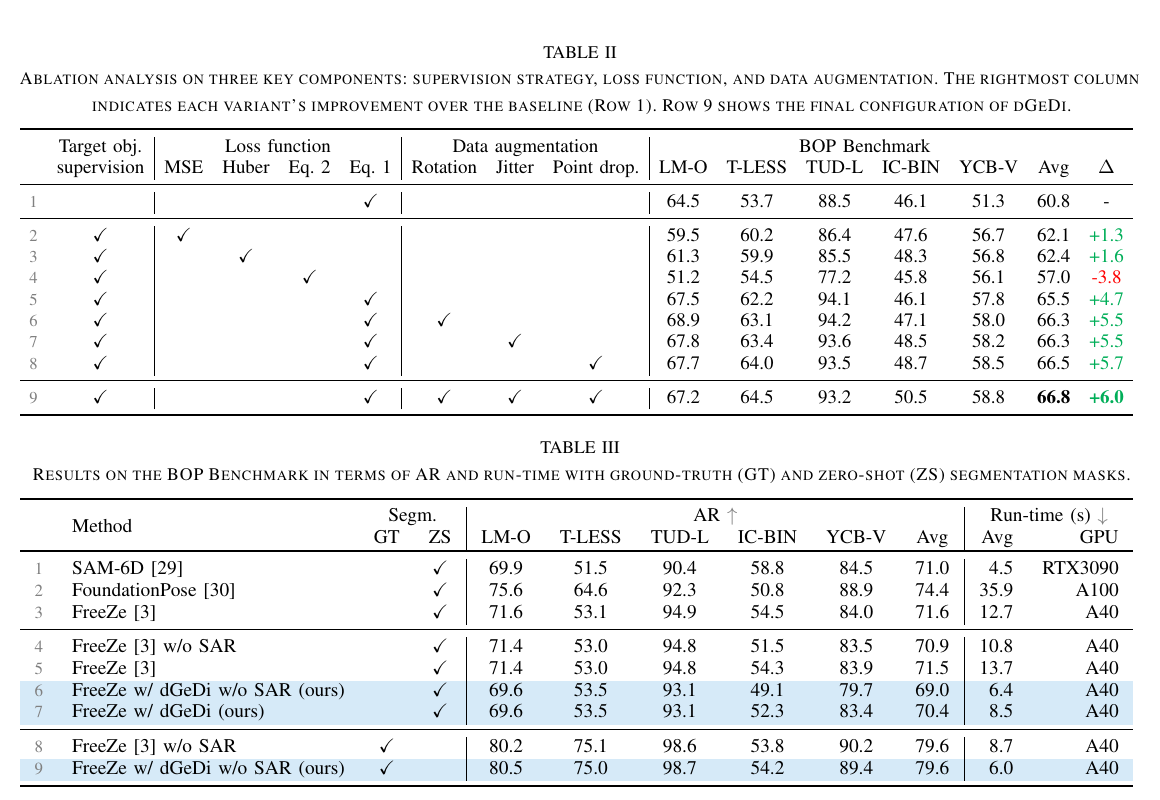 原论文 Table II–III。Table II 的最终配置用 target supervision、Eq. 1 和三种 augmentation;Table III 区分几何 encoder 提速与完整 FreeZe 端到端时间。来源:作者公开稿;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
6.1 蒸馏消融
仅 query supervision + Eq.1 + 无增强的 baseline 平均 AR 为 60.8。
- 加 target correspondence supervision + Eq.1:65.5,+4.7;
- MSE / Huber:62.1 / 62.4;
- 强调高误差点的 Eq.2:57.0,低于 baseline 3.8;
- target supervision + Eq.1 + rotation / jitter / point dropout:最终 66.8,+6.0。
证据支持三项设计:target partial observation 监督、抑制高误差 teacher features、几何 / 缺失增强。
6.2 FreeZe 端到端
| 设置 | FreeZe / dGeDi | Avg AR | Avg runtime |
|---|
| SAM-6D mask + SAR | FreeZe | 71.5 | 13.7 s |
| SAM-6D mask + SAR | dGeDi | 70.4 | 8.5 s |
| GT mask, no SAR | FreeZe | 79.6 | 8.7 s |
| GT mask, no SAR | dGeDi | 79.6 | 6.0 s |
部署设定下,dGeDi 把端到端时间降 5.2 s,但 AR 降 1.1。GT mask 时保持相同 AR 并降 2.7 s。FoundationPose 表中的 74.4 AR / 35.9 s 在 A100 上测,SAM-6D 的 71.0 / 4.5 s 在 RTX3090 上测;由于 GPU 与实现不同,跨方法 runtime 不能当作严格硬件公平排名。
7. 定性结果
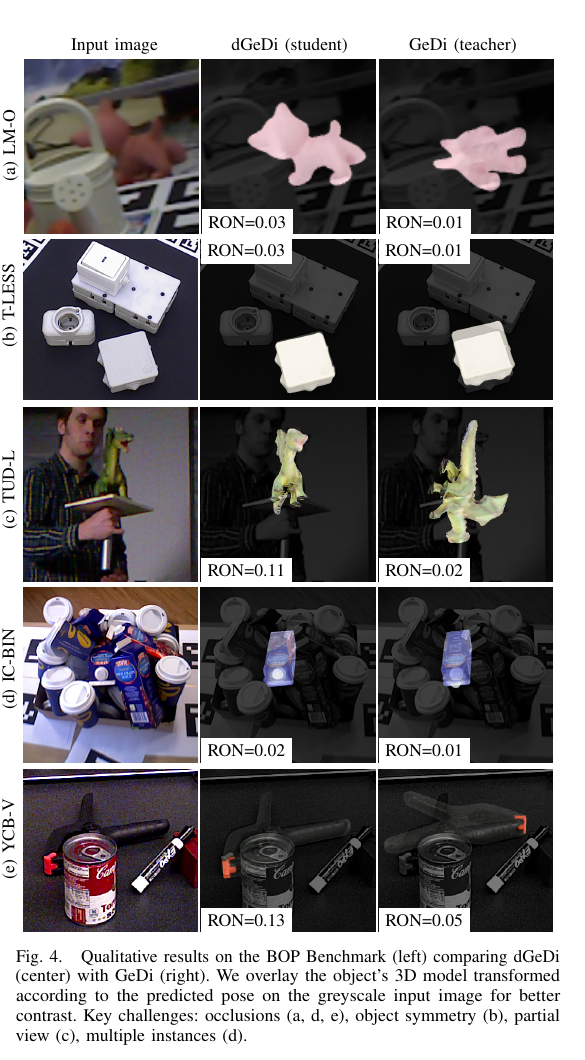 原论文 Figure 4:覆盖 LM-O 遮挡、T-LESS 对称、TUD-L partial view、IC-BIN 多实例和 YCB-V 遮挡;灰度图上的彩色 CAD 为预测 pose。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
作者解释 GeDi 的 local reference frame 在可见结构不足时容易失败,而 student 直接前馈产生更平滑的 descriptor。图中 dGeDi 的 RON 均高于 GeDi并给出更合理 pose。该图是作者选择的成功案例,没有配套失败案例;对称对象利用微小不对称细节获得唯一 pose,也需确认是否与 benchmark symmetry equivalence 一致。
8. 局限与复现风险
作者明确指出:dGeDi 只优化 geometric feature extraction,registration 仍是系统瓶颈。
本站补充:
- 训练依赖 GT pose 和 GT mask,zero-shot 指的是测试对象未见,不是无监督训练;
- SAM-6D mask 噪声导致完整系统 AR 下降,说明 student 对 segmentation domain shift 仍敏感;
- storage 14 TB / 34 GB 是按作者数据规模与 feature layout 的估算,应在实际格式中复核;
- 8×A100 训练成本并不“轻量”,轻量指部署 encoder;
- 100K RANSAC + 1K ICP iterations 占据大量端到端时间;
- descriptor 只在 FreeZe 路线和 RGB-D 输入中验证,未测试纯点云注册、事件或 RGB-only;
- 论文未报告参数量、训练时长、能耗和低端 edge GPU latency。
9. 复现检查表
- 固定 PTV3 voxel / serialization 参数、32D decoder 和点数;
- 复现 query diameter normalization、target statistical outlier removal;
- 核对 TQ→T 方向、最近邻 Γ 与 target visibility;
- 保存 teacher query features 的 dtype、压缩和 34 GB 估算;
- 实现 piecewise loss 的连续常数 γ 与 δ=0.3;
- 复现 rotation、jitter、point dropout 的幅度;
- 分别记录 geometric encoder、vision encoder、matching、RANSAC、ICP、SAR 时间;
- 同时报告 GT masks 与 predicted masks,避免把前端 domain gap 藏在平均 AR 中。
10. 最终评价
dGeDi 是一篇“局部模块问题定义清楚、工程数字完整”的论文。它没有声称重构整个 zero-shot pose pipeline,而是精准解决 GeDi 太慢和 teacher descriptor 不可靠的问题。173× 只属于几何特征提取,完整 FreeZe 是 13.7→8.5 s 且 AR 略降;把这两个尺度区分后,dGeDi 仍然是非常有价值的高效 3D descriptor 蒸馏案例。
