论文精读:DynOPETs
1. 为什么需要动态物体 / 动态相机数据
多数 6D object pose 数据集默认至少有一项容易控制:
相机固定、物体被转台或机器人移动;
物体静止,相机绕物体拍摄;
每一帧相对独立,不要求长期 tracking consistency;
动态视频存在,但对象类别、未知对象估计与 tracking 只覆盖其中一项。
真实 AR、移动机器人和人机交互却经常是“人拿着未知物体移动,观察者也在移动”。此时 image blur、手部遮挡、快速旋转、弱纹理和相机自运动同时出现,单帧 pose 与时序 tracking 都会变难。DynOPETs 的主要贡献不是新网络,而是以同一批长视频支撑:
category-level object pose estimation(COPE);
unseen-object pose estimation(UOPE);
dynamic object pose tracking(OPT)。
2. 数据规模与组成
论文发布 175 条 distinct object sequences,每条约 500 帧、15 Hz,总计约 210K RGB-D frames 与超过 530K annotations。标注内容包括 instance mask、camera intrinsics / extrinsics、camera pose、object pose 和扫描 CAD。
COPE-119
面向类别级 6D pose / size,覆盖 bottle、bowl、camera、can、laptop、mug 等常见 NOCS 类别。对象具有类内形状和尺度变化。
UOPE-56
其余 56 个 household objects,给定 query object model / scan,评测此前未在目标数据上训练的 novel-object estimator。
Tracking
全部 175 条序列用于 object pose tracking。这里的难点不仅是 object motion,也包括 moving camera;最终评价相机坐标系下的 camera-to-object trajectory。
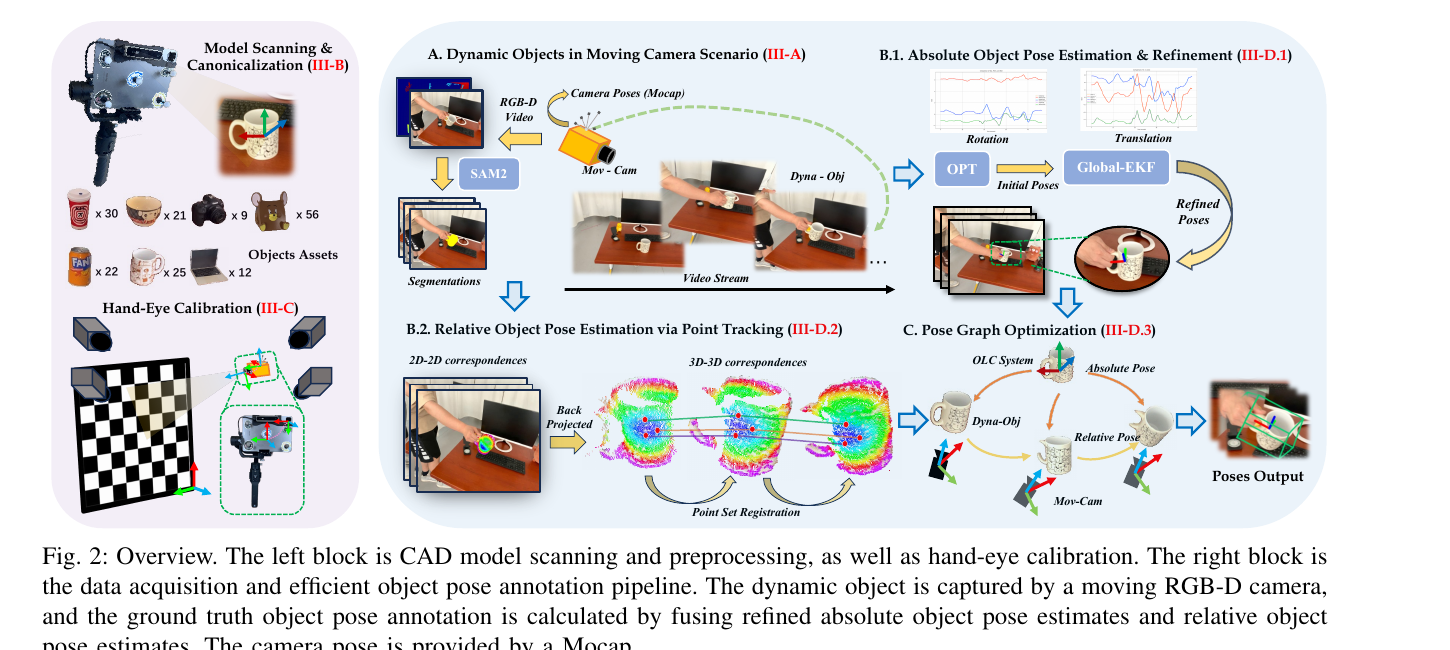
采集设备为 iPad Pro + Structure Sensor Pro。camera trajectory 由外部 OptiTrack mocap 获得,再通过 hand–eye calibration 与 RGB-D 对齐。对象不贴 marker,避免 marker 遮挡纹理或改变日常物体外观。对象模型经过扫描、尺度恢复和 canonicalization,统一到 object local coordinate(OLC)。
3. 标注为什么需要三种几何来源
原论文 Figure 2:左侧完成扫描和 hand–eye calibration;右侧把移动 RGB-D、mocap 相机位姿、绝对 object pose 与相对 point tracking 融合为全局一致轨迹。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
3.1 绝对位姿:FoundationPose + EKF/RTS
FoundationPose 以 RGB-D、object mask 和 CAD model 给出每帧 pose。绝对 pose 不累计漂移,但会受到遮挡、对称、mask 错误影响,个别帧会突然跳到错误模式。
作者在全局序列上采用 constant-velocity state:
x = [ p , q , v , ω ] , x=[p,q,v,\omega], x = [ p , q , v , ω ] , 其中 p , q p,q p , q v , ω v,\omega v , ω
3.2 相对位姿:TAP 点轨迹 + 3D registration
作者从 reference frame 选 query points,使用 Track-Any-Point 类模型在视频中获得 2D correspondence;再根据每帧 depth 反投影到 3D,以 point-set registration 估计帧间 S E ( 3 ) SE(3) S E ( 3 )
相对方法不需要每帧重新识别 object 的 canonical pose,对近似对称或弱纹理物体更平滑;但一旦 tracks 漂移或 depth 缺失,误差会积累,长序列没有全局锚点。
3.3 Pose graph optimization
令每一帧的 object pose 为图节点。绝对估计形成 unary / prior-like edge,相对运动形成相邻或跨帧 edge;信息矩阵表达两者可信度。作者在 GTSAM 中优化所有节点:
absolute edge 抑制长期 drift;
relative edge 保持局部运动连续;
对明显错误的 absolute pose,需要人工检查和删除 edge。
这一人工步骤很重要。数据不是“一键自动 ground truth”,而是 algorithmic proposal + smoothing + manual curation + graph optimization。
4. 标注验证:能说明什么,不能说明什么
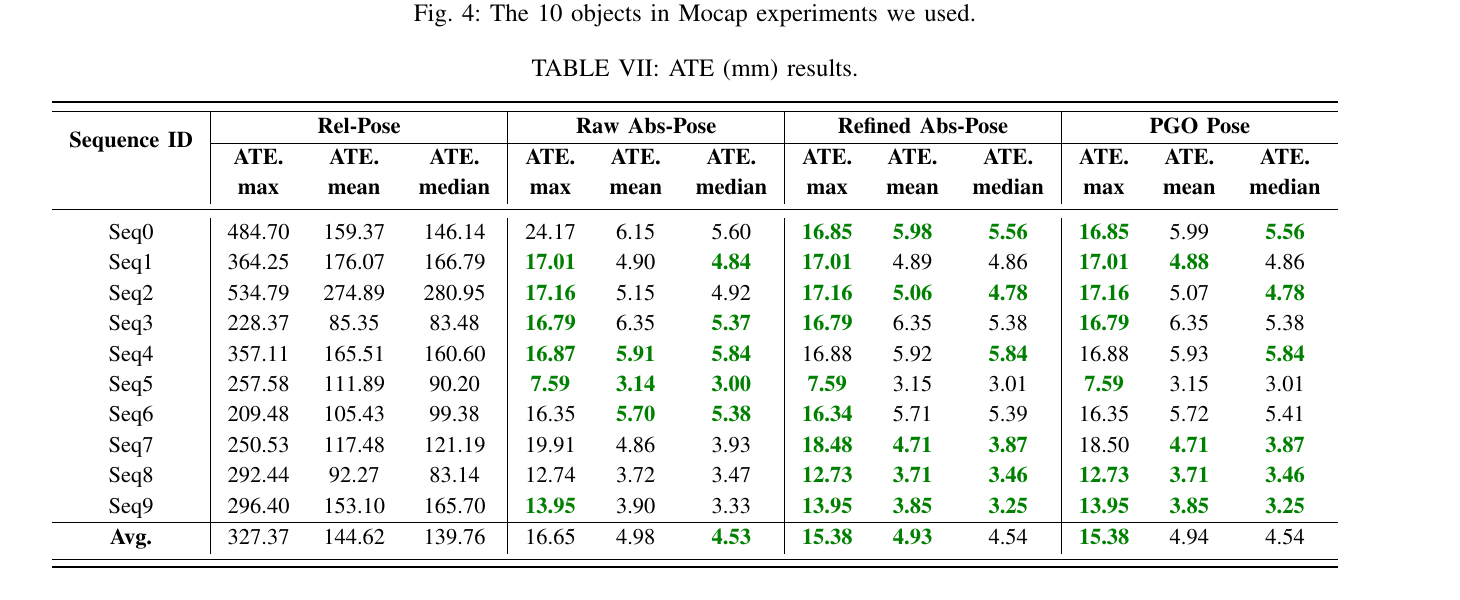
作者额外选择 10 个物体安装 mocap markers,采集与主数据不同的验证序列。这样可获得 object 与 camera 都由 OptiTrack 测得的参考轨迹,再比较四种标注:
Rel-Pose;
Raw Abs-Pose;
Refined Abs-Pose;
PGO Pose。
补充材料 Table VII:PGO 的平均 ATE mean 为 4.94 mm,最大 ATE 的十序列均值为 15.38 mm;纯 relative pose 则因漂移达到 144.62 mm mean ATE。来源:原论文及补充材料 。图片版权归论文作者所有,本站仅作学术解读展示。
关键均值为:
标注路线 ATE max ATE mean ATE median Rel-Pose 327.37 mm 144.62 mm 139.76 mm Raw Abs-Pose 16.65 mm 4.98 mm 4.53 mm Refined Abs-Pose 15.38 mm 4.93 mm 4.54 mm PGO Pose 15.38 mm 4.94 mm 4.54 mm
结果表明:
relative-only 的长期漂移非常明显;
FoundationPose 绝对估计本身已在厘米内;
smoothing / PGO 对平均误差改善很小,主要价值可能是消除离散跳变、提高轨迹一致性;
10 条验证支持“毫米级平均误差”这一量级,但样本远少于 175 条主数据,且验证对象安装 marker 后的动态 / 遮挡分布未必等同于主集。
论文正文概括旋转误差低于 1°、平移低于 1 cm;使用时最好把它视为独立小样本审计结果,而不是每帧误差保证。
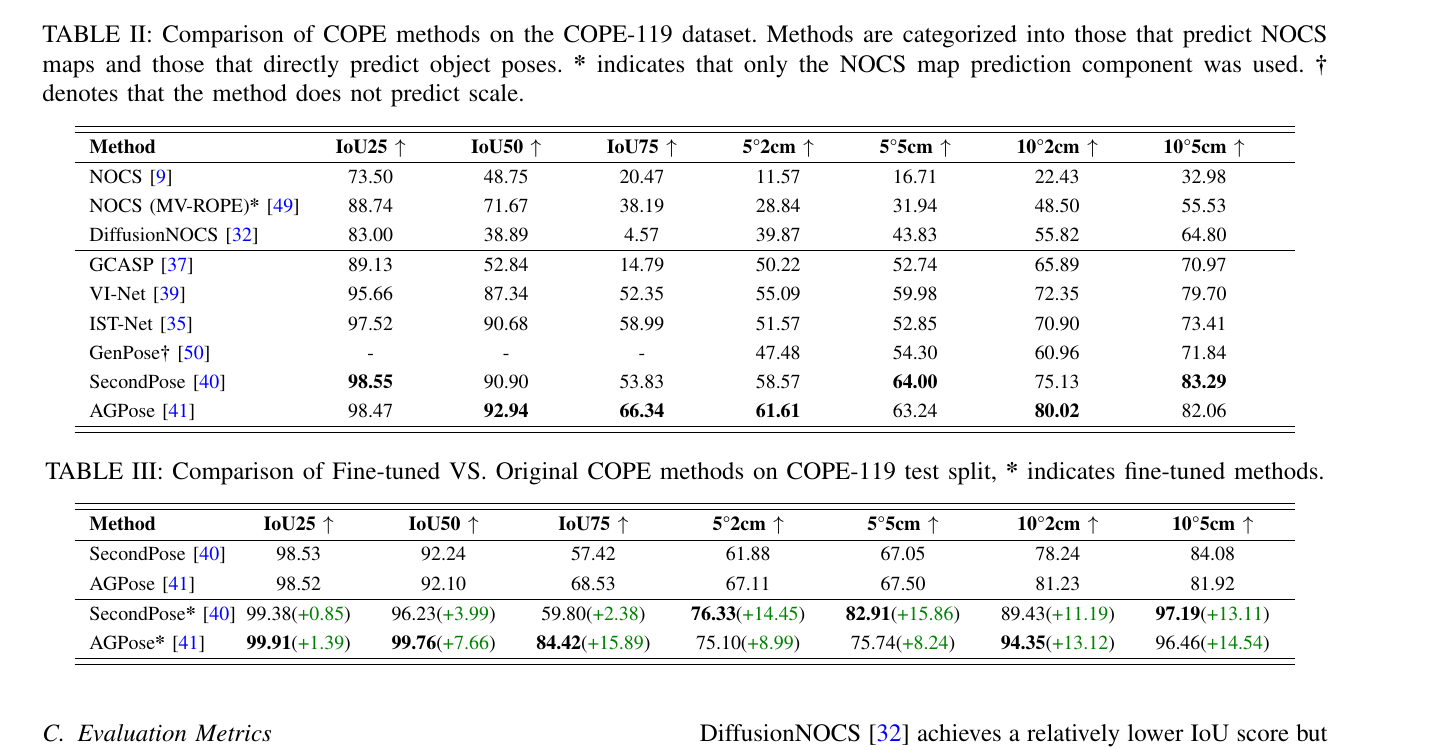
5. Category-level pose benchmark
COPE 任务同时评价 3D IoU 与姿态阈值。所有方法尽量共享 SAM2 segmentation,以减少 detector 差异。
原论文 Tables II–IV:COPE 的 IoU / 角度平移阈值、短微调增益,以及 UOPE 的 BOP AR 与 FPS。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
原始模型中:
SecondPose:IoU25 98.55、5°5 cm 64.00、10°5 cm 83.29;
AGPose:IoU50 92.94、IoU75 66.34、5°2 cm 61.61、10°2 cm 80.02。
不同方法在尺度 / IoU 与严格 pose threshold 间各有优势,不能用一个粗体列判定总体最优。
作者还用 84 条 training sequences 只 fine-tune 2 epochs,在 35 条 test sequences 上评估:
方法 5°2 cm 5°5 cm 10°5 cm SecondPose 原始 61.88 67.05 84.08 SecondPose 微调 76.33 82.91 97.19 AGPose 原始 67.11 67.50 81.92 AGPose 微调 75.10 75.74 96.46
这说明 DynOPETs 的训练标注确实能提供有用监督,但“微调后提升”不是对标注绝对正确性的独立证明:domain match 也会带来提升。更严格的验证仍是上一节 marker mocap。
6. Unseen-object pose benchmark
UOPE-56 使用 BOP 的 VSD、MSSD、MSPD 及其平均 AR,并报告 FPS:
方法 输入 AR FPS FoundPose coarse RGB 60.46 0.50 MegaPose RGB 72.23 2.25 GigaPose RGB 69.79 3.37 MegaPose RGB-D 80.49 2.61 SAM6D RGB-D 79.75 3.75 FoundationPose RGB-D 92.41 0.98
FoundationPose 的精度优势明显,但速度并不领先。论文还说明 FoundPose 的核心 refinement code 未开放,因此只能报告 coarse result;这会使 benchmark 对“完整方法”与“可复现部分”的比较不完全对称。
7. Dynamic tracking benchmark
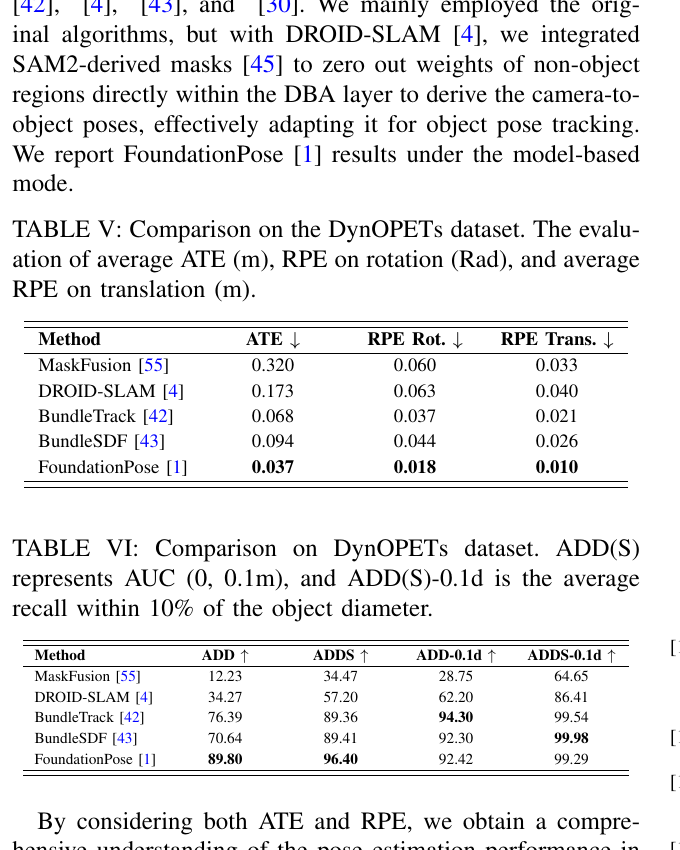
作者比较 MaskFusion、DROID-SLAM、BundleTrack、BundleSDF、FoundationPose。DROID-SLAM 通过 SAM2 mask 把非对象区域权重置零,再将 camera motion 转换为 object-relative motion。
原论文 Tables V–VI:FoundationPose 的 ATE / RPE 最低,BundleTrack / BundleSDF 在部分 ADD(S)-0.1d recall 上更高,反映平均轨迹误差与失败率并非同一概念。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
轨迹误差
方法 ATE ↓ RPE Rot. ↓ RPE Trans. ↓ MaskFusion 0.320 m 0.060 rad 0.033 m DROID-SLAM 0.173 m 0.063 rad 0.040 m BundleTrack 0.068 m 0.037 rad 0.021 m BundleSDF 0.094 m 0.044 rad 0.026 m FoundationPose 0.037 m 0.018 rad 0.010 m
Pose threshold / AUC
FoundationPose 的 ADD / ADD-S AUC 为 89.80 / 96.40,最高;但 ADD-0.1d 为 92.42,略低于 BundleTrack 的 94.30,ADD-S-0.1d 为 99.29,略低于 BundleSDF 的 99.98。论文解释是 FoundationPose 在少数序列出现 tracking failure。AUC 与 strict threshold recall 对 failure tail 的敏感性不同,因此两组指标应一起看。
8. 数据使用中的风险
8.1 伪标注与算法继承偏差
主集绝对 pose 由 FoundationPose 初始化。即使经过 relative edge 和 PGO,系统仍可能继承 FoundationPose 对某些纹理、对称或深度质量的偏差。用相同或相近模型在此数据上评测,存在 annotation-model affinity。
8.2 人工剔边不可忽略
明显错误的 absolute edges 由人工删除。若复现数据生成,应记录删除规则、审查人员一致性与保留比例;否则“自动标注 pipeline”的成本会被低估。
8.3 相邻帧泄漏
每条视频约 500 帧,相邻帧高度相关。训练 / 测试必须按 sequence 或 object 切分,不能随机按 frame 切分,否则 pose、背景和手部外观会泄漏。
8.4 175 个对象不等于 175 种动态条件
论文基本是一对象一主序列。对象覆盖广,但同一实例在不同背景、不同操作者、不同速度与光照下的重复采集有限。它适合研究 object diversity,不足以单独分离 acquisition condition 的方差。
8.5 mocap 验证规模
独立 marker ground truth 只有 10 条额外序列。对 benchmark 用户而言,最好把每帧 annotation confidence、被删除 absolute edge、depth support 等质量信号一并使用,而不是默认所有帧同精度。
9. 与已有数据集的区别
DynOPETs 的独特性不只是“更多帧”,而是三种任务共享同一动态域:
COPE 方法可测试类内形变与动态遮挡;
UOPE 方法可测试给定 CAD 的 novel-object generalization;
tracker 可测试长期时序、快速运动和 moving camera。
这使研究者能比较“单帧识别强”与“时序稳定强”是否一致,也能把 detector / segmentation / pose initialization / tracking 分阶段诊断。
10. 总体判断
DynOPETs 是 2026 年很有价值的动态 object pose benchmark,尤其适合作为 YCB-V、REAL275 等静态 / 短时数据的补充。最合理的使用方式是:
明确任务子集与 split;
同时报告 ATE/RPE 和 ADD(S) threshold;
对 symmetry、hand occlusion、rapid motion 分层;
把标注视为经小规模 mocap 审计的 pose-graph optimized pseudo ground truth;
若用于监督训练,做 annotation confidence filtering 与跨标注器验证。
它解决了动态域缺数据的问题,但也把一个长期值得研究的问题摆到台前:当大规模 6D pose 数据依赖强模型生成时,如何量化并防止 benchmark 继承该模型的系统偏差。