论文精读笔记:EgoXtreme: A Dataset for Robust Object Pose Estimation in Egocentric Views under Extreme Conditions
1. 核心判断
2. 一句话定位
用 15 位参与者的 Aria egocentric 视频和 mocap 6D annotations,评测模型在低光、模糊、烟雾与严重遮挡下的物体 pose 与 tracking 鲁棒性。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | Sports、Maintenance、Emergency 的困难因素有何不同? |
| Table 1 | EgoXtreme 相比 HOT3D、YCB-V、LM-O 的增量到底是什么? |
| Table 2 | Standard 与 Extreme illumination 的条件如何组合? |
| Table 3 | FoundPose、GigaPose、PicoPose 在不同条件下的退化是否一致? |
| Table 4 | deblur、dehaze、light enhancement 是否真的解决 pose 问题? |
| Table 5 | per-frame、temporal、hybrid tracking 哪一种更适合模糊视频? |
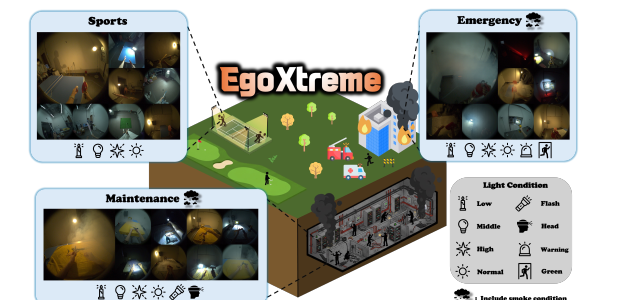 原论文图表中的相关区域:数据集覆盖 egocentric Sports、Maintenance、Emergency 场景及 low light、smoke、motion blur。来源:项目页 / CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 数据集设计
- 总规模约 1.3M frames、775.5 minutes、30 FPS;每段 sequence 约 55 seconds / 1650 frames。
- 采集设备为 Aria glasses,提供 1408×1408 fisheye RGB;参与者头部运动和手部操作保留真实 egocentric 轨迹。
- 15 位参与者,13 个物体,覆盖 3 个 scenario;照明有 normal、low、head / flash、warning、exit green、high light 等条件。
- 通过 mocap markers 追踪 headset 与 object,并用 Umeyama 对齐坐标系,获得连续 6D pose ground truth。
- 训练集约 518.8 分钟,其余划入验证 / 测试,避免将连续同一动作泄漏到评测。
4. 研究脉络与动机
- YCB-V、LINEMOD、T-LESS 等 benchmark 主要控制 clutter、texture、occlusion 或 static light,未充分覆盖 egocentric dynamic conditions。
- HOT3D 推进了 egocentric 物体理解,但仍以相对良好的照明和较温和运动为主。
- 现有 zero-shot RGB 方法在标准数据上较强,但作者发现 extreme lighting、motion blur 和 truncation 带来正交的失败模式。
5. 条件与任务
- Sports:高速挥动物体,如 baseball bat、hockey stick、pingpong / tennis racket、golf club,重点测试 motion blur。
- Maintenance:工业照明、flashlight、headlight 和局部 smoke,模拟手持工具与低光维护。
- Emergency:warning light、exit green light、high light、smoke,模拟应急救援的颜色和可见性变化。
- 任务包含单帧 pose estimation、极端条件下的 pose recall,以及以 t−1 pose 初始化的 tracking。
6. 标注与评估
- 主指标为 ADD(S) recall,在 0.1d、0.2d、0.3d 等物体直径阈值报告。
- 真实 mocap 标注让作者可以评测 6D pose,而不是只比较 2D tracking box。
- 低光、烟雾和 blur 分开统计,能够区分 illumination failure、visibility failure 与 temporal failure。
7. 实验分析
7.1 Baseline
- 对比 FoundPose、GigaPose、PicoPose 等 RGB-only zero-shot 方法;同时研究 image restoration 与 temporal tracking 策略。
- 在极端条件下,模型需要在 query crop 中同时完成 object localization、orientation 和 translation,失败不应只归因于 pose head。
7.2 主要发现
- 在 extreme light 与 smoke 下,baseline recall 显著下降;极端运动模糊是最难条件之一,常导致模型无法得到足够的特征或最小匹配数。
- 论文报告加入 smoke 后,部分模型的 0.3d recall 约下降 5 个百分点;sports 场景下 motion blur 的影响更明显。
- 传统 deblurring、dehazing 和 low-light enhancement 不能稳定改善 pose,甚至可能引入噪声;说明恢复“看起来清晰”不等于恢复几何可用特征。
- temporal tracking 能利用上一帧 pose,但如果错误初始化或出现长时间遮挡,时序先验也可能累积错误。
8. 批判性分析
- 贡献:将真实 egocentric 条件系统化,提供可重复、带高精度标注的 benchmark。
- 数据偏差:13 个物体和 15 位参与者仍不足以覆盖所有佩戴方式、肤色、头部运动和物体类别。
- 标注边界:mocap marker、headset 和 object coordinate alignment 对小物体 / 部件的精度需要特别核查。
- 算法含义:结果表明下一个瓶颈可能是 visibility-aware temporal modeling、uncertainty 和主动视线 / 头部运动,而非更强 image restoration。
9. 对我的研究的启发
- pose 方法应按 condition-aware protocol 报告,而不是只给一个平均 recall。
- 将 motion blur 视为时间积分过程,结合 event / high-speed sensor 或 continuous-time model 可能比单帧 deblur 更有效。
- egocentric pose 可与 hand-object interaction、动作意图和 gaze / head trajectory 联合建模。
10. 待解决问题
- 如何利用头部运动主动选择更可观测的下一视角?
- 如何将 object pose uncertainty 与 temporal tracker 的 re-initialization 触发连接?
- 如何从 13 个物体泛化到开放类别、细小物体和被手严重截断的目标?
11. 精读补充:EgoXtreme 把“真实困难”拆成了什么
11.1 数据集规模与采集协议
EgoXtreme 包含 775.5 分钟 egocentric RGB video,15 位参与者、Aria glasses、约 1.3M frames,30 FPS,原始 fisheye RGB 分辨率 1408×1408。目标包含 13 个物体,8 种 illumination condition,场景分为 Sports、Maintenance、Emergency;训练部分约 518.8 分钟。mocap 提供 object / headset 对齐的 pose annotations,因此可以研究连续 tracking,而不是只评测孤立图片。
它的价值在于同时出现近距离截断、手部 / 身体遮挡、头部运动 blur、低光、flash、headlight、warning light 与 smoke。与 YCB-V、LM-O 的桌面 / 固定相机分布相比,这些因素改变了 object crop 和可观测性本身。
11.2 Table 3 的基线数字
论文使用 GT bounding boxes 解耦检测误差,比较 FoundPose、GigaPose、PicoPose。几个典型结果如下(ADD(S) recall):
| 场景 | 条件 | FoundPose @0.3d | GigaPose @0.3d | PicoPose @0.3d |
|---|
| Sports | Standard | 4.72 | 24.64 | 24.61 |
| Sports | Extreme | 2.42 | 19.04 | 17.86 |
| Maintenance | Standard | 37.61 | 52.86 | 59.87 |
| Maintenance | Extreme | 30.03 | 45.52 | 52.30 |
| Emergency | Standard | 12.88 | 46.34 | 67.83 |
| Emergency | Extreme | 0.56 | 21.30 | 36.23 |
这组数字揭示了两个不同难点:Sports 的 egocentric crop + motion blur 让所有基线几乎失效;Emergency 的 extreme lighting 则使 recall 大幅坍塌。不能只用“平均下降几个点”概括。
11.3 Restoration 与 tracking 的反直觉结果
PicoPose 的 preprocessing Table 4 显示,Sports 原图 0.3d 为 23.02,deblur / dehaze / light enhancement 组合为 20.99;Maintenance 原图为 63.32,三者组合为 53.28。也就是说,图像视觉上更清晰并不保证 pose feature 更可用,串联多个 restoration 甚至会损伤几何线索。
论文指出 smoke 使部分方法在 @0.3d 下降约 5 个百分点;Sports 中 motion blur 是主要失败源,FoundPose 常因 sparse feature matching 不足而无法进入 PnP-RANSAC。时序 tracking 能改善初始化连续性,但长遮挡仍会积累错误。
11.4 作者声称与我的分析
| 作者声称 | 我的判断 |
|---|
| EgoXtreme 是更接近真实部署的 benchmark | 15 人、775.5 分钟、连续 mocap 和多条件设计支持,但 13 个 object 仍有限。 |
| 现有 zero-shot pose 对 extreme condition 不鲁棒 | Table 3 的极低 recall 很有说服力;GT bbox 协议也避免把检测失败混入结论。 |
| restoration 不是充分解决方案 | Table 4 的组合退化支持;下一步应做 condition-aware temporal / event model。 |
12. 复现与数据审计
记录 headset intrinsics、fisheye distortion、mocap-to-object calibration、condition 标签和 video split。建议报告参与者留一、物体留一、场景留一三种划分,并把 no pose output 单独计为失败。对机器人 / AR 应用,pose uncertainty 应驱动重新初始化、头部主动移动或请求下一帧,而不是让 tracker 静默漂移。
