Reading Notes
粗读 / 精读
已生成 src/paper-notes/environment-agnostic-pose-iccv2025/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:Environment-Agnostic Pose: Generating Environment-independent Object Representations for 6D Pose Estimation
1. 基本信息
- 年份 / 会议:2025 / ICCV;阅读模式:粗读。
- 任务:环境变化下的 RGB 6D object pose estimation。
- 原文:ICCV Open Access;代码:EA6D。
2. 一句话定位
EA6D 先学“纯对象图像”的 latent representation,再用 Environment Decoupling Diffusion Model 从带背景、光照和遮挡的输入中生成该环境无关表示,最后解码 6D pose。
2.1 论文图表导读
| 图表 | 看点 |
|---|---|
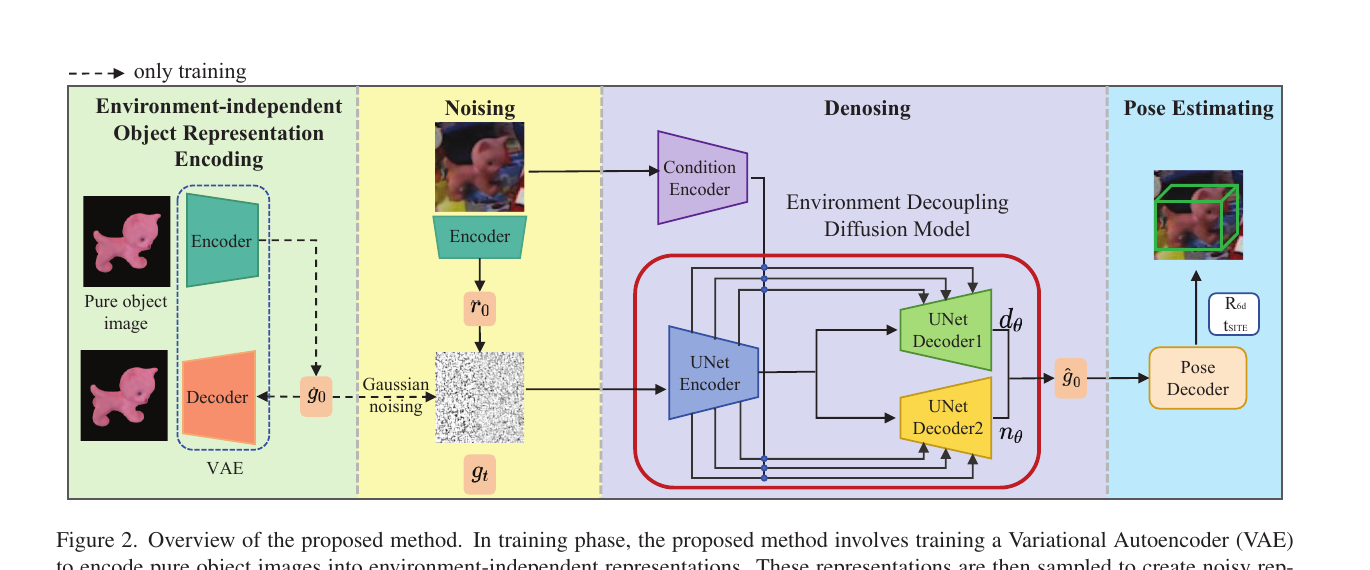
| Figure 2 | VAE object representation、noising、双 decoder EDDM 与 pose decoder 的训练/测试路径。 |
3. 方法概览
- VAE 以纯对象图像编码 ,作为与环境因素分离的学习目标。
- EDDM 通过一套 U-Net encoder 与两个 decoder,在 input-image prior 与 latent noising 下恢复目标对象表示;随后 pose decoder 回归 rotation 与 translation。
- 论文强调 few-step sampling,训练主要使用合成数据,并通过 DiverseScenes 补充更复杂环境测试。
4. 实验概览
- 数据集:LINEMOD、Occlusion LINEMOD、其他标准 6D pose 基准以及自建 DiverseScenes。
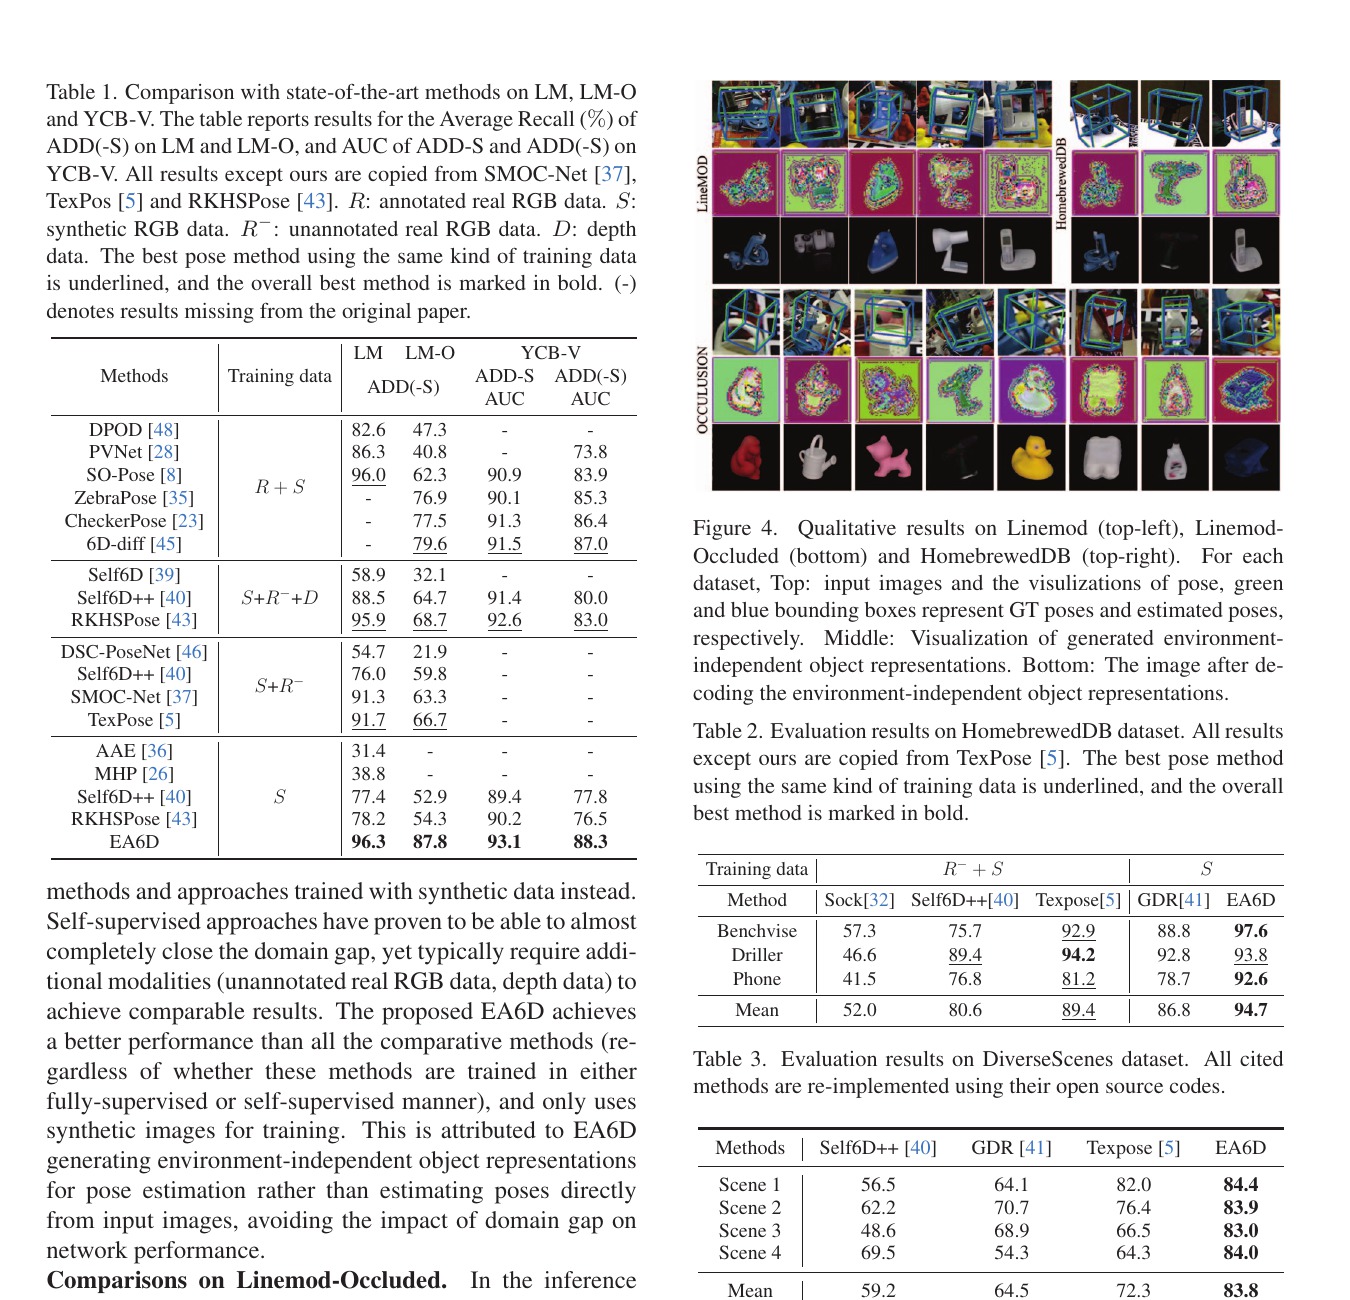
- 作者声称:仅合成训练时,在 LINEMOD / Occlusion LINEMOD 的公平对比下较此前方法提高 18.1% / 33.5%。
- 我的分析:将 domain gap 变成“生成不含环境的 representation”比直接 style transfer 更明确;但纯对象图像监督和是否能覆盖透明/镜面/极端遮挡,决定了其泛化边界。
5. 优缺点与启发
- 优点:环境因素被作为显式 nuisance variable 处理;few-step diffusion 关注实用速度。
- 风险:仍需实例级训练、mask/crop 与合成数据;不是无 CAD、无标注的通用方案。
- 启发:可学习 pose-invariant / environment-invariant latent,再把几何解码头和生成过程分开评估。