论文精读笔记:Event6D: Event-based Novel Object 6D Pose Tracking
1. 核心判断
- 论文:CVF Open Access
- 项目 / 数据:Event6D
- 核心判断:Event6D 的关键不是把 events 简单堆成一张图,而是用事件的高时间分辨率补齐低频 depth 之间的几何和光度观测,再让 pose tracker 在这些中间时间戳工作。
2. 一句话定位
EventTrack6D 以 sparse events 为条件,在相邻 depth frames 之间重建 intensity/depth,随后用 CAD render-and-compare 在 120 FPS 时间轴上追踪未知物体 pose。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | dual reconstruction 如何克服 RGB-D 30 FPS 的时间间隔? |
| Table 1 | 新数据集是否同时覆盖规模、物体数量、运动速度和真实事件? |
| Figure 2 | event encoder、reconstruction 和 pose refiner 的数据流是什么? |
| Table 2 / 3 | 120 FPS 和 30 FPS 下,EventTrack6D 相比 RGB-D baseline 的优势是否一致? |
| Table 5 | 只重建 image、只重建 depth、双模态三种设置差异是什么? |
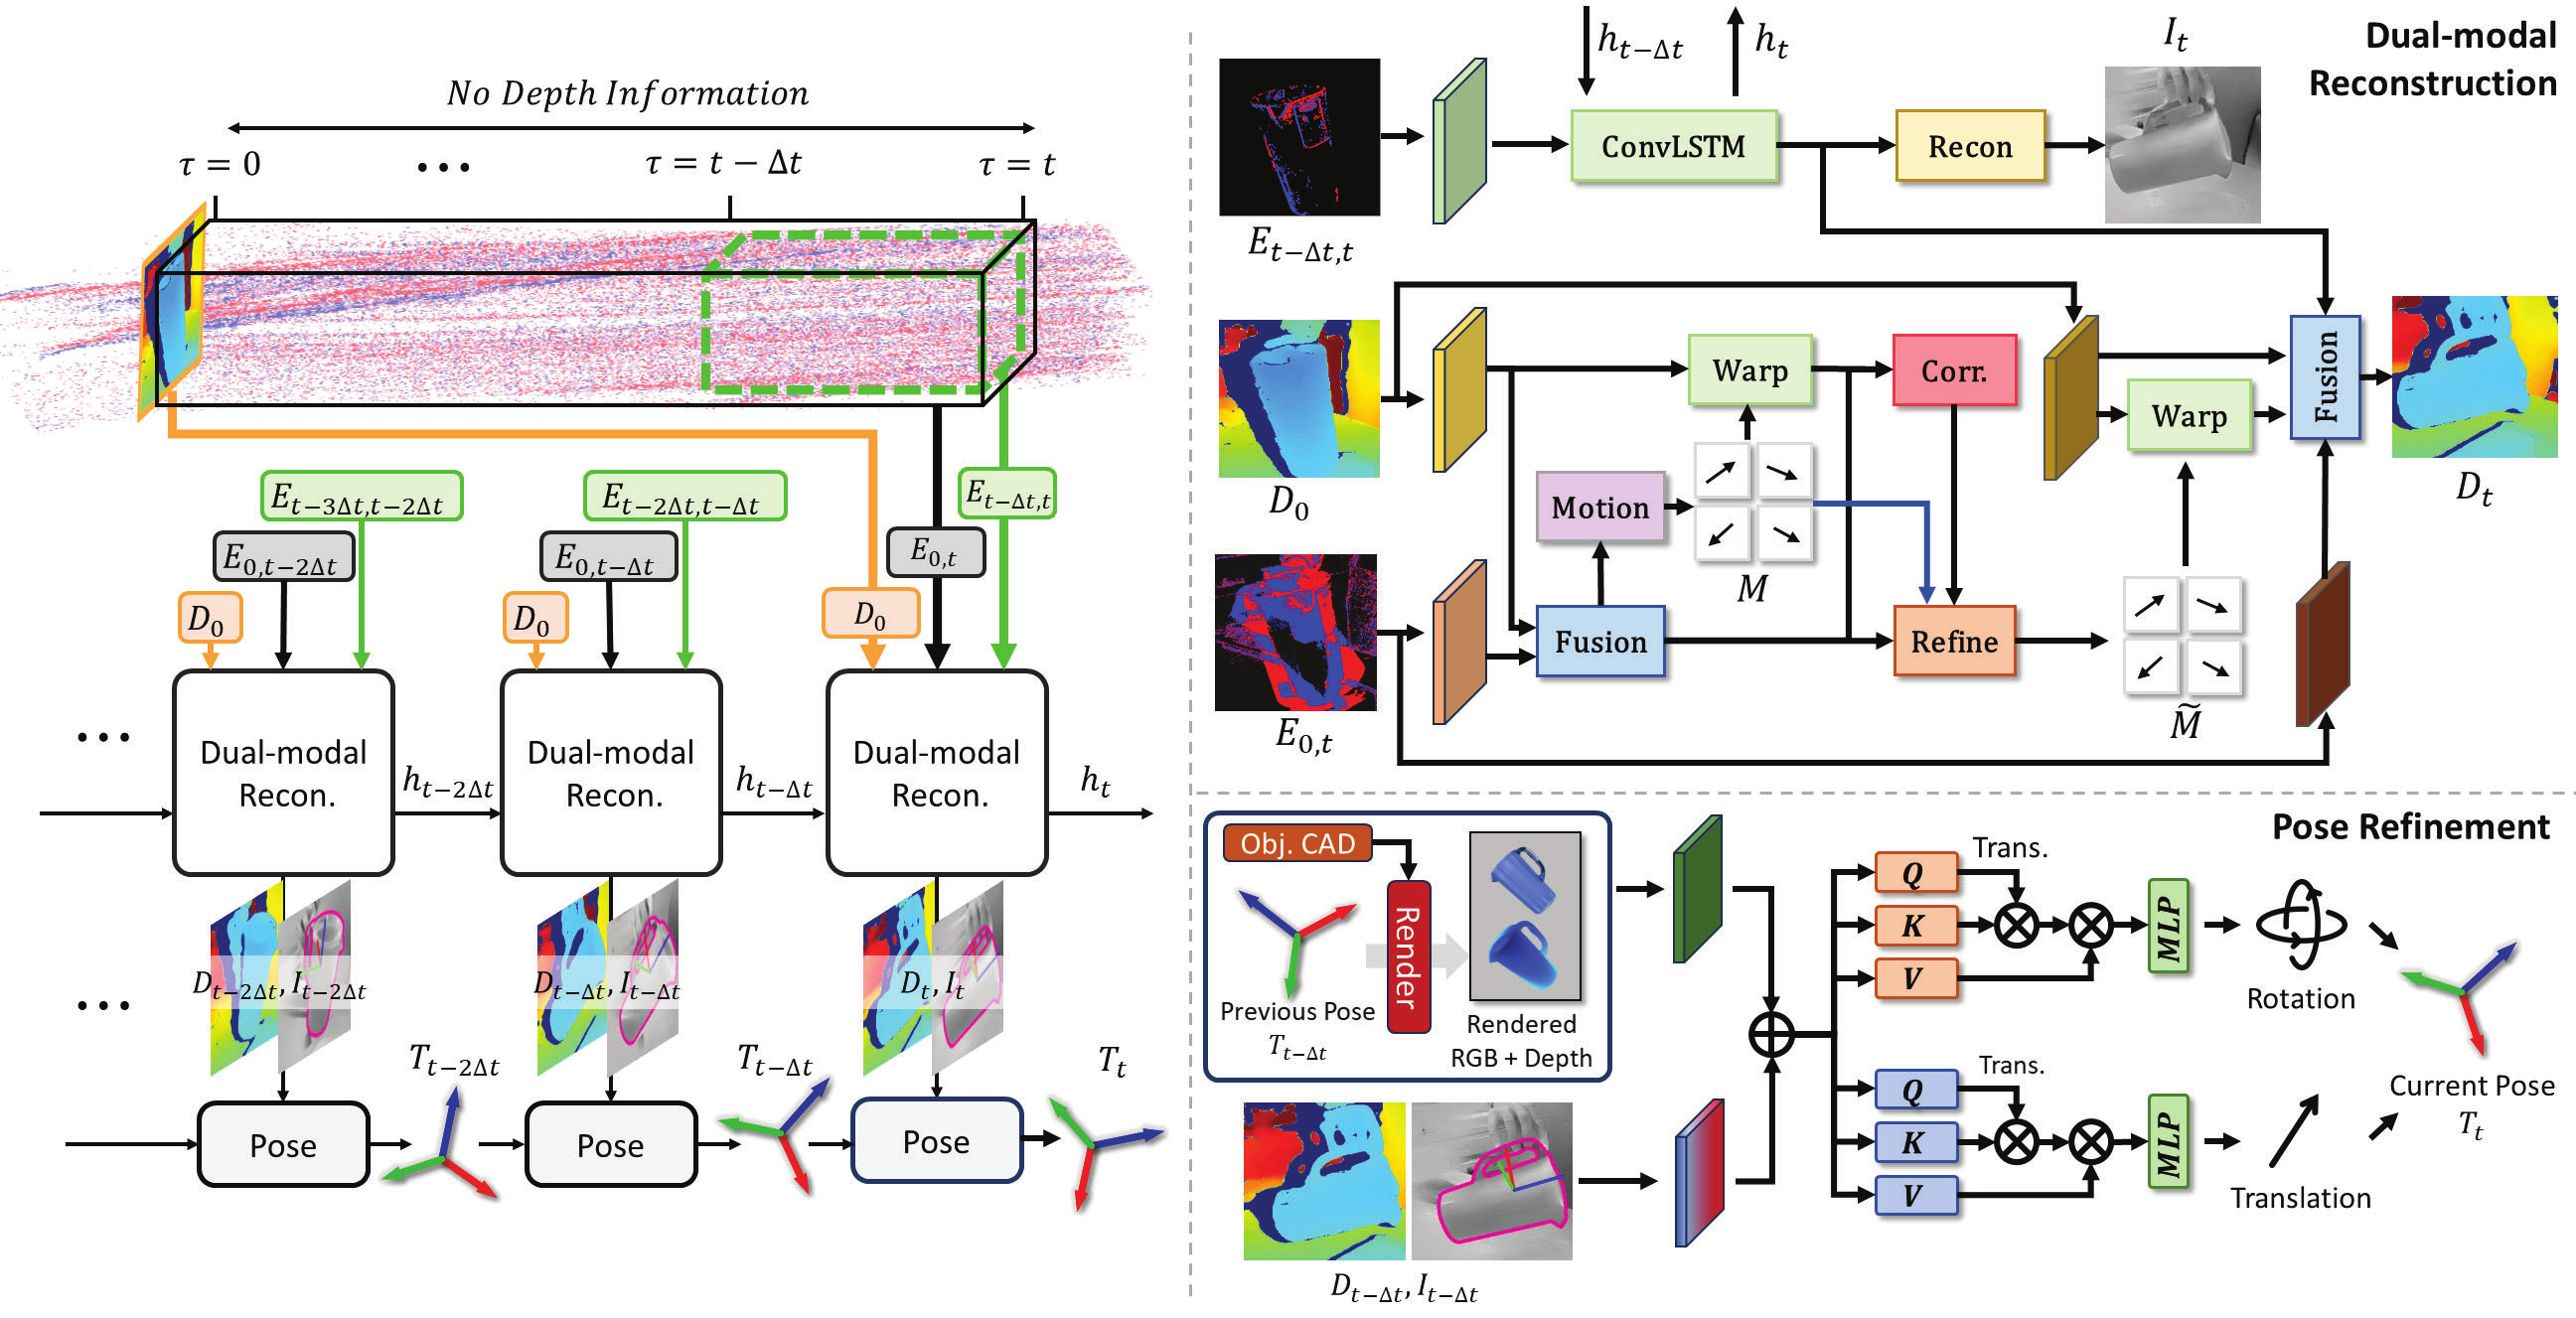 原论文图表中的相关区域:普通 RGB-D 在高速运动下受到低帧率限制,EventTrack6D 用事件流重建中间时间戳的 image 与 depth。来源:项目页 / CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 事件相机异步输出像素亮度变化,RGB-D 只在较低频率提供完整帧。
- Event6D 的真实数据使用 120 Hz motion-capture pose ground truth;RGB / depth 仍以 30 FPS 记录,正好形成事件补帧问题。
- 训练只使用 EventBlender6D 合成数据,Event6D 和 EventHO3D 中的评测物体与训练物体分离,测试 novel-object generalization。
- 初始 frame 需要给出 pose,后续不再依赖未来 RGB / depth;这使系统更接近在线 tracking 而不是离线视频估计。
4. 研究脉络
- 传统 RGB-D tracker 受 30 FPS、motion blur 和大位移影响;event camera 提供 microsecond temporal resolution 和高动态范围。
- 早期 event-based pose 数据集物体少、运动慢,或 pose annotation 仍依赖低频 RGB-D 方法。
- Event6D 同时补足模型、数据和任务:dual reconstruction、novel-object tracking、synthetic-to-real benchmark。
5. 研究动机
- 高速运动时,相邻 RGB-D 帧之间的物体位姿变化可能远超普通 tracker 的搜索范围。
- events 稀疏但时间精确,缺少完整光度和深度;需要与历史 depth 联合解释。
- 仅把 events 转成普通灰度图会丢掉时间信息,也无法直接得到深度。
- 所以作者设计 dual-modal reconstruction,再将其接到成熟的 render-and-compare pose refinement。
6. 方法详解
6.1 Event-conditioned reconstruction
- 事件包含像素位置、时间戳和 polarity,网络从一段事件窗口提取运动与亮度变化。
- 以最近可用 depth frame 为条件,预测当前任意时间戳的 intensity map 和 depth map。
- depth reconstruction 提供几何,intensity reconstruction 提供外观和边缘,二者分别用 L1 / photometric objective 监督。
- 方法不使用未来帧,符合在线 tracking 的因果性。
6.2 Pose refinement
- 将重建的 RGB-like / depth-like patch 与 CAD surface 的渲染结果比较。
- 当前 pose 通过 refinement operator 更新,输出下一时刻 pose。
- 由于中间帧现在有 dense photometric / geometric cue,tracker 不需要等下一张完整 depth。
6.3 数据集设计
- EventBlender6D 使用 Google Scanned Objects、BlenderProc 和 event simulator,提供 495,840 个样本、1033 个物体。
- EventHO3D 将 event simulation 与 HO3D 运动结合,提供 103,462 个样本、5 个物体。
- Event6D 真实数据包含 54,556 个样本、14 个物体,使用 motion capture 生成 120 Hz pose annotation,并引入扫描得到的新物体 CAD。
7. 实验分析
7.1 设置与指标
- 120 FPS setting:RGB-D 只有 30 FPS,事件方法在中间帧上评测;30 FPS setting:在完整 RGB / depth 时间点比较更多 baseline。
- 指标包括 ADD / ADD-S AUC、Average Recall、VSD、MSSD、MSPD 和 runtime FPS。
- 评测物体对训练物体 unseen,验证 synthetic-only training 的泛化。
7.2 主结果
- EventTrack6D 在 Event6D 120 FPS 评测中达到超过 120 FPS 的 TensorRT runtime;未经优化约 50 FPS,优化后约 128 FPS。
- RGB / RGB-D baseline 在 120 FPS 中间帧无法获得新 depth,面对快速运动出现大位移和跟踪不稳定;EventTrack6D 能维持时间连续性。
- 在 EventHO3D 上,尽管运动分布与传感器设置不同,synthetic-only 训练仍保持较好泛化,支持数据设计的跨域价值。
7.3 消融
- 只使用历史 depth、不重建 intensity 和 depth,会丢失中间时间戳的 dense cues。
- 只重建单一模态会降低 pose refinement,双模态 reconstruction 在快速运动下更稳。
- 更长 / 更合适的 event window 能提高信息量,但也可能带来运动混叠,需要按速度调节。
8. 批判性分析
- 优势:任务、数据和系统速度对高速机器人非常有价值;评测明确区分 120 / 30 FPS。
- 同步问题:event、RGB、depth、motion capture 的时间校准误差会直接变成 pose label noise。
- CAD 依赖:虽然是 novel object tracking,但仍需要物体 CAD / reference representation;与完全 model-free event pose 不同。
- 分布风险:EventBlender6D 的事件噪声模型、曝光和运动轨迹与真实相机不完全一致,仍需更多真实训练或自适应。
9. 对我的研究的启发
- 可将事件流看成高频 pose evidence,与低频深度 / 多视角几何做异步融合。
- pose tracker 可以输出连续时间 uncertainty,决定何时请求下一张深度帧。
- 对机器人抓取,可把 event-based tracking 与主动减速 / regrasp 策略连接起来。
10. 待解决问题
- 如何在没有 CAD、只有少量 RGB-D reference 的情况下做 event novel-object tracking?
- 如何利用 event timestamp 做 continuous-time SE(3) motion model,而非逐帧 refinement?
- 如何对传感器时间偏差、事件噪声和遮挡同时建模?
11. 精读补充:从事件流到 120 Hz pose
11.1 数据统计
| 数据集 | 样本 | 物体 | 分辨率 | 时间特性 |
|---|
| EventBlender6D | 495,840 | 1,033 | — | dynamic synthetic |
| EventHO3D | 103,462 | 5 | 640×480 | moderate motion |
| Event6D | 54,556 | 14 | 1280×720 | real, 120 Hz, dynamic |
EventBlender6D 负责大规模训练,EventHO3D 检查跨运动 / 传感器域泛化,Event6D 才是高速真实评测。RGB / depth 只有 30 FPS,而事件流异步到达;因此 120 FPS table 不能用普通 RGB-D baseline 直接公平比较。
11.2 120 FPS 的主结果
EventTrack6D 在 Event6D 120 FPS setting 的平均 ADD-S / ADD / AR 为 52.79 / 25.26 / 64.38,运行速度约 50.19 FPS(TensorRT 128.04 FPS)。对比 E2VID+MG 的 6.78 / 2.12 / 9.02、E2VID+FP 的 37.24 / 16.97 / 48.72、ETAP 的 7.77 / 2.22 / 11.42、event-trained FP 的 22.93 / 4.31 / 25.72,提升非常明显。
EventHO3D 上平均 ADD-S / ADD / AR 为 64.75 / 50.95 / 66.27;E2VID+FP 为 57.10 / 41.13 / 56.77,event-trained FP 为 35.31 / 8.83 / 27.64。跨数据集的结果说明它不是只在 Event6D 的运动轨迹上拟合。
11.3 双模态 reconstruction 消融
| Depth reconstruction | Image reconstruction | ADD-S | ADD | AR |
|---|
| ✗ | ✗ | 18.45 | 3.29 | 20.07 |
| ✓ | ✗ | 28.67 | 4.75 | 29.08 |
| ✗ | ✓ | 30.53 | 13.79 | 44.99 |
| ✓ | ✓ | 52.79 | 25.26 | 64.38 |
这个消融说明 image reconstruction 对外观与纹理证据很重要,depth reconstruction 提供几何结构,二者联合有明显互补。Table 6 还显示仅事件 motion vector 为 42.26 / 19.32 / 48.99,仅 image feature 为 41.88 / 17.61 / 50.54,二者同时用回到完整的 52.79 / 25.26 / 64.38。
11.4 作者声称与我的分析
| 作者声称 | 我的判断 |
|---|
| 事件流让 pose tracking 进入高时间分辨率 | 120 Hz ground truth、128.04 FPS TensorRT 和速度对比支持。 |
| 双模态重建解决深度帧之间的几何缺失 | ablation 的 AR 20.07→64.38 是强证据。 |
| 可泛化到真实高速物体 | EventHO3D / Event6D 支持,但真实训练规模仍小于合成,时间同步和事件噪声是关键风险。 |
12. 复现清单
记录 event window、timestamp、depth 到 event 的外参 / 时间偏差、160×160 ROI、CAD render 参数、TensorRT 是否开启。评测时分开 30 FPS 与 120 FPS,保存中间 reconstructed intensity / depth 和 pose residual。对没有 CAD 的 novel object,未来需要把 EventTrack6D 的 render-and-compare 替换为 reference-based representation。
