论文精读笔记:Implicit Coarse-to-Fine 3D Perception for Category-Level Object Pose Estimation from Monocular RGB Image
1. 阅读结论与证据等级
FAP-Net 是一篇面向单目 RGB、类别级、端到端 pose + size estimation 的工作。它不在推理时引入 depth,而是在训练时通过 geometry supervision 迫使网络先获得 coarse 3D perception,再以 pose / size constraints 完成细化。作者摘要给出的 REAL275 提升和 42 FPS 表明,这条路线同时追求 metric reasoning 与实时部署。
需要先说明证据边界:IEEE 页面当前没有无登录开放全文,未发现作者公开稿或可用代码。因此本页的“论文事实”只来自 DOI 元数据与作者公开摘要;关于单目投影、指标和复现风险的部分是本站分析,不冒充论文公式、网络层或消融结论。
| 内容 | 证据状态 |
|---|
| 单张 RGB、category-level、端到端 | 作者摘要明确 |
| coarse-to-fine、geometry supervision | 作者摘要明确 |
| pose / size constraints 用于 refinement | 作者摘要明确 |
| CAMERA25、REAL275、两项提升、42 FPS | 作者摘要明确 |
| 具体 backbone / geometry target / loss | 公开摘要未披露 |
| absolute scores / 完整 baseline / 硬件 | 公开摘要未披露 |
| 输入是否使用 GT mask / detector crop | 公开摘要未披露 |
2. 为什么单目类别级 pose 特别难?
类别级任务要求模型面对训练时未见过的同类实例,例如训练用若干瓶子,测试时估计另一个形状、比例和纹理均不同的瓶子。除了普通 6DoF 旋转和平移,还常要恢复对象的 metric size。
透视投影可写为:
u~∼K(RX+t).
当三维对象整体尺度与深度按近似相同比例变化时,它在图像中的投影大小可能接近。也就是说,单张 RGB 中存在典型的 scale–depth ambiguity:
z1s1≈z2s2⇒similar image extent.
RGB 外观可以帮助识别类别、轮廓和可见表面,但不能天然提供绝对米制尺度。类别内部形状变化又使“记住一个平均 CAD”失效。因此,网络若直接从全局 appearance feature 回归 (R,t,s),很可能学习背景、纹理或图像框尺寸等数据集捷径。
FAP-Net 的标题与摘要都把问题归因于“缺少 3D information 导致 translation / size ambiguity”,其方法选择则是:不在测试时增加深度传感器,而在表示学习阶段注入几何约束。
3. 可核验的方法结构
3.1 Stage 1:geometry-supervised coarse perception
摘要原意是先借助 geometry supervision 促进 coarse 3D feature perception。这至少意味着训练目标不只包含最终 pose 误差,还存在某种能约束三维结构的辅助信号。
但当前公开材料没有告诉我们这个信号具体是什么。可能的技术家族包括 pseudo-depth、NOCS coordinate、surface normal、shape prior 或它们的组合;这些都是领域中常见选择,却不能据此断言 FAP-Net 采用其中某一种。本页只保留更高层、可核验的结论:中间特征被要求携带几何信息。
3.2 Stage 2:pose / size constrained refinement
第二阶段根据 pose 与 size constraints 细化粗特征。这种设计把约束分成两层:
- 几何监督解决“特征有没有三维意识”;
- pose / size 约束解决“这些三维线索是否服务于最终度量任务”。
它比把所有目标一次性压到单个回归头更有 coarse-to-fine 味道。第一阶段提供较稳定的三维结构底座,第二阶段再对与位姿和尺寸最相关的方向进行任务化修正。
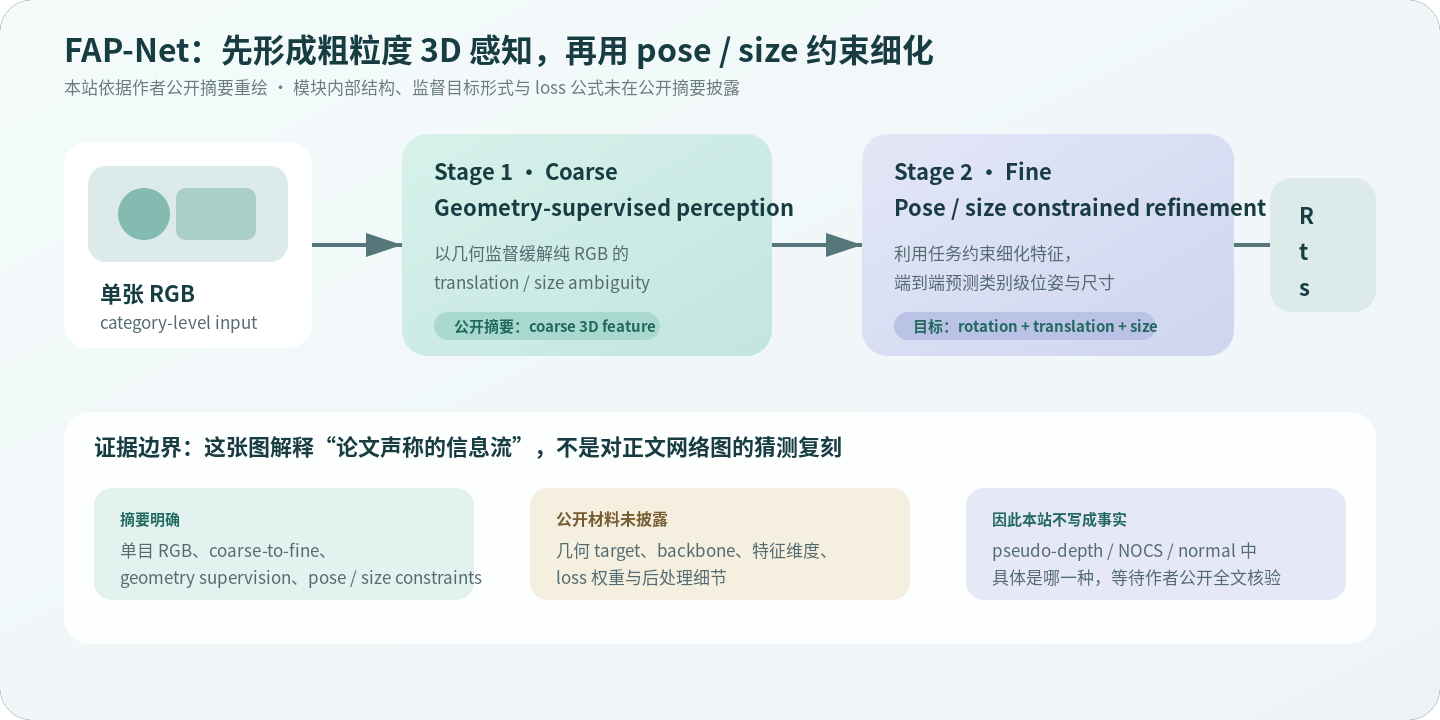 本站依据作者公开摘要重绘,非论文原图。图中特别区分“摘要明确”与“公开材料未披露”,避免把领域常见模块误写成 FAP-Net 的事实。论文内容版权归原作者;重绘仅用于学术解读。来源:FAP-Net, ICRA 2024。
3.3 End-to-end 的准确含义
摘要称方法为 end-to-end,能够从单张 RGB 直接完成类别级 pose estimation。这里可以确认“最终预测由统一网络产生”,但不能推断:
- 是否有外部 detector / segmenter 提供 object crop;
- 网络内部是否显式求解 Umeyama / PnP;
- 尺寸是各轴独立回归、统一 scale 还是 3D box;
- 推理图中是否包含任何不可微后处理。
这些差别会直接影响“端到端”和“42 FPS”的工程口径,必须等待正文核验。
4. 实验与数字
论文在 CAMERA25 与 REAL275 上实验。这两个 split 属于 NOCS 体系:
- CAMERA25 主要由合成图像构成;
- REAL275 是更能反映 sim-to-real 与真实遮挡 / 外观变化的测试集。
作者摘要重点报告 REAL275:
| 指标 | 相对当时 SOTA 的提升 |
|---|
| 10°10cm | +14.7 percentage points |
| IoU50 | +11.4 percentage points |
| 推理速度 | 42 FPS |
4.1 为什么两项提升要一起看?
10°10cm 只要旋转误差小于 10°且平移误差小于 10 cm 就计为成功;它不直接要求尺寸准确。3D IoU50 则比较带尺寸的三维框重叠,对中心、姿态和尺度都敏感。
如果只有 10°10cm 提升,可能只是 pose regression 更强;如果只有 IoU50 提升,也可能是尺寸先验更合适。两者同时提升,至少与作者“coarse geometry + pose / size refinement”的设计目标相符。
4.2 提升量不是绝对分数
“+14.7”和“+11.4”是相对某个当时 SOTA baseline 的百分点差,不是 FAP-Net 本身的 14.7% / 11.4%。缺少正文表格时,不能反推出:
FAP score=unknown baseline score+reported gain.
也不能确定两个提升是否相对于同一个 baseline、相同输入协议或相同训练数据。因此本站图表只画“作者报告的 gain”,不画虚构的完整排行榜。
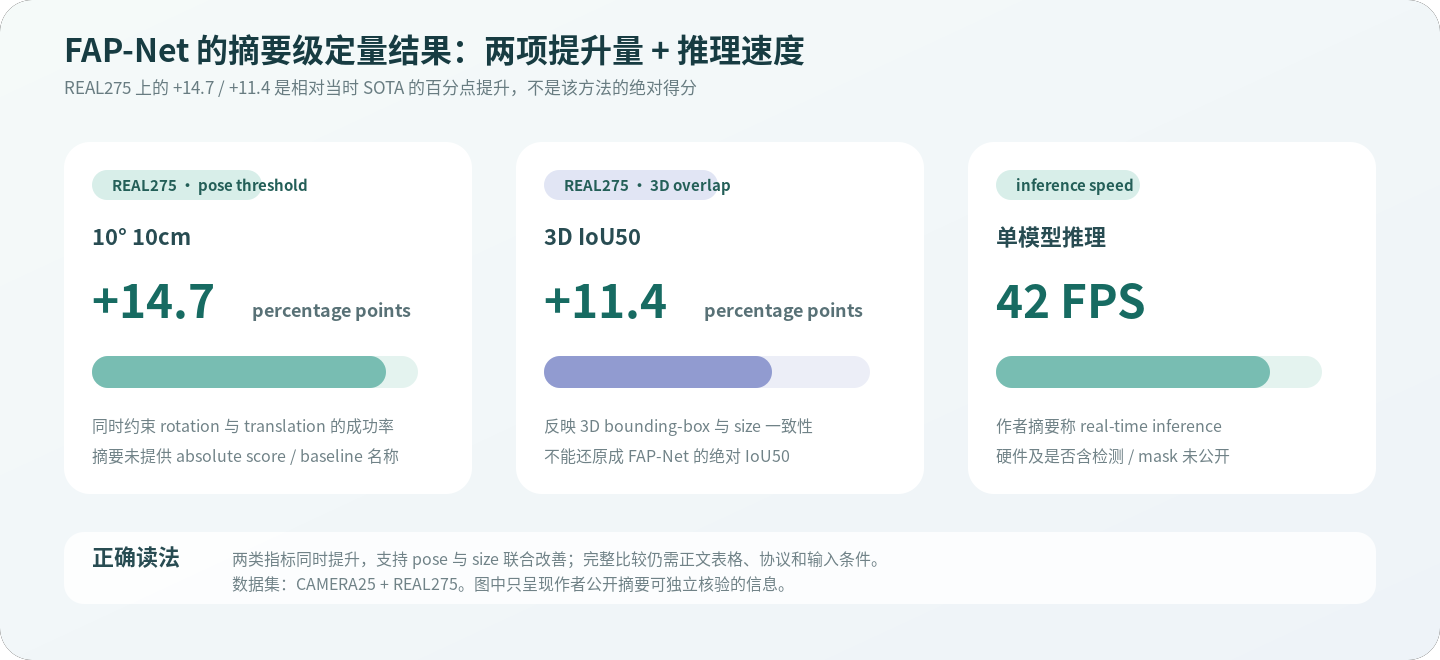 本站根据作者公开摘要重绘。+14.7 / +11.4 是百分点提升;42 FPS 的硬件、batch size,以及是否包含 detection / segmentation 均未在摘要披露。来源:FAP-Net, ICRA 2024。
5. 与相邻技术路线的关系
5.1 显式 canonical correspondence
NOCS 类方法预测每个像素或点的 canonical coordinates,再把观测几何与 canonical shape 对齐。优点是几何链路清楚,缺点是 correspondence、深度质量和实例形变都会传递误差。
5.2 RGB → pseudo-depth / shape reconstruction
另一类方法先从 RGB 恢复对象深度、点云或形状,再做几何对齐。它把单目歧义显式化,便于可视化,但重建误差可能成为 pose 的瓶颈。
5.3 FAP-Net 的隐式几何特征
FAP-Net 的公开定位更接近“用辅助几何监督塑造 feature,再由任务约束细化”。它可能避免完整三维重建的成本,并保持 42 FPS;代价是几何含义更隐式,跨域失败时较难判断是 geometry perception、pose head 还是 size head 出错。
这里的“可能”是方法层面的合理分析,不是未公开消融的替代品。
6. 结果的合理解释与不可外推项
可以合理支持
- 训练时几何监督对 RGB-only 类别级 pose 有显著价值;
- pose threshold 与 3D overlap 同时改善,说明提升不只集中于单一输出;
- 42 FPS 表明作者至少在其测试实现中达到实时级单模型推理。
当前不能支持
- 不能说 FAP-Net 在 REAL275 上的 absolute score 是多少;
- 不能说它比所有后续方法更强,因为摘要只比较论文当时基线;
- 不能确定 42 FPS 是 end-to-end system throughput;
- 不能确定对称物体、严重遮挡、透明 / 反光物体的优势;
- 不能从“geometry supervision”猜出具体的 depth / NOCS / normal target。
7. 潜在失败模式
以下是依据任务设定得到的复现风险分析,而非论文报告的 failure cases:
- 尺度先验偏差:真实对象尺寸分布超出训练类别统计时,单目 metric scale 仍可能失真。
- 遮挡:可见轮廓和表面减少后,coarse 3D feature 的约束变弱。
- 对称性:外观与几何都对称时,单点 rotation regression 容易在等价姿态间被惩罚。
- 域偏移:CAMERA25 的合成纹理、背景和照明若被网络当成捷径,REAL275 或新相机上的性能会下降。
- crop / mask 依赖:若训练与评测使用高质量裁剪,而部署检测框抖动,translation / size 可能一起漂移。
- 相机内参与画幅变化:以图像尺度隐式推断深度时,焦距或 resize protocol 的变化尤其危险。
8. 复现与公平比较清单
取得正文或代码后,应优先补齐以下信息:
- geometry supervision 的 target、来源和单位;
- coarse 与 fine 阶段的输入输出张量、连接方式和 loss;
- rotation representation、symmetry handling 与 size parameterization;
- CAMERA25 / REAL275 的训练 split、synthetic-to-real 策略;
- 输入使用 GT mask、predicted mask、GT box 还是 detector box;
- 所有 absolute scores、每类别结果及消融;
- 42 FPS 的 GPU、batch size、输入分辨率和计时边界;
- 参数量、显存、检测 / 分割是否单独计时;
- inference 时是否需要 camera intrinsics。
只有这些信息齐全,才可以和 DMSR、OLD-Net、NOCS 系列进行同协议比较。
9. 研究启发
FAP-Net 的高层思想值得保留:先让特征对三维结构负责,再让它对最终任务负责。 后续可以沿几个方向增强:
- 把 coarse geometry 从点估计改成带 uncertainty 的 depth / coordinate distribution;
- 在 pose / size refinement 中显式传播几何不确定性,避免错误粗特征被过度放大;
- 对 symmetry 使用等价姿态集合或分布式 rotation loss;
- 用相机内参归一化图像尺度,减少焦距变化被误当成对象深度;
- 分别报告 detector、geometry、pose、size 的误差,建立可诊断的 pipeline。
在当前公开证据下,FAP-Net 最适合被理解为 2024 年单目 category-level pose 的一个趋势信号:研究重点从“纯外观直接回归”转向“训练期注入几何、测试期保持 RGB-only 与实时性”。至于其具体网络创新和完整 SOTA 地位,仍应等待作者公开全文或代码后再作技术级复现判断。
