论文精读笔记:GCE-Pose: Global Context Enhancement for Category-level Object Pose Estimation
1. 核心判断
- 论文:CVF Open Access
- 关键问题:部分可见 RGB-D 只能提供 local feature;类别级 pose 却需要知道被遮挡部分的整体语义形状,直接从 partial observation 预测 NOCS 会缺少全局 context。
- 核心回答:用 Semantic Shape Reconstruction (SSR) 先补齐 global semantic geometry,再以 GCE fusion 汇聚 global 与 local feature。
2. 一句话定位
GCE-Pose 的 first-complete-then-aggregate 将“类别先验补全”与“实例观测 pose”区分开,使 global context 不再只是一个附加 feature。
2.1 论文图表导读
| 图表 | 应该看什么 |
|---|
| Figure 1–2 | 传统 partial-feature pipeline 与 SSR + GCE fusion 的差异,尤其是 reconstructed global feature 的进入位置。 |
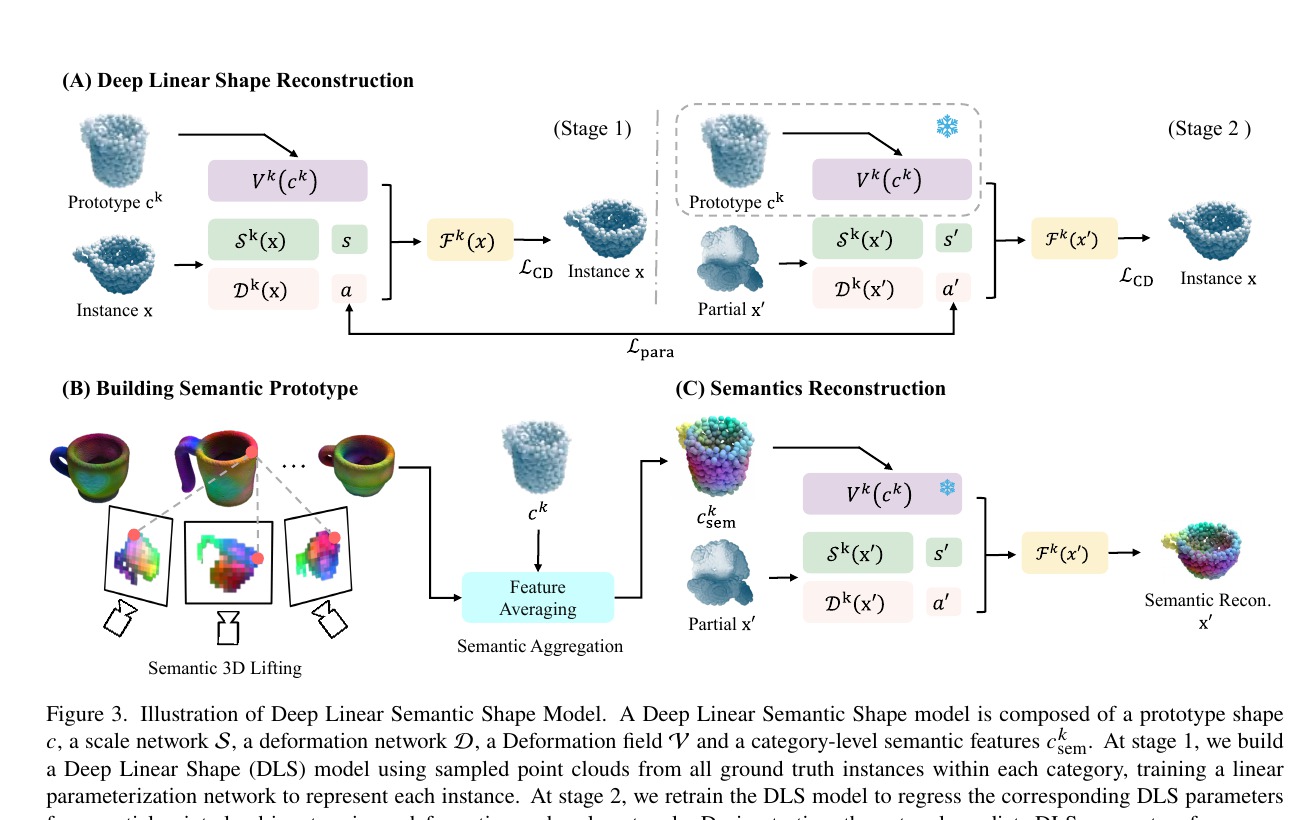
| Figure 3 | deep linear semantic shape model 如何由 prototype 和实例 deformation 组成。 |
| Table 1 | HouseCat6D 与 NOCS-REAL275 的 pose / 3D IoU 指标和 prior 条件。 |
| Table 2–3 / Figure 5 | global prior 和 key/value fusion 的因果贡献,以及补全结果是否合理。 |
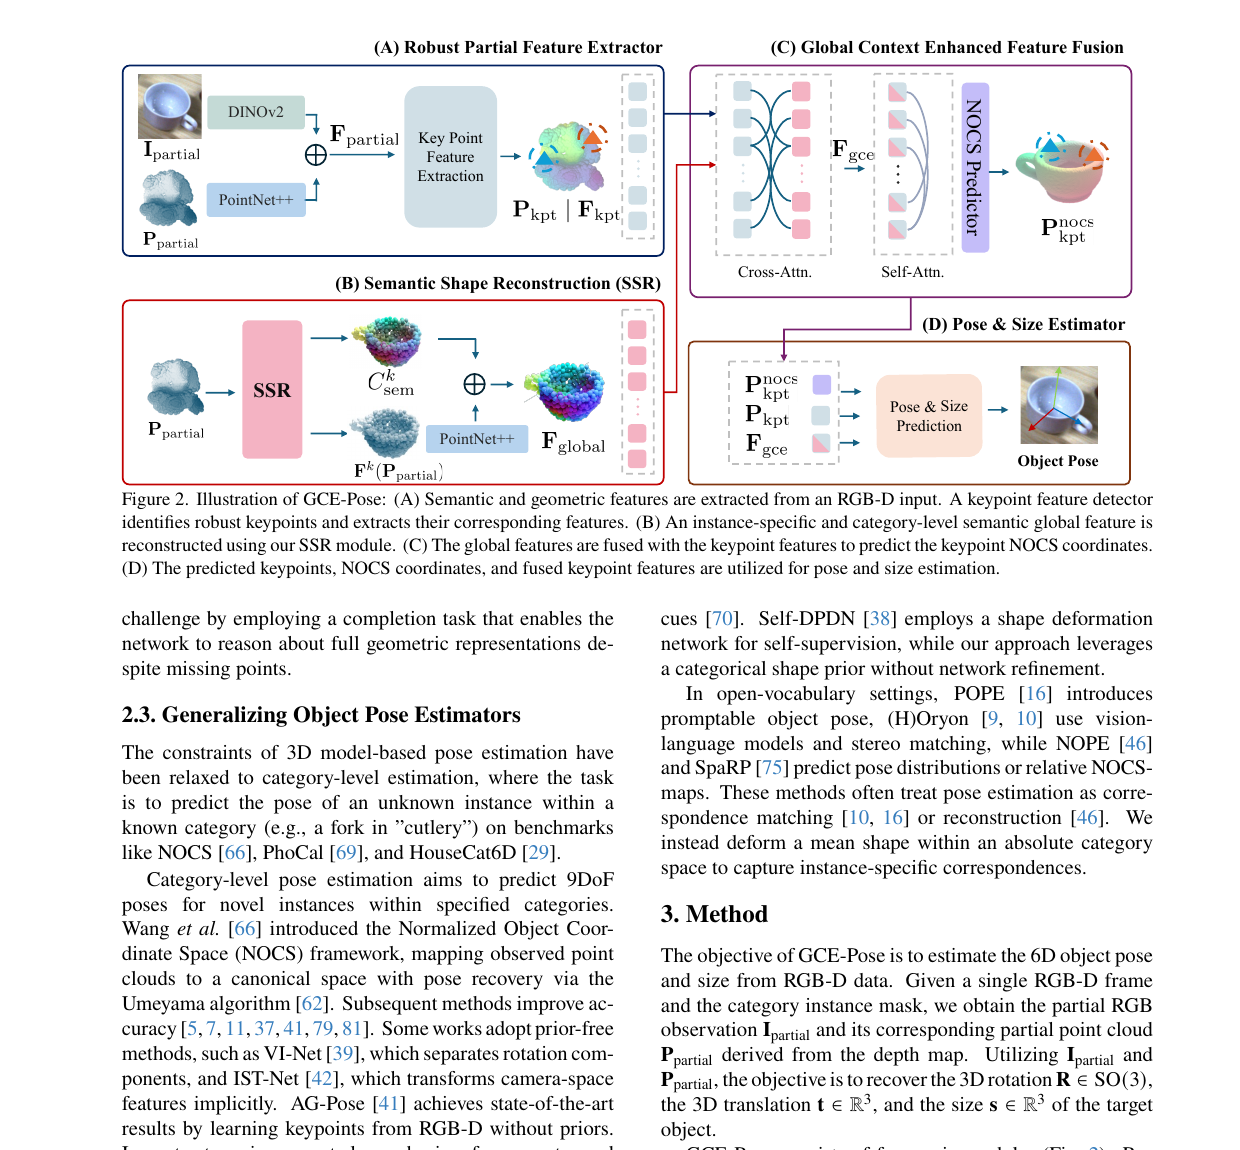 原论文方法图区域:GCE-Pose 从 partial RGB-D 重建类别语义 shape,并将全局上下文与局部观测特征融合后预测 pose。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- 输入为部分可见 RGB-D object instance;输出类别内未见实例的 NOCS / pose。
- 不需要每个测试实例的 CAD,但预训练的 category semantic prototype 和 deformation prior 是强先验。
- 方法的“全局”指对象级全局 shape context,不是场景级 multi-object context。
4. 方法详解
- SSR:从 partial observation 提取语义 / 几何 feature,以 Deep Linear Semantic Shape Model deform category-specific prototype,重建全局 instance shape。
- GCE fusion:用重建的 global semantic context 与 partial local feature 融合;论文比较 key token 与 value token 作为聚合载体。
- Pose:增强后的 feature 预测 NOCS,后续通过 pose solver 恢复类别级 pose。
5. 实验分析
| HouseCat6D | 5°2cm | 5°5cm | 10°5cm | IoU75 |
|---|
| AG-Pose | 11.5 | 12.0 | 35.8 | 45.0 |
| AG-Pose(DINO) | 21.3 | 22.1 | 54.3 | 53.0 |
| GCE-Pose | 24.8 | 25.7 | 58.4 | 60.6 |
替换 DINOv2 backbone 本身已带来很大增益,因此严谨读法应以 AG-Pose(DINO)为同骨干基线:GCE-Pose 在 5°2cm 上增加 3.5、IoU75 增加 7.6。后者提升更明显,说明完整形状先验不仅改善旋转–平移,还改善类别实例的尺度与 3D 框贴合。
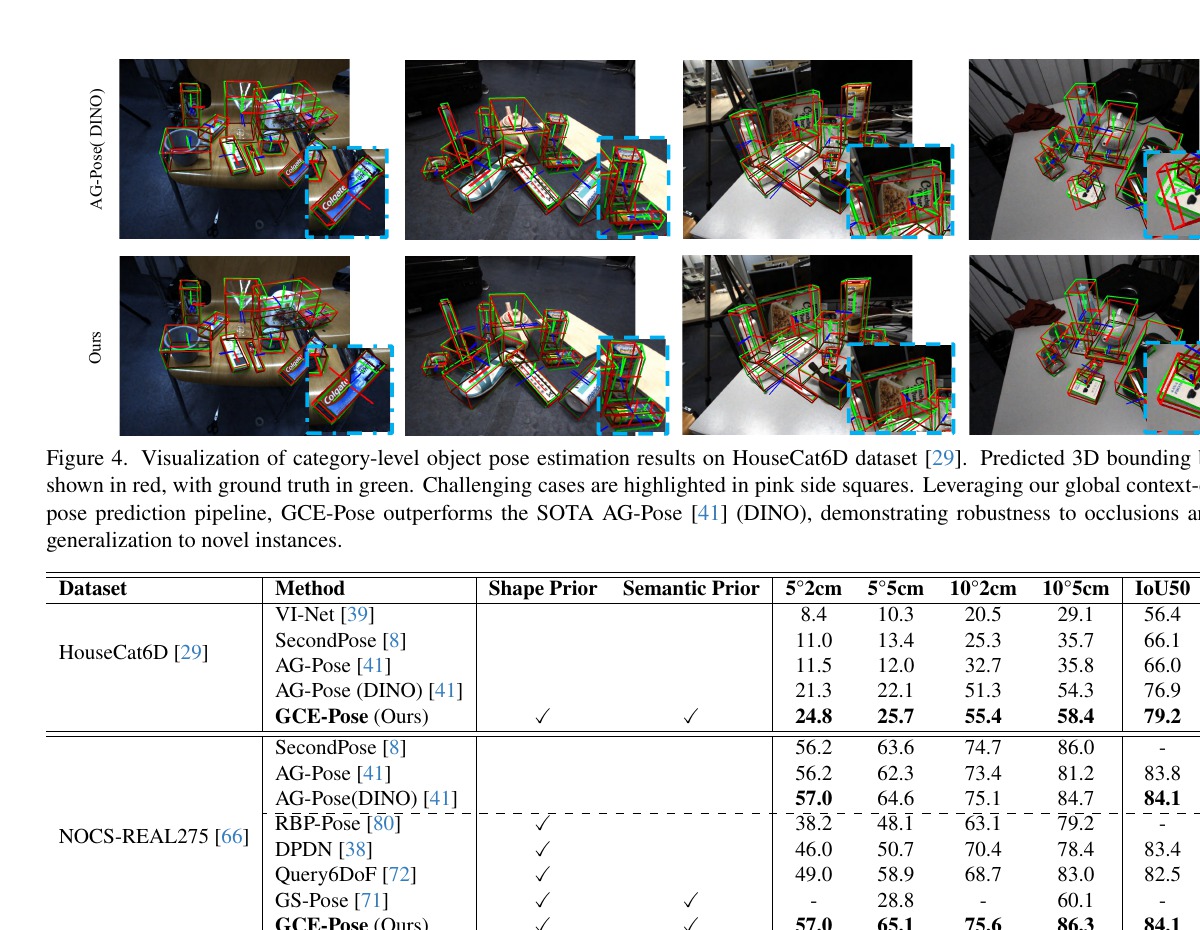 原论文 Figure 4 与 Table 1:红框为预测、绿框为真值,粉色局部突出遮挡和形变困难样本;表中分别列出 HouseCat6D 与 NOCS-REAL275 的先验条件和多项指标。来源:CVPR 2025 论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
NOCS-REAL275 上,GCE-Pose 的 5°2cm / 5°5cm / 10°2cm / 10°5cm 为 57.0 / 65.1 / 75.6 / 86.3。与 prior-free 的 AG-Pose(DINO)相比,严格 5°2cm 相同,但 5°5cm 从 64.6 提至 65.1;与其他使用 shape prior 的 DPDN(46.0 / 50.7)和 Query6DoF(49.0 / 58.9)相比优势更明显。这里不能据此断言类别先验在所有数据集都必要,因为不同方法的 backbone 和训练设置仍是混杂变量。
Table 2 从同骨干 baseline 开始分解 global prior:instance geometry 为 22.2,categorical semantics 为 22.7,mean-shape geometry + semantics 为 23.4,instance-specific geometry + semantics 的完整模型为 24.8。几何与语义先验互补,而且实例级重建优于简单平均形状。
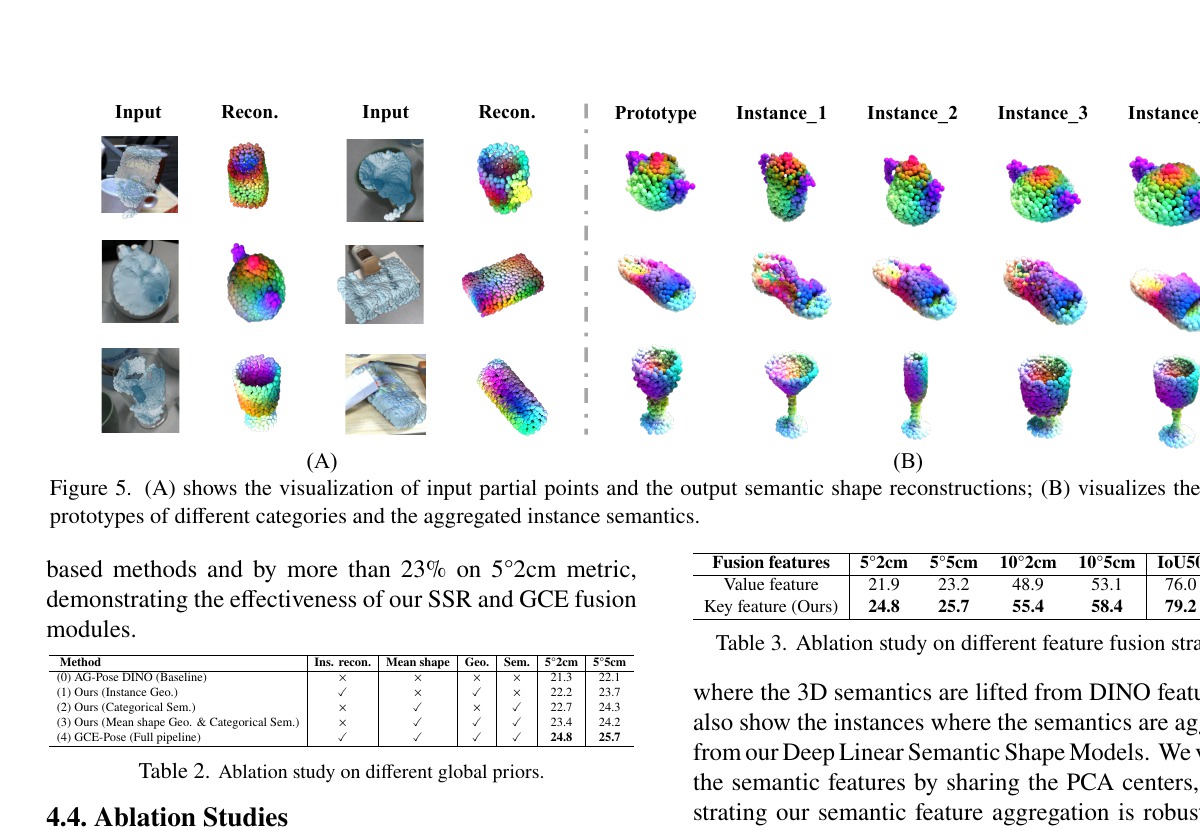 原论文 Figure 5 与 Table 2–3:可视化 partial point cloud 的语义重建及类别 prototype,并比较不同全局先验与 key / value feature 融合策略。来源:CVPR 2025 论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
使用 value feature 的 fusion 为 21.9 / 23.2 / 48.9 / 53.1,而作者的 key feature 为 24.8 / 25.7 / 55.4 / 58.4;差异不只是参数量,而来自 cross-attention 中“partial local feature 作 query、global semantic prior 作 key”的匹配关系。这组直接对照支持 GCE fusion 的设计,而不只是 SSR 提供了额外特征。
6. 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| global context 能改善 partial visibility pose | 同骨干 baseline 21.3 到完整模型 24.8,且 instance geometry / semantics 分别为 22.2 / 22.7,逐步消融支持;还应按可见比例分组。 |
| key token 更适合融合 semantic prior | key 相对 value 在 5°2cm 上为 24.8 对 21.9,在 10°2cm 上为 55.4 对 48.9,差异显著;仍需确认训练预算完全一致。 |
7. 复现要点与限制
- 必须明确每个类别 prototype 的坐标与 scale、SSR latent dimension、partial point sampling 和 NOCS solver。
- prototype 覆盖不了长尾形状时,先补全可能比只看 partial observation 更有偏差。
- 应在 invisible surface reconstruction error 与 final pose error 间做关联分析,验证补全质量确实传导给 pose。