论文精读笔记:Generalizable Single-View Object Pose Estimation by Two-Side Generating and Matching
1. 基本信息
简称 :Gen2SM作者 :Yujing Sun、Caiyi Sun、Yuan Liu、Yuexin Ma、Siu Ming Yiu机构 :The University of Hong Kong、ShanghaiTech University会议 :IEEE/CVF Winter Conference on Applications of Computer Vision(WACV 2025)正式论文页 :CVF Open Access 预印本 :arXiv:2411.15860 代码仓库 :scy639/Gen2SM 阅读模式 :精读
2. 先给结论
Gen2SM 不是完整 6D object pose estimator,而是一个面向未见物体、单参考 RGB 设定的相对观察方向估计器 。它把大视角差下不可靠的“参考图直接生成到查询视角”改写为“参考侧与查询侧在多组共享中间视角上互相解释”,再将预训练 Zero-1-to-3 的噪声预测残差作为 pose energy,通过离散搜索和 SGD 细化得到查询图的 elevation 与 azimuth。
论文最有价值的部分是 two-side matching 的问题改写,而不是简单地“用了 diffusion”:
端到端跨度被缩短 :两张相差 150° 的图都可以只向若干中间视角移动较小角度。生成问题变成判别式 energy :无需把每个候选完整采样成 RGB,利用 denoiser 对噪声的可解释程度给 pose 假设打分。结果与动机相符 :在 GSO 的 δ≥120° 与 δ≥150° 子集上,Gen2SM 明显优于 E2VG、IDPose 等直接生成 / 反演路线。
但其边界同样清楚:不估 translation,不估 scale,不独立估 roll;依赖参考 pose、重力对齐和 object-centric crop;对称对象在 NAVI 协议中被过滤;默认单张 A100 约 7.8 秒 / query;论文自己也承认精度尚未达到数度级。
2.1 论文图表导读
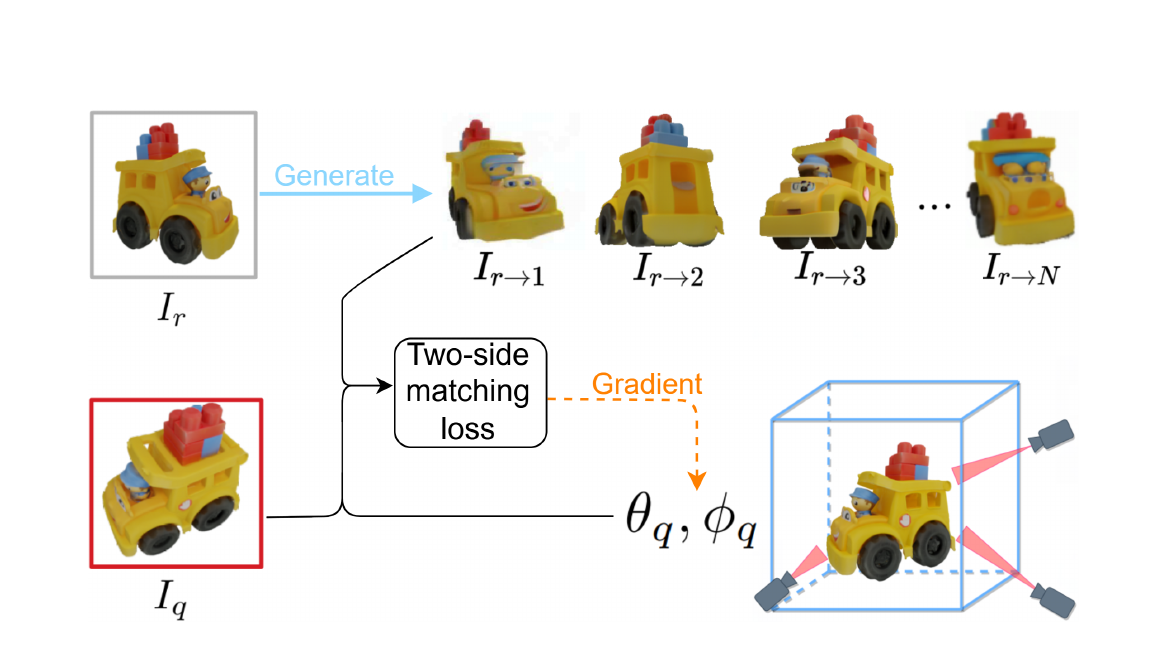
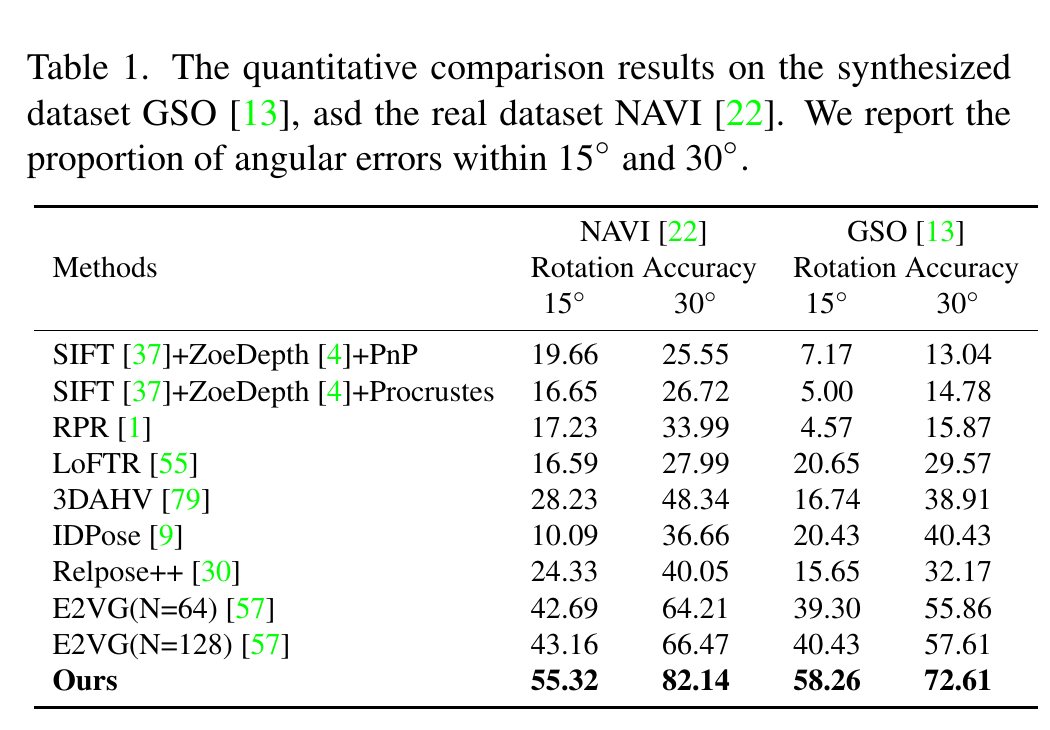
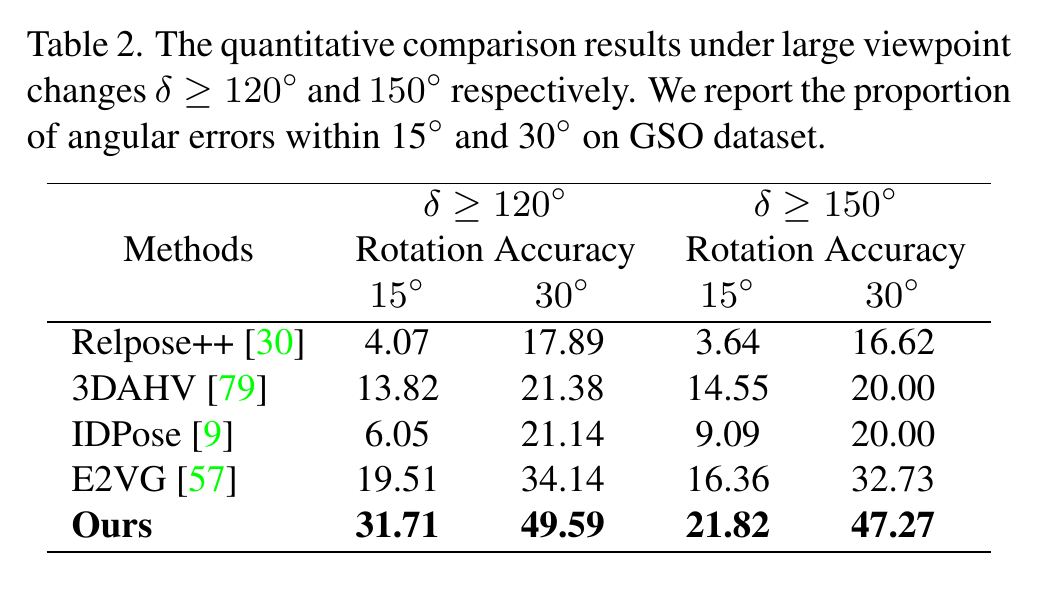
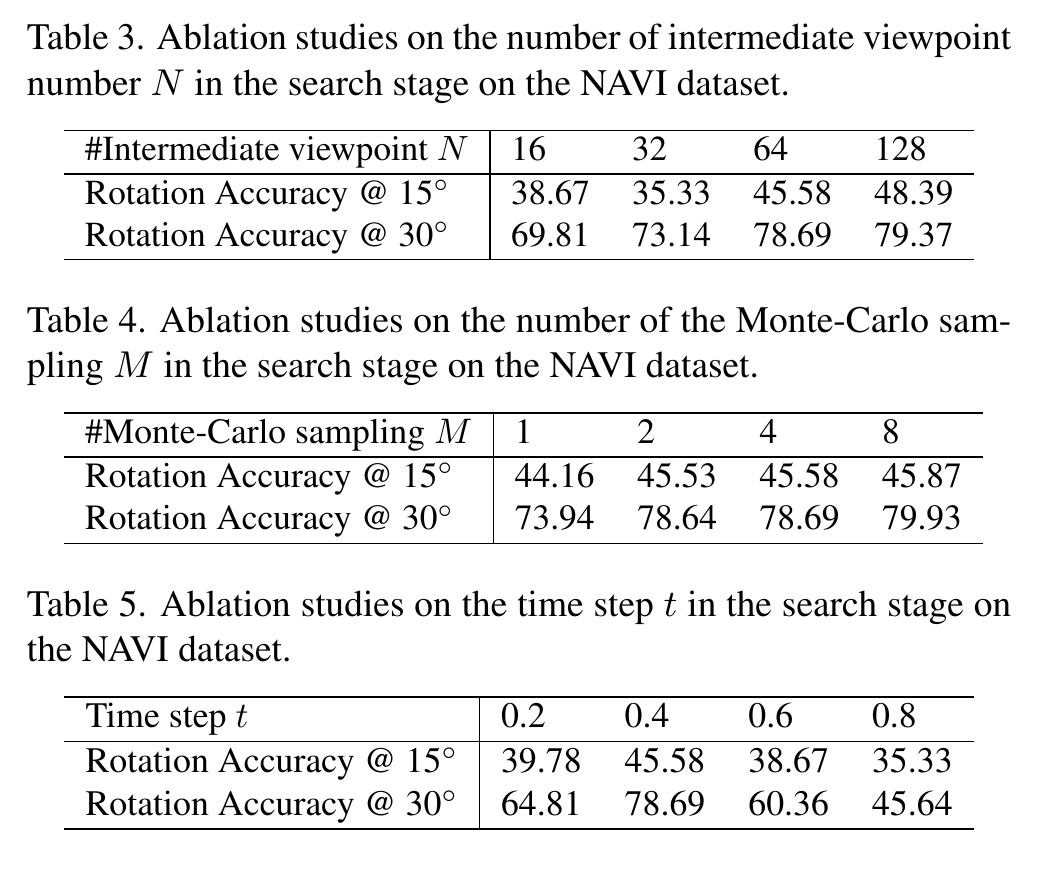
图表 它回答的问题 关键读法 Figure 3 方法到底输入什么、优化什么 两张图不是直接做特征匹配;未知变量只有查询 elevation / azimuth Table 1 是否真的优于对应、回归和 diffusion baselines 四个主列均领先,但指标只衡量 rotation threshold accuracy Table 2 two-side matching 是否击中“大视角差”痛点 120° / 150° 子集优势仍显著,是论文最直接的动机证据 Tables 3–5 性能来自参数堆叠还是稳定设计 N、M、t 存在不同的饱和与敏感性;尤其 t=0.4 很关键
3. 问题设定与任务边界
3.1 坐标、输入与未知量
论文令物体位于 object coordinate system 原点。参考图像记作 I r I_r I r h e t a r heta_r h e t a r p h i r phi_r p h i r I q I_q I q
目标是估计查询视角:
( θ q , ϕ q ) , (\theta_q,\phi_q), ( θ q , ϕ q ) , 或等价地估计相对变化:
Δ θ r q = θ q − θ r , Δ ϕ r q = ϕ q − ϕ r . \Delta\theta_{rq}=\theta_q-\theta_r,\qquad
\Delta\phi_{rq}=\phi_q-\phi_r. Δ θ r q = θ q − θ r , Δ ϕ r q = ϕ q − ϕ r . Zero-1-to-3 的条件接口还允许半径变化 Δ r \Delta r Δ r Δ r = 0 \Delta r=0 Δ r = 0
3.2 这不是任意 SO(3) 或 SE(3)
从论文的变量和实现可见,它只显式优化 elevation 与 azimuth。已知重力对齐约束固定了物体“正立”方向,roll 没有作为第三个独立旋转自由度求解。因此网站将它标记为重力对齐的 relative rotation / viewpoint estimation ,而不是完整三轴旋转,更不是标准 R,t 六自由度物体位姿。
这种任务仍可由旋转矩阵统一评价:作者把 GT 与预测结果转换为 R g t R_{gt} R g t R p r R_{pr} R p r SO(3)。
3.3 输入、输出和先验清单
维度 Gen2SM reference 一张同物体 RGB 图,reference pose 已知 query 一张同物体 RGB 图,经检测和 object-centric crop CAD / mesh 不需要 depth 不需要 mask 论文主方法不以 GT mask 为输入,但依赖对象检测 / 裁剪前端 camera intrinsics 不是 score 的显式输入;数据协议提供相机信息用于 GT 与前处理 multi-view reference 不需要 object-specific training 不需要 pretrained prior 需要 Zero-1-to-3;其预训练过程使用大规模 3D 对象渲染数据 output ( θ q , ϕ q ) (\theta_q,\phi_q) ( θ q , ϕ q ) missing output translation、scale、independent roll、uncertainty distribution inference coarse grid search + test-time gradient refinement
3.4 “training-free”的准确说法
Gen2SM 对测试对象不做再训练,也没有为 NAVI / GSO 训练一个 pose regressor,因此可以说是 object-level training-free 或 test-object training-free 。但它并非不依赖训练:核心 prior 来自已经在大量带视角渲染数据上训练好的 Zero-1-to-3。其泛化能力和失败模式都会继承基础模型的训练分布。
4. 研究脉络
4.1 稠密参考路线
Gen6D、OnePose++、模板检索及许多 CAD-based 方法可以从多张已知 pose 的参考图或稠密模板中找到接近查询视角的证据。这类方法的优势是显式观测充分,弱点是参考采集成本高。Gen2SM 把参考数量压到一张,缺失的视角信息交给生成先验补足。
4.2 图像对应 + 几何求解
SIFT / LoFTR 路线通过跨图像对应恢复相对几何。若对象表面纹理丰富、重叠区域足够,这种方法具有强几何解释性;若两张图看到的几乎是对象正反两面,共同可见表面太少,对应数量和稳定性会迅速下降。论文也加入 ZoeDepth 后的 PnP / Procrustes 版本,但单目深度与跨视角匹配误差会叠加。
4.3 直接回归相对旋转
RPR、RelPose / RelPose++、3DAHV 等从图像对回归相对旋转或验证多个 hypothesis。其速度通常比扩散搜索更友好,但需要模型在训练分布中学习对象类别、几何和视角变化的统计。Gen2SM 不为 pose 任务重新训练,而把 Zero-1-to-3 视为跨类别对象先验。
4.4 单侧生成 / diffusion inversion
E2VG 从参考图生成一系列候选新视角,再与查询图匹配;IDPose 直接反演扩散去噪过程来优化相对 pose。它们与 Gen2SM 使用相同类型的生成先验,因而是最关键的对照。两者的问题是:当参考到查询的视角差很大时,生成模型需要一次补全大量未观测结构,身份一致性与细节都会退化。
4.5 Gen2SM 的真正增量
Gen2SM 不要求生成模型在端点之间“一步跨越”,而是引入一组统一的 intermediate viewpoints。正确的查询 pose 假设应让 reference-conditioned 与 query-conditioned generation 在这些中间状态上相容。它把 pose estimation 转为多中间视角上的 set-to-set consistency 问题。
5. 研究动机:为何两侧去中间比一侧到终点更稳
设参考与查询 azimuth 相差 120°。从参考图直接生成查询视角意味着模型必须猜出大部分未见背面;即使生成图语义上仍像同一类对象,也可能在局部结构、颜色、附件位置上偏离真正实例。此时直接 RGB 相似度或 feature matching 都会把“生成幻觉”误当成 pose 误差。
若选取位于两者之间的视角,例如 60°,参考侧与查询侧各自只需改变约 60°。两端都保留更多已观测区域,条件生成较容易维持对象身份。如果候选查询 pose 错了,那么从查询侧到同一中间视角的条件变化也会错,denoiser 无法很好解释参考侧中间图所加的噪声,score 会增大。
这个思路类似几何中的“寻找共同坐标系”,但共同空间不是显式 3D mesh,而是由预训练扩散模型定义的 view-conditioned image manifold。
6. 方法详解
原论文 Figure 3:总体流程。已知 reference pose,生成式先验提供中间视角证据,查询 elevation / azimuth 由 two-side matching score 的搜索与梯度细化恢复。图中的相机框是 viewpoint estimation 的示意,不代表方法求解 translation。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6.1 Zero-1-to-3 去噪器
标准扩散前向过程将干净图像 I I I
I t = α t I + σ t ϵ , I_t=\alpha_t I+\sigma_t\epsilon, I t = α t I + σ t ϵ , 其中 ϵ ∼ N ( 0 , I ) \epsilon\sim\mathcal N(0,I) ϵ ∼ N ( 0 , I ) t t t
ϵ Θ ( I t ; t , I c o n d , Δ θ , Δ ϕ , Δ r ) . \epsilon_\Theta(I_t; t, I_{cond}, \Delta\theta,\Delta\phi,\Delta r). ϵ Θ ( I t ; t , I co n d , Δ θ , Δ ϕ , Δ r ) . Gen2SM 不关注最终采样一张“好看”的新视角图,而关心:在某个 pose 假设下,conditioned denoiser 能否正确预测已知中间图上的噪声。
6.2 Naive generation-and-matching
最直接的目标是从参考图生成查询视角,并最小化与真实查询图的距离:
min Δ ϕ r q , Δ θ r q E z ∥ I q − G ( z , I r , Δ θ r q , Δ ϕ r q ) ∥ 2 2 . \min_{\Delta\phi_{rq},\Delta\theta_{rq}}
\mathbb E_z\left\|I_q-\mathbb G(z,I_r,\Delta\theta_{rq},\Delta\phi_{rq})\right\|_2^2. Δ ϕ r q , Δ θ r q min E z ∥ I q − G ( z , I r , Δ θ r q , Δ ϕ r q ) ∥ 2 2 . z z z I r → I q I_r\rightarrow I_q I r → I q
6.3 Two-side generated-image objective
论文用 Fibonacci sphere 在上半球均匀采样 N N N
{ ( ϕ i , θ i ) } i = 1 N . \{(\phi_i,\theta_i)\}_{i=1}^{N}. {( ϕ i , θ i ) } i = 1 N . 从 reference 到第 i i i
( Δ ϕ r i , Δ θ r i ) = ( ϕ i − ϕ r , θ i − θ r ) , (\Delta\phi_{ri},\Delta\theta_{ri})=(\phi_i-\phi_r,\theta_i-\theta_r), ( Δ ϕ r i , Δ θ r i ) = ( ϕ i − ϕ r , θ i − θ r ) , 从当前 query pose 假设到中间视角的变化为:
( Δ ϕ q i , Δ θ q i ) = ( ϕ i − ϕ q , θ i − θ q ) . (\Delta\phi_{qi},\Delta\theta_{qi})=(\phi_i-\phi_q,\theta_i-\theta_q). ( Δ ϕ q i , Δ θ q i ) = ( ϕ i − ϕ q , θ i − θ q ) . 理想的 set-to-set 目标是:
min θ q , ϕ q E z ∑ i = 1 N ∥ G ( z , I q , Δ θ q i , Δ ϕ q i ) − G ( z , I r , Δ θ r i , Δ ϕ r i ) ∥ 2 2 . \min_{\theta_q,\phi_q}\mathbb E_z
\sum_{i=1}^{N}
\left\|
\mathbb G(z,I_q,\Delta\theta_{qi},\Delta\phi_{qi})-
\mathbb G(z,I_r,\Delta\theta_{ri},\Delta\phi_{ri})
\right\|_2^2. θ q , ϕ q min E z i = 1 ∑ N ∥ G ( z , I q , Δ θ q i , Δ ϕ q i ) − G ( z , I r , Δ θ r i , Δ ϕ r i ) ∥ 2 2 . 若 ( θ q , ϕ q ) (\theta_q,\phi_q) ( θ q , ϕ q )
6.4 用 score distillation 近似图像集合距离
为避免每次 pose 候选都完整采样两套图,论文先从 reference 生成并缓存:
G r = { I r → i } i = 1 N . \mathcal G_r=\{I_{r\rightarrow i}\}_{i=1}^{N}. G r = { I r → i } i = 1 N . 随后给每个 I r → i I_{r\rightarrow i} I r → i I r → i , t I_{r\rightarrow i,t} I r → i , t I q I_q I q ϵ \epsilon ϵ
论文借鉴 DreamFusion 的 score-distillation 思路,把目标写成:
min θ q , ϕ q E t , ϵ ∑ i = 1 N ∥ ϵ Θ ( I r → i , t ∣ I q , Δ θ q i , Δ ϕ q i ) − e p s i l o n ∥ 2 2 . \min_{\theta_q,\phi_q}
\mathbb E_{t,\epsilon}
\sum_{i=1}^{N}
\left\|
\epsilon_\Theta(I_{r\rightarrow i,t}\mid I_q,\Delta\theta_{qi},\Delta\phi_{qi})-epsilon
\right\|_2^2. θ q , ϕ q min E t , ϵ i = 1 ∑ N ∥ ϵ Θ ( I r → i , t ∣ I q , Δ θ q i , Δ ϕ q i ) − e p s i l o n ∥ 2 2 . 这里值得特别理解:
被加噪的是 reference 侧已经生成的中间视角图 ;
denoiser 的条件来自 query 图和当前 pose 假设 ;
残差衡量“query 条件能否解释 reference 侧中间图”,因此具有 two-side 性质;
score 不是两个图像 backbone feature 的 cosine similarity。
6.5 固定时间步 + Monte-Carlo score
对全部扩散时间步求期望仍很昂贵。论文固定 t t t M M M
f ( θ q , ϕ q ) = 1 M ∑ j = 1 M ∑ i = 1 N ∥ ϵ Θ ( I r → i , t ( j ) ∣ I q , Δ θ q i , Δ ϕ q i ) − e p s i l o n ( j ) ∥ 2 2 . f(\theta_q,\phi_q)=
\frac{1}{M}\sum_{j=1}^{M}
\sum_{i=1}^{N}
\left\|
\epsilon_\Theta(I_{r\rightarrow i,t}^{(j)}\mid I_q,\Delta\theta_{qi},\Delta\phi_{qi})-epsilon^{(j)}
\right\|_2^2. f ( θ q , ϕ q ) = M 1 j = 1 ∑ M i = 1 ∑ N ϵ Θ ( I r → i , t ( j ) ∣ I q , Δ θ q i , Δ ϕ q i ) − e p s i l o n ( j ) 2 2 . 默认参数为:
N = 64 N=64 N = 64 M = 4 M=4 M = 4 t = 0.4 t=0.4 t = 0.4 refinement iterations = 3。
固定 t t t t t t
6.6 Grid-based coarse search
粗搜过程并非一次均匀高分辨率遍历,而是分层缩小候选:
azimuth 从 0° 到 360°,间隔 45°;elevation 候选为 15°、45°、75°。
固定当前最佳 elevation,在最佳 azimuth 周围评估 -30°、-15°、+15°、+30°。
再在当前最佳 azimuth 周围评估 -10°、-5°、+5°、+10°。
围绕初始 elevation 以约 10° 的局部范围继续比较候选;正文具体写到计算 ( θ q − 15 ° , θ q + 15 ° ) (\theta_q-15°,\theta_q+15°) ( θ q − 15° , θ q + 15° )
离散搜索先跨过 energy landscape 中的大范围局部极值,最终角度间隔约 10°,再交给连续优化。
6.7 Gradient refinement
以粗搜结果为初值,随机采样噪声评价 f f f
∂ f ∂ θ q , ∂ f ∂ ϕ q , \frac{\partial f}{\partial\theta_q},\qquad
\frac{\partial f}{\partial\phi_q}, ∂ θ q ∂ f , ∂ ϕ q ∂ f , 并用 SGD 更新 pose。默认 3 次 refinement。论文 Figure 8 显示收益主要体现在严格的 15° 阈值,而 30° 阈值较早饱和;naive 单侧 refinement 没有同样明显的改进。这说明 two-side score 不仅改善粗排序,也提供了更有用的局部梯度。
6.8 模块输入输出
模块 输入 输出 作用 主要风险 对象检测与归一化 query RGB object-centric query crop 把场景裁剪到基础模型熟悉的对象中心分布 detector / crop 误差会改变外观与视角线索 中间视角采样 上半球、N ( θ i , ϕ i ) (\theta_i,\phi_i) ( θ i , ϕ i ) 给两侧建立共享目标状态 不覆盖下半球;采样越多越慢 reference generation I r I_r I r I r → i I_{r\rightarrow i} I r → i 缓存 reference 侧的生成证据 背面 hallucination、实例身份漂移 two-side score noisy I r → i I_{r\rightarrow i} I r → i I q I_q I q scalar f ( θ q , ϕ q ) f(\theta_q,\phi_q) f ( θ q , ϕ q ) 评价 query 假设能否解释 reference 中间图 对 t t t coarse search 离散 viewpoint hypotheses 粗 ( θ q , ϕ q ) (\theta_q,\phi_q) ( θ q , ϕ q ) 全局探索 候选数量大、计算昂贵 SGD refinement 粗 pose、score gradient 精化 pose 提高 15° accuracy 局部极值、随机梯度方差
6.9 训练与监督
论文没有为 Gen2SM 训练新的 pose network,也没有使用 GSO / NAVI 的 pose labels 优化参数。数据集 GT 只用于评价。真正的监督来自 Zero-1-to-3 预训练阶段,而该阶段不属于本文训练流程。
因此复现关注点主要在 inference implementation,而非训练 recipe:
Zero-1-to-3 checkpoint 与 scheduler 版本;
object-centric crop 的复现;
viewpoint 坐标约定、角度正负和 periodicity;
reference 中间图缓存;
随机噪声是否在不同候选间共享;
coarse-to-fine 候选展开顺序;
SGD 学习率与角度参数约束;
light version 的 pruning / feature reuse 实现。
7. 实验分析
7.1 数据集与样本协议
数据集 类型 对象规模 参考—查询协议 关键边界 GSO 扫描对象的合成渲染 原库约 1,000 个;测试 23 个 每对象在上半球均匀渲染多视角,随机取 1 reference + 20 queries 渲染输入干净;适合统计超大 viewpoint difference NAVI 真实对象、多环境、多视角 原库 36 个;沿用 E2VG 后测试 27 个 通常每对象 20 个 reference-query pairs,图像不足者使用全部可用对 对称等“不适合”的对象被过滤,协议不检验 symmetry handling
作者沿用 E2VG benchmark,有利于直接对比 diffusion-based baseline。代价是评测边界也继承:对象中心化、对称对象过滤、rotation-only、有限对象数量。
7.2 指标定义
论文计算:
R e r r = R g t ⊤ R p r , R_{err}=R_{gt}^{\top}R_{pr}, R er r = R g t ⊤ R p r , 再将 R e r r R_{err} R er r @ 误读为链接,本站记作:
Acc≤15°:较严格的方向精度;Acc≤30°:较宽松的 coarse orientation 成功率。
这两个阈值没有提供误差分布的中位数、均值或 calibration,也不包含 translation。30° 成功不代表能用于精准 AR overlay、装配或抓取。
7.3 Baselines 与设定公平性
类别 方法 主要输入 / 求解 与 Gen2SM 的可比性 手工 / 稠密对应 SIFT + ZoeDepth + PnP / Procrustes、LoFTR 图像对应,部分版本加入单目深度 都是单 reference-query,但依赖对应可见区域;大视角天然吃亏 直接回归 RPR、RelPose++ 两图回归 relative rotation 输出较接近,可直接比较 rotation accuracy;训练先验不同 hypothesis & verification 3DAHV 学习 3D-aware representation 并验证候选 任务相近,但网络训练与推理范式不同 diffusion IDPose、E2VG Zero-1-to-3 prior + inversion / generation matching 最关键对照;使用相近基础模型与单参考设定
论文说明 SIFT-ZoeDepth 与 RPR 使用文献 [1] 的实现,其余方法使用官方仓库;RelPose++ 只采用 two-view setting。总体设定可比性合理,但仍需注意不同 baseline 的 crop、模型预训练数据、生成候选数和 runtime 未在同一张表中统一比较。
7.4 主结果
原论文 Table 1:主结果。Gen2SM 在 NAVI 和 GSO 的 15° / 30° rotation accuracy 上均领先;表中没有 translation 或完整 6D pose 指标。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
NAVI
方法 Acc≤15°Acc≤30°3DAHV 28.23 48.34 RelPose++ 24.33 40.05 E2VG (N=64) 42.69 64.21 E2VG (N=128) 43.16 66.47 Gen2SM 55.32 82.14
相对最强所列 baseline E2VG (N=128),Gen2SM 分别提高 12.16 与 15.67 percentage points。真实数据上的提升说明 two-side score 并非只适用于干净渲染。
GSO
方法 Acc≤15°Acc≤30°IDPose 20.43 40.43 E2VG (N=64) 39.30 55.86 E2VG (N=128) 40.43 57.61 Gen2SM 58.26 72.61
相对 E2VG (N=128) 分别提高 17.83 与 15.00 points。GSO 使用上半球渲染,和方法的中间视角采样域更一致;因此 GSO 的结果不能单独证明任意真实场景泛化,NAVI 更重要。
7.5 大视角差分析
原论文 Table 2:GSO 大视角差子集。Gen2SM 在 `δ≥120°` 和 `δ≥150°` 下仍保持对 E2VG 的明显优势,直接支撑“共享中间视角比端到端生成更稳”的动机。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
GSO 子集 RelPose++ 3DAHV IDPose E2VG Gen2SM δ≥120°, Acc≤15°4.07 13.82 6.05 19.51 31.71 δ≥120°, Acc≤30°17.89 21.38 21.14 34.14 49.59 δ≥150°, Acc≤15°3.64 14.55 9.09 16.36 21.82 δ≥150°, Acc≤30°16.62 20.00 20.00 32.73 47.27
与 E2VG 相比:
δ≥120°:提高 12.20 / 15.45 points;δ≥150°:提高 5.46 / 14.54 points。
作者把结果概括为约 1.5 倍于最佳 baseline,若按不同比例列计算并不完全统一;更稳妥的表述是“所有列都显著领先”。同时,δ≥150° 的严格阈值仍只有 21.82%,说明端点间几乎没有共同可见区域时,基础模型 hallucination 仍是强瓶颈。
7.6 消融实验
原论文 Tables 3–5:NAVI 上的三组关键超参数消融。`N` 增长带来收益后趋于饱和,`M=4` 已接近 `M=8`,而扩散时间步 `t` 对 score 判别性非常敏感。来源:CVF Open Access 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
中间视角数 N
N16 32 64 128 Acc≤15°38.67 35.33 45.58 48.39 Acc≤30°69.81 73.14 78.69 79.37
从 64 增加到 128,30° accuracy 只提高 0.68 point,计算量却近似随 N 线性增加,因此默认 64 合理。需要注意 15° 指标从 N=16 到 N=32 反而下降 3.34 points,结果不是严格单调;这可能来自 noise sampling 方差、视角覆盖结构或单次实验波动。论文没有提供多随机种子置信区间。
Monte-Carlo 采样数 M
M1 2 4 8 Acc≤15°44.16 45.53 45.58 45.87 Acc≤30°73.94 78.64 78.69 79.93
从 M=1 到 2,30° 指标提高 4.70 points;从 2 到 4 几乎不变;从 4 到 8 也只提高 0.29 / 1.24 points。作者指出 M=8 运行时间接近 M=4 的两倍,因此选 4。该消融支持“少量 noise samples 已足以降低 score 方差”。
扩散时间步 t
t0.2 0.4 0.6 0.8 Acc≤15°39.78 45.58 38.67 35.33 Acc≤30°64.81 78.69 60.36 45.64
t=0.4 明显最佳。太小的噪声层级可能让 denoiser 过度关注局部像素差异,太大的噪声层级则丢失实例结构;论文给出的解释是中等噪声最有效,但没有进一步分析 score landscape 或不同对象的最优 t。这是一个很值得后续做自适应选择的点。
refinement 次数与 two-side score
正文 Figure 8 只给曲线,没有精确数值表。可确认的结论是:
two-side refinement 从 0 到 3 次持续改善,主要收益集中在 15° accuracy;
naive generation-and-matching refinement 没有显著提高;
3 次之后收益趋缓,因此默认 3。
本站不从曲线像素估算具体数值,以免制造虚假精度。
7.7 运行时间与可扩展性
版本 硬件 搜索 refinement 总时间 / 论文报告 默认 单张 A100 6.5 s 1.3 s 约 7.8 s / query light 论文同类 GPU 语境 未分拆 未分拆 1.12 s / query
light version 使用 intermediate viewpoint pruning、feature reuse 等加速,论文称 Acc≤15° 与 Acc≤30° 分别下降约 1 与 4 points。候选 score 可以跨 GPU 并行,wall-clock time 近似按 GPU 数下降,但总 FLOPs 与资源占用没有消失。
对于应用:
离线相对朝向初始化:可接受;
AR 首帧初始化:light version 可能勉强可用;
机器人抓取闭环:仍需 translation、稳定检测、精细 refinement 与速度优化;
视频 tracking:不适合作为逐帧独立 estimator,最好只在失跟踪重定位时调用。
7.8 鲁棒性与失败条件
因素 论文是否充分评价 本站判断 大视角差 是,单列 120° / 150° 核心优势证据充分 synthetic-to-real GSO + NAVI 有基础证据,但真实对象数有限 对称物体 否,NAVI 协议过滤部分对称对象 不能声称 symmetry robustness 遮挡 / clutter 未做遮挡率分桶;Zero-1-to-3 object-centric 真实场景能力不足以判断 textureless / reflective 未单独分组 生成先验可能依类别外观而异,需补实验 detector / crop error 未单独扰动 这是实际部署的重要隐含变量 query 与 reference 光照域差 NAVI 含多环境但未分桶 有混合证据,缺少因果分析 scene-level multiple objects 作者明确说不能直接处理 属于当前方法边界 数度级精度 作者明确承认未达到 不能用于高精装配
8. 贡献是否被实验支撑
作者声称 对应实验 证据强度 本站判断 单参考且泛化未见对象 GSO / NAVI、无对象级训练 中—强 在给定 object-centric 和重力对齐协议下成立 two-side matching 解决大视角瓶颈 Table 1、Table 2、Figure 8 强 与 E2VG / IDPose 的差异和大视角分桶都对准主张 diffusion prior 被更有效利用 主结果和中间视角生成可视化 中 结果支持,但没有控制基础模型版本、生成质量与 score 的更细因果实验 方法可推广到机器人、AR、SLAM 等 结论中的应用展望 弱 未输出 translation,速度慢,也没有系统实验;应视为潜力而非已证实能力
9. 批判性分析
9.1 优点
问题改写非常具体 :不是抽象地增加模块,而是针对“一侧大跨度生成退化”提出共享中间视角。比较对象选得对 :E2VG 与 IDPose 使用同类 Zero-1-to-3 prior,主结果能相对隔离 matching strategy 的作用。关键子集单独报告 :120° / 150° 分桶让论文最重要的主张可被直接检验。energy-based 视角有扩展价值 :denoising residual 可作为几何未知量的可微 score,思想可迁移到其他基础模型。局限写得较诚实 :作者明确承认基础模型瓶颈、数度级精度不足和 object-centric 场景限制。
9.2 缺点
“object pose”命名容易扩大理解 :正文真正求解 elevation / azimuth,不包含 R,t;网站必须显式纠正。基础模型先验难以审计 :如果 Zero-1-to-3 见过相似对象或类别,其优势有多少来自 two-side objective、多少来自预训练覆盖,不易分离。对称性被绕开 :过滤对象简化了角度误差,但没有解决单视图 pose 最核心的多解问题。缺少 uncertainty :Monte-Carlo score 天然可产生候选分布,论文却只输出最佳 pose;在大视角 / 对称场景下 top-K hypotheses 更实用。计算成本高 :N×M×候选数×refinement 次 denoiser 评估是主要瓶颈;light version 细节在补充材料 / 代码中,正文证据有限。协议前端未充分审计 :对象检测、裁剪、reference pose 误差和 gravity misalignment 都可能显著影响结果,却没有扰动实验。统计不确定性缺失 :消融中出现非单调值,但没有多 seed 方差或 confidence interval。
9.3 隐含假设
参考与查询确实是同一对象实例;没有 object retrieval / identity verification。
对象的“上方向”可定义并与重力对齐。
参考 pose 足够准确;论文未评估 reference pose noise。
对象主要落在 Zero-1-to-3 熟悉的 object-centric 分布内。
上半球中间视角足以连接 reference 与 query。
object detector 能得到稳定 crop,且裁剪尺度变化不会破坏 viewpoint conditioning。
生成模型对同一实例从两个端点产生的中间视角具有足够身份一致性。
单个固定 t=0.4 可跨对象工作。
9.4 真实应用可行性
若目标是“从一张产品图判断另一张图的大致朝向”,Gen2SM 已给出有竞争力的方案。若目标是机器人操作中的 6D pose,还至少缺少:
translation / scale 求解;
symmetry-aware multi-hypothesis;
clutter、occlusion 和多物体前端;
detector / mask / crop 的稳定性;
depth 或几何 refinement;
数度级旋转与毫米级平移精度;
远低于 1 秒的推理速度;
失败检测和 score calibration。
更合理的系统定位是:Gen2SM 生成 coarse orientation hypotheses,后端用 RGB-D registration、CAD render-and-compare、PnP 或 learned refinement 求完整 R,t。
10. 复现清单
10.1 数据与协议
使用与 E2VG 相同的 GSO 23-object test split 和每对象 1+20 views 采样。
使用 NAVI 27-object filtered split,并确认对称对象过滤名单。
固定 reference-query pairs;避免不同方法随机抽到不同难度样本。
明确 GT rotation 从相机 extrinsics 到 object coordinate system 的转换。
对 azimuth 周期边界(0° / 360°)做 wrap-around。
10.2 图像前处理
复现 E2VG 的 object detector 与 object-centric transformation。
记录 crop center、scale、padding 与图像 resize。
确认 reference 和 query 的背景处理一致。
对检测失败单独计数,不能只在成功检测样本上报告 pose。
10.3 Zero-1-to-3 与 score
固定 checkpoint、VAE、scheduler、图像归一化和 precision。
中间视角用 Fibonacci sphere 在上半球采样,默认 N=64。
reference 侧中间图可缓存,避免每个 query 候选重复生成。
固定 Δr=0,核对 elevation / azimuth 的符号约定。
固定 t=0.4,明确它对应 1,000-step schedule 中的索引换算。
默认 M=4;比较候选时最好使用 common random numbers,减少 score ranking 方差。
记录 score 是否按像素 / latent 数量归一化。
10.4 搜索与细化
首轮 azimuth 45° grid,elevation {15°,45°,75°}。
按论文顺序执行 ±30° / ±15°、再 ±10° / ±5° 的局部 azimuth 搜索。
核对 elevation 局部候选与上下界。
refinement 默认 3 次;记录 SGD learning rate、gradient clipping 和 angle wrap。
保存 top-K score,而非只保存 argmin,便于发现多峰和对称问题。
10.5 评价与日志
用 R g t ⊤ R p r R_{gt}^{\top}R_{pr} R g t ⊤ R p r Acc≤15° 与 Acc≤30°。
同时补充 median / mean angular error、per-object result 与 bootstrap confidence interval。
单列 δ≥120°、δ≥150°。
记录 search / refinement / preprocessing 各阶段时间、峰值显存与 denoiser 调用次数。
至少运行 3 个 noise seeds,尤其是 N、M、t 消融。
11. 可改进方向
11.1 从单点输出变成 pose posterior
保留 coarse grid 的完整 score map,并在周期角度空间上归一化为 posterior。对称或背面不可辨识时输出多个 hypotheses,再由下游 depth / temporal evidence 消歧,比强迫单一 argmin 更可靠。
11.2 自适应中间视角
固定 64 个上半球点对所有对象并不经济。可以先用少量候选估计高概率 pose region,再只保留能同时缩短 reference 与 query 生成距离的中间视角;或学习每个中间视角的信息增益。
11.3 自适应扩散时间步
t=0.4 的消融优势显著,说明不同噪声层级携带不同几何 / 外观信息。可将多个 t 的 score 组成 coarse-to-fine schedule:高噪声负责大范围语义方向,低噪声负责实例细节;也可按对象纹理和不确定性动态选择。
11.4 使用多视图一致基础模型
作者提出可替换为 SV3D、SyncDreamer、Wonder3D、MVDiffusion++ 等更强或 multi-view-consistent prior。真正关键不是换名字,而是检验:
是否降低 reference-side identity drift;
是否使 score landscape 更平滑;
是否在 150° 以上提高严格阈值;
是否增加计算量;
是否扩大训练数据泄漏风险。
11.5 接入完整 6D pose
三条可行路线:
RGB-D :Gen2SM 给 orientation initialization,depth correspondence / Umeyama / ICP 求 translation 和 scale。CAD available :把 coarse orientation 交给 render-and-compare,再联合优化 R,t。CAD-free multi-view :先由 reference / assist views 重建稀疏 pointmap,利用 Gen2SM 的 orientation prior 稳定 registration。
11.6 场景与遮挡
可用 SAM / open-vocabulary detector 产生对象 mask,把 reference 与 query 都归一化到 object-centric crop;再对多 crop 运行 score。需要额外训练一个 failure detector,识别 crop 中对象不完整、身份不匹配或基础模型生成崩溃的情况。
11.7 对称性
将 GT symmetry group 作用到 pose score,比较:
f s y m ( R ) = min S ∈ S f ( R S ) , f_{sym}(R)=\min_{S\in\mathcal S} f(RS), f sy m ( R ) = S ∈ S min f ( R S ) , 或直接让 posterior 在等价旋转上多峰。若没有 CAD symmetry annotation,可通过 reference-side generation consistency 自动发现近似等价视角。
12. 对 6D 物体位姿研究的启发
把 foundation model 变成几何能量函数 :其 denoiser / decoder 不只用于生成,也可以为 pose hypothesis 提供可微评分。从端点匹配转向共同解释 :当两观测重叠很少,让它们同时解释共享 canonical states,往往比直接对应更稳。coarse orientation 与 metric pose 分层 :基础模型擅长类别级 / 语义级大范围方向,几何模块擅长局部毫米级 refinement,两者应分工。不要把“未见对象”误写成“无先验” :对象级无需训练不代表模型没有大规模生成先验、正立方向或参考 pose 假设。精度报告必须对应真实输出 :rotation threshold accuracy 不能替代 ADD(-S)、BOP AR 或 translation error。
13. 待解决问题
概念问题
若 reference 的 gravity alignment 有 5°–10° 误差,score 最优点如何偏移?
中间视角数量增加后 15° 指标为何从 N=16 到 32 下降?是随机噪声还是视角分布问题?
denoising residual 与真正的生成图相似度之间是否单调?
实验问题
对称对象、强遮挡、透明 / 反光 / 无纹理对象的 per-category 表现如何?
light version 的 1 / 4 points 降幅分别在哪个数据集统计,是否跨数据集稳定?
与 baseline 的统一 runtime、显存、预处理开销比较如何?
若换成更强的普通 image feature matcher,再给相同 object-centric crop,差距是否仍然相同?
复现问题
论文正文没有给出 SGD learning rate、完整 light-version 细节和多 seed 方差,需要结合代码与补充材料核实。
Figure 8 只有曲线,不能从正文恢复精确 refinement-step 数值。
NAVI 的具体 filtered object list 与 pair sampling 应从官方代码确认,避免协议漂移。
14. 总体评价
Gen2SM 是一篇任务边界窄但方法思想清楚的工作。它没有解决完整 6D pose,也没有证明场景级实时能力;但它抓住了生成式单参考 pose 的一个真实失败源:大视角差使单侧 novel-view synthesis 产生严重身份与结构漂移。通过共享中间视角、score-distillation 残差和粗到细优化,论文在真实 NAVI、合成 GSO 以及 120° / 150° 子集上都得到一致提升。
从研究价值看,它最适合被当作 diffusion-based relative orientation energy 来复现和扩展。若与 symmetry-aware posterior、RGB-D translation solver、快速候选剪枝和场景前端结合,才可能成为完整 6D pose 系统的一部分。就当前版本而言,正确结论是“单参考未见物体的大范围相对方向估计显著改善”,而不是“单图通用 6D pose 已经解决”。