论文精读笔记:GeoReF
1. 核心判断
GeoReF 从 CATRE 的失败模式出发:类别级 refiner 不像实例级 ICP 那样拥有与目标完全一致的 CAD。观测对象可能是一只窄口杯,而类别 mean shape 是宽口杯;直接用 PointNet 分别编码、最后拼接,网络既难找到跨形状对应,也容易把 prior mismatch 当成 pose error。
论文的解决路径有三层:
用 HS-layer 提取多尺度几何结构;
用 Learnable Affine Transformations(LAT)动态调整点坐标和 feature coordinates;
用 Cross-Cloud Transformation(CCT)让 shape prior 产生的变换显式作用于 observed features。
REAL275 中从 CATRE 的 IoU75 43.6 提到 51.8;更关键的是,随机换掉 mean prior 后仍保持稳定,以及 CAMERA25 只用 2% 训练图便超过 full-data CATRE。这些结果比单一主榜更直接支持“适配 shape variation”的论文命题。
2. 任务定义
给定:
( R 0 , t 0 , s 0 ) , O ∈ R N O × 3 , P ∈ R N P × 3 , (R_0,t_0,s_0),\quad
O\in\mathbb R^{N_O\times3},\quad
P\in\mathbb R^{N_P\times3}, ( R 0 , t 0 , s 0 ) , O ∈ R N O × 3 , P ∈ R N P × 3 , 网络预测:
( Δ R , Δ t , Δ s ) = ϕ ( R 0 , t 0 , s 0 , O , P ) . (\Delta R,\Delta t,\Delta s)
=\phi(R_0,t_0,s_0,O,P). ( Δ R , Δ t , Δ s ) = ϕ ( R 0 , t 0 , s 0 , O , P ) . 更新后可以再次输入网络做迭代 refinement。论文每个 observed / prior 点云采 512 点。任务是类别级 9DoF:旋转 3、平移 3、metric size 3;不是只细化 6DoF。
它不负责:
从 RGB 检测对象;
从深度分割对象点云;
生成初始 pose;
学习类别 prior。
这些都由上游 category-level estimator 和数据预处理提供。
3. Point-cloud focalization
GeoReF 沿用 CATRE 的 focalization:
O ^ = { o ^ i ∣ o ^ i = o i − t 0 } , \hat O=\{\hat o_i\mid \hat o_i=o_i-t_0\}, O ^ = { o ^ i ∣ o ^ i = o i − t 0 } , P ^ = { p ^ i ∣ p ^ i = diag ( s 0 ) R 0 p i } . \hat P=\{\hat p_i\mid
\hat p_i=\operatorname{diag}(s_0)R_0p_i\}. P ^ = { p ^ i ∣ p ^ i = diag ( s 0 ) R 0 p i } . 观测云先减初始 translation,prior 则按初始 rotation 与 anisotropic size 放到相近坐标。此时两者的剩余差异混合了:
初始 pose / size error;
同类实例真实形变;
depth 缺失、遮挡和噪声。
refiner 的难点正是区分前两者:pose error 应被修正,shape variation 不应被误修成错误姿态。
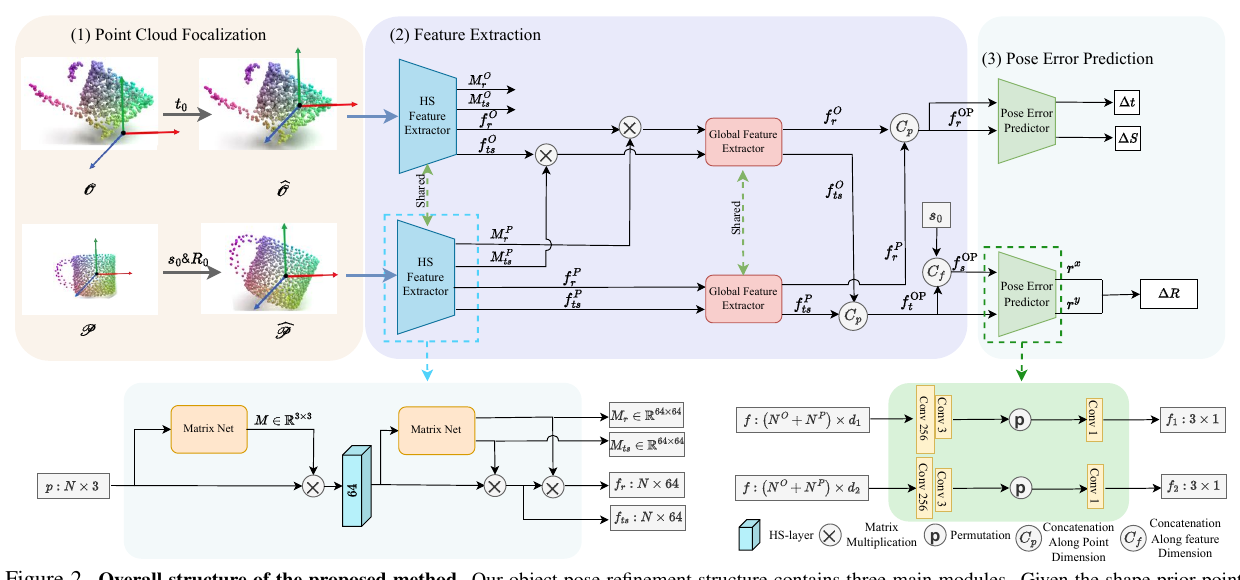
原论文 Figure 2 的主要结构。下方 Matrix Net 对输入点和两类 feature 产生三组 LAT;上方 observed / prior 共享 HS extractor,再进入旋转与平移尺寸两个误差头。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
直接将 PointNet 换成强几何 encoder 反而更差:HS-Encoder IoU75 30.1,3DGCN 28.4,而 CATRE PointNet baseline 为 43.6。原因不是 encoder 能力不足,而是单云 pose estimation 的几何算子不自动等价于跨不同形状的对齐器。
GeoReF 的 Matrix Net 产生:
M ∈ R 3 × 3 M\in\mathbb R^{3\times3} M ∈ R 3 × 3 M r ∈ R 64 × 64 M_r\in\mathbb R^{64\times64} M r ∈ R 64 × 64 M t s ∈ R 64 × 64 M_{ts}\in\mathbb R^{64\times64} M t s ∈ R 64 × 64
它们不是显式刚体变换,而是可学习 affine feature alignment。分别建模是因为 rotation 需要方向结构,translation / size 更依赖尺度和中心分布,不应强制共享同一变换。
消融非常明确:
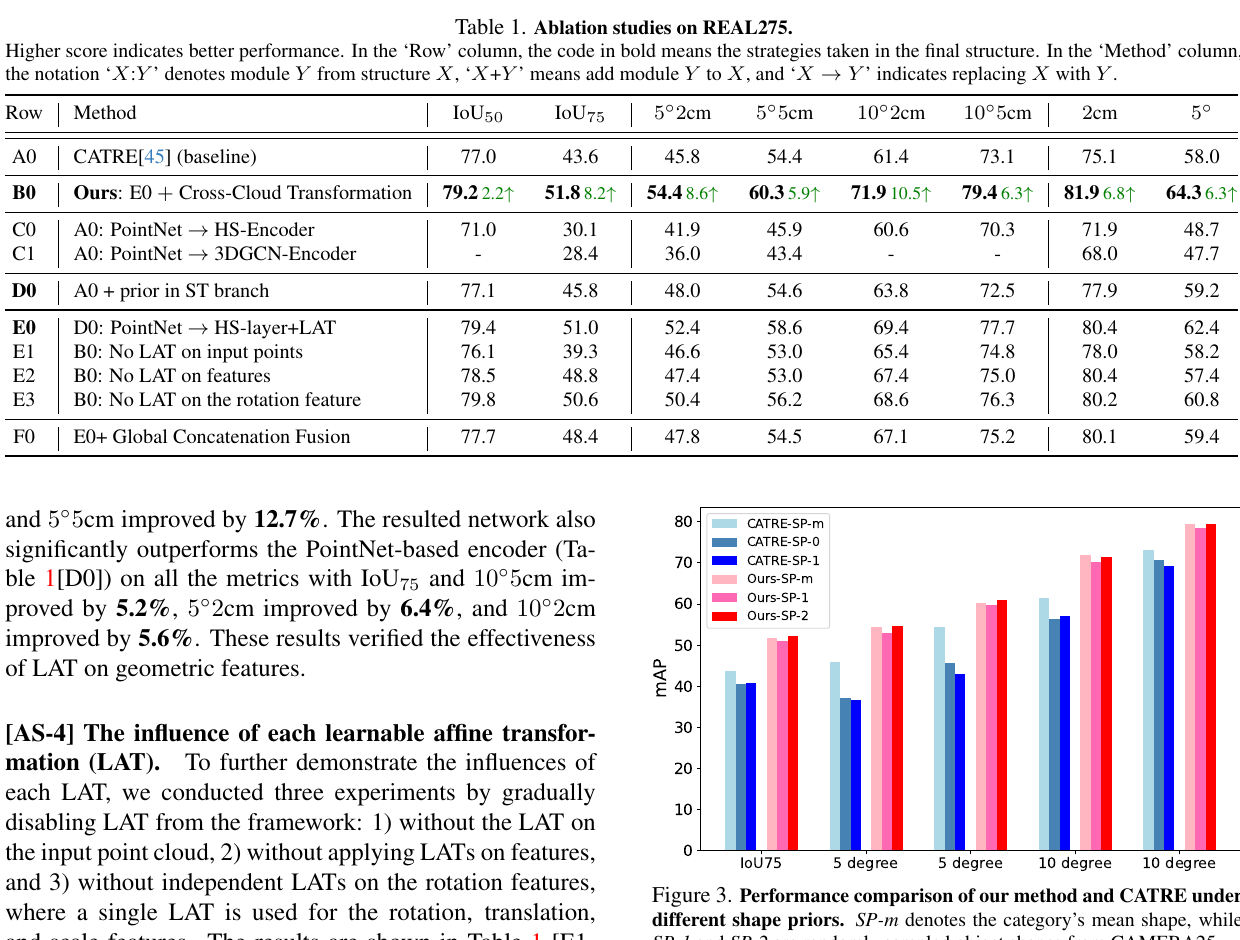
配置 IoU75 5°2cm 5°5cm 完整 GeoReF 51.8 54.4 60.3 无 input-point LAT 39.3 46.6 53.0 无 feature LAT 48.8 47.4 53.0 rotation 不用独立 LAT 50.6 50.4 56.2
input LAT 的影响最大,说明两云进入 graph convolution 前的局部坐标兼容性非常关键。
CATRE 直到后期才拼接 observed / prior features。GeoReF 让 prior 分支生成的变换矩阵作用到 observed features:
f r O = M r P f r O , f t s O = M t s P f t s O . f_r^O=M_r^P f_r^O,\qquad
f_{ts}^O=M_{ts}^P f_{ts}^O. f r O = M r P f r O , f t s O = M t s P f t s O . 这不是逐点最近邻对应,而是 由 prior 条件化的 feature-space alignment 。随后全局 feature extractor 汇总两云信息,再进入两个独立 pose-error predictors。
普通 global concatenation 的 IoU75 / 5°2cm 为 48.4 / 47.8,CCT 为 51.8 / 54.4。它说明“让另一云直接改变 feature basis”比只把两个向量并排放进 MLP 更有效。
旋转头输出两个三维向量 r x , r y r_x,r_y r x , r y
r z = r x × r y . r_z=r_x\times r_y. r z = r x × r y . 实际实现还需保证归一化与正交化,否则仅叉积不能确保 R ∈ S O ( 3 ) R\in SO(3) R ∈ S O ( 3 ) Δ t , Δ s \Delta t,\Delta s Δ t , Δ s
6. REAL275 组件消融
原论文 Table 1 与 Figure 3:上方量化 LAT、CCT 与 prior feature 的贡献;右下比较 mean prior 和两个随机 shape priors。CATRE 对 prior 替换更敏感,GeoReF 曲线更稳定。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
完整表的关键路径:
设计 IoU75 5°2cm 10°2cm CATRE 43.6 45.8 61.4 + prior 进入平移/尺寸分支 45.8 48.0 63.8 + HS-layer + LAT 51.0 52.4 69.4 + CCT(完整) 51.8 54.4 71.9
贡献层次清楚:prior 对 translation / size 有帮助,LAT 是最大增益,CCT 再补最后一段跨云融合。单纯把 PointNet 换成 HS-Encoder 会崩,说明 LAT 不是可有可无的外围模块,而是几何 encoder 能适应 refinement 的前提。
7. 不同初始化的鲁棒性
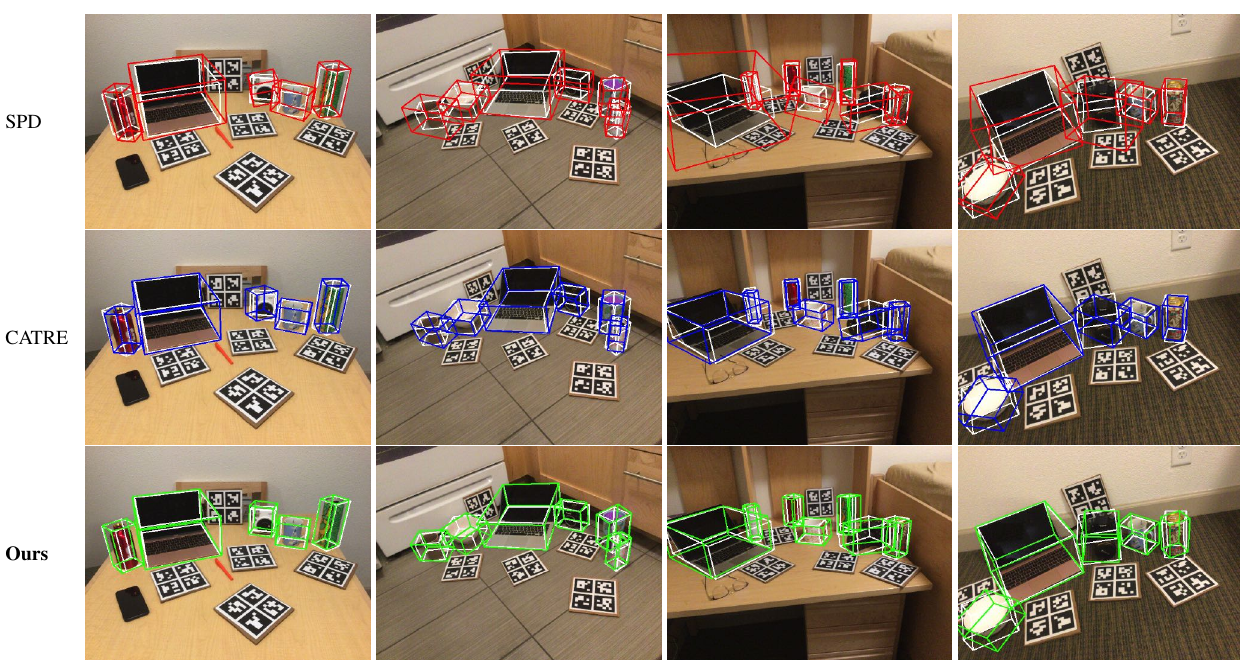
原论文 Figure 4:第一行为 SPD 初始化,第二行为 CATRE refinement,第三行为 GeoReF;白线是真值,彩色线是估计。类别先验与实例形状不一致、相互遮挡时,GeoReF 的 box extent 与朝向更接近真值。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
GeoReF 并非只对 SPD 有效:
Self-DPDN:5°2cm 44.3 → GeoReF 53.9;CATRE 反而 44.0。
GPV-Pose:32.0 → GeoReF 47.4;CATRE 39.7。
HS-Pose:46.5 → GeoReF 51.7;CATRE 48.7。
CATRE 在高质量初始化上甚至会让 10°2cm、10°5cm 下降;GeoReF 对三种初始化均改善,说明其 learned alignment 较少把实例形变错误解释成 pose residual。
8. 少数据泛化
CAMERA25 共 275k train images。论文只抽:
方法 训练图 IoU75 5°2cm 5°5cm CATRE 275k 76.1 75.4 80.3 CATRE 5k 63.2 66.4 72.3 GeoReF 5k 77.5 75.4 81.1 CATRE 10k 66.5 69.7 75.5 GeoReF 10k 79.2 77.9 84.0
5k GeoReF 已超过 275k CATRE 的 IoU75。这个结果支持结构先验减少样本需求,但不能直接推成跨类别泛化:train/test 仍是同样六个类别,只是实例数量与图像数量不同。
9. 主榜与正确读法
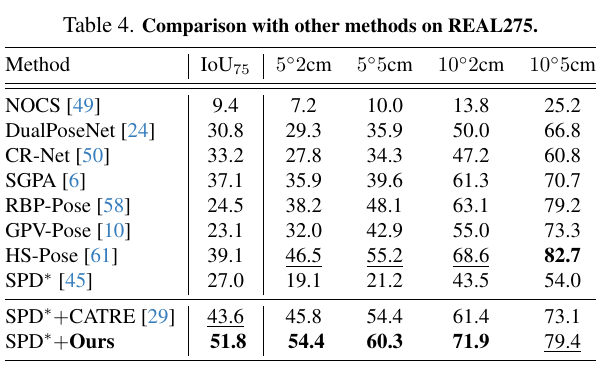
原论文 Table 4:所有 GeoReF 数字都以 SPD 初始估计为起点。它是 refinement 后结果,不应与单阶段 estimator 在相同计算口径下直接比较。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
方法 IoU75 5°2cm 5°5cm 10°2cm 10°5cm SPD 27.0 19.1 21.2 43.5 54.0 SPD + CATRE 43.6 45.8 54.4 61.4 73.1 SPD + GeoReF 51.8 54.4 60.3 71.9 79.4
作者也强调 estimator 与 refiner 不是同一任务。GeoReF 看见 initial pose、shape prior 和 depth point cloud,计算链更长;主榜的意义是证明它能提升已有 estimator,不是证明单模型输入更少。
10. 训练与复现
GPU:RTX 4090;
batch 12,150 epochs;
observed / prior 各 512 点;
Ranger optimizer,base learning rate 10 − 4 10^{-4} 1 0 − 4
从总 epoch 的 72% 开始 cosine annealing;
augmentation:随机丢点、Gaussian noise、pose perturbation;
loss 与基础增强沿用 CATRE;
REAL275 消融使用 SPD initial poses。
必须核对的口径:
CATRE 原始 IoU 实现有小错误,论文按后续协议重算;
相同 initial estimator、相同 iterations 才能公平比较 refiner;
随机 prior 实验的 prior 来自 CAMERA25 train set,不是完全未知类别;
REAL275 只有六类、36 个对象,结果不能代表开放类别。
11. 局限
需要 RGB-D 与可靠对象 mask,纯 RGB 不适用。
需要类别 shape prior,且不处理 articulated / non-rigid objects。
需要合理初始 pose;若误差越过 refinement basin,focalized clouds 可能无有效对应。
LAT 是一般 affine feature transform,不保证物理可解释或刚体一致。
论文未把端到端 detector、initial estimator 与 refiner 的总延迟作为核心指标。
只在 NOCS 六类上训练和评测,类别范围有限。
12. 最终评价
GeoReF 的价值在于把类别级 pose refinement 的核心冲突讲清楚:observed–prior mismatch 同时包含 pose error 和 shape variation,不能靠“更强单云 encoder + 最后拼接”自动解决。 LAT 与 CCT 给出一套简洁、证据充分的跨形状 feature alignment。
它适合作为任何 RGB-D category-level estimator 的后端研究基线,但不是完整系统。部署时要把上游分割、初始 pose、depth 质量、迭代次数和总体时延一起评估,不能只拿 refinement 后的主榜数字下结论。