论文精读:GraspClutter6D
1. 论文的定位
GraspClutter6D 不是单一 6D pose 算法,而是一套连接“感知标注—抓取候选—真实机器人验证”的数据基础设施。作者认为现有数据常有以下缺口:
物体数量或材质覆盖有限;
scene 较稀疏,遮挡与同类多实例不足;
RGB-D pose 数据与 grasp annotations 分离;
大量 synthetic grasp label 没有在真实 clutter 中验证;
相机视角固定,跨传感器和 viewpoint coverage 不足。
因此数据同时面向 instance segmentation、6D object pose estimation、6-DoF grasp detection 与真实抓取训练。
2. 对象、场景与采集硬件
2.1 200 个对象
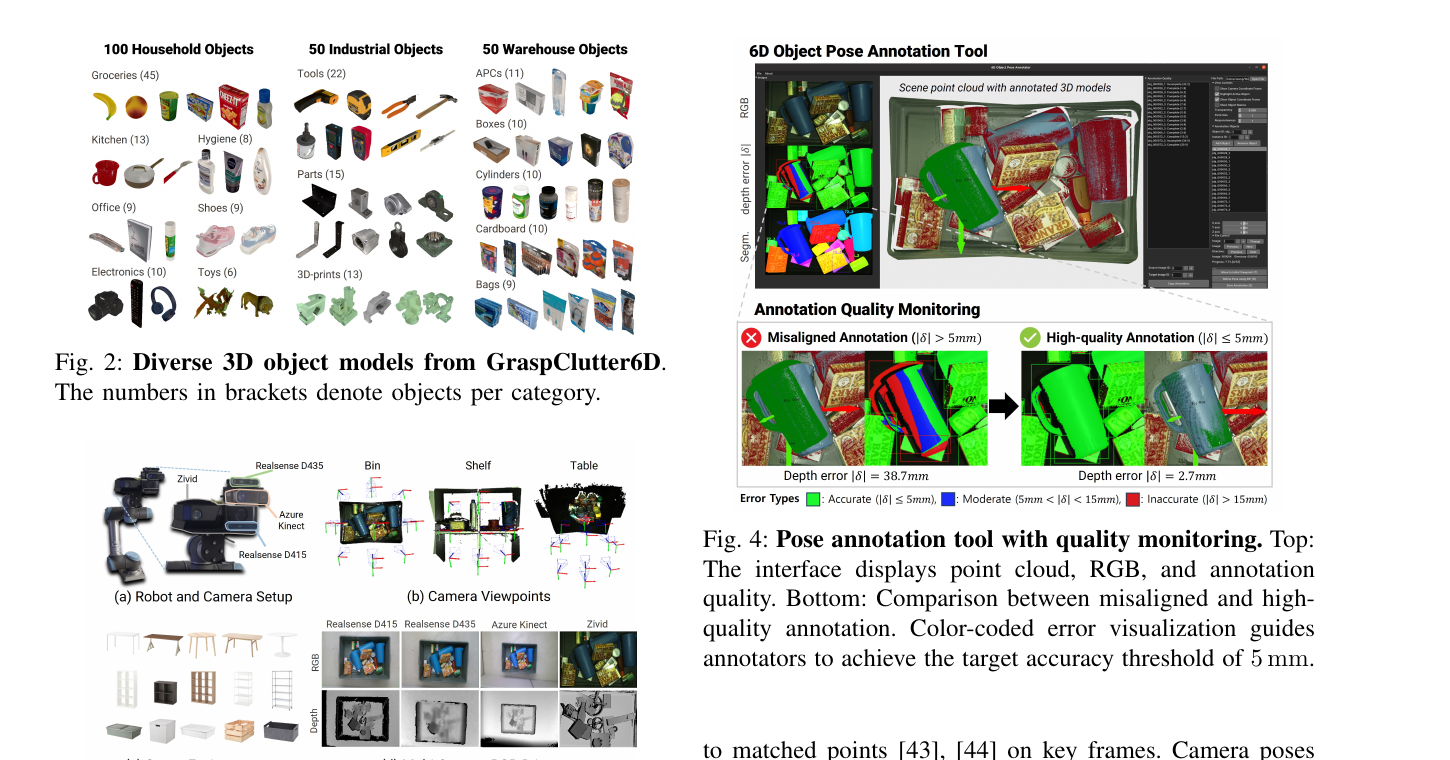
对象分为 100 household、50 industrial、50 warehouse,包含 groceries、kitchen、hygiene、office、electronics、shoes、toys、tools、parts、3D prints、APC objects、boxes、cylinders、cardboard 与 bags。
其中 108 个对象由 Artec Leo 扫描,92 个来自 YCB、HOPE、GraspNet、DexNet、APC 等已有资源。自扫描模型经专家修补为 watertight mesh;反光 / 透明对象为获取几何而喷涂消光材料,公开的是统一尺度的 mesh。
2.2 四相机刚性平台
UR5 末端安装:
RealSense D415;
RealSense D435;
Azure Kinect;
Zivid One+ M。
前三者代表常见低成本 RGB-D,Zivid 用于高质量点云融合与标注。相机通过 ChArUco、MC-Calib、PnP-RANSAC 与 bundle adjustment 完成内外参标定。作者还拟合深度 correction:
D415 mean absolute depth error:10.2 → 5.0 mm;
D435:15.6 → 7.0 mm;
Azure Kinect:25.4 → 15.8 mm。
每种 bin / shelf / table 类别选 5 种家具与 5 种背景变化,共 75 种 environment configurations。每个 scene 随机放置 5–20 个对象,从 13 个外围 / 中心 Zivid viewpoint 采集;所有相机合计产生 52K RGB-D images。
原论文 Figures 2–4:对象组成、UR5 四相机装置,以及把 RGB / segmentation / depth residual 放在同一界面的 pose annotation tool。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
3. 6D pose 标注流程
3.1 一次对齐,多视角传播
13 个 Zivid view 先融合为 scene point cloud。标注者在这份高精度点云中对齐所有 object CAD,而不是在 52K 张图上逐帧操作;随后根据 camera extrinsics 将每个 object pose 传播到 D415、D435、Azure Kinect 与 Zivid 图像。
3.2 Coarse-to-fine 与质量热力图
自定义工具同时显示:
RGB;
segmentation;
captured depth 与 rendered CAD depth 的差值;
object model 与 scene point cloud。
标注者先粗调,再执行 ICP refinement。工具用颜色显示 ∣ δ ∣ ≤ 5 |\delta|\le5 ∣ δ ∣ ≤ 5
最终得到 735,545 个 annotated object instances,附 6D pose 与 segmentation mask。
3.3 标注精度统计应怎样理解
作者定义
δ = d r − d c , \delta=d_r-d_c, δ = d r − d c , 其中 d r d_r d r d c d_c d c
| Sensor | mean ∣ δ ∣ |\delta| ∣ δ ∣ ∣ δ ∣ |\delta| ∣ δ ∣
这些数字不能完全等同于 pose error。残差同时包含:
6D pose misalignment;
mesh reconstruction error;
depth quantization / multipath / missing pixels;
object material引起的 sensor artifact;
遮挡边界与 segmentation 误差。
透明 / 强反光对象因 depth artifact 未进入公平质量比较,正是一个需要额外审计的 difficult subset。
4. 抓取标注是怎样生成的
抓取标签分两层:
object level :在每个 watertight mesh 上采样平行夹爪 pose,以 force-closure metric 评分,摩擦系数从 1.0 降到 0.1;scene level :用 ground-truth 6D object pose 把 object grasps 变换到 scene,再与 reconstructed scene point cloud 做 collision checking。
论文称每个模型“14.4K grasps per point”的表述容易引起歧义;最终发布量为约 9.3B collision-free 6-DoF grasp poses,平均每图约 178K。
这里必须区分三件事:
force closure:理想刚体 / 摩擦模型下的静态可夹持性;
collision-free:候选 gripper pose 不与观测场景发生明显碰撞;
real success:机器人沿实际 approach trajectory 执行后完成抓取。
93 亿只对应前两项,不等于 93 亿次物理执行,也没有覆盖夹爪 compliance、传感误差、动态碰撞和 approach path。
5. 场景统计与覆盖
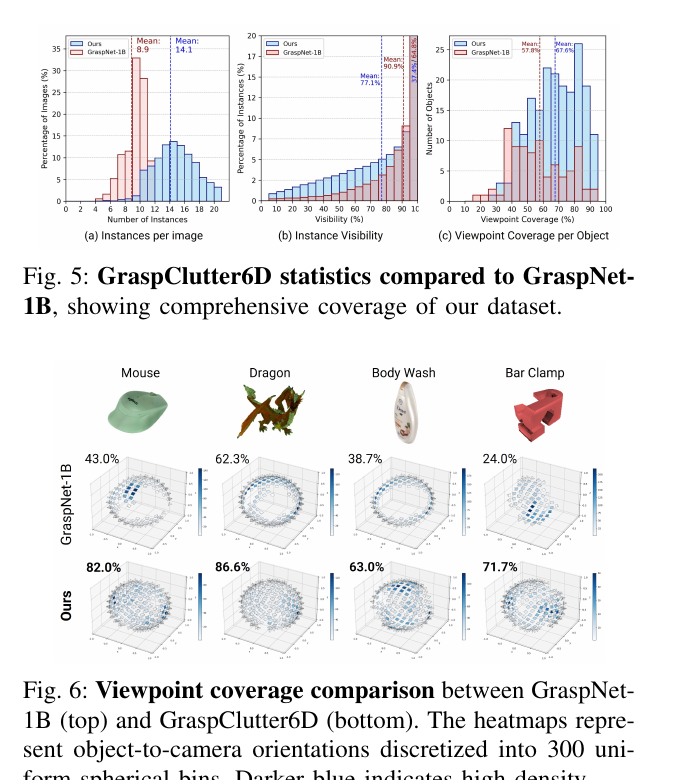
原论文 Figures 5–6:与 GraspNet-1B 相比,GraspClutter6D 每图实例更多、visibility 更低,若干对象的 spherical viewpoint coverage 更广。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
论文报告:
1000 real scenes;
200 objects;
平均 14.1 object instances / image;
平均 visibility 77.1%;
62.6% instances 的 visibility ≤ 0.95 \le0.95 ≤ 0.95
object–camera distance 0.31–1.37 m,均值 0.77 m;
object diameter 4.5–47.3 cm;
weight 6–2250 g;
mean viewpoint coverage 67.6%,对比 GraspNet-1B 为 57.8%。
需要注意,多相机和 13 viewpoint 使同一 physical scene 产生多张图。统计图中的 image count 很大,但场景独立性仍以 1000 scene 为单位。评测 split 应按 scene group,而不是随机 frame。
6. 真实机器人抓取结果
作者在 UR5 + Robotiq gripper 上测试 unseen YCB objects,使用 RealSense D435。场景包括:
packed 5 objects;
pile 5 / 10 / 15 objects。
每个设置对每个方法执行 20 rounds,并限制连续失败。Contact-GraspNet 在不同训练数据下比较:
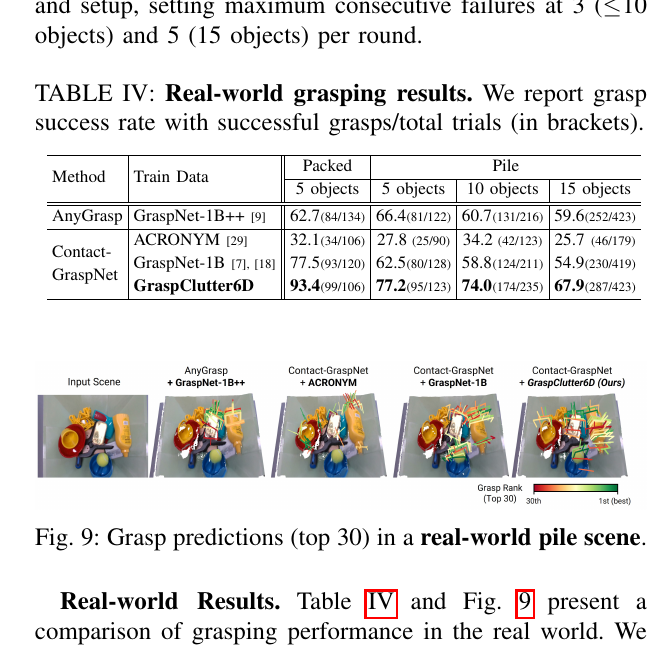
原论文 Table IV 与 Figure 9:GraspClutter6D 训练的 Contact-GraspNet 在所有真实设置上领先,且 clutter 越强所有方法越明显下降。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
方法 / 训练数据 Packed 5 Pile 5 Pile 10 Pile 15 AnyGrasp / GraspNet-1B++ 62.7 66.4 60.7 59.6 Contact-GraspNet / ACRONYM 32.1 27.8 34.2 25.7 Contact-GraspNet / GraspNet-1B 77.5 62.5 58.8 54.9 Contact-GraspNet / GraspClutter6D 93.4 77.2 74.0 67.9
因为 backbone / inference algorithm 相同,主要变量是 training data,这比仅在 offline AP 上比较更能说明数据价值。但它仍不是完全因果隔离:数据量、采样密度、标签分布和场景风格同时变化。
论文观察到,即使 grasp pose 本身准确,简单直线 approach trajectory 也可能与周围物体碰撞。未来需要 gripper-aware / reactive motion,而非只改静态 grasp score。
7. 对下游 perception 训练的帮助
在 YCB-Video 上,附加数据量分别为 GraspNet-1B 56K、GraspClutter6D 14K:
FFB6D pose
论文 Table VI 的两列标为 ADD-S,但结合正文应理解为标准的 ADD(-S) / ADD-S 组合。数值:
YCB-V only:63.48 / 81.46;
GraspNet-1B:64.24 / 85.09;
GraspClutter6D:68.80 / 85.76。
用约四分之一的附加图像获得更大增益,说明 dense clutter 与 object diversity 的信息密度高。但对公平性最好进一步控制 effective object instances、总训练 steps 与 category overlap。
8. 6D object pose benchmark
作者在标准 21 个 YCB-V objects 上比较:
instance-level:FFB6D、GDR-Net;
foundation / novel-object:MegaPose、FoundationPose。
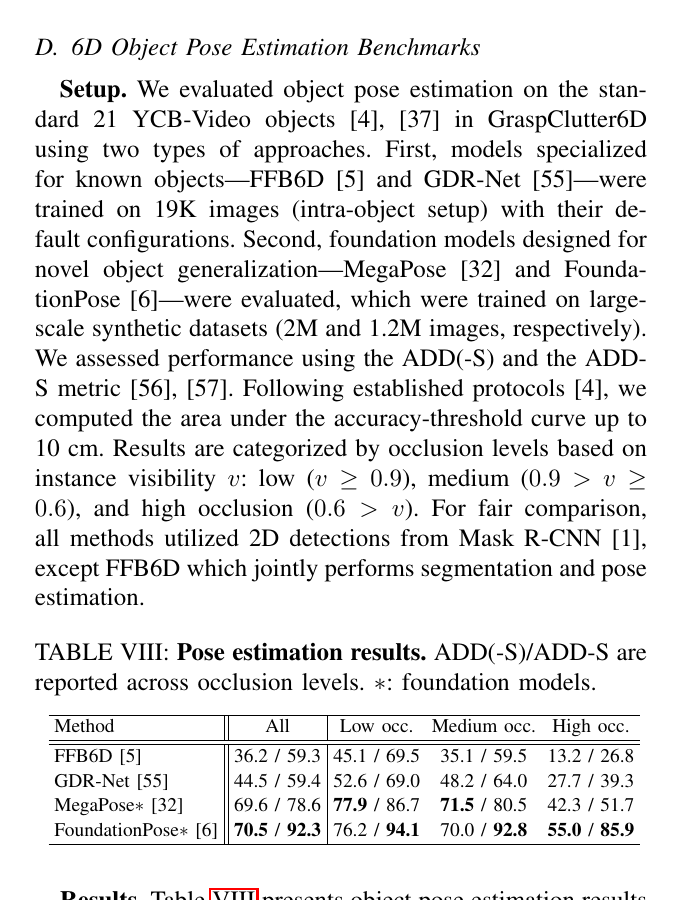
指标为 ADD(-S) / ADD-S AUC(阈值到 10 cm),并按 visibility 分低、中、高遮挡。
原论文 Table VIII:所有方法随遮挡加重而下降;FoundationPose 总体最佳,但高遮挡 ADD(-S) 仍只有 55.0。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
方法 All Low occ. Medium occ. High occ. FFB6D 36.2 / 59.3 45.1 / 69.5 35.1 / 59.5 13.2 / 26.8 GDR-Net 44.5 / 59.4 52.6 / 69.0 48.2 / 64.0 27.7 / 39.3 MegaPose 69.6 / 78.6 77.9 / 86.7 71.5 / 80.5 42.3 / 51.7 FoundationPose 70.5 / 92.3 76.2 / 94.1 70.0 / 92.8 55.0 / 85.9
ADD-S 与 ADD(-S) 的大差距说明对称处理显著影响总体结论。高遮挡时 FoundationPose 仍较强,但严格对应误差下降明显;这使数据适合分析 visibility-aware confidence 或 tracking recovery。
9. 6-DoF grasp detection benchmark
四个方法都在 GraspNet-1B 的 100 scenes 上训练,再分别在 GraspNet-1B 和 GraspClutter6D 测试。以 friction coefficient 0.2–1.2 下的 force-closure AP 为指标。所有方法跨到 GraspClutter6D 后显著下降:
Contact-GraspNet:19.07 → 10.73 AP;
GraspNet-Baseline:23.43 → 17.95;
ScaleBalancedGrasp:44.85 → 22.69;
EconomicGrasp:51.63 → 21.67。
这表明 GraspClutter6D 不是一个被现有 GraspNet 训练“轻易解决”的近域测试集,也强调训练集 domain 与 evaluation clutter 的影响。
10. 主要局限
解析 grasp 数量容易被误读。 93 亿是候选,不是独立真实 trials。pose quality metric 混合误差源。 深度 residual 不能单独识别旋转、平移、mesh 或 sensor error。透明 / 反光质量统计不完整。 这些困难材质虽在数据中,却从 opaque-only 对比中排除。多视角相关性。 52K images 不是 52K independent scenes;split 必须 scene-wise。对象来源重叠。 YCB 等 public objects 与下游 YCB-V benchmark 的关系应在 unseen / transfer 结论中明确。抓取动力学简化。 force closure 与点云碰撞未建模 approach planning、compliance、slip、闭环视觉 / 触觉反馈。采集装置受控。 UR5 刚性 rig、标定良好的静态 clutter 与手持 / 移动物体场景仍有距离。
11. 总体判断
GraspClutter6D 的核心贡献不是某个 SOTA 粗体数字,而是建立了一条可以从“CAD 对齐的 pose”走到“场景级 grasp 候选”再走到“真实机器人 success”的证据链。对 6D pose 社区,它特别适合:
高遮挡 pose robustness;
RGB-D foundation pose estimator 的 scene-level failure;
pose / segmentation data 对下游训练的增益;
pose uncertainty 与 grasp planning 的联动;
多传感器深度偏差和标注质量研究。
使用时若严格控制 scene split、object overlap 与 opaque-only quality caveat,这套数据可以成为连接 pose estimation 与 manipulation 的重要 benchmark。